Publier un service web, ce n'est pas démarrer un processus : c'est rendre accessible, de façon fiable, une fonction attendue par des utilisateurs précis. Cette leçon ouvre la formation « Publier un service web » : avant de parler de noms DNS, de ports ou de reverse proxy (un serveur intermédiaire qui reçoit les requêtes à la place de l'application, puis les lui transmet), il faut savoir nommer précisément ce que l'on publie. Vous apprendrez à distinguer un processus qui tourne d'un service qui répond, une application complète d'un simple site statique, et à écrire le contrat minimal qu'un service doit tenir une fois publié.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Distinguer service, application, processus, socket, site statique et API, et savoir laquelle de ces notions répond à quelle question
- Décrire les utilisateurs, dépendances, données et exigences d'un service avant de le publier
- Observer un service avec
ss -ltnp,psetcurl -w, puis consigner ce qu'on a vu dans une fiche de service - Expliquer pourquoi un processus démarré, ou même un conteneur à l'état
running, ne prouve pas qu'un service rend ce qu'on attend de lui
Prérequis
Section intitulée « Prérequis »Cette leçon suppose que vous savez lire une adresse IP et un port, utiliser un terminal, et reconnaître à l'œil une résolution DNS et une requête HTTP, sans encore savoir les expliquer en détail : c'est l'objet des deux prochaines leçons de ce socle. Si ces notions sont neuves, les guides IP et sous-réseaux, TCP vs UDP, DNS et HTTP et HTTPS donnent les bases de lecture nécessaires. Aucun outil ni aucun reverse proxy particulier n'est requis ici : cette formation reste indépendante du produit qui exposera vos services au moment de leur publication effective.
Qu'est-ce qu'un client, un serveur, une requête et une réponse ?
Section intitulée « Qu'est-ce qu'un client, un serveur, une requête et une réponse ? »Un client envoie une requête, un serveur renvoie une réponse : tout le reste
de cette formation n'est qu'une variation sur ces quatre mots. Le client
(un navigateur, curl, une autre application) ouvre une connexion réseau et
formule une requête : « donne-moi ceci », « enregistre cela ». Le serveur
écoute cette connexion, traite la demande et renvoie une réponse, qui
contient en général une ressource (une page, un enregistrement, un
résultat de calcul) sous une représentation donnée (du HTML, du JSON, une
image). La même ressource peut avoir plusieurs représentations : une fiche
produit existe en page HTML pour un navigateur et en JSON pour une
application mobile, sans que la donnée sous-jacente change.
Ce vocabulaire paraît élémentaire, mais il sert de référence constante : dans les leçons suivantes, une requête mal comprise, une réponse mal lue ou une confusion entre la ressource et sa représentation expliquent la plupart des diagnostics ratés.
Que distinguent service, application, processus, socket, site statique et API ?
Section intitulée « Que distinguent service, application, processus, socket, site statique et API ? »Six mots qu'on emploie souvent l'un pour l'autre désignent en réalité six notions distinctes : confondre un processus avec un service, ou un site statique avec une API, est une cause fréquente de publication mal comprise. Le tableau fixe un vocabulaire précis pour la suite du socle.
| Terme | Ce qu'il désigne |
|---|---|
| Processus | Un programme en cours d'exécution sur une machine, identifié par un numéro unique, le PID |
| Socket | Le point d'écoute réseau qu'un processus ouvre (une adresse et un port) |
| Application | Le code et sa logique métier : ce qui décide quoi répondre |
| Service | Ce qui est rendu à l'utilisateur de façon fiable dans la durée, pas seulement démontré une fois |
| Site statique | Des fichiers (HTML, images, scripts) servis tels quels, sans calcul propre à chaque requête |
| API | Une interface pensée pour un programme appelant, pas pour un navigateur humain |
Un processus peut très bien être lancé, occuper un socket, et pourtant ne rendre aucun service utilisable : il attend une configuration absente, une base de données injoignable, ou répond une erreur à chaque appel métier. C'est pour cela que ce socle traite le service comme la notion centrale : elle seule engage une promesse envers un utilisateur, les cinq autres ne décrivent que des briques de cette promesse.
Une API n'est pas un type de serveur à part : c'est un contrat d'échange (souvent en JSON, parfois en XML) destiné à un programme, là où un site statique répond des pages déjà prêtes. Beaucoup de services réels combinent les deux : un site statique pour l'interface, une API derrière pour les données, un seul nom public pour les deux.
Que change le passage d'un serveur de développement à un service exploitable ?
Section intitulée « Que change le passage d'un serveur de développement à un service exploitable ? »Un serveur de développement et un service exploitable peuvent exécuter exactement le même code, mais seul le second promet quelque chose à un utilisateur qu'on ne connaît pas personnellement. Un serveur de développement démarre en une commande, affiche ses erreurs en clair, recharge le code à chaque modification, et s'arrête sans conséquence quand on ferme le terminal : c'est voulu, il sert à vous, pendant que vous écrivez le code.
Un service exploitable doit survivre à votre absence. Il a un démarrage reproductible (pas « lancé une fois à la main et oublié »), une configuration externalisée du code (adresses, quotas, mode de journalisation), des secrets qui ne vivent ni dans le code ni dans les journaux (mots de passe, clés d'API, jetons), et un état qui doit, ou non, survivre à un redémarrage selon qu'il s'agit d'une donnée métier à conserver ou d'un simple cache à reconstruire. Ces quatre points, démarrage, configuration, secrets et état, sont ce qu'une fiche de service doit décrire avant toute publication : ils ne se devinent pas en lisant le code une fois.
Qu'est-ce qu'un contrat de publication ?
Section intitulée « Qu'est-ce qu'un contrat de publication ? »Publier un service, c'est s'engager sur un contrat vérifiable : qui peut y accéder, sous quel nom, avec quelle disponibilité et quelle latence, et qui en répond en cas de panne. Ce contrat de publication précède toute question de reverse proxy ou d'outil : il définit ce que l'outil devra tenir, pas comment il le tiendra.
Cinq éléments composent ce contrat :
- les noms par lesquels le service est joint (un ou plusieurs noms DNS, parfois une IP seule en interne) ;
- les URL exposées, c'est-à-dire les chemins qui ont un sens pour l'utilisateur, à distinguer des chemins internes de l'application ;
- l'accès autorisé : public, réservé à un réseau interne, ou derrière une authentification ;
- la disponibilité et la latence attendues, exprimées en termes vérifiables (« répond en moins d'une seconde », « accessible 99 % du temps »), pas en formules vagues ;
- l'exploitant, la personne ou l'équipe qui répond quand le service ne tient plus sa promesse.
Un service sans ce contrat écrit n'est pas forcément mal construit, mais il est impossible à vérifier : personne ne peut dire s'il fonctionne « comme prévu », faute d'avoir écrit ce qui était prévu.
Pourquoi une réponse technique ne prouve-t-elle pas que le service fonctionne ?
Section intitulée « Pourquoi une réponse technique ne prouve-t-elle pas que le service fonctionne ? »Un code de réponse 200 et un conteneur à l'état running prouvent qu'un
processus répond, jamais que la fonction métier attendue fonctionne.
Deux observations confirment qu'un processus est vivant et qu'il parle le
protocole attendu : ss -ltnp montre le processus et le socket sur
lequel il écoute, et curl -i montre la réponse renvoyée. Elles ne disent
rien de la fonction métier : la page d'accueil peut s'afficher normalement
pendant que la recherche, le paiement ou l'envoi d'un formulaire échoue
silencieusement derrière. Les sections suivantes le montrent sur un vrai
service.
Deux erreurs reviennent constamment à cause de cette confusion :
- une page HTML qui s'affiche n'est pas toute l'application : une page d'accueil statique, ou une page d'erreur personnalisée bien stylée, peut répondre alors que les fonctions réelles du service, elles, sont en panne ;
- un conteneur à l'état
runningn'est pas une preuve de disponibilité : Docker ou tout autre moteur de conteneurs rapporte l'état du processus qu'il surveille, pas celui de la fonction métier rendue par ce processus. Un processus bloqué en boucle d'attente, ou qui répond des erreurs à chaque appel, resterunning.
Vérifier un service exploitable demande donc de tester la fonction métier elle-même (une recherche qui retourne un résultat connu, un paiement de test qui aboutit), pas seulement de constater qu'un socket répond. C'est l'écart entre « le processus tourne » et « le service rend ce qui est promis » que la fiche de service de cette leçon doit consigner.
Comment observer un service qui tourne ?
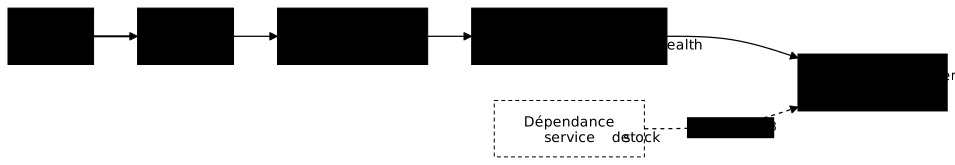
Section intitulée « Comment observer un service qui tourne ? »Quatre commandes suffisent pour décrire un service en marche : ss -ltnp
dit qui écoute, ps dit sous quel compte et depuis quand, curl -i dit ce
qui est répondu, curl -w dit le code et le temps. Chacune interroge une
couche différente, et le schéma montre laquelle : on part du client et on
descend vers le processus, sans jamais supposer ce qu'on n'a pas observé.
Les relevés qui suivent viennent d'un petit service de catalogue lancé sur mon
poste de travail le 2026-10-25, avec curl 8.18.0 et Python 3.12.13.
Ce sont les valeurs d'une mesure, pas des exigences : le port 18311, le PID, le
compte bob et les durées seront différents chez vous, seule la façon de les
lire compte. C'est la même application que celle du lab ci-dessous, sans sa
dépendance de stock, volontairement absente. Première question, qui écoute sur
le port 18311 ? L'option -l ne garde que les sockets en écoute, -t le TCP,
-n les numéros plutôt que les noms, -p le processus propriétaire :
ss -ltnp "sport = :18311"State Recv-Q Send-Q Local Address:Port Peer Address:PortProcessLISTEN 0 5 127.0.0.1:18311 0.0.0.0:* users:(("python3",pid=2786496,fd=4))Trois informations se lisent ici. L'adresse 127.0.0.1 signifie que le
service n'écoute que sur l'interface de bouclage (loopback) : il n'est
joignable que depuis la machine elle-même. Un collègue sur le réseau n'y
accède pas, ce qui change tout pour la publication. (Un conteneur a son propre
127.0.0.1, distinct de celui de la machine : un service qui écoute en
loopback dans un conteneur n'est joignable que depuis ce conteneur.) Le nom
python3 et le PID 2786496 désignent le processus. La colonne Peer
(0.0.0.0:*) est normale pour une écoute : aucun client n'est encore connecté.
Si ss ne rend rien, personne n'écoute ce port, et la question suivante n'a
pas de sens.
Deuxième question, sous quel compte et depuis quand ce processus
tourne-t-il ? On la pose à ps avec le PID que ss vient de fournir :
ps -o pid,user,etime,args -p 2786496 PID USER ELAPSED COMMAND2786496 bob 00:03 python3 app.pyLa colonne USER donne le compte propriétaire, ici bob, mon compte de
poste. C'est déjà un constat : un service exploité tourne sous un compte de
service dédié, pas sous le compte d'une personne. La colonne ELAPSED donne
l'ancienneté du processus (trois secondes, il vient de démarrer) : un service
censé tourner depuis des jours dont l'ancienneté affiche quelques secondes a
redémarré, peut-être en boucle. COMMAND donne la ligne de lancement, utile pour
retrouver le fichier de configuration ou l'unité qui le démarre.
Comment vérifier que le service répond, et à quoi ?
Section intitulée « Comment vérifier que le service répond, et à quoi ? »curl -i affiche la réponse complète, curl -w n'en garde que le code et la
durée, et il faut interroger plusieurs chemins : un seul chemin qui répond ne
prouve que ce chemin. Voici la page d'accueil, avec ses en-têtes :
curl -sS -i http://127.0.0.1:18311/HTTP/1.0 200 OKServer: BaseHTTP/0.6 Python/3.12.13Date: Sun, 25 Oct 2026 21:09:31 GMTContent-Type: text/htmlContent-Length: 23
<h1>Catalogue-demo</h1>La première ligne porte le code 200, le Content-Type annonce du HTML et
le corps est le titre de l'application : l'accueil fonctionne. Le chemin
/health répond lui aussi {"status": "ok"} avec un 200. Reste la fonction que
les utilisateurs attendent, la liste des livres. Pour comparer plusieurs
chemins sans noyer l'écran, -w imprime une ligne par appel, -o /dev/null
jette le corps, -s supprime la barre de progression :
for chemin in / /health /api/livres; do curl -s -o /dev/null -w "%{http_code} %{time_total}s $chemin\n" \ "http://127.0.0.1:18311$chemin"done200 0.000447s /200 0.000316s /health503 0.000561s /api/livresC'est le cœur de la leçon : deux chemins répondent 200, le troisième 503.
Le processus tourne, le socket écoute, l'accueil s'affiche, le contrôle de
santé est vert, et pourtant la fonction métier est en panne. Le corps de la
réponse 503 ({"error": "stock indisponible"}) pointe une dépendance,
c'est-à-dire un autre composant dont le service a besoin pour répondre (une
base de données, un service de stock). C'est une piste à vérifier, pas une
preuve : trouver cette dépendance, son compte et son port est justement le
travail du lab. La durée, elle, se lit dans la deuxième colonne : ici moins
d'une milliseconde, parce que le client et le serveur sont sur la même machine.
Sur un vrai réseau, c'est cette valeur que le contrat de publication borne
(« moins d'une seconde »).
Que voit le client quand le service est arrêté ?
Section intitulée « Que voit le client quand le service est arrêté ? »Un service arrêté ne répond pas du tout : curl n'a aucun code HTTP à afficher
et -w '%{http_code}' rend 000, ce qui n'est pas un code de réponse mais
l'aveu qu'aucune réponse n'est arrivée. On arrête le processus, puis on pose
les deux mêmes questions :
ss -ltnp "sport = :18311"curl -sS -o /dev/null -w "%{http_code} %{time_total}s\n" http://127.0.0.1:18311/echo "curl a rendu le code de sortie $?"State Recv-Q Send-Q Local Address:Port Peer Address:PortProcesscurl: (7) Failed to connect to 127.0.0.1 port 18311 after 0 ms: Could not connect to server000 0.000116scurl a rendu le code de sortie 7ss ne rend plus que son en-tête : plus aucun socket n'écoute. curl
affiche l'erreur 7 (« Failed to connect »), le code HTTP vaut 000 et son code
de sortie vaut 7. Retenez la différence avec le 503 de la section précédente :
un 503 vient d'un processus vivant qui dit « je ne peux pas », un 000
signifie que personne n'a répondu. Les deux se traitent différemment :
dans le premier cas on cherche la dépendance, dans le second on cherche
pourquoi le processus ne tourne plus ou n'écoute plus.
À quoi ressemble une fiche de service remplie ?
Section intitulée « À quoi ressemble une fiche de service remplie ? »La fiche de service consigne ce que vous venez d'observer, une ligne par fait, et chaque ligne se vérifie par une commande. Voici celle du service relevé plus haut, au format YAML :
service: catalogueurl: http://127.0.0.1:18311/utilisateur: bobprocessus: python3 app.py (PID 2786496)ecoute: 127.0.0.1:18311dependances: à établirrecette: - "GET / rend 200" - "GET /health rend 200" - "GET /api/livres rend 200 en moins d'une seconde"exploitant: à désignerRelisons-la ligne à ligne. service et url nomment ce que l'utilisateur
connaît. utilisateur, processus et ecoute viennent des deux premières
commandes (ps et ss) : ce sont des faits observés, non des intentions.
Ici, utilisateur désigne le compte système qui fait tourner le processus
(la colonne USER de ps), pas les utilisateurs finaux du contrat. La ligne
utilisateur: bob est honnête mais révèle un défaut à corriger avant
publication. dependances: à établir assume une inconnue au lieu de la
deviner : mieux vaut un « à établir » qu'une valeur plausible et fausse. Enfin
recette liste des critères observables, c'est-à-dire des phrases qu'une
commande peut confirmer ou infirmer. Avec les relevés ci-dessus, les deux
premiers sont satisfaits et le troisième ne l'est pas : la fiche dit donc
d'elle-même que ce service n'est pas prêt, ce qu'un simple « il tourne »
n'aurait jamais révélé.
Notez ce que la fiche ne contient pas : aucune adresse publique, aucun nom DNS, aucun reverse proxy. Ces éléments arrivent avec la publication et alimentent le contrat décrit plus haut ; la fiche, elle, décrit le service avant qu'on y touche. Une fiche complète ajoute le démarrage, la configuration, les secrets et l'état vus plus haut ; celle-ci reste minimale pour montrer le geste.
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab vous donne une petite application de catalogue dont la page répond mais dont une fonction métier échoue, sur une machine où personne ne peut vous dire quel processus répond, sous quel compte, ni de quoi il dépend. Vous rédigez la fiche de service avec les gestes de cette leçon, vous rétablissez la fonction, puis vous observez l'effet d'un redémarrage. Les tests automatiques comparent chacune de vos affirmations au système en marche.
À retenir
Section intitulée « À retenir »- Un client envoie une requête, un serveur renvoie une réponse qui porte une ressource sous une représentation donnée.
- Processus, socket, application, service, site statique et API désignent six choses distinctes ; seul le service engage une promesse envers un utilisateur.
- Un service exploitable se distingue d'un serveur de développement par son démarrage reproductible, sa configuration externalisée, ses secrets isolés et son état maîtrisé au redémarrage.
- Un contrat de publication fixe noms, URL, accès, disponibilité, latence et exploitant, avant toute question d'outil.
ss -ltnpdit qui écoute (et sur quelle adresse),ps -o pid,user,etime,argsdit sous quel compte et depuis quand,curl -w '%{http_code}'dit ce qui est répondu ; un503vient d'un processus vivant qui ne peut pas tenir sa fonction, un code000signifie qu'aucune réponse n'est arrivée.- Une fiche de service consigne des faits observés, avoue ses inconnues
(
à établir) et liste des critères de recette qu'une commande peut vérifier. - Un code 200 ou un conteneur
runningprouvent qu'un processus répond, jamais que la fonction métier fonctionne : il faut la tester elle-même.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Lire HTTP avant de configurer un proxy
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications