Pour diagnostiquer une panne HAProxy sans savoir laquelle, lisez toujours dans le même ordre : la configuration effective, l'état des serveurs, puis le code de terminaison du journal. Cette leçon s'adresse à qui exploite déjà un HAProxy 3.4 et reçoit une alerte sans explication. Elle n'enseigne pas cinq corrigés, parce qu'on ne sait jamais d'avance laquelle on aura : elle enseigne une méthode, c'est-à-dire par où commencer, quoi lire, et comment ne pas suivre une fausse piste. Le fil rouge est un piège : un 503 accuse le routage, et la cause est souvent dans la confiance TLS ou dans une sonde.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »La leçon va du symptôme à la cause, puis de la cause à une correction qui ne retire rien de ce qui protège le service.
- Suivre un ordre de lecture fixe : configuration effective,
show stat, journal. - Lire un code de terminaison comme
SC--et en déduire le côté fautif. - Poser
ssl_bc_err_strdans le journal avant d'en avoir besoin. - Expliquer pourquoi un 503 avec un serveur
UPn'est pas un problème de routage. - Éviter les lectures qui concluent à tort : version, socket, compteurs de transition.
- Corriger sans désactiver la vérification TLS ni les sondes.
Prérequis
Section intitulée « Prérequis »La leçon suppose un HAProxy 3.4 qui tourne et un compte capable d'utiliser
sudo. Les faits ont été mesurés sur HAProxy 3.4.7, le paquet du dépôt
trixie-backports-3.4 de Debian 13, avec un client distinct de la machine
qui porte le proxy.
- Installer HAProxy 3.4 et lire ses sections : Installer HAProxy et lire ses sections de configuration.
- Comprendre les sondes,
inter,fall,riseet les compteurs deshow stat: Choisir la répartition et mesurer les sondes. - Interroger le socket d'administration : Modifier l'état de HAProxy à chaud avec des droits limités.
Par où commencer quand on ne sait pas quelle panne on a ?
Section intitulée « Par où commencer quand on ne sait pas quelle panne on a ? »Commencez par la configuration effective, puis par l'état des serveurs, et ne lisez le code HTTP qu'en troisième. Le code de retour oriente, il ne conclut pas : un 503 veut dire « plus aucun serveur disponible », et au moins trois familles de pannes le produisent (routage, sonde, confiance TLS vers le backend). Une limite de trafic rend plutôt un 429, et un mauvais routage peut même rendre un 200 avec le mauvais contenu, le seul cas qu'aucun code ne révèle. Partir du code, c'est donc choisir une piste avant d'avoir un fait. Les deux premiers gestes se jouent en lecture seule : ils ne modifient rien, se lancent depuis la machine du proxy, et écartent plusieurs hypothèses avant qu'on ait touché à un seul fichier.
L'ordre ci-dessous évite ce piège. Regardez le nœud en évidence : un serveur UP qui rend pourtant un 503, la situation qui trompe le plus.
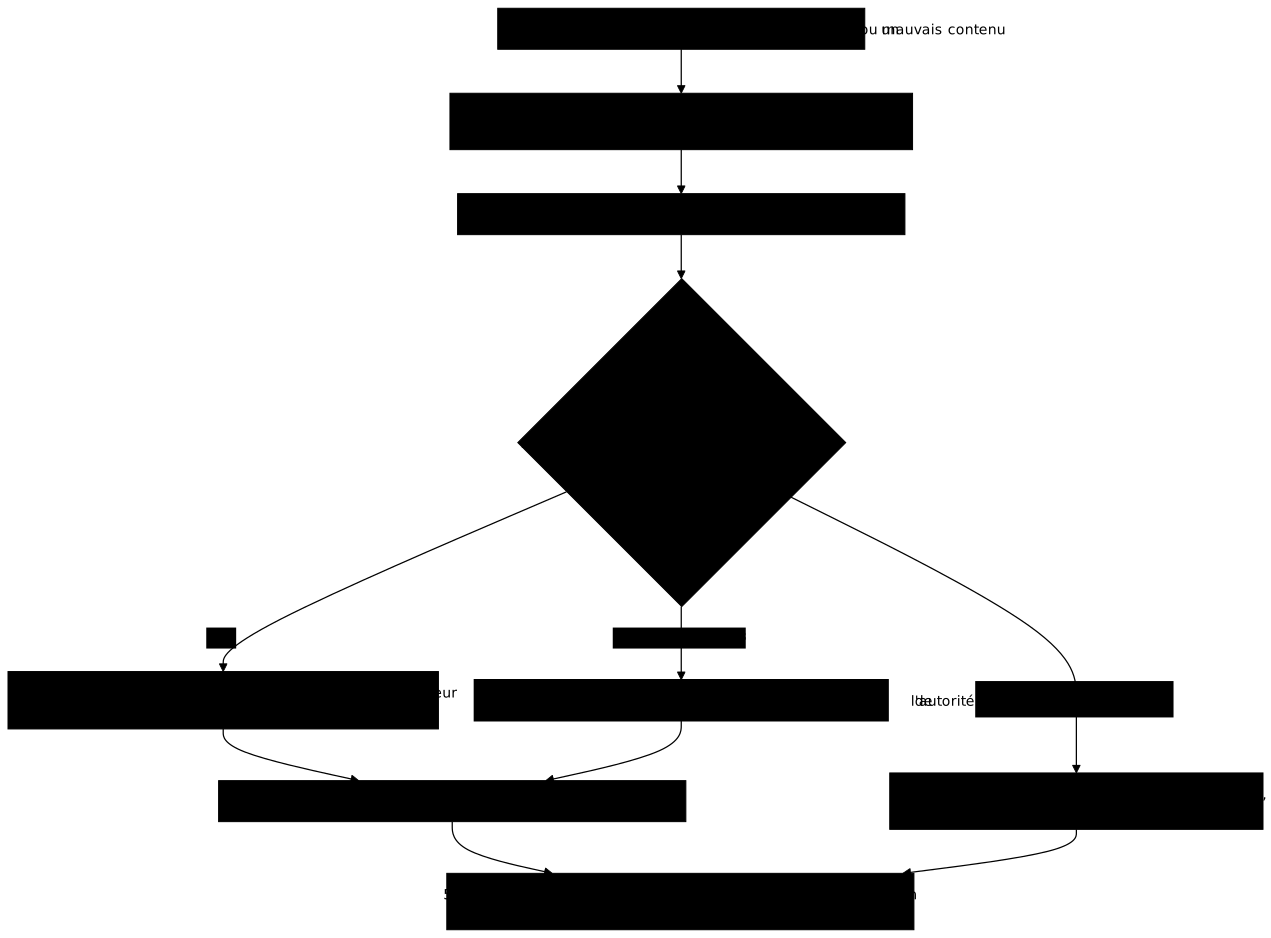
La configuration effective est celle que HAProxy a réellement chargée, pas celle que vous croyez avoir : haproxy -c -f /etc/haproxy/haproxy.cfg -V la
valide et la commente. Le paquet Debian charge aussi le répertoire
/etc/haproxy/conf.d, ce qui explique qu'une règle absente du fichier principal agisse quand même. Puis l'état des serveurs :
echo 'show stat' | sudo socat -t2 stdio /run/haproxy/admin.sockLa sortie est un CSV. Lisez trois colonnes : le statut (UP, DOWN), check_status, qui dit pourquoi la dernière sonde a échoué, et qcur, la file d'attente. Un seul coup d'œil sépare déjà trois familles sur cinq.
Que dit un code de terminaison comme SC-- ?
Section intitulée « Que dit un code de terminaison comme SC-- ? »SC-- signifie que l'échec s'est produit à l'établissement de la connexion,
côté serveur. Les codes de terminaison sont les deux premières lettres de
l'état de fin de session que HAProxy écrit dans son journal ; le format de
journal option httplog les porte. Le manuel 3.4 (section 8.5) définit la
première lettre, qui dit qui a terminé la session et pourquoi. S veut
dire « the TCP session was unexpectedly aborted by the server, or the server
explicitly refused it », et la deuxième lettre C dit que le proxy attendait
l'établissement de la CONNECTION.
Les deux lettres se lisent ensemble. S désigne le côté fautif, le serveur ; C désigne le moment, l'établissement. Lu ainsi, SC-- écarte d'un coup le client, le routage et l'application : le proxy a choisi un serveur, a tenté de
lui parler, et la connexion n'a pas abouti, ou le serveur l'a refusée. Les
causes restantes sont la joignabilité, une sonde, ou une négociation TLS vers
le backend qui échoue.
Un autre code est à connaître : D marque les connexions coupées par on-marked-down shutdown-sessions, l'option qui ferme les sessions d'un serveur au moment où HAProxy le déclare DOWN. Elle est désactivée par défaut, donc un D signale une coupure voulue par la configuration, pas une panne du serveur. Le journal est dans /var/log/haproxy.log, et
journalctl -u haproxy donne les messages de démarrage.
Comment lire la raison exacte d'un échec TLS vers le backend ?
Section intitulée « Comment lire la raison exacte d'un échec TLS vers le backend ? »Ajoutez ssl_bc_err_str au log-format : il écrit la raison OpenSSL exacte
d'un échec TLS entre HAProxy et le backend. Sans lui, un échec de
négociation ressemble à un serveur absent : SC--, puis un 503, et rien ne dit
si le certificat est expiré, signé par une autorité inconnue, ou refusé pour un
autre motif. C'est typiquement ce qu'une leçon de dépannage doit apprendre à
poser avant d'en avoir besoin, parce qu'un champ ajouté après la panne ne
dit rien de la panne qui vient d'avoir lieu. Le journal reste en outre lisible par n'importe quel exploitant de garde, alors qu'un test à la main suppose de reproduire les conditions de la panne depuis la bonne machine.
Voici un fragment qui l'ajoute. Ce fragment est une illustration ; seule la valeur lue dans le champ vient de la mesure.
defaults log-format "%ci %ST %tsc %b/%s %[ssl_bc_err_str]"Sur la panne de confiance du lab, le champ contenait :
error:0A000086: certificate verify failedLe message dit que la vérification du certificat du serveur a échoué, ce qui désigne la confiance (autorité, nom, usage du certificat) et non le routage. Le champ évite des heures de recherche : sans lui, on teste successivement le réseau, le port et l'application, alors que la réponse était disponible à la première requête.
Pourquoi un 503 avec un serveur UP n'est-il pas un problème de routage ?
Section intitulée « Pourquoi un 503 avec un serveur UP n'est-il pas un problème de routage ? »Un 503 « No server is available » alors que show stat affiche le serveur
UP vient, dans les deux cas mesurés, de la vérification TLS stricte du backend, pas du routage. Deux causes mesurées sur HAProxy 3.4.7 le produisent, et aucune ne se
trouve dans les règles de routage. Dans les deux cas, la ligne server
déclare verify required, qui oblige HAProxy à valider le certificat du
serveur avant de lui envoyer la requête. Si la validation échoue, la requête
reçoit un 503 alors que le serveur reste UP.
- Une autorité de certification sans extension
keyUsage. Elle passeopenssl verify, mais échoue en vérification stricte, celle qu'exige unverify required. Mesure au banc :openssl verify -x509_strict -purpose sslserveréchoue sans l'extension et réussit avec. L'extendedKeyUsagede la feuille n'y est pour rien, c'est la fausse piste naturelle. - Un
snimanquant sur la ligneserver. Sans lui, unverify requiredéchoue même avec unca-fileet unverifyhostcorrects.
Le piège est dans le diagnostic, pas dans la configuration. Le symptôme (un 503) accuse le routage, l'état (UP) rassure, et la faute est dans la PKI.
Le bon réflexe est de tester la vérification comme HAProxy la fait, avec
openssl verify -x509_strict -purpose sslserver, et non avec la commande
nue qui répond « OK » à tort. Cette leçon décrit ces causes pour les
reconnaître ; la manière d'établir la confiance relève d'une autre leçon.
Quand le routage est-il vraiment fautif, et comment le reconnaître ?
Section intitulée « Quand le routage est-il vraiment fautif, et comment le reconnaître ? »Une panne de routage ne se lit pas dans le code de retour, mais dans la
décision : quel backend a été choisi, et pourquoi. Quatre défauts reviennent,
et chacun trompe d'une façon différente. Le premier est un frontend sans
default_backend : il rend un 503, parce qu'aucune décision n'a été prise,
ce qui est un défaut de configuration et non un refus voulu.
Les trois autres sont silencieux. Une règle use_backend qui vise un backend
désactivé ou non publié est ignorée, et l'évaluation continue vers la
règle suivante : le routage « ne fait rien » sans aucune erreur. Un
use_backend calculé dont le nom est inconnu se rabat sur default_backend
sans erreur à la validation, donc haproxy -c ne le voit pas. Enfin la
première règle qui correspond gagne : une règle ajoutée au-dessus rend
inatteignables celles qui la suivent, sans qu'aucune soit fausse.
Le seul cas qu'aucun code ne révèle est un 200 avec le mauvais marqueur. La requête a été servie, mais par le mauvais backend. Pour le trouver, comparez ce que la route devrait renvoyer à ce qu'elle renvoie, avec un marqueur propre à chaque backend. Le routage et l'ordre des règles sont détaillés dans Router par noms et chemins avec ACL et maps.
Quelles lectures font conclure à tort ?
Section intitulée « Quelles lectures font conclure à tort ? »Plusieurs signaux qui paraissent probants ne prouvent rien, et le diagnostic se trompe en les prenant au mot. Chacun a été mesuré ou établi sur HAProxy 3.4, et chacun fait corriger le mauvais élément.
- La version est masquée sur la page de statistiques depuis la 3.4
(
stats show-versionest désactivé par défaut). Un contrôle qui y lisait la version échoue : utilisezhaproxy -v. - HAProxy ne supprime pas son socket UNIX en s'arrêtant. Un test de la présence du fichier conclut à tort que le service tourne ; il faut interroger le socket, pas le chercher sur le disque.
- Un statut
UP 4/5ouDOWN 1/3apparaît pendant une transition. Le suffixe compte les contrôles obtenus sur ceux qu'il faut : comparer le statut à l'égalité stricte lit donc une montée en cours comme un retrait. - Un statut renseigné ne prouve pas que l'application a répondu.
$upstream_statuscôté Nginx peut être renseigné sans que l'application ait répondu ; la lecture des journaux Nginx est détaillée dans Observer Nginx : journaux, stub_status et amont. - Un backend entièrement
DOWNest presque toujours une sonde, pas une panne.option httpchk GET <chemin>échoue si le chemin n'existe pas, et fait alors tomber tous les serveurs, les sains compris.
Le dernier point renvoie à la leçon sur les sondes, qui mesure les compteurs chkfail et chkdown. Une panne courte doit incrémenter le premier sans toucher le second : c'est ainsi qu'on distingue un seuil qui tient d'un seuil qui oscille.
Comment corriger sans retirer ce qui protège ?
Section intitulée « Comment corriger sans retirer ce qui protège ? »On corrige la cause, jamais la garantie : retirer verify required ou les
sondes fait repartir le service et supprime en même temps ce qui le protégeait.
C'est la tentation d'une astreinte à trois heures du matin, et c'est ce que le
lab mesure. verify none sur le backend et le retrait des check font repartir
le service dans deux des cinq variantes, ce qui donne l'impression d'avoir
trouvé la cause alors qu'on l'a rendue invisible.
Deux canaris servent à le mesurer, et ils font partie de l'état sain.
/api-usurpe/ mène à un backend dont le certificat est signé par une autorité
étrangère et qui porte le même nom que le légitime : il doit rester refusé,
car son refus prouve que la vérification TLS est stricte. sonde-cassee est un
serveur vivant dont la readiness échoue en permanence : il doit rester hors
service. Après votre correction, les routes saines répondent, et les deux
canaris tiennent encore leur rôle.
Pour une saturation, la démarche est la même : regardez qcur et scur dans show stat. Une file qui ne se vide pas pointe un client coincé, et show sess le nomme. Terminez par un dossier qui nomme la cause et la
distingue de son symptôme : « le 503 est le symptôme, la cause est
l'autorité sans keyUsage ».
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab tire au hasard une panne parmi cinq familles (routage, sonde de santé, confiance TLS vers le backend, limite de trafic, saturation) et pose du bruit par-dessus : un frontend pour un nom abandonné, un fichier de notes, un serveur déclaré en panne exprès. Vous ne savez pas laquelle vous aurez, d'où une méthode et non une liste. La validation porte sur quatre contrôles : un dossier qui nomme la cause et la distingue de son symptôme, le service et les routes saines restaurés depuis un client indépendant, les deux canaris qui tiennent encore leur rôle, et l'administration et les backends qui restent injoignables depuis le client. Le dossier est relu par une personne.
À retenir
Section intitulée « À retenir »Un diagnostic fiable suit un ordre fixe et refuse de retirer la garantie qui a détecté la panne.
- Lisez dans l'ordre la configuration effective
(
haproxy -c -f /etc/haproxy/haproxy.cfg -V), l'état des serveurs (show stat) puis le code de terminaison du journal. - Un code HTTP oriente et ne conclut pas : un 503 vient de plusieurs familles de pannes, et un 200 peut venir du mauvais backend.
SC--dit un échec à l'établissement, côté serveur ;Dmarque une coupure paron-marked-down shutdown-sessions.- Posez
ssl_bc_err_strdans lelog-formatavant la panne : il donne la raison OpenSSL exacte, par exemple « certificate verify failed ». - Un 503 avec un serveur
UPvient de la vérification TLS stricte : une autorité sanskeyUsageou unsnimanquant, pas du routage. - Un frontend sans
default_backendrend 503, unuse_backendvers un backend désactivé est ignoré, ethaproxy -cne voit pas unuse_backendcalculé au nom inconnu. - Ne comparez pas
UP 4/5à l'égalité stricte, ne testez pas la présence du socket, et ne lisez pas la version sur la page de statistiques en 3.4. - Corrigez la cause : retirer
verify requiredou les sondes rétablit le service en supprimant la garantie, et les deux canaris sont là pour le mesurer.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Huit questions vérifient que vous savez lire un code de terminaison, reconnaître un 503 qui n'est pas un routage et corriger sans retirer une garantie, une fois le lab joué.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Recharger, mettre à jour et reprendre HAProxy
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications