Observer un service publié, c'est mesurer ce que le client a réellement reçu, puis décider à partir de quel écart on réveille quelqu'un. Le point d'entrée est le service qui reçoit les requêtes des clients, le plus souvent un reverse proxy (un serveur placé devant vos applications, qui reçoit les requêtes à leur place). Cette leçon s'adresse à une personne qui publie déjà un service et qui veut savoir si ce service va bien. Elle apprend à définir un indicateur de succès, à régler une alerte, à relier une requête à son backend (l'application qui répond derrière le proxy), et à ne pas confondre un silence avec une bonne santé.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Définir un indicateur de niveau de service vu du client : quelles requêtes comptent, lesquelles réussissent.
- Régler les trois seuils d'une alerte à partir de mesures, pas de valeurs au hasard.
- Distinguer une panne réelle, une absence de trafic et une collecte perdue.
- Relier une requête en échec à son backend et à sa durée par un identifiant.
- Prouver qu'une alerte se déclenche sur une vraie panne et revient à la normale.
Prérequis
Section intitulée « Prérequis »Cette leçon suppose que vous savez lire un échange HTTP, que vous avez déjà protégé un point d'entrée et que vous manipulez un fichier YAML. Elle ne réexplique pas ces gestes.
- Lire un échange HTTP : méthode, chemin, code de statut.
- Définir une politique de sécurité du point d'entrée : savoir ce que le journal ne doit jamais contenir.
- Savoir interroger une URL avec
curl.
Que traite cette leçon, et que laisse-t-elle aux autres pages ?
Section intitulée « Que traite cette leçon, et que laisse-t-elle aux autres pages ? »Cette leçon traite ce que le service rendu laisse comme traces au point d'entrée, et la décision qui mène du signal à l'alerte, sans dépendre d'un outil. Le sujet existe ailleurs sur le site, sous d'autres angles, et le plus simple est de dire qui fait quoi.
Les guides d'outil montrent comment obtenir les signaux : Observer Traefik avec les journaux et métriques, Observer Nginx et Protéger et observer HAProxy donnent les directives, les champs et les points d'état propres à chaque produit. La leçon L'observabilité dans l'architecture raisonne au niveau d'un système entier : le pipeline du signal, et la panne de l'observabilité elle-même. La page Monitoring vs observability cloud pose les trois piliers.
Ici, on prend le service vu de l'entrée : quel indicateur retenir, comment l'écrire en définition précise, à partir de quel écart c'est grave. La théorie des objectifs et du budget d'erreur reste dans SLI, SLO et budget d'erreur, qu'on ne reprend pas.
Que voit le point d'entrée que l'application ne voit pas ?
Section intitulée « Que voit le point d'entrée que l'application ne voit pas ? »Le point d'entrée voit chaque requête arriver, y compris celles qui n'atteignent jamais l'application, et c'est ce qui en fait le meilleur poste d'observation du service rendu. L'application ne connaît que les requêtes qu'elle a reçues et traitées. Le proxy, lui, voit aussi celles qu'il refuse lui-même, celles qui échouent avant d'arriver, et le temps total passé de bout en bout.
Quatre choses lui sont propres. Le refus qu'il prononce seul (un accès interdit, une limite de débit atteinte) n'apparaît pas dans le journal de l'application, qui ne reçoit jamais la requête. L'échec de connexion vers le backend, qu'il transforme en erreur pour le client, pas davantage, pour la même raison. Ce n'est pas une propriété magique du proxy : si un autre étage journalise en amont, ou si l'application applique elle-même un contrôle d'accès, le partage change. La durée totale inclut l'attente avant que l'application commence, que l'application ne mesure pas. Enfin, pour chaque requête, il connaît l'état renvoyé au client, le seul qui compte pour l'utilisateur.
Un piège en découle, établi par la leçon Délais, tentatives et cache : un rejeu (renvoyer une requête échouée vers un autre backend) peut masquer la panne au client. Le premier essai échoue, le second réussit, et le client reçoit un succès. Les erreurs vues par le client ne mesurent donc pas la santé réelle du backend. C'est pour cela que l'on observe au point d'entrée : lui seul voit chaque tentative vers le backend, pas seulement la réponse finale, comme le détaille la leçon Équilibrer et vérifier la santé d'un service. Dans le lab de cette leçon, il n'y a pas de rejeu : la route journalise directement, et la mesure porte sur ce qu'elle a répondu.
Qu'est-ce qu'un SLI, et que doit-on y compter ?
Section intitulée « Qu'est-ce qu'un SLI, et que doit-on y compter ? »Un SLI (Service Level Indicator, indicateur de niveau de service) est une proportion de requêtes réussies parmi les requêtes qui comptent, et tout le travail consiste à écrire ces deux mots : « réussies » et « comptent ». Sans cette définition écrite, deux personnes regardent le même tableau de bord et ne parlent pas de la même chose.
Prenons une boutique avec une route /paiement. Le dénominateur (le total sur lequel on divise) rassemble les requêtes d'affaires faites par de vrais clients vers cette route. Le numérateur (ce qu'on divise) ne garde que celles qui ont réussi. Si 90 requêtes sur 100 réussissent, l'indicateur vaut 0,9, soit 90 %.
Trois décisions se prennent par écrit. La première est la route. La route de santé, appelée par la supervision toutes les quelques secondes, n'est jamais une route d'affaires : elle répond presque toujours bien, et elle noie les vraies requêtes sous du bruit. Si elle entre au dénominateur, un service qui échoue une fois sur deux paraît en bonne santé. La deuxième est le critère de succès : un intervalle de codes de statut HTTP, par exemple de 200 à 299. La troisième est ce qu'on fait des codes de la famille 4xx, que le client provoque en demandant une page absente : le lab ne les rencontre pas, mais une définition honnête dit si on les compte, et pourquoi.
Voici le format d'un tel fichier pour la route /paiement d'un autre service. Chaque champ répond à une décision : route nomme la route comptée, exclut liste ce qui n'entre jamais au dénominateur, et les deux bornes fixent le succès.
route: /paiementexclut: - /santecode_min_succes: 200code_max_succes: 299Vérifiez toujours une définition sur un jeu connu avant de lui faire confiance. Si votre journal contient 10 requêtes d'affaires dont 5 échouent, plus 10 requêtes de santé réussies, un indicateur correct vaut 0,5. S'il affiche 0,75, la route de santé s'est glissée au dénominateur, et l'écart est le défaut lui-même.
Une disponibilité ne suffit pas toujours. La latence (le temps de réponse) se définit de la même façon : une proportion de requêtes plus rapides qu'un seuil. Évitez la moyenne, qui cache les requêtes lentes derrière beaucoup de requêtes rapides ; préférez un percentile, par exemple le 95e, la valeur que 95 % des durées ne dépassent pas. Le lab de cette leçon ne mesure que la disponibilité : la latence sert ici de complément à lire dans le journal.
Comment relier une requête en échec à son backend et à sa durée ?
Section intitulée « Comment relier une requête en échec à son backend et à sa durée ? »On relie une requête à son backend par un identifiant unique que le proxy attribue ou transmet, et que chaque journal inscrit sur sa ligne. Sans cet identifiant, l'astreinte (la personne de garde) voit un taux d'erreur monter et ne sait pas quelle requête regarder. Avec lui, elle cherche une ligne, lit le code, la durée, la route, et sait quel backend a répondu.
Cet identifiant s'appelle souvent identifiant de requête. Le client ou le proxy l'inscrit dans un en-tête HTTP, que l'application recopie dans son propre journal. Les guides d'outil montrent la directive exacte, par exemple dans Observer Nginx. Le journal du lab écrit une ligne JSON par requête, avec les champs ts (l'heure), id, route, code, latence_ms et lot.
Une corrélation (mettre en regard deux enregistrements qui parlent du même événement) se consigne par écrit. Pour l'incident déjà journalisé du lab, le fichier porte quatre champs : l'identifiant de la requête (requete_id), le backend qui l'a servie, le code renvoyé et la durée (duree_ms). Voici le format, avec les valeurs d'un autre incident.
requete_id: incident-a1b2c3backend: pub-obs-paiementcode: 503duree_ms: 412Le nom du backend n'est pas écrit dans le journal du lab. Ici, un seul service sert la route d'affaires : c'est le nom de son unité système qu'on reporte. La règle générale est de nommer le composant qui a répondu, pas celui qui a relayé.
Une règle de prudence accompagne la corrélation : l'identifiant doit rester inoffensif. Un jeton d'accès, un cookie ou un mot de passe n'a jamais sa place dans une ligne de journal, comme le rappelle la politique de sécurité du point d'entrée. De même, l'identifiant va dans le journal, jamais dans une étiquette de métrique : chaque valeur distincte crée une série à stocker, et un identifiant unique par requête les multiplierait sans limite.
Quand une alerte mérite-t-elle un réveil ?
Section intitulée « Quand une alerte mérite-t-elle un réveil ? »Une alerte mérite un réveil quand un indicateur d'affaires franchit un seuil que la panne dépasse et que le calme ne dépasse pas, sur une durée assez longue pour ne pas sonner à chaque hoquet. Une alerte est une règle qui compare une mesure à un seuil et prévient quelqu'un quand elle le franchit. Une règle qui ne sonne jamais ne protège de rien, une règle qui sonne tout le temps finit ignorée.
Trois réglages définissent l'alerte du lab, dans un fichier de politique relu en continu. Chacun a son piège, et chacun se règle à partir d'une mesure du service sain, jamais d'une valeur devinée.
Le premier est le seuil de taux d'erreur. Le taux d'erreur est la part de requêtes en échec dans une fenêtre, un nombre entre 0 et 1. Un seuil supérieur à 1 est hors d'atteinte : l'alerte ne se déclenchera jamais. Un seuil nul sonne sur la moindre erreur isolée, voire en permanence. Le bon seuil se place entre le taux du service sain et celui de la panne injectée.
Le deuxième est le volume minimum de trafic. Sur dix requêtes, une erreur donne 10 %, alors que sur dix mille elle donne 0,01 % : un taux calculé sur trop peu de requêtes ne signifie rien. Ce seuil fixe le nombre de requêtes sous lequel on refuse de conclure. Placé trop haut, il fait passer le trafic normal pour une absence : on le règle d'après le volume du service sain, qu'on observe d'abord.
Le troisième est la fraîcheur de la collecte, traitée dans la section suivante. Les deux premiers portent sur une fenêtre glissante, un intervalle récent qui avance avec l'horloge. Dans le lab, l'exportateur (le programme qui relit le journal et compte les requêtes) retient les 10 dernières secondes. Cette fenêtre est aussi le délai de l'alerte : elle sonne quand la fenêtre est assez remplie d'erreurs, et ne se résout pas à la première réussite.
Une alerte utile s'accompagne d'un runbook, une courte fiche qui dit quoi regarder d'abord et qui prévenir. Elle repose sur l'astreinte : sa qualité se juge à ce que cette personne comprend en la lisant à trois heures du matin. Pour la mécanique des règles d'alerte, voir le guide Alerting.
Comment distinguer une panne, une nuit calme et une collecte bloquée ?
Section intitulée « Comment distinguer une panne, une nuit calme et une collecte bloquée ? »Le silence a trois causes que le tableau de bord confond : une vraie panne, une absence de trafic et une collecte perdue, et les deux dernières interdisent de conclure que tout va bien. L'astreinte qui ouvre un tableau de bord vide ne peut pas dire si la nuit a été bonne ou si personne ne regardait. La seule parade est d'apprendre au système à nommer chaque cas.
Une collecte est le chemin qui transforme les requêtes en mesures : l'exportateur relit le journal et publie des compteurs, que l'évaluateur interroge. Elle peut tomber sans que le service tombe. Ses chiffres restent alors figés à leur dernière valeur, et ils ont l'air normaux. Un évaluateur qui ne vérifie pas leur âge annonce une santé fantôme.
Le schéma suit l'ordre des questions de l'évaluateur du lab. Regardez que la panne réelle n'est atteinte qu'après deux réponses positives : la collecte est récente, et le trafic est suffisant. Les deux cases grisées sont des cas où l'on ne conclut rien.
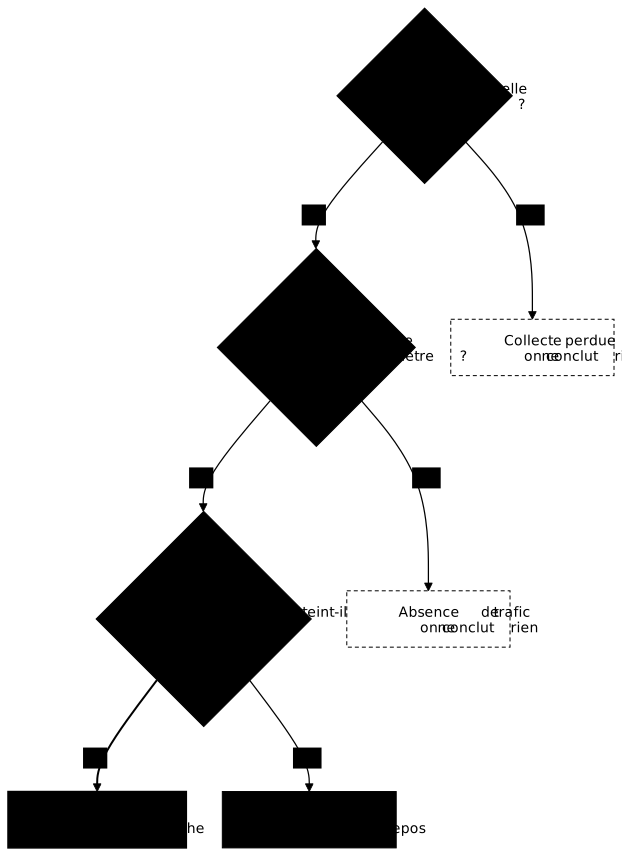
Ce qui rend le diagnostic fiable, c'est que la fraîcheur et le volume soient vérifiés avant le taux d'erreur, et non l'ordre précis de ces deux-là entre eux. Si l'on calculait le taux d'erreur d'abord, une collecte figée afficherait un taux de 0 et l'on dirait « tout va bien ». Si l'on ne vérifiait pas le volume, une nuit sans client passerait pour une réussite à 100 %, ou provoquerait une division par zéro. L'ordre retenu ici est celui de l'évaluateur du lab ; c'est un principe de conception raisonnable, pas une loi.
Le premier réglage, la fraîcheur maximale de la collecte, se place entre deux bornes. Elle doit dépasser la période de rafraîchissement de l'exportateur, que vous lisez en comparant deux valeurs successives de pub_obs_export_timestamp sur son point /metrics. Elle doit rester assez courte pour qu'un exportateur gelé quelques secondes soit détecté. Les dix minutes du réglage de départ ne signaleraient la perte que bien après la fin de l'incident.
Le même raisonnement vaut pour le trafic : l'absence de trafic ne se déclare que si le volume de la fenêtre passe sous le minimum, et il ne peut y passer que si le minimum est au-dessus de zéro. L'évaluateur rend un diagnostic JSON à l'adresse /diagnostic, avec les champs classification, firing (l'alerte sonne-t-elle), taux_erreur et total_fenetre. Lisez-le avant de régler quoi que ce soit.
Comment prouver qu'une alerte fonctionne vraiment ?
Section intitulée « Comment prouver qu'une alerte fonctionne vraiment ? »On prouve une alerte en provoquant la panne qu'elle doit détecter, en attendant qu'elle sonne, puis en réparant et en attendant qu'elle se taise. Une alerte qui n'a jamais été vue sonner n'a qu'une valeur théorique : le seuil peut être hors d'atteinte, la fenêtre trop longue, la règle mal branchée, et rien ne le dit tant qu'une vraie panne n'arrive pas.
La méthode tient en quatre gestes. Mesurez d'abord l'état nominal : classification nominal, firing à faux, un volume de trafic dans la fenêtre. Provoquez ensuite la panne : dans le lab, poser le fichier /var/lib/pub-obs/panne fait répondre 500 à la route /commande, et le retirer la répare. Attendez la durée de la fenêtre, puis lisez /diagnostic : la classification doit passer à panne_reelle avec firing à vrai. Réparez, attendez encore, et vérifiez le retour à faux.
sudo touch /var/lib/pub-obs/pannecurl -s http://127.0.0.1:<port-evaluateur>/diagnosticsudo rm -f /var/lib/pub-obs/panneLe port de l'évaluateur est donné dans /home/student/README-obs, car il est tiré au hasard à chaque préparation. Après quelques secondes de panne, la sortie attendue est un objet JSON dont classification vaut panne_reelle. Si elle reste nominal ou absence_trafic après deux fenêtres, un seuil est mal placé.
Les deux autres cas se provoquent de la même façon. Pour l'absence de trafic, on arrête le générateur fourni (systemctl stop pub-obs-generateur.service) : le diagnostic doit dire absence_trafic, jamais panne_reelle, puisque aucune requête n'échoue. Pour la collecte perdue, on gèle l'exportateur avec le signal SIGSTOP, qui suspend un processus sans le tuer, et le diagnostic doit finir par dire collecte_perdue. Dans les deux cas, on remet l'état d'origine ensuite, sinon le tableau de bord reste muet.
Mettre en pratique
Section intitulée « Mettre en pratique »Dans le lab, une route d'affaires tourne sur la machine edge.lab, derrière une collecte qui fonctionne mais dont la politique est volontairement mal réglée. Vous écrivez /home/student/sli.yaml, vous corrigez /etc/pub-obs/politique.yaml pour que l'évaluateur distingue les trois cas, et vous écrivez /home/student/correlation.yaml pour l'incident nommé dans /home/student/README-obs.
La validation applique votre sli.yaml à un lot historique connu, qui doit donner 10 requêtes dont 5 réussies, puis à un lot frais de 10 requêtes d'affaires, 6 réussies, plus 3 requêtes de santé qui ne comptent pas. Elle compare votre corrélation à la vraie ligne du journal. Enfin, elle provoque trois situations : une panne classée panne_reelle avec l'alerte active en 25 secondes puis résolue en 25 secondes, un générateur arrêté qui doit donner absence_trafic, et un exportateur gelé qui doit donner collecte_perdue. Elle exige aussi nominal quand tout tourne. La latence n'est pas mesurée.
À retenir
Section intitulée « À retenir »- Le point d'entrée voit chaque requête, y compris celles que l'application ne voit jamais, et chaque tentative vers le backend.
- Un rejeu peut masquer une panne au client : les erreurs vues par le client ne mesurent pas la santé réelle du backend.
- Un SLI est une proportion de succès parmi les requêtes qui comptent ; la route de santé n'y entre jamais.
- Une définition se vérifie sur un jeu connu avant d'être crue.
- Un identifiant de requête relie le proxy, le backend, le code et la durée, sans jamais porter de secret.
- Un seuil de taux d'erreur supérieur à 1 ne sonne jamais, un seuil nul sonne tout le temps.
- L'évaluateur teste d'abord la fraîcheur de la collecte, puis le volume, puis le taux d'erreur.
- Le silence n'est pas une bonne nouvelle : absence de trafic et collecte perdue sont deux cas à nommer.
- Une alerte se prouve en provoquant la panne, puis en la réparant.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Le quiz vérifie que vous savez définir un indicateur, régler une alerte et lire un silence sans le prendre pour de la santé.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Préparer la publication, la reprise et le retour arrière
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications