Pour modifier l'état de HAProxy à chaud sans ouvrir une porte à tous les comptes de la machine, donnez à la lecture et à l'action deux sockets distincts, chacun avec son niveau et son groupe, puis faites écrire l'état des serveurs dans un fichier par le rechargement lui-même. Cette leçon s'adresse à qui exploite déjà un HAProxy 3.4 et veut qu'un collecteur de métriques lise sans pouvoir toucher aux serveurs, qu'un exploitant sorte un serveur du service sans éditer la configuration, et qu'un rechargement n'annule pas cette décision. Le socket d'administration est le fichier par lequel on interroge et on pilote HAProxy en marche, sans toucher à sa configuration. La leçon couvre les droits de ce socket, la persistance de l'état et le retour au nominal.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »La leçon va de la porte ouverte à la décision qui survit à un rechargement.
- Distinguer le mode d'un socket, qui dit qui l'ouvre, de son niveau, qui dit ce qu'on y fait.
- Séparer la lecture de l'état et l'action sur l'état, chacune avec son socket et son groupe.
- Placer
server-state-fileetload-server-state-from-filedans la bonne section de la configuration. - Accrocher la sauvegarde de l'état des serveurs au rechargement, avec un drop-in systemd.
- Prouver qu'une décision prise à chaud change le trafic et survit au rechargement.
- Livrer une méthode de retour au nominal qu'on peut exécuter.
Prérequis
Section intitulée « Prérequis »La leçon suppose un HAProxy qui tourne et un compte capable d'utiliser
sudo. Les commandes ont été établies sur HAProxy 3.4.7, le paquet
3.4.7-1~bpo13+1 du dépôt trixie-backports-3.4 de Debian 13, qui est la
version du lab. Seul le drop-in systemd de la section sur la persistance
n'a pas encore été rejoué, et la page le dit à l'endroit où elle l'enseigne.
- Installer HAProxy 3.4, lire ses sections et interroger son socket avec
socat: Installer HAProxy et lire ses sections de configuration. - Sortir un serveur du service avec
set server … state drain, et savoir ce que fait le drainage : Choisir la répartition et mesurer les sondes. - Comprendre un mode de fichier (
660), un propriétaire et un groupe : Permissions Linux et Utilisateurs et groupes. - Savoir ce qu'est une unité systemd et recharger un service avec
systemctl: systemctl : lister, démarrer et diagnostiquer les services Linux.
Pourquoi le socket d'administration de HAProxy est-il une surface à protéger ?
Section intitulée « Pourquoi le socket d'administration de HAProxy est-il une surface à protéger ? »Le socket d'administration est l'API d'exécution de HAProxy (runtime API) :
tout compte qui peut s'y connecter lit l'état du proxy et, selon le niveau du
socket, le modifie sans toucher à haproxy.cfg. Un socket Unix est un
fichier spécial par lequel deux programmes de la même machine dialoguent ; ses
droits sont donc ceux d'un fichier. Dans global, la ligne stats socket en
fixe quatre : le chemin, le mode (qui peut ouvrir le fichier), le
groupe propriétaire et le niveau (ce que la connexion a le droit de
demander à HAProxy).
Le piège est que le mode et le niveau se confondent. Un socket en
mode 666 s'ouvre depuis n'importe quel compte, y compris un compte sans groupe
ni sudo, et s'il porte level admin, ce compte peut sortir un serveur du
service. Rien ne casse et rien ne s'affiche : le proxy fonctionne, c'est
pour cela que personne ne regarde.
Pour mesurer ce que votre socket laisse faire, jouez la commande sous l'identité d'un compte sans droit particulier :
sudo -u <compte> sh -c "echo 'show info' | socat -t2 stdio /run/haproxy/admin.sock"Si la réponse affiche des champs comme Nbthread, ce compte lit votre proxy.
Si elle affiche un refus de connexion, la porte est fermée pour lui.
Comment séparer la lecture de l'action avec deux sockets ?
Section intitulée « Comment séparer la lecture de l'action avec deux sockets ? »Déclarez deux lignes stats socket dans global : l'une en level operator pour lire, l'autre en level admin pour agir, chacune en mode 660
avec son propre group. Le niveau appartient au socket, pas au compte : un
même socket ne peut pas laisser lire un groupe et laisser agir un autre. Il en
faut donc deux, et chacun se règle sur le moindre privilège, c'est-à-dire sur
le droit strictement nécessaire à son usage.
global stats socket /run/haproxy/sondes.sock mode 660 group sondes level operator stats socket /run/haproxy/pilotage.sock mode 660 group pilotes level adminLe mode 660 répond à la question « qui ouvre le fichier ? » : le
propriétaire et le groupe, personne d'autre. Le level répond à « que
peut-on demander ? ». Le manuel de HAProxy 3.4 définit trois niveaux : user
ne lit que des statistiques non sensibles, operator (le niveau par défaut)
lit tout et n'autorise que des changements « non sensibles » selon le manuel
(« non-sensitive changes »), comme remettre à zéro les compteurs maximum, et
admin permet tout, dont set server.
Ne lisez pas « non sensible » comme « inoffensif ». Mesuré sur HAProxy
3.4.1, un socket operator refuse les actions sur les serveurs (set server,
disable server, set weight, set maxconn, shutdown sessions), mais
accepte set table et clear table : un compte operator peut donc créer
ou effacer une entrée de stick-table, y compris un bannissement que le
module de protection y a inscrit. Réservez operator à des comptes de
confiance, et ne le tenez pas pour un niveau en lecture seule. Le message
exact d'un refus n'a pas été relevé sur la VM du lab : constatez-le vous-même.
Les deux réglages sont nécessaires : un socket en level operator mais en mode 666
laisse tout compte de la machine lire ce que le proxy sait, et un socket en
mode 660 mais en level admin donne l'action à tout son groupe.
| Réglage | Question posée | Valeur qui protège |
|---|---|---|
mode | Qui peut ouvrir le fichier ? | 660, jamais 666 |
group | Quel groupe l'ouvre ? | Un groupe par usage |
level | Que peut-on y demander ? | operator pour lire (comptes de confiance), admin pour agir |
Sur Debian, la section global contient déjà une ligne livrée stats socket (la section sur les sockets du paquet Debian la décrit). Remplacez-la par vos deux lignes plutôt
que d'en ajouter une troisième : un socket resté en level admin garde le
droit d'agir pour son groupe.
Le socket ne se crée qu'au chargement de la configuration, donc après un
haproxy -c -f /etc/haproxy/haproxy.cfg qui valide le fichier et un
systemctl reload haproxy qui le prend en compte. Un compte ne rejoint un
groupe qu'à sa prochaine ouverture de session : pour tester sans se
reconnecter, jouez les commandes avec sudo -u <compte>, et vérifiez le groupe
avec id <compte> et le propriétaire avec ls -l /run/haproxy/.
Comment prouver que chaque identité a le bon droit ?
Section intitulée « Comment prouver que chaque identité a le bon droit ? »La séparation se prouve avec trois identités, jamais en relisant une ligne de
configuration : un compte qui lit, un compte qui agit, et un compte sans aucun
groupe qui ne doit rien pouvoir. Relire haproxy.cfg dit ce que vous avez
écrit, pas ce que HAProxy applique. La seule mesure fiable est de jouer la
commande sous chaque identité et de lire la réponse.
Le compte de lecture se connecte au socket sondes.sock et lit l'état avec
show info ou show stat. Le même compte tente ensuite une action sur ce
socket, par exemple set server applicatif/b state drain : HAProxy doit
refuser, et le serveur doit rester UP dans show stat. Le compte d'action
joue la même commande sur pilotage.sock et obtient DRAIN. Le compte sans
groupe tente show info sur les deux sockets et n'obtient rien.
Choisissez une opération réversible pour prouver le droit d'agir : sortir un
serveur du service puis le remettre en ready démontre le droit sans abîmer
quoi que ce soit. Vider une table ou couper des sessions ne se défait pas :
la machine resterait dans un état modifié pour les mesures suivantes. Pour lire
l'état d'un serveur d'un coup d'œil, la colonne status de show stat est la
dix-huitième du format CSV (le manuel la numérote 17 parce qu'il compte à
partir de zéro, alors que cut -f compte à partir de un) :
echo 'show stat' | sudo socat -t3 stdio /run/haproxy/pilotage.sock | cut -d, -f1,2,18Quels sockets le paquet Debian fournit-il, et lequel utiliser ?
Section intitulée « Quels sockets le paquet Debian fournit-il, et lequel utiliser ? »Sur un HAProxy installé depuis le paquet Debian 13, avant toute modification,
deux sockets sont ouverts : /run/haproxy/admin.sock, en mode 660 et au
niveau admin, qui pilote le worker, et /run/haproxy-master.sock, qui est celui
du processus maître.
HAProxy tourne en effet en deux sortes de processus : un processus maître,
qui supervise et orchestre les rechargements, et des workers, qui traitent
le trafic. show servers state et set server se jouent sur le socket du
worker, celui que la section global déclare avec stats socket. Le piège est
de prendre l'autre pour un second socket d'administration.
Le socket du maître s'ouvre avec l'option -S de la ligne de commande de
haproxy. Savoir d'où elle vient sur votre machine se lit, ne se suppose pas.
L'unité systemd (le fichier de service qui lance HAProxy) du paquet
3.4.7-1~bpo13+1 de Debian 13 lance haproxy -Ws, mesuré sur ce paquet : -W
active le mode master-worker (un maître et des workers) et -s fait
prévenir systemd quand le service est prêt. Cette ligne ne porte pas -S
elle-même. Affichez la vôtre avec systemctl cat haproxy, et cherchez-y -S,
sans oublier les options supplémentaires ($EXTRAOPTS) qu'elle ajoute.
Les deux sockets ne parlent pas le même langage. Un show stat envoyé tel
quel sur le socket du maître ne rend aucune statistique : il rend la liste des
commandes qu'il accepte, parmi lesquelles show proc, show version et
show startup-logs. Les statistiques et set server se jouent sur le socket du
worker. Les droits du socket du maître ne sont pas ceux que vous venez de
régler pour les vôtres : contrôlez-les avec ls -l /run/haproxy-master.sock
avant de conclure que la séparation est faite.
Pourquoi un rechargement oublie-t-il un serveur sorti du service ?
Section intitulée « Pourquoi un rechargement oublie-t-il un serveur sorti du service ? »Un rechargement lance un nouveau processus qui relit haproxy.cfg et repart
de ses valeurs, alors qu'un set server … state drain ne modifie que la mémoire
du processus en cours. La décision prise à chaud vit donc exactement aussi
longtemps que ce processus. Dès qu'un rechargement a lieu, le serveur que vous
aviez sorti revient dans la rotation, comme si de rien n'était.
Le rechargement qui efface la décision est rarement celui que vous avez déclenché exprès. C'est celui qu'un autre événement a lancé, par exemple le renouvellement d'un certificat à quatre heures du matin : l'exploitation croit le serveur hors service pour la maintenance en cours, et le trafic y retourne. La leçon Router par noms et chemins avec ACL et maps mesure le même effet sur une table de routage modifiée à chaud.
Le moyen de le constater est le trafic, pas l'état. show stat dit ce que
HAProxy pense ; une boucle de requêtes dit ce qu'il fait :
for i in $(seq 20); do curl -s http://<adresse-du-proxy>/; done | sort | uniq -cSi chaque serveur renvoie son nom, le décompte montre qui reçoit le trafic. Un
serveur marqué sortant dans show stat mais présent dans ce décompte est un
état affiché, pas une décision appliquée.
Comment faire survivre l'état des serveurs à un rechargement ?
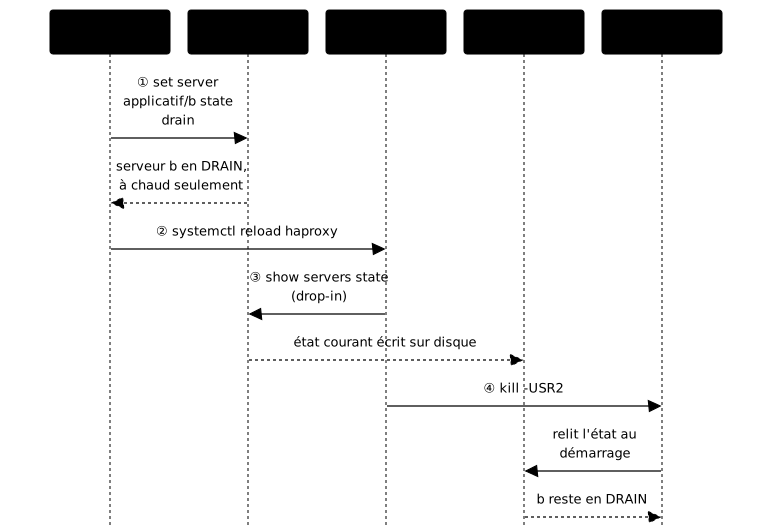
Section intitulée « Comment faire survivre l'état des serveurs à un rechargement ? »HAProxy sait relire un fichier d'état au démarrage, mais il faut trois gestes et non deux : déclarer le fichier, demander à le charger, et l'écrire juste avant chaque rechargement. Les deux premiers sont de la configuration, le troisième est une commande, et c'est le troisième que les recettes publiées oublient. En production, il ne se joue pas à la main : il s'accroche au rechargement lui-même.
Ces trois gestes ne sont pas les étapes du schéma. Le schéma suit une décision
dans le temps, à travers un rechargement, en quatre étapes : décider sur le
socket, demander le rechargement à systemd, écrire le fichier d'état, puis
envoyer le signal. Les étapes 3 et 4 réalisent le troisième geste, et leur
ordre compte : le fichier d'état n'est écrit ni par la décision, ni par
HAProxy, il l'est par un show servers state que systemd joue avant le
signal. Les deux gestes de configuration, détaillés après le schéma, ne
servent qu'à relire ce fichier au démarrage.
La configuration tient en deux lignes, mais elles ne vont pas dans la même section :
global    server-state-file /var/lib/haproxy/serveurs.state
defaults    load-server-state-from-file global
server-state-file se déclare dans global : il dit où le fichier vit.
load-server-state-from-file se déclare dans defaults (ou dans un backend) :
il dit si les serveurs de cette section le relisent. Il accepte trois valeurs :
global (ici la valeur, pas la section du même nom) charge le fichier déclaré
par server-state-file, local un fichier par backend
(server-state-file-name), none ne charge rien pour ce backend. Placée dans
global, la seconde ligne fait refuser toute la configuration par HAProxy
3.4, dont le message d'erreur propose lui-même le mot-clé voisin. La plupart des recettes affichent
les deux lignes côte à côte sans préciser qu'elles n'ont pas la même section, et
un lecteur qui les recopie obtient un démarrage en échec. Validez toujours avec
haproxy -c -f /etc/haproxy/haproxy.cfg avant de recharger.
Ni l'une ni l'autre n'écrit le fichier. Pour comprendre ce qu'il faut produire, jouez d'abord le geste à la main, sur le socket d'administration :
echo 'show servers state' | sudo socat -t3 stdio /run/haproxy/pilotage.sock \ | sudo tee /var/lib/haproxy/serveurs.state > /dev/nullLe sudo tee n'est pas un détail. Une redirection > vers le fichier
d'état serait exécutée par votre shell et non par sudo, et
/var/lib/haproxy est le répertoire de confinement (le chroot) de HAProxy,
où votre compte n'a pas de raison d'écrire : regardez ses droits avec ls -ld /var/lib/haproxy. L'écriture échouerait dès que votre compte n'a pas le droit
de créer le fichier ; sudo tee fait écrire un écrivain privilégié, et le
> /dev/null final ne sert qu'à taire l'écho de tee dans le terminal. Sans
cette écriture, le fichier relu au rechargement est celui d'un état
antérieur, ce qui est pire qu'une absence de fichier puisque rien n'avertit.
Ce geste manuel garde un défaut, que le drop-in ci-dessous corrige : tee
tronque le fichier d'état dès le lancement du tube, avant que socat ait
répondu. Si socat échoue, le fichier reste vide.
Ce dump manuel sert à comprendre, pas à exploiter : il suppose qu'un humain y
pense avant chaque rechargement, y compris celui que lance le renouvellement
d'un certificat à quatre heures du matin. En production, on accroche le dump
au rechargement. Un drop-in systemd est un fichier de surcharge qui complète
l'unité du paquet sans la modifier (le durcissement d'un service
systemd en fait le même usage), et
sudo systemctl edit haproxy crée le vôtre dans
/etc/systemd/system/haproxy.service.d/override.conf.
ExecReload est la directive de l'unité qui liste, dans l'ordre, les
commandes que systemd exécute quand on lance systemctl reload haproxy. Le
piège tient à l'unité Debian, qui en porte deux, mesurées sur le paquet du
dépôt :
ExecReload=/usr/sbin/haproxy -Ws -f $CONFIG -f $CFGDIR -c $EXTRAOPTSExecReload=/bin/kill -USR2 $MAINPIDLa première valide la configuration, la seconde envoie le signal qui déclenche
le rechargement. Un drop-in qui se contente d'ajouter une ligne ExecReload
s'ajoute aux deux existantes : il passe donc après le signal, trop tard. Il
faut vider la liste en écrivant d'abord ExecReload= sans aucune valeur
(une ligne qui s'arrête au signe égal, et non une ligne blanche), puis réécrire
les trois lignes dans l'ordre voulu :
[Service]ExecReload=ExecReload=/usr/sbin/haproxy -Ws -f $CONFIG -f $CFGDIR -c $EXTRAOPTSExecReload=/bin/sh -c 'echo "show servers state" | socat -t3 stdio /run/haproxy/pilotage.sock > /var/lib/haproxy/serveurs.state.nouveau && mv /var/lib/haproxy/serveurs.state.nouveau /var/lib/haproxy/serveurs.state'ExecReload=/bin/kill -USR2 $MAINPIDLa validation de la configuration reprend telle quelle la ligne de
l'unité, -f $CFGDIR compris ($CONFIG, $CFGDIR et $EXTRAOPTS sont des
variables que l'unité définit et que le drop-in réutilise) : sans cette option,
le rechargement validerait une configuration différente de celle qui tourne. Le dump vient ensuite,
et le kill -USR2 en dernier. Ici pas de sudo tee : systemd exécute ces lignes en
root, et la redirection > est faite par le sh -c lui-même, donc avec ses
droits.
L'ordre n'est pas un détail. Le signal lance le nouveau processus, qui relit
haproxy.cfg et le fichier d'état à son démarrage ; un dump écrit après le
signal arrive après la lecture, et le fichier relu est celui de l'état
précédent. Si le dump échoue, systemd n'exécute pas la ligne suivante et le
rechargement est annulé, ce qui est le comportement voulu.
Le fichier temporaire et le mv ne sont pas une précaution de style, et
c'est le genre de détail qui se paie une seule fois. Une redirection > ouvre
et tronque sa cible avant que la commande écrive quoi que ce soit : un
socat qui échoue laisserait donc un fichier vide, et non l'état
précédent. Le rechargement serait bien annulé, mais la décision à conserver
serait déjà perdue. Écrire à côté puis déplacer rend la substitution
atomique sur un même système de fichiers : tant que le dump n'a pas réussi,
l'ancien état reste lisible.
Ce drop-in n'a pas encore été rejoué sur la VM du lab : le guillemetage
de la ligne sh -c, l'écriture sans sudo et l'arrêt de la suite quand une
ligne échoue restent à constater. Il se vérifie en rechargeant avec sudo systemctl reload haproxy, puis en relisant le fichier d'état pour y
chercher le serveur sorti du service.
Comment revenir à l'état nominal sans laisser de piège ?
Section intitulée « Comment revenir à l'état nominal sans laisser de piège ? »Un retour au nominal complet fait deux gestes dans cet ordre : remettre le
serveur en service sur le socket d'administration avec set server … state ready, puis réécrire le fichier d'état depuis show servers state. Si vous ne
faites que le premier, le serveur est de retour tout de suite, mais le fichier
d'état garde l'ancienne décision. Avec le drop-in, le prochain
rechargement le réécrit d'abord depuis l'état courant ; sans lui, ou si HAProxy
est rechargé hors de systemd, il ressort l'ancienne décision. Le script de
retour ne suppose donc pas le drop-in : il réécrit le fichier lui-même.
Les deux gestes reprennent les commandes déjà vues, sur le socket d'action :
echo 'set server applicatif/b state ready' | sudo socat -t3 stdio /run/haproxy/pilotage.sockecho 'show servers state' | sudo socat -t3 stdio /run/haproxy/pilotage.sock \ | sudo tee /var/lib/haproxy/serveurs.state > /dev/nullOublier le second geste est le piège symétrique de la persistance, dès que le drop-in manque ou que le rechargement a lieu hors de systemd, et il se prouve de la même façon : après le retour, rechargez, puis regardez qui reçoit le trafic. Les deux serveurs doivent répondre. Un retour qui n'a pas été vérifié par un rechargement n'a prouvé que sa moitié.
La méthode de retour se livre comme un script exécutable, pas comme une page de consignes : une méthode qui n'a jamais été jouée n'est pas une méthode de retour, et la machine à trois heures du matin n'a pas le temps de découvrir qu'une commande de la procédure était fausse. Ce script s'accompagne d'un dossier relu par un humain, qui répond à trois questions : quelle décision a été prise, par quelle voie, et comment on revient. L'exécutable sert la machine, le dossier sert la personne qui reprend la garde.
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab part d'un HAProxy qui fonctionne, avec un seul socket en mode 666 au niveau admin, aucun fichier d'état, deux serveurs derrière le proxy et trois identités de test : un compte qui doit lire, un compte qui doit agir et un compte qui ne doit rien pouvoir. Vous séparez la lecture de l'action, vous faites survivre une décision à un rechargement et vous livrez un retour au nominal. La validation porte sur quatre mesures : les trois identités jouent chacune leurs commandes (contrôle critique), le retrait d'un serveur change réellement le serveur qui répond, la décision survit à un rechargement lu dans l'état que HAProxy rapporte, et le retour au nominal est exécuté puis tient à un second rechargement.
À retenir
Section intitulée « À retenir »Séparer la lecture de l'action et faire écrire l'état par le rechargement sont deux chantiers distincts, et le second est le plus souvent oublié.
- Le mode d'un socket dit qui l'ouvre, le niveau dit ce qu'on y fait : les deux sont nécessaires.
- Le niveau appartient au socket, donc il faut deux sockets :
operatorpour lire,adminpour agir, chacun avec son groupe ;operatorne touche pas aux serveurs mais peut modifier les stick-tables. - Une séparation se prouve avec trois identités, dont une sans aucun groupe.
server-state-fileva dansglobal,load-server-state-from-filedansdefaultsou unbackend; dansglobal, la seconde fait refuser la configuration.- Ni l'une ni l'autre n'écrit le fichier : le
show servers stateà la main sert à comprendre, en production un drop-in systemd le joue avant le signal. - Le drop-in remet
ExecReload=à zéro puis réécrit les trois lignes (validation avec-f $CFGDIR, dump,kill -USR2) : une ligne ajoutée passerait après le signal. Le dump écrit dans un fichier temporaire puis le déplace avecmv, pour qu'un échec ne laisse jamais un fichier d'état vide. - Le socket du processus maître (option
-S) ne répond pas aux mêmes commandes que celui du worker : contrôlez ses droits, ne le supposez pas fermé. - Un
set serverne vit que dans la mémoire du processus : un rechargement l'efface sans prévenir. - Le trafic dit ce que HAProxy fait,
show statce qu'il pense. - Un retour au nominal fait deux gestes, remettre en service puis réécrire le fichier, et se livre comme un script exécutable joué.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Huit questions vérifient que vous savez placer les directives, séparer les droits et enchaîner les trois gestes avant de passer au lab.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Diagnostiquer HAProxy sans masquer la cause
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications