Pour mettre à jour une application derrière HAProxy sans couper personne, rechargez la configuration au lieu de redémarrer le service, ne retirez jamais la génération que vous venez de remplacer, et gardez le moyen de revenir. Cette leçon s'adresse à qui exploite déjà un HAProxy 3.4 et doit livrer une nouvelle version de son application, puis la reprendre si elle se comporte mal. Elle explique le couple maître-ouvriers, la règle de livraison qui en découle et la façon de prouver qu'une bascule n'a rien coupé. Elle ne traite ni le socket d'administration ni l'état des serveurs à chaud.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »La leçon va du mécanisme à la preuve, en passant par la règle de livraison.
- Décrire ce qu'un rechargement fait au processus maître et à ses ouvriers.
- Énoncer la règle : une livraison retire la génération remplacée à la livraison précédente, jamais celle qu'elle remplace.
- Justifier qu'on ne remplace pas le maître, et lire son PID pour le prouver.
- Livrer une bascule réversible entre deux générations, avec son retour.
- Interpréter ce que la validation mesure, et ce qu'elle ne voit pas.
Prérequis
Section intitulée « Prérequis »La leçon suppose un HAProxy 3.4 en marche devant une application, et un
compte capable d'utiliser sudo. Les faits ont été établis sur HAProxy
3.4.7, version du lab, sur Debian 13.
- Installer HAProxy, lire ses sections et valider une configuration avec
haproxy -c: Installer HAProxy et lire ses sections de configuration. - Retirer un serveur sans couper ce qu'il sert, et savoir ce qu'est un flux long : Choisir la répartition et mesurer les sondes.
- Recharger et lire une unité systemd : systemctl : lister, démarrer et diagnostiquer les services Linux.
Que fait réellement un rechargement de HAProxy ?
Section intitulée « Que fait réellement un rechargement de HAProxy ? »Un rechargement ne remplace pas le processus maître : il lui fait démarrer de
nouveaux ouvriers, et laisse les anciens vivre jusqu'à la fin des connexions
qu'ils tiennent. En mode master-worker (maître et ouvriers, que l'option
-W active), HAProxy se compose de deux rôles. Le maître supervise et
relance les ouvriers ; les ouvriers (workers) portent la configuration,
traitent le trafic et tiennent les sockets d'écoute (un point d'écoute réseau par port ouvert). Au rechargement, le
maître récupère ces sockets auprès de l'ouvrier courant par un transfert de
descripteurs (un processus passe à un autre un socket déjà ouvert), puis les
remet aux nouveaux : le port n'est donc jamais
refermé d'une génération à l'autre. Un systemctl reload haproxy envoie au
maître le signal qui lui demande de relire la configuration et de lancer une
nouvelle génération d'ouvriers.
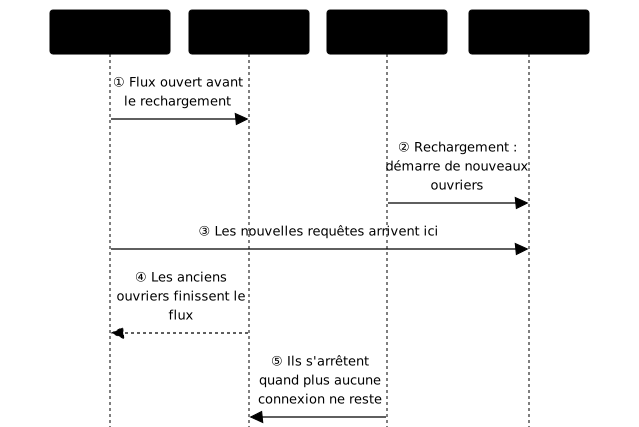
Les anciens ouvriers n'acceptent plus de nouvelles connexions : elles vont aux nouveaux. Mais ils continuent de servir celles qu'ils tenaient déjà, et ne s'arrêtent qu'une fois la dernière terminée. Les deux générations d'ouvriers coexistent donc, parfois quelques minutes. C'est exactement ce qui rend un rechargement sans coupure possible.
Le schéma suit un flux long à travers un rechargement. Regardez les étapes ① et ③ : le même client parle d'abord aux anciens ouvriers, puis ses nouvelles requêtes arrivent aux nouveaux, pendant que son flux ouvert se termine chez les anciens.
Les deux générations d'ouvriers se voient sur la machine. Les ouvriers sont les processus enfants du maître, et le PID du maître (son identifiant de processus) est celui que systemd connaît.
maitre=$(systemctl show -p MainPID --value haproxy)pgrep -P "$maitre"La première ligne lit le PID du maître, la seconde liste ses enfants. Juste après un rechargement, si un flux long est encore ouvert, vous voyez plus d'ouvriers qu'avant : les anciens et les nouveaux. Quand le dernier flux se ferme, les anciens disparaissent et la liste revient à sa taille d'origine. C'est aussi la mesure exacte que fait la validation du lab : elle compare l'ensemble des enfants avant et après, et exige qu'au moins un nouvel ouvrier soit apparu.
Le maître expose aussi un socket de commandes, ouvert par l'option -S, qui
accepte la commande show proc pour lister les processus. Il est décrit,
avec ses droits, dans Modifier l'état de HAProxy à chaud avec des droits
limités : cette leçon-là traite de ce
qu'on change dans un HAProxy qui tourne, celle-ci de ce qu'on change
autour de lui.
Pourquoi une livraison ne retire-t-elle pas la génération qu'elle remplace ?
Section intitulée « Pourquoi une livraison ne retire-t-elle pas la génération qu'elle remplace ? »Parce que les anciens ouvriers parlent encore à la génération qu'ils connaissaient : l'arrêter couperait les flux qu'ils servent. Une génération désigne ici une version de l'application avec son propre processus et son propre port (la 1.4.2 sur le port 18211, la 1.5.0 sur le 18212 dans le lab). Au moment du rechargement, la configuration pointe vers la nouvelle génération, mais les anciens ouvriers, eux, ont gardé la configuration d'avant.
Le piège est de livrer « proprement » : démarrer la 1.5.0, recharger, puis arrêter la 1.4.2 puisqu'elle ne sert plus. Rien ne casse sur une requête courte. Un flux long ouvert avant la bascule, lui, est servi par un ancien ouvrier qui parle à la 1.4.2 : son arrêt le coupe au milieu. Ce défaut ne se voit qu'en pleine bascule, ce qui explique qu'il passe les essais à froid.
La règle est donc : une livraison retire la génération qui avait été remplacée à la livraison précédente, pas celle qu'elle remplace. À ce moment, les anciens ouvriers qui parlaient à cette génération-là ont eu tout le temps de finir. La génération en cours de remplacement reste vivante, et sert aussi de retour arrière gratuit.
| Livraison | En service avant | En service après | Retirée par cette livraison |
|---|---|---|---|
| Aucune (départ) | 1.4.2 | 1.4.2 | rien |
livrer 1.5.0 | 1.4.2 | 1.5.0 | rien (1.4.2 reste vivante) |
| Livraison suivante, disons 1.6.0 | 1.5.0 | 1.6.0 | la 1.4.2, remplacée à la livraison d'avant |
Deux générations seulement existent dans le lab : la troisième ligne du tableau est un exemple que le lab ne joue pas. Retenez la mécanique : on garde toujours la génération en service et celle qu'elle vient de remplacer, et on retire celle d'avant.
Pourquoi ne faut-il jamais remplacer le processus maître ?
Section intitulée « Pourquoi ne faut-il jamais remplacer le processus maître ? »Parce que lui seul fait passer les sockets d'écoute d'une génération
d'ouvriers à la suivante : le remplacer emporte tout le service, ferme le port
le temps qu'un autre processus le rouvre, et aucune mesure côté client ne
rattrape une seconde pendant laquelle rien n'écoute. Un systemctl restart haproxy arrête le service puis le relance : maître et ouvriers disparaissent
ensemble, emportant les sockets, le successeur a un autre PID, et le port 80 est
fermé entre les deux. C'est bien la continuité du maître qui rend le
rechargement transparent, non le fait qu'il écouterait lui-même.
Une sonde cliente qui tire une requête toutes les 200 ms peut parfaitement ne rien voir de ce trou. La preuve ne se fait donc pas par le trafic mais sur la machine : on lit le PID du maître avant et après la bascule, et un PID différent signe un redémarrage déguisé en rechargement.
avant=$(systemctl show -p MainPID --value haproxy)sudo systemctl reload haproxyapres=$(systemctl show -p MainPID --value haproxy)[ "$avant" = "$apres" ] && echo "maître inchangé" || echo "maître remplacé"Le bloc compare les deux PID. Si vous lisez « maître inchangé », le port n'a
jamais été fermé. C'est la mesure que la validation fait, avec
systemctl show -p MainPID --value haproxy, avant et après l'exécution de
votre livraison. Un reload conserve le maître ; un restart, et tout
script qui passe par lui, le change.
Comment livrer une bascule réversible entre deux générations ?
Section intitulée « Comment livrer une bascule réversible entre deux générations ? »Réécrivez une seule ligne dans un seul fichier, validez, rechargez, et
n'arrêtez rien de ce que les anciens ouvriers utilisent encore. Le lab isole
ce qui change dans /etc/haproxy/service.d/generation.cfg, un fichier inclus
par HAProxy en plus de haproxy.cfg (deux options -f, ajoutées par une
surcharge de l'unité). La ligne qui change est celle du serveur :
backend applicatif option httpchk GET /pret http-check expect status 200 server courante 127.0.0.1:18211 check inter 1s fall 3 rise 2Passer à la 1.5.0 revient à remplacer le port 18211 par 18212. Rien d'autre
n'est en jeu, ce qui rend la livraison relisable et le retour identique à
l'aller. Le lab attend deux exécutables, livrer <version> et revenir, dans
le langage de votre choix : la validation les appelle, elle ne les lit pas.
Les étapes de livrer, dans cet ordre, sont toujours les mêmes :
- Démarrer la génération demandée et attendre qu'elle réponde, avant de
la montrer à HAProxy. Une unité modèle systemd
pub-maj-app@<version>(un seul fichier d'unité, où ce qui suit@désigne la version) la démarre sans rien éditer :systemctl enable --now. - Réécrire la ligne du fichier, après en avoir gardé une copie.
- Valider avec
haproxy -csur les deux fichiers, et restaurer la copie si la validation échoue : on ne recharge jamais une configuration invalide. - Recharger avec
systemctl reload haproxy, jamaisrestart. - Retirer la génération remplacée à la livraison précédente, et noter celle qu'on vient de remplacer pour la prochaine.
Voici l'esquisse d'une logique possible, à adapter : le lab n'impose ni langage ni structure, et cette version n'est pas la solution du lab rejouée telle quelle. Elle garde dans deux petits fichiers la génération en service et celle qu'elle a remplacée.
#!/usr/bin/env bashset -euo pipefailcible="$1"etat=/var/lib/pub-haproxy-mise-a-jourgen=/etc/haproxy/service.d/generation.cfgdeclare -A port=( [1.4.2]=18211 [1.5.0]=18212 )
install -d "$etat"courante=$(cat "$etat/courante" 2>/dev/null || echo 1.4.2)precedente=$(cat "$etat/precedente" 2>/dev/null || true)
systemctl enable --now "pub-maj-app@${cible}.service"until curl -sf "http://127.0.0.1:${port[$cible]}/pret" >/dev/null; do sleep 1; done
cp "$gen" "$gen.avant"sed -i "s/127.0.0.1:[0-9]*/127.0.0.1:${port[$cible]}/" "$gen"if ! haproxy -c -f /etc/haproxy/haproxy.cfg -f "$gen"; then    mv "$gen.avant" "$gen"; exit 1fisystemctl reload haproxy
if [ -n "$precedente" ] && [ "$precedente" != "$cible" ] \   && [ "$precedente" != "$courante" ]; then    systemctl disable --now "pub-maj-app@${precedente}.service"fiif [ "$courante" != "$cible" ]; then    systemctl disable "pub-maj-app@${courante}.service"fiecho "$courante" > "$etat/precedente"echo "$cible" > "$etat/courante"
Relisez la fin du script. La génération retirée par disable --now est
precedente, lue avant d'être écrasée : c'est la règle de la section
précédente, en une condition. La génération remplacée reçoit seulement
disable, sans --now : elle continue de tourner pour les anciens ouvriers,
mais ne redémarrera pas au prochain démarrage de la machine. Au reboot, ce qui
démarre est ce que le fichier de HAProxy désigne, rien de plus.
Un détail d'écriture mérite le détour, parce qu'il casse des scripts de
livraison bien plus souvent qu'on ne le croit. La dernière condition est un
if, et non un [ … ] && commande qui dirait la même chose en plus court.
Sous set -e, cette forme abrégée est dangereuse à une place précise : la
dernière d'un script ou d'une fonction. Un test faux n'arrête rien sur le
moment, car set -e ignore l'échec d'une commande placée à gauche d'un && ;
mais le code non nul du test devient celui du script ou de la fonction, et
c'est lui qui arrête l'appelant. Mesuré sur bash 5.2.21 : suivie d'une autre
instruction, la ligne laisse le script continuer et sortir en 0 ; en dernière
instruction d'une fonction, elle fait sortir le script en 1, et la ligne placée
après l'appel n'est jamais exécutée. L'échec est alors silencieux : rien n'a
réellement échoué, et le script s'est pourtant arrêté.
Comment revenir en arrière sans couper le service ?
Section intitulée « Comment revenir en arrière sans couper le service ? »Le retour est une bascule comme l'autre : on la rejoue vers la génération
précédente, avec la même validation, le même rechargement et la même exigence
de disponibilité. Un retour arrière qui coupe le service n'en est pas un, car
on l'exécute précisément quand quelque chose va déjà mal, et c'est le moment où
une coupure de plus coûte le plus cher. La validation du lab traite d'ailleurs
revenir comme un contrôle critique.
Avec l'esquisse de la section précédente, revenir tient en quelques lignes : il
lit precedente et rappelle livrer avec elle.
#!/usr/bin/env bashset -euo pipefailetat=/var/lib/pub-haproxy-mise-a-jourexec "$(dirname "$0")/livrer" "$(cat "$etat/precedente")"Le retour est sans surprise parce que la génération précédente vit toujours,
pour la raison de la règle : aucune livraison ne l'a retirée. Le retour se
mesure donc comme l'aller. Notez aussi que la condition
[ "$precedente" != "$cible" ] empêche livrer de retirer la génération
vers laquelle on revient, qui est justement la précédente lue au départ :
un retour ne détruit jamais son propre point d'arrivée.
Reste le cas de la machine qui redémarre. L'état « 1.5.0 en service » qui ne vivrait que dans la mémoire des processus disparaît au reboot, alors que le fichier que HAProxy lit au démarrage peut dire autre chose. Le lab éprouve cette cohérence en dernier : il redémarre la machine, vérifie que la 1.4.2 est de nouveau servie, puis rejoue une livraison complète et son retour. Le cycle doit rester opérant après un reboot, pas seulement le service.
Que prouve la validation du lab, et que laisse-t-elle de côté ?
Section intitulée « Que prouve la validation du lab, et que laisse-t-elle de côté ? »La validation prouve qu'une bascule jouée en pleine charge ne coupe ni le port, ni un flux établi, ni plus d'une requête courte ; elle ne prouve pas que vous avez respecté la règle de retrait. C'est un point à lire sans indulgence, parce qu'une preuve plus large que ce qu'elle mesure est la première cause de confiance mal placée.
Pour chaque bascule, aller comme retour, la validation :
- ouvre un flux long depuis le poste client, et attend ses premières lignes ;
- lance une sonde continue de requêtes courtes ;
- lit le PID du maître et la liste des ouvriers, puis exécute votre commande ;
- constate que le PID du maître est inchangé et qu'un nouvel ouvrier est apparu ;
- exige au plus une requête courte en échec ;
- exige que le flux long continue de recevoir et aille jusqu'à son terme, sans erreur, et sans changer de génération en route ;
- vérifie enfin que la version servie est celle attendue.
Remarquez ce que cette liste ne contient pas : aucune ligne ne vérifie que la génération d'avant est arrêtée ou conservée. La règle de retrait est mesurée indirectement : si vous arrêtez la génération remplacée, le flux long ne va pas à son terme et le contrôle échoue. En revanche, qu'une livraison laisse vivre trop de générations, ou qu'elle ne retire jamais la plus ancienne, ne fait échouer aucun test. Cette moitié de la règle reste à votre charge.
Au-delà de ces contrôles, le journal est relu par un humain. Le test vérifie seulement que le fichier existe, qu'il dépasse 400 caractères et qu'il parle du flux ou des connexions établies, et du retour. Le reste, ce que vous avez mesuré pendant la bascule et comment revenir, est ce qu'un relecteur jugera.
La mesure a une limite que la formation ne cache pas. Un rechargement sans coupure ne dit rien d'une panne de la machine : un reboot ou une perte d'hôte coupe tous les flux, anciens ouvriers compris. Sans coupure sur reload ne signifie pas sans coupure sur panne. Le diagnostic d'un comportement inattendu est traité dans Diagnostiquer HAProxy sans masquer la cause.
Un dernier point d'exploitation : un ancien ouvrier ne s'arrête que quand ses
connexions se terminent. Avec un timeout client (l'inactivité tolérée côté client) de 180
secondes, comme dans
le lab, une connexion inactive peut le retenir longtemps. HAProxy sait borner
cette durée avec la directive hard-stop-after de la section global. Le
manuel 3.4 la définit comme « the maximum time allowed to perform a clean
soft-stop », c'est-à-dire la durée au-delà de laquelle l'instance quitte même
s'il lui reste des connexions ouvertes. Elle échange donc une fin plus nette des
anciens ouvriers contre la coupure des flux qui dépassent le délai.
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab vous livre deux générations d'une même application, la 1.4.2 en
service et la 1.5.0 arrêtée, et aucun moyen de passer de l'une à
l'autre. Vous écrivez livrer et revenir (deux exécutables, dans le langage
de votre choix), puis un journal.md. La validation joue vos exécutables
pendant qu'elle mesure : un flux long ouvert avant la bascule, une sonde de
requêtes courtes, le PID du maître et les ouvriers avant et après, pour l'aller
puis pour le retour. Elle contrôle aussi l'état de départ, lit votre journal,
puis redémarre la machine et rejoue le cycle complet.
À retenir
Section intitulée « À retenir »- Un rechargement garde le maître et lui fait démarrer de nouveaux ouvriers ; les anciens finissent leurs connexions avant de s'arrêter, et les deux générations coexistent quelques minutes.
- Une livraison ne retire pas la génération qu'elle remplace : les anciens ouvriers lui parlent encore. Elle retire celle remplacée à la livraison précédente.
- Les ouvriers tiennent les sockets d'écoute, et le maître les leur
transmet d'une génération à l'autre : le remplacer emporte le service et ferme
le port, ce qu'un client ne voit pas toujours. On le prouve par son PID,
lu avant et après avec
systemctl show -p MainPID --value haproxy. - Une bascule se joue en quelques gestes : démarrer la génération, réécrire une
ligne, valider avec
haproxy -c,systemctl reload haproxy, puis retirer la génération d'avant. - Le retour arrière est une bascule comme l'autre, avec la même mesure ; il est sans surprise parce que la génération précédente vit toujours.
- Ce que le lab mesure : port, flux établi, une requête courte au plus, PID du maître, nouvel ouvrier, retour, reboot. Il ne vérifie pas que la plus ancienne génération a bien été retirée.
- Sans coupure sur reload ne veut pas dire sans coupure sur panne de
l'hôte ;
hard-stop-afterborne la durée de vie des anciens ouvriers, au prix de la coupure des flux plus longs que le délai.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de ce guide est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Tester la disponibilité du point d'entrée
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications