Pour qu'un point d'entrée HAProxy survive à une panne, il faut deux
machines qui servent la même configuration et un certificat de même confiance,
une adresse qui passe de l'une à l'autre, et surtout une bascule qui surveille
le service et non la machine. Cette leçon s'adresse à qui exploite déjà un
HAProxy 3.4 et veut le rendre tolérant à la perte d'un nœud (chacune des
deux machines). Elle explique les domaines de panne (ce qui tombe en même
temps), le piège du vrrp_script (le test qui retire l'adresse à un
nœud dont HAProxy est mort) et le choix de son poids, le split-brain (deux
machines qui se croient seules porteuses de l'adresse), ce qui doit rester
identique entre les deux nœuds, puis la façon de mesurer une reprise sans
toucher au client.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Distinguer la perte d'un processus de celle d'un hôte, et dire ce que chaque essai prouve.
- Expliquer pourquoi une bascule doit surveiller le service et non la machine, distinguer les deux voies du poids (0 ou négatif) et calculer un poids négatif qui déclenche vraiment la bascule.
- Choisir entre une adresse flottante, une entrée amont et le DNS selon ce que le réseau permet.
- Écrire la configuration keepalived d'un nœud, puis adapter celle du second sans casser l'élection.
- Reconnaître un split-brain dès la mise en place, et diagnostiquer
un double porteur avec
journalctletip. - Lister ce qui doit rester identique entre les deux nœuds.
- Mesurer une reprise avec une sonde qui ne change rien côté client.
Prérequis
Section intitulée « Prérequis »Vous avez un HAProxy 3.4.7 qui sert un service (la version du lab,
installée depuis trixie-backports-3.4 sur Debian 13), comme dans
installer HAProxy, et vous savez
lire l'état d'un serveur de backend et ses sondes, comme dans
la santé des serveurs avec HAProxy.
Vous êtes à l'aise avec systemctl, ip addr et curl. La notion de reverse
proxy est posée dans le guide du reverse proxy.
Pour une vue d'ensemble des autres briques de haute disponibilité (bases,
stockage, clusters), voir la
section haute disponibilité.
Un seul HAProxy suffit-il à garantir la disponibilité ?
Section intitulée « Un seul HAProxy suffit-il à garantir la disponibilité ? »Non : un HAProxy unique est un point de défaillance unique, et deux
instances ne protègent que contre les pannes qu'elles ne partagent pas. Un
domaine de panne est l'ensemble de ce qui tombe en même temps quand un
élément défaille. Le processus haproxy en est un : il peut planter ou
être tué sans que la machine bouge. L'hôte en est un autre : une VM qui
redémarre, un disque plein, une alimentation coupée emportent tous les
processus qu'elle héberge. Plus haut encore, le réseau amont (le commutateur,
la passerelle, l'adresse publique) en est un troisième.
Deux instances de HAProxy sur la même machine couvrent le premier domaine
et laissent le second intact : la panne de l'hôte les emporte ensemble. Pour
prouver qu'un point d'entrée survit à la perte d'un hôte, il faut donc deux
hôtes distincts, et c'est pourquoi le lab de cette leçon démarre trois VM :
edge.lab et edge2.lab pour les deux points d'entrée, poste.lab pour le
client qui interroge de l'extérieur. Une seule machine ne prouverait que la
perte d'un processus.
Quand peut-on utiliser une adresse flottante, et que faire sinon ?
Section intitulée « Quand peut-on utiliser une adresse flottante, et que faire sinon ? »Une adresse flottante (VIP) pilotée par VRRP convient quand les deux machines partagent un réseau de niveau 2 (elles se joignent directement, sans routeur entre elles) qui accepte qu'une adresse change de porteur ; si le réseau l'interdit, on choisit une entrée amont de niveau 4 ou le DNS, avec leurs limites. Le principe : l'adresse de service n'est câblée sur aucune machine en particulier, c'est le nœud élu qui l'ajoute à son interface. VRRP (Virtual Router Redundancy Protocol) désigne ce porteur : chaque nœud a une priorité, un nombre configuré, et celui dont la priorité est la plus haute porte l'adresse et annonce régulièrement sa présence ; si le porteur se tait, l'autre prend l'adresse. keepalived est le démon qui implémente VRRP sous Linux. Les clients ne changent rien : ils joignent toujours la même adresse.
Tous les réseaux n'acceptent pas cela. Un réseau qui n'achemine pas le multicast (l'envoi d'un paquet à un groupe de machines abonnées, sur lequel VRRP s'appuie par défaut, groupe 224.0.0.18), ou qui interdit qu'une adresse change de porteur, rend la solution inutilisable ; à vérifier sur votre réseau avant de la prescrire. Cette leçon ne dresse pas la liste des clouds concernés. keepalived sait annoncer en unicast, d'un nœud vers l'adresse de l'autre, ce qui contourne le blocage du multicast mais pas une interdiction de déplacer l'adresse. Les deux alternatives ont chacune une limite : un répartiteur de niveau 4 en amont (qui distribue les connexions TCP devant les deux HAProxy) devient lui-même le point unique à protéger, et le DNS avec plusieurs enregistrements ne retire pas une adresse morte tant que le cache des clients n'a pas expiré.
Pourquoi keepalived doit-il surveiller HAProxy et pas seulement la machine ?
Section intitulée « Pourquoi keepalived doit-il surveiller HAProxy et pas seulement la machine ? »Sans surveillance du service, keepalived ne contrôle que la machine : un HAProxy mort sur une machine vivante ne provoque aucune bascule, et l'adresse reste chez un nœud qui ne sert plus rien. C'est le piège central de la haute disponibilité d'un proxy. keepalived annonce que son porteur est vivant tant que son propre processus répond, qu'HAProxy tourne ou non. Le service est à terre, la haute disponibilité « se porte bien », et personne n'est alerté.
La parade est un vrrp_script : un test que keepalived exécute à
intervalle régulier, rattaché à l'instance VRRP par track_script. Son
weight (poids) décide de ce qui arrive quand ce test échoue, et deux
voies existent. Laissé à sa valeur par défaut, 0, l'échec fait passer
l'instance en état FAULT (l'état « en défaut » d'une instance VRRP, qui
n'est ni maître ni secours), sans aucun calcul de priorité. Le manuel
keepalived.conf(5) l'écrit sans détour : « The default weight equals 0,
which means that any VRRP instance monitoring the script will transition to the
fault state ».
Avec un poids négatif, keepalived abaisse la priorité du nœud de la
valeur absolue du poids quand le test échoue fall fois de suite (fall est
le nombre d'échecs consécutifs toléré), ce que le même manuel formule
« subtracted from the initial priority in case of fall failures ». Cette
leçon détaille le poids négatif, mais le poids 0 est un choix tout aussi
légitime. Le poids 0 est plus simple (aucune priorité à calculer) et plus
rapide : le nœud passe en FAULT, cesse d'annoncer (il envoie alors une
priorité 0, que le journal note « sent 0 priority » seulement sous -D, voir
plus bas) et le pair devient maître en environ 1 seconde. Le poids négatif (-60
sur un nœud de priorité 150, soit 90 face à un pair à 100) bascule en environ 3
secondes, mais garde le nœud candidat pendant sa maladie : il reste dans
l'élection avec une priorité abaissée au lieu d'en sortir. Dans les deux cas, le nœud guéri revient. Ces durées sont mesurées sur
keepalived 2.3.3 en conteneur (deux nœuds en unicast, priorités 150 et 100,
interval 1, fall 2, rise 2), le 2026-10-26 : le manuel ne les énonce pas,
à rejouer sur le lab.
Après guérison, le nœud reprend l'adresse environ 8 secondes après, par
préemption (le nœud de priorité la plus haute reprend l'adresse dès qu'il
est de nouveau candidat) : cela produit une seconde coupure brève, que le
mot-clé nopreempt évite pour qui n'en veut pas.
L'abaissement n'a d'effet que s'il fait passer la priorité sous celle du pair, sinon le nœud malade garde l'adresse.
Le tableau le montre sur un exemple : le nœud porteur a la priorité 150, son pair 100 (un écart de 50), et le test du porteur échoue.
| Poids | Priorité du nœud malade | Priorité du pair | Résultat |
|---|---|---|---|
| -20 | 130 | 100 | Pas de bascule : 130 reste au-dessus de 100 |
| -50 | 100 | 100 | Égalité : le résultat dépend d'un départage peu lisible |
| -60 | 90 | 100 | Bascule : l'autre nœud prend l'adresse |
| 0 (défaut) | sans objet | 100 | Instance en état FAULT après fall échecs : la priorité n'entre plus en jeu |
Si vous retenez le poids négatif, choisissez donc un poids dont la valeur
absolue dépasse l'écart entre les deux priorités, avec de la marge :
à priorités égales, VRRP départage par l'adresse IP primaire la plus élevée
(RFC 5798, section 6.4.3), ce qui fait dépendre le résultat des adresses
plutôt que de la panne. Le manuel accepte un weight de -253 à 253. Le calcul
des priorités vient du manuel et de l'arithmétique ci-dessus ; les durées de
bascule viennent de la mesure en conteneur citée plus haut, pas du lab.
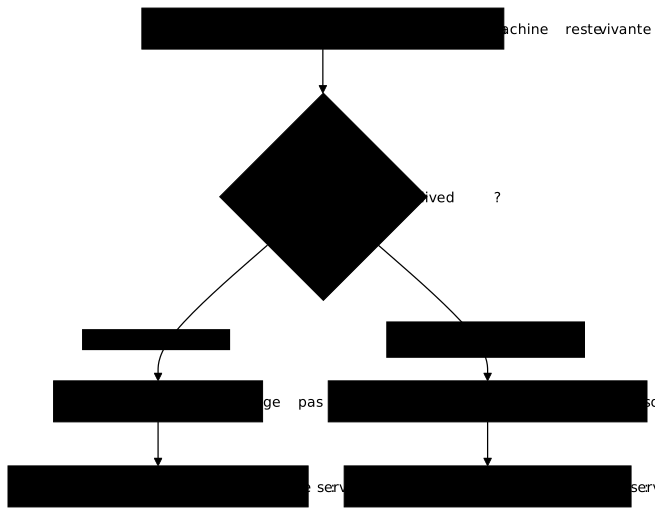
Regardez le schéma de haut en bas : la panne est la même, seule la décision
de surveiller le service change l'issue. Le test lui-même peut être minimal
(un pgrep -x haproxy vérifie qu'un processus de ce nom exact existe) ou
plus fidèle (une vraie requête sur le port local, qui prouve qu'HAProxy
répond). Plus le test ressemble à ce que fait un client, moins il y a d'écart
entre « la bascule croit que tout va bien » et « le service est utilisable ».
Un HAProxy bloqué, saturé ou qui n'écoute plus passerait le test du processus,
là où une vraie requête échouerait. Quelle que soit la commande choisie, elle
doit exister sur chaque nœud : voir plus bas.
À quoi ressemble la configuration keepalived d'un nœud ?
Section intitulée « À quoi ressemble la configuration keepalived d'un nœud ? »La configuration d'un nœud tient dans /etc/keepalived/keepalived.conf : un
bloc vrrp_script qui teste HAProxy, un bloc vrrp_instance qui décrit
l'élection, et un track_script qui relie les deux. L'exemple suivant utilise
d'autres noms et un autre plan d'adressage que votre réseau : deux proxys
proxy-a (172.16.40.11) et proxy-b (172.16.40.12) se partagent l'adresse de
service 172.16.40.100, sur l'interface ens18. Voici proxy-a, le nœud
préféré, en unicast.
vrrp_script check_haproxy {    script "/usr/bin/pgrep -x haproxy"    interval 1    fall 2    rise 2    weight -60}
vrrp_instance VI_WEB {    state BACKUP    interface ens18    virtual_router_id 77    priority 150    advert_int 1    unicast_src_ip 172.16.40.11    unicast_peer {        172.16.40.12    }    virtual_ipaddress {        172.16.40.100/24    }    track_script {        check_haproxy    }}
Le bloc vrrp_script suit keepalived.conf(5). script est la commande
exécutée, un code de sortie non nul étant un échec : si elle est fausse ou
absente, le test échoue à chaque exécution et le nœud se retire seul.
interval fixe les secondes entre deux essais, fall le nombre
d'échecs consécutifs avant de déclarer le test en échec, rise le nombre de
succès avant de le déclarer rétabli.
weight vaut ici -60 : avec 150 contre 100, la priorité tombe à 90, sous
celle du pair, comme le montre le tableau plus haut.
L'exemple emploie pgrep -x haproxy (le -x exige le nom exact) parce que
pgrep vient du paquet procps, de priorité « important » sous Debian, donc
présent sur une installation minimale. Il rend un code non nul si aucun
processus ne correspond, ce qui en fait un test. L'alternative classique,
killall -0 haproxy, vient du paquet psmisc, de priorité « optional » : elle
exige de l'installer, sans quoi la commande est absente et le test échoue en
permanence. Le chemin /usr/bin/pgrep n'a pas été rejoué sur Debian 13 : sur
votre nœud, confirmez-le avec command -v pgrep, puis lancez la commande du
test à la main avec echo $? (0 tant qu'HAProxy tourne).
Le bloc vrrp_instance décrit l'élection. state BACKUP s'écrit sur les
deux nœuds : c'est la priorité qui désigne le maître, et le manuel exige un état
initial différent de MASTER pour que nopreempt fonctionne. interface
nomme l'interface qui porte les annonces ; une fausse interface empêche
l'instance de démarrer. priority (de 1 à 255) départage : le manuel
recommande 50 de plus pour le maître et des priorités toutes différentes.
advert_int est l'intervalle des annonces en secondes (1 par défaut).
virtual_ipaddress liste l'adresse de service avec son masque : le
manuel en fait une partie facultative de <IPADDR>[/<MASK>], mais écrire
/24 évite de laisser le choix du préfixe à l'outil, à vérifier sur votre
nœud avec ip -o -4 addr show. track_script nomme le vrrp_script à
appliquer : sans lui, le test ne s'exécute jamais, car le manuel précise qu'un
script n'est lancé que si une instance le surveille.
unicast_src_ip est l'adresse locale d'où partent les annonces, et
unicast_peer la liste des adresses du ou des pairs, qui reçoivent les
annonces au lieu du groupe multicast. Le multicast est le mode par défaut : les
annonces partent vers 224.0.0.18 et tout nœud du même réseau de niveau 2 les
entend sans connaître ses voisins. L'unicast est le choix obligé d'un réseau qui
n'achemine pas le multicast. En contrepartie, chaque nœud doit connaître l'adresse
de l'autre : une erreur dans unicast_peer supprime la liaison et prépare un
double maître. Le manuel ajoute qu'il est impossible de fonctionner en unicast
sans pair.
Que changer sur le second nœud, et que laisser identique ?
Section intitulée « Que changer sur le second nœud, et que laisser identique ? »Sur proxy-b, seuls la priority et les deux adresses unicast changent ;
tout le reste doit être identique à proxy-a, et d'abord le virtual_router_id.
Le virtual_router_id (de 1 à 255) est l'identifiant du groupe VRRP : deux
nœuds ne se voient comme pairs que s'il est le même. Avec 77 d'un côté et 78 de
l'autre, chaque nœud ignore les annonces de l'autre, se croit seul, élit
son propre maître et prend l'adresse : c'est le split-brain (deux machines qui
portent l'adresse en même temps), décrit plus bas, sans qu'aucune panne n'ait eu
lieu.
| Directive | proxy-a | proxy-b |
|---|---|---|
virtual_router_id | 77 | 77 (identique) |
virtual_ipaddress | 172.16.40.100/24 | 172.16.40.100/24 (identique) |
state | BACKUP | BACKUP (identique) |
priority | 150 | 100 (différente) |
unicast_src_ip | 172.16.40.11 | 172.16.40.12 (inversée) |
unicast_peer | 172.16.40.12 | 172.16.40.11 (inversée) |
vrrp_script et track_script | identiques | identiques |
Le bloc vrrp_script reste le même : si proxy-b n'a pas de test, un
HAProxy mort sur proxy-b n'est jamais détecté, et l'adresse y reste une fois
qu'il l'a prise. La commande du test doit aussi exister sur proxy-b : si elle
y manque, le test échoue en permanence. Avant de démarrer, keepalived -t -f /etc/keepalived/keepalived.conf (--config-test) vérifie la syntaxe, mais
pas les valeurs : un virtual_router_id différent passe ce contrôle. Après
systemctl restart keepalived sur les deux nœuds, appliquez le contrôle de la
section sur le split-brain, plus bas : une seule machine doit porter l'adresse.
Une fois guéri, proxy-a reprend l'adresse par préemption, comme plus haut,
ce qui crée une seconde coupure. Pour l'éviter, ajoutez nopreempt dans
vrrp_instance sur les deux nœuds ; preempt_delay retarde seulement la
reprise.
Où regarder pour lire l'état et diagnostiquer un double porteur ?
Section intitulée « Où regarder pour lire l'état et diagnostiquer un double porteur ? »Deux commandes suffisent pour savoir qui porte l'adresse et pourquoi :
ip -o -4 addr show répond à « qui », et journalctl -u keepalived à
« pourquoi ». Lancez ip -o -4 addr show dev ens18 sur chaque nœud et cherchez
l'adresse de service (ici 172.16.40.100) : une ligne sur un seul nœud est l'état
sain. Le journal, lu par journalctl -u keepalived --since "10 min ago" --no-pager, raconte les transitions : des lignes Entering MASTER STATE ou
Entering BACKUP STATE pour l'élection, et Entering FAULT STATE suivie de
sent 0 priority quand un vrrp_script à poids 0 échoue (cette dernière
ligne n'apparaît que si keepalived tourne avec -D, --log-detail). Le
libellé exact dépend de la version, à vérifier sur votre nœud.
Deux porteurs se diagnostiquent dans cet ordre. Premier réflexe : comparer
virtual_router_id, unicast_src_ip et unicast_peer sur les deux nœuds, car
c'est une cause très probable. Ensuite, vérifier qu'un pare-feu laisse passer
le protocole 112 (VRRP, qui n'est ni TCP ni UDP) entre les deux adresses ;
cette valeur vient de la définition de VRRP (RFC 5798) et non du manuel de
keepalived. Enfin, relire le journal des deux nœuds : un nœud dont l'état ne
change jamais alors que son pair s'arrête est probablement isolé. Aucun de ces
gestes ne remplace la mesure de la reprise décrite plus bas.
L'autre panne de mise en place est un nœud qui ne prend jamais l'adresse alors
qu'il devrait, ou dont l'état reste figé. Vérifiez alors que son vrrp_script
n'échoue pas en permanence : lancez la commande du test à la main, puis
echo $?, qui doit afficher 0 tant qu'HAProxy tourne. Si la commande est
absente, l'échec est constant : avec un poids de 0 le nœud reste en FAULT,
avec un poids négatif sa priorité reste abaissée et il ne reprend jamais
l'adresse.
Comment reconnaître un split-brain avant même la première bascule ?
Section intitulée « Comment reconnaître un split-brain avant même la première bascule ? »Un split-brain, c'est deux machines qui portent l'adresse de service en même temps ; au repos, une seule des deux doit la porter, et cela se vérifie dès la mise en place. Les nœuds s'élisent en s'échangeant des annonces. Si ces annonces ne passent plus (partition réseau, pare-feu qui bloque le protocole, adresse de pair erronée), chaque nœud se croit seul et prend l'adresse. Les deux répondent alors à la même IP, et les clients tombent sur l'un ou l'autre au hasard, avec deux états applicatifs qui divergent.
Le contrôle est simple et ne demande aucune panne : sur chacune des deux
machines, listez les adresses IPv4 avec ip -o -4 addr show et cherchez
l'adresse de service. Elle doit apparaître sur une seule machine. Zéro
porteur, ou deux, est un défaut de mise en place à diagnostiquer avant toute
bascule ; deux porteurs pointent d'abord vers des annonces qui ne
circulent pas. Refaites ce contrôle après chaque bascule : l'adresse doit
avoir changé de machine et être toujours unique.
Aucun réglage de configuration ne supprime le risque de partition : il se décrit dans le dossier d'exploitation (le document destiné à ceux qui font tourner le service, que le lab demande de rédiger), avec sa conséquence (le double maître, c'est-à-dire le split-brain) et la façon de le détecter.
Que faut-il garder identique sur les deux nœuds ?
Section intitulée « Que faut-il garder identique sur les deux nœuds ? »Les deux nœuds doivent présenter le même service au client : la même configuration HAProxy, un certificat valide pour le même nom et de même confiance, et la même politique d'accès. Sinon la bascule devient visible du client, ou pire, ouvre ce que l'autre nœud refusait. Un client qui vérifie strictement le TLS ne doit pas voir un service différent selon qui répond.
Attention à ce que cette exigence veut dire exactement, car la confusion est courante. Un client strict ne réclame pas un fichier identique sur les deux machines : il vérifie que le certificat présenté couvre le nom demandé et qu'il est signé par une autorité qu'il approuve. Deux certificats distincts pour le même nom, émis par la même autorité, passent donc la vérification sans que le client voie la moindre différence. C'est même le cas courant en production, où chaque nœud renouvelle le sien par ACME.
Dans le lab, les deux points d'entrée vont plus loin que cette exigence et présentent la même empreinte : l'autorité et le certificat de service sont générés une fois puis recopiés, plutôt que générés deux fois. C'est un choix de simplicité du banc, qui évite d'avoir deux dates d'expiration à suivre pendant l'exercice, et non une règle à transposer telle quelle.
La même logique vaut pour la politique d'accès. Une route privée refusée sur
edge doit l'être aussi sur edge2, après la bascule : une politique qui
ne suit pas le service est une ouverture qui s'ignore. Le lab écoute sur
bind :443 et non sur l'adresse flottante, car HAProxy refuse de démarrer sur
une adresse que la machine ne porte pas encore ; or le nœud de secours ne porte
pas l'adresse de service tant qu'il n'a pas pris le relais, et son HAProxy doit
pourtant démarrer. Pour écouter quand même sur l'adresse flottante, le manuel
d'administration d'HAProxy indique de régler le paramètre noyau Linux (le
sysctl) net.ipv4.ip_nonlocal_bind à 1 ; bind :443 évite ce réglage.
Une troisième catégorie est plus insidieuse : l'état n'est pas répliqué. Ce qu'une instance garde en mémoire (compteurs, suivi de sessions) et les décisions prises à chaud sur son socket d'administration, comme sortir un serveur du service (modifier l'état à chaud), restent dans cette instance. Après une bascule, l'autre nœud repart de sa propre configuration. Les certificats, eux, se gèrent comme dans HTTPS et ACME avec HAProxy : à chaque nœud d'avoir le sien à jour.
Comment mesurer une reprise sans toucher au client ?
Section intitulée « Comment mesurer une reprise sans toucher au client ? »On mesure une reprise avec une sonde continue qui interroge toujours la même adresse de service, sans rien changer, pendant qu'on provoque la panne ; la durée de l'interruption se lit dans l'écart entre la dernière réponse et la première réponse du second nœud. La condition est stricte : une bascule qui demanderait une action du client n'en serait pas une. Une sonde qu'on relancerait sur l'autre adresse mesurerait sa propre intervention.
Le lab fournit sur poste.lab une sonde nommée sonde-entree. Elle ouvre une
connexion TLS strict par seconde vers la même adresse et écrit une ligne par
interrogation : l'instant, puis le nom de la machine qui a répondu (les
deux serveurs applicatifs annoncent leur nom), ou une erreur. Dans ces lignes,
la panne apparaît comme une série d'erreurs, et la reprise comme le retour des
réponses sous le nom de l'autre machine. La durée de la série est votre délai
de reprise : elle se mesure, elle ne se déduit pas de la configuration.
Faites deux essais, car ils ne prouvent pas la même chose. D'abord arrêtez
HAProxy sur le nœud porteur : c'est la perte d'un processus, et le test qui
révèle l'absence de vrrp_script. Ensuite redémarrez la machine entière :
c'est la perte d'un hôte, que seuls deux hôtes distincts permettent d'essayer.
Deux points complètent la mesure. Premièrement, une connexion ouverte au
moment de la panne est coupée : elle meurt avec le processus ou l'hôte qui la
portait, et le client doit se reconnecter. Il ne faut pas la confondre avec le
cas d'un serveur de backend déclaré DOWN par HAProxy. Pour celui-ci, le
manuel ne dit nulle part en toutes lettres que les connexions établies
survivent ; on le déduit de l'option inverse,
on-marked-down shutdown-sessions, qui les coupe et dont le manuel précise
« Actions are disabled by default » (les connexions ainsi coupées portent le
code de terminaison D). Deuxièmement, la capacité : si
chaque nœud absorbe la moitié du trafic, le survivant reçoit tout. Chaque nœud
doit pouvoir porter la charge entière, sinon la bascule transforme une panne
en saturation.
Que ne protège pas cette bascule ?
Section intitulée « Que ne protège pas cette bascule ? »Cette bascule protège contre la perte d'un processus HAProxy ou d'un hôte, pas contre une configuration fausse déployée des deux côtés, ni contre la partition réseau, ni contre la perte de l'état en mémoire. Une erreur de configuration poussée sur les deux nœuds bascule vers une copie de la même panne. Le dossier d'exploitation que le lab demande de rédiger tient sur trois sujets, dont aucun ne se lit dans la configuration : le double maître que produit une partition, l'état non répliqué, et ce que la bascule ne couvre pas du tout (le réseau amont, les backends, la configuration elle-même).
Un backend partagé en panne n'est pas non plus réparé par un second proxy : les sondes de santé des serveurs restent nécessaires, derrière chacun des deux nœuds.
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab part de deux points d'entrée HAProxy déjà en place sur edge.lab et
edge2.lab, avec la même configuration et le même certificat, et d'un
keepalived installé mais non configuré. Vous déployez une bascule
compatible avec le réseau fourni, puis vous mesurez la perte d'un processus
et celle d'un hôte depuis poste.lab, sans rien changer côté client. La validation porte sur
quatre contrôles : les deux points d'entrée servent la recette (le test de
réception de départ), la reprise est
mesurée après la perte d'un processus puis d'un hôte, les deux nœuds
présentent la même empreinte de certificat et la route privée reste refusée
après la bascule, et le dossier décrit ce que la bascule ne protège pas.
À retenir
Section intitulée « À retenir »La disponibilité d'un point d'entrée se prouve par la perte d'un hôte, pas seulement d'un processus.
- Un domaine de panne est ce qui tombe ensemble : deux instances sur le même hôte partagent la panne de l'hôte.
- Une adresse flottante VRRP n'est possible que si le réseau l'accepte ; sinon, entrée amont de niveau 4 ou DNS, avec leurs limites.
- Sans
vrrp_script, keepalived surveille la machine et non le service ; la commande du test doit exister sur chaque nœud, sinon il échoue en permanence. - Le poids du
vrrp_scripta deux voies : à 0 (défaut), l'échec met l'instance en état FAULT ; négatif (la voie enseignée ici), il abaisse la priorité, qui doit passer sous celle du pair : avec 150 contre 100, un poids de -20 ne bascule pas, un poids de -60 oui. - Sur les deux nœuds, le
virtual_router_idest identique ; seuls la priorité et les adresses unicast diffèrent. - Au repos, une seule machine porte l'adresse : deux porteurs signalent un split-brain.
- Les deux nœuds gardent la même configuration et la même politique, et présentent un certificat valide pour le même nom et de même confiance, pas nécessairement le même fichier ; l'état en mémoire n'est pas répliqué.
- Une reprise se mesure avec une sonde continue qui ne change rien côté client, et chaque nœud doit pouvoir porter toute la charge.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Ces questions vérifient que vous savez prévoir ce que la bascule fait, et ce qu'elle ne fait pas, avant de la mesurer.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Pangolin : exposer un service sans ouvrir de port
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications