Pour diagnostiquer un service web publié dont on ignore la panne, on descend les mêmes couches (les étapes que traverse une requête) dans le même ordre, nom, port, TLS, route, application, et on s'arrête à la première qui échoue, qui devient la couche à examiner en premier. Cette leçon s'adresse à une personne qui sait lancer un curl et qui hérite d'un service dont quelqu'un dit « il se comporte mal ». Elle enseigne une méthode : quel geste tranche à chaque étage, comment éliminer une hypothèse au lieu de la confirmer, et comment réparer sans retirer une protection. Elle ne configure aucun outil précis : le raisonnement vaut pour n'importe quel point d'entrée.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »La leçon va du symptôme à la couche fautive, puis de la couche à une réparation qui ne retire rien.
- Descendre les cinq couches d'un service publié dans l'ordre du trajet de la requête.
- Choisir le geste qui tranche à chaque étage, depuis un client indépendant.
- Distinguer une connexion refusée d'un hôte qui ne répond pas.
- Formuler une hypothèse, la tester par un geste ciblé, puis la déclarer confirmée ou réfutée.
- Écarter un message alarmant qui n'a aucun rapport avec la panne.
- Réparer par la plus petite correction, puis rejouer une recette qui prouve qu'aucune protection n'a été affaiblie.
Prérequis
Section intitulée « Prérequis »La leçon suppose que vous savez lancer curl dans un terminal, lire une réponse HTTP et ses codes de statut, et que vous avez déjà vu un service publié derrière un point d'entrée, par exemple un reverse proxy.
- Lire un échange HTTP, ses codes et ses en-têtes : Lire HTTP avant de configurer un proxy.
- Situer le point d'entrée sur le trajet d'une requête : Publier un service web.
- Savoir qu'une recette se joue depuis un client indépendant : Préparer la publication, la reprise et le retour arrière.
- Le lab fournit les machines et la panne : vous n'installez rien.
Que traite cette leçon, et que laisse-t-elle aux pages d'outil ?
Section intitulée « Que traite cette leçon, et que laisse-t-elle aux pages d'outil ? »Cette leçon traite de la méthode, indépendante du produit ; la lecture des journaux et des directives d'un proxy précis appartient aux pages d'outil. Un point d'entrée est la machine ou le processus qui reçoit les requêtes du public et les relaie vers le service : on l'appelle aussi reverse proxy, un intermédiaire qui parle au client à la place du service. Le backend est le service relayé, celui qui produit la vraie réponse.
Trois pages existent côté outil et restent la référence une fois la couche trouvée. Diagnostiquer HAProxy sans masquer la cause lit les codes de terminaison d'HAProxy. Dépanner Nginx lit son journal d'erreur, et Dépanner un point d'entrée Traefik ses journaux et ses routes. Côté réseau général, Méthodologie de diagnostic réseau relie chaque message du noyau à ses causes. Ici, l'angle est plus étroit : un service publié, cinq couches, et le raisonnement qui évite de réparer au mauvais endroit.
Pourquoi descendre les couches plutôt que lire le premier message ?
Section intitulée « Pourquoi descendre les couches plutôt que lire le premier message ? »Un message d'erreur nomme ce que le client a constaté, pas la couche qui a échoué, alors que le trajet d'une requête traverse les couches dans un ordre fixe. Un code 502 (« Bad Gateway », le point d'entrée n'a pas obtenu de réponse valide du backend) peut venir d'un backend arrêté, d'une mauvaise adresse de backend ou d'une confiance TLS refusée entre les deux. Partir du message, c'est choisir une piste avant d'avoir un fait.
Descendre les couches remplace cette intuition par un ordre fixe. Une requête passe d'abord par le nom (le DNS donne une adresse), puis par le port (une connexion TCP s'ouvre), puis par TLS (le chiffrement qui authentifie le serveur par un certificat), puis par le routage (le point d'entrée choisit une route), et enfin par l'application (le backend répond). Une requête ne peut pas franchir une couche si celle d'avant a échoué : la première qui échoue est la couche à examiner en premier, et les suivantes n'ont encore rien dit. C'est une méthode, pas une loi : si le nom renvoie une adresse fausse, le test du nom « réussit » puisqu'une adresse revient, le port échoue ensuite, et la faute est pourtant dans le nom. Le geste de chaque étage doit donc comparer le résultat à celui qu'on attend, pas seulement constater qu'il y en a un. La première couche qui échoue est le point de départ de l'enquête ; la couche réellement fautive est celle que les hypothèses testées plus bas finissent par confirmer.
Cet ordre a une autre vertu : il coûte peu. Chaque test se lance depuis le poste de travail, ne modifie rien, et permet d'écarter une couche entière en une commande. Mieux vaut ne toucher à aucun fichier avant d'avoir localisé la panne.
Quelles sont les cinq couches, et quel geste tranche à chaque étage ?
Section intitulée « Quelles sont les cinq couches, et quel geste tranche à chaque étage ? »Chaque couche a une question fermée et un geste qui y répond par oui ou par non, et la descente s'arrête au premier non. Le schéma suit le trajet : regardez les flèches pleines, qui descendent tant que la réponse est oui, et les flèches en pointillé, qui mènent toutes à la même conclusion, la première couche qui échoue.
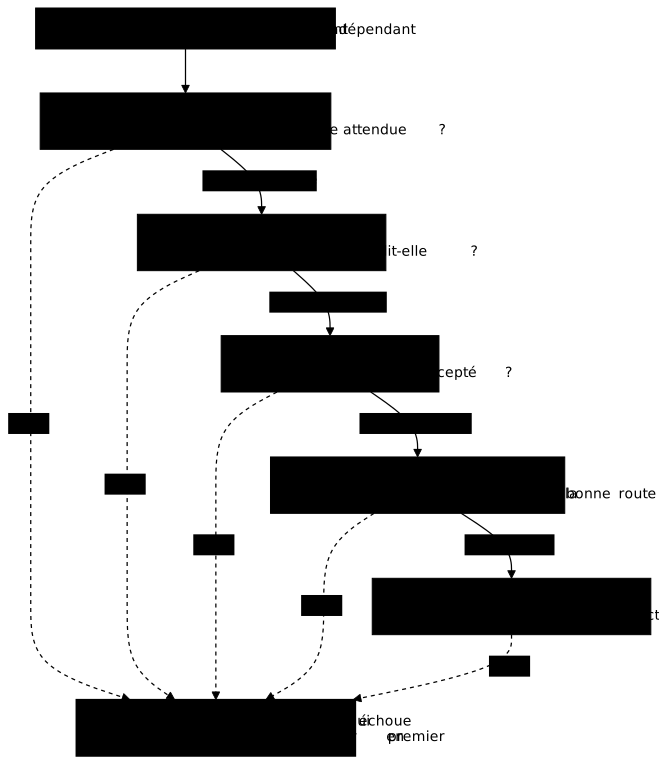
Le tableau donne, pour chaque étage, le geste qui tranche et ce qu'un échec évoque. Les causes citées sont des exemples fréquents, pas une liste complète.
| Couche | Question | Geste qui tranche | Un échec évoque |
|---|---|---|---|
| Nom | Le nom donne-t-il l'adresse attendue ? | dig service.mes.test A depuis le client | zone absente, mauvaise adresse, cache périmé |
| Port | La connexion TCP s'ouvre-t-elle ? | une connexion brute au port, avec un délai borné | rien n'écoute à cette adresse, pare-feu, mauvais port |
| TLS | Le certificat est-il accepté ? | curl --cacert ca.pem https://… | autorité inconnue, nom absent du certificat, certificat expiré |
| Routage | La requête atteint-elle la bonne route ? | curl et lecture du statut | route absente, route qui vise le mauvais port |
| Application | Le backend répond-il correctement ? | requête directe au backend, depuis la machine du service | processus arrêté, erreur applicative |
La leçon sur le trajet d'une requête donne la même logique du point de vue du proxy, avec la table des codes 404, 502, 503 et 504. La différence ici : on ne part pas du code, on part de la couche.
Pourquoi observer depuis un client indépendant et depuis l'opérateur ?
Section intitulée « Pourquoi observer depuis un client indépendant et depuis l'opérateur ? »Il faut deux points de vue, parce que l'opérateur voit le service de l'intérieur, alors que seul un client indépendant le traverse tout entier. L'opérateur est la personne, et la machine, qui administre le service. Un client indépendant est une autre machine, avec son propre résolveur DNS (le serveur auquel elle demande les adresses) et sa propre liste d'autorités de confiance.
Depuis la machine du service, un test sur l'adresse locale réussit même quand le nom n'est pas déclaré, ou quand le service n'écoute que sur l'adresse de boucle locale (127.0.0.1, joignable uniquement depuis la machine elle-même). Le même test depuis un client indépendant échoue, et l'écart entre les deux est déjà un indice : ce que l'opérateur voit et ce que le client voit ne coïncident pas, donc la panne se situe souvent entre eux, dans le nom, le port ou le pare-feu.
Nous recommandons d'ouvrir le diagnostic par le point de vue du client, parce que c'est lui qui se plaint, puis de descendre côté opérateur pour les couches que seul l'hôte voit : processus, configuration, journaux. Le client indépendant dit où ça casse, l'opérateur dit pourquoi.
Comment tester le nom puis le port ?
Section intitulée « Comment tester le nom puis le port ? »Le nom se teste en interrogeant le résolveur du client, le port en tentant une connexion avec un délai borné, et les deux échecs ne se ressemblent pas. Le DNS est le service qui traduit un nom en adresse IP. Si dig ne rend aucune adresse, ou une adresse inattendue, la panne est dans la couche nom, et rien de plus bas n'a de sens à tester.
Piège fréquent : forcer l'adresse avec curl --resolve fait réussir la requête sans rien apprendre sur le DNS. Ce contournement sert à tester une route avant que le nom ne soit déclaré, pas à diagnostiquer une panne de nom. Pour lire un échec de résolution en détail, voir Le DNS.
Le port est le numéro qui désigne un service sur une machine : 443 pour HTTPS. Une connexion TCP s'ouvre en trois échanges (SYN, SYN-ACK, ACK), et son échec prend le plus souvent deux formes. Une connexion refusée revient en quelques secondes : quelqu'un a répondu non, immédiatement. Un hôte injoignable, dont les paquets sont jetés en chemin, ne répond rien, et le client attend jusqu'à la borne de connexion, le délai maximal qu'il s'est donné avant d'abandonner.
Cette différence d'attente est un indice utile : un refus rapide suggère que la machine est joignable mais que rien n'écoute, ou qu'un filtre refuse proprement ; un silence long suggère un chemin coupé ou un paquet jeté. Elle ne désigne pourtant pas une cause unique, et la page Méthodologie de diagnostic réseau montre qu'un même refus peut venir de deux situations opposées. Posez toujours un délai maximal à votre test, sinon un hôte muet fige le terminal.
Comment tester TLS sans désactiver la vérification ?
Section intitulée « Comment tester TLS sans désactiver la vérification ? »On teste TLS en désignant explicitement l'autorité de confiance, avec curl --cacert, et jamais en désactivant la vérification. TLS chiffre l'échange et authentifie le serveur grâce à un certificat, un document signé par une autorité de certification (AC), l'organisme dont la signature atteste qu'un certificat appartient à un nom. Un client accepte un certificat quand sa chaîne remonte à une AC qu'il connaît et que le nom demandé figure dans le certificat.
Dans un laboratoire, l'AC est souvent une autorité de test dont le certificat est déposé sur le client : on la désigne avec --cacert ca.pem. L'option -k (--insecure) fait passer n'importe quel certificat, y compris le mauvais, donc elle supprime le test qu'on voulait faire. Une panne de la couche TLS devient alors invisible, et le diagnostic conclut à tort que la couche est saine.
Un échec TLS a des causes que le message de curl aide à départager : autorité inconnue du client, nom absent du certificat, certificat expiré. Un point d'entrée qui présente un certificat signé par une autre autorité que celle attendue donne un échec dès la négociation, avant tout échange HTTP. C'est pourquoi TLS vient avant le routage : tant que le client vérifie le certificat et le refuse, il n'envoie pas sa requête HTTP. Pour lire un certificat en détail, voir Diagnostiquer TLS.
Comment distinguer le routage de l'application ?
Section intitulée « Comment distinguer le routage de l'application ? »On distingue le routage de l'application en interrogeant le backend directement, depuis la machine du service, puis en comparant sa réponse à celle du point d'entrée. Le routage est la décision par laquelle le point d'entrée choisit, selon le nom ou le chemin demandé, vers quel backend relayer. Une route est une règle de ce choix. Une route qui vise le mauvais port, ou qui n'existe pas, donne une erreur vue du client alors que le backend est en parfaite santé.
Le geste qui tranche est la requête directe au backend. Si le backend répond correctement quand on lui parle sans passer par le point d'entrée, la couche application est saine et la faute se trouve le plus souvent dans le routage : la route vise une mauvaise cible (ou la liaison entre le point d'entrée et le backend, par exemple une confiance TLS refusée, est en cause). Si le backend ne répond pas, ou refuse la connexion, la faute est dans l'application, ou plus exactement dans le processus qui devait l'exécuter.
Ce geste repose sur un fait à garder en tête : le point d'entrée voit des requêtes que l'application ne voit jamais. Une requête refusée par une règle, une route absente, un échec TLS : le backend n'en entend pas parler, et son journal reste vide. Un journal vide côté application ne prouve donc rien, il dit seulement que la requête n'est pas arrivée jusque-là, ce qui est justement une information sur les couches précédentes.
Un autre piège touche cette frontière : un rejeu peut masquer une panne au client. Certains points d'entrée retentent une requête échouée sur un autre backend du même groupe (Nginx le fait par défaut sur une erreur de connexion ou un délai, selon proxy_next_upstream). Le client peut alors recevoir un 200, et les erreurs qu'il voit ne mesurent plus la santé de chaque backend. Pour savoir si un backend est en bonne santé, on l'interroge lui, pas à travers le point d'entrée. La leçon Maîtriser délais, tentatives et cache sans altérer les réponses détaille ces reprises.
Comment éliminer une hypothèse au lieu de la confirmer ?
Section intitulée « Comment éliminer une hypothèse au lieu de la confirmer ? »Une hypothèse se teste par un geste qui peut la réfuter ; la méthode de cette leçon conclut sur celle qu'aucun test n'a réussi à écarter, pas sur la plus plausible. Une hypothèse est une explication provisoire : « le certificat présenté n'est pas celui attendu ». Un test ciblé est un geste dont le résultat dépend de cette explication : si elle est fausse, le résultat change. La plausibilité peut guider l'ordre des tests, mais seule la survie aux tests autorise à conclure. Le biais courant consiste à chercher ce qui confirme, et on en trouve facilement.
Nous recommandons de tenir un journal d'enquête, c'est-à-dire un petit fichier texte avec une ligne par observation : l'heure, l'hypothèse, le test, l'issue (confirmée ou réfutée). Ce n'est pas du formalisme. Dans un diagnostic qui dure une heure, ce journal évite de retester deux fois la même chose, et il permet de dire exactement ce qui a été écarté. Une hypothèse réfutée est un progrès, pas un échec : elle retire une couche de la liste. Ne le confondez pas avec les journaux du service (ses logs), qui sont une source de faits et non votre trace de raisonnement.
Deux précautions limitent les fausses pistes. La première : un seul changement à la fois. Si vous modifiez deux choses puis que le service répond, vous ne savez pas laquelle a réparé. La seconde : un message alarmant n'est pas une cause tant qu'un test ne l'a pas relié à la panne. Un journal peut porter un avertissement qui inquiète, par exemple un cache presque plein, sans aucun rapport avec la panne. Le test de la couche tranche : tant qu'aucun geste du tableau n'échoue à cause de ce message, notez-le comme bruit provisoire et ne le traitez pas avant d'avoir localisé la couche fautive.
Il faut aussi nommer le piège du silence. Quand un journal ou un graphique ne montre rien, au moins trois causes se cachent derrière ce silence : une panne réelle, une absence de trafic, ou une collecte perdue, c'est-à-dire que l'information n'est pas arrivée jusqu'à l'endroit où vous regardez. Observer un service publié détaille ce tri. Le diagnostic par couches limite le problème, puisque ses gestes de localisation ne dépendent pas d'un journal du service : il génère lui-même le trafic de test et lit la réponse.
Quelle réparation, et comment prouver qu'aucune protection n'a sauté ?
Section intitulée « Quelle réparation, et comment prouver qu'aucune protection n'a sauté ? »La bonne réparation est la plus petite qui rétablit le service, et elle se prouve en rejouant une recette qui contrôle aussi ce qui doit rester refusé. Une panne se répare en remettant la couche fautive dans son état prévu, pas en retirant la garde qui la révélait. Désactiver la vérification TLS fait « marcher » un certificat faux, ouvrir le backend directement au public fait « marcher » une route cassée, et les deux laissent le service moins sûr qu'avant la panne.
La recette est un ensemble de vérifications rejouées depuis le client indépendant, une fois la réparation faite. Elle couvre le nom, le certificat, la route métier, mais aussi trois refus : une route interne doit continuer à répondre 403 (interdit), ce que ce lab exige, le backend ne doit pas être joignable directement depuis le client, et le port public ne doit pas répondre en HTTP en clair. Une recette qui ne contrôle que le succès valide une réparation qui a pu ouvrir une brèche.
Rejouez la recette plusieurs fois : un 200 obtenu une fois peut venir de la chance, d'un cache ou d'un backend parmi plusieurs. Plusieurs réponses identiques valent mieux qu'une seule, et le lab en exige trois. La même logique, appliquée à une mise en service, est décrite dans Préparer la publication, la reprise et le retour arrière.
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab vous confie un service publié en TLS derrière un routeur, avec un backend protégé. Une panne a été tirée au sort parmi cinq couches, DNS, transport, TLS, route et backend, et un bruit de fond sans rapport avec elle encombre le journal. Vous observez depuis le client indépendant et depuis la machine du service, tenez un journal d'enquête, nommez la couche et le composant fautifs dans un fichier de diagnostic, puis réparez. Le lab nomme les couches dns, transport, tls, route et backend : elles correspondent, dans l'ordre de cette leçon, au nom, au port, à TLS, au routage et à l'application.
La validation lit votre travail sur la machine : le journal d'enquête doit porter au moins deux observations horodatées, une hypothèse, un test et une issue, mais le test ne juge que la présence de cette trace, pas la qualité du raisonnement. La couche nommée doit être la couche réellement tirée, et le composant doit nommer le composant fautif sans citer ceux des autres couches. Après réparation, le test interroge le DNS depuis le client, exige trois 200 de suite, un 403 sur la route interdite, aucune réponse du backend en accès direct et aucune réponse en clair sur le port 443.
À retenir
Section intitulée « À retenir »- Un service publié se diagnostique en descendant cinq couches dans l'ordre du trajet : nom, port, TLS, route, application. La première qui échoue est la couche à examiner en premier : c'est une méthode, pas une loi.
- Un message d'erreur nomme ce que le client a constaté, pas la couche en cause : un même code se produit à plusieurs étages.
- On observe depuis un client indépendant pour savoir où ça casse, puis depuis l'opérateur pour savoir pourquoi.
- Une connexion refusée revient en quelques secondes, un hôte injoignable attend la borne de connexion, mais aucun des deux ne désigne à lui seul une cause unique.
- On teste TLS avec l'autorité désignée par
--cacert, jamais avec-k, qui supprime le test. - Le point d'entrée voit des requêtes que l'application ne voit jamais, et un rejeu peut masquer une panne au client : on interroge le backend directement pour juger sa santé.
- Une hypothèse se teste par un geste qui peut la réfuter, et on conclut sur celle qu'aucun test n'a écartée, un changement à la fois. Un avertissement alarmant n'est pas une cause tant qu'un test ne l'a pas relié à la panne.
- Un silence a au moins trois causes : panne réelle, absence de trafic, collecte perdue.
- On répare par la plus petite correction, puis on rejoue une recette qui contrôle aussi les refus : route interne, backend isolé, pas de HTTP en clair.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Ces questions vérifient que vous savez ordonner les couches, choisir le geste qui tranche à chaque étage et réparer sans affaiblir une protection.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Épreuve du socle : concevoir et réceptionner la publication d'un service
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications