Publier un service web, c'est faire arriver une requête HTTPS venue d'Internet sur une application qui n'est pas elle-même exposée. Entre les deux, un reverse proxy (un serveur placé devant vos applications) reçoit la connexion sur le port 443 (le port 80 sert à rediriger vers lui et à valider les certificats), choisit le certificat d'après le nom demandé, déchiffre, choisit la route d'après l'en-tête Host, puis transmet au backend (l'application qui répond vraiment). Cette leçon, écrite pour des administrateurs, des ops et des développeurs qui auto-hébergent, décrit ce trajet indépendamment du produit : les mesures citées viennent de Traefik et de Nginx, mais les mécanismes sont les mêmes partout. Elle montre aussi ce que le backend peut croire, ce qu'un proxy ne doit jamais faire, et les erreurs que vous verrez.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Décrire le trajet d'une requête, du nom DNS jusqu'au backend
- Distinguer ce que décident le SNI (le certificat) et l'en-tête Host (la route)
- Choisir entre terminaison TLS (déchiffrer au proxy), re-chiffrement et passthrough (relayer sans déchiffrer), et en mesurer les conséquences
- Appliquer la règle de confiance sur
X-Forwarded-Foret ses voisins - Expliquer la répartition et les sondes actives ou passives
- Associer les erreurs 404, 502, 503, 504 et celles de certificat à leur cause
Prérequis
Section intitulée « Prérequis »Cette leçon suppose les formations Réseau et Docker : vous savez ce qu'est une adresse IP, un port, une résolution DNS (voir DNS), et vous avez déjà lancé un conteneur. Lisez aussi, avant de commencer, Reverse proxy : définition, rôle et quel outil choisir, qui situe le reverse proxy dans une architecture et survole le trajet d'une requête. Ici, le point de vue est celui de la requête : on y regarde de près les deux décisions du proxy (SNI et Host), ce que le backend peut croire de ce qu'il reçoit, et les erreurs que chaque étage produit.
Pour lire un échange HTTP ou un certificat à la main, deux guides existent déjà et ne sont pas refaits ici : HTTP et HTTPS pour les en-têtes et les codes de statut, le diagnostic TLS avec openssl pour la lecture d'un certificat.
Quel chemin suit une requête du navigateur jusqu'au backend ?
Section intitulée « Quel chemin suit une requête du navigateur jusqu'au backend ? »Une requête publiée traverse quatre étapes, plus une redirection facultative : résolution du nom en adresse IP publique, connexion TLS sur le port 443 du proxy, lecture de la requête HTTP déchiffrée, puis transmission au backend. Le proxy est le seul élément exposé, sur deux ports : le 443 porte le trafic utile, le 80 ne sert qu'à rediriger et à valider les certificats. Les backends restent sur un réseau privé et ne parlent qu'au proxy.
Regardez le schéma ci-dessous de gauche à droite. Le trait en pointillé est la résolution DNS, qui a lieu avant tout contact avec le proxy. Le trait épais est le chemin du trafic utile, en HTTPS sur le port 443. Le trait fin vers le proxy est une éventuelle première visite en HTTP sur le port 80, qui n'aboutit qu'à une redirection. Les deux traits fins vers les backends sont internes : aucun client n'y accède directement.
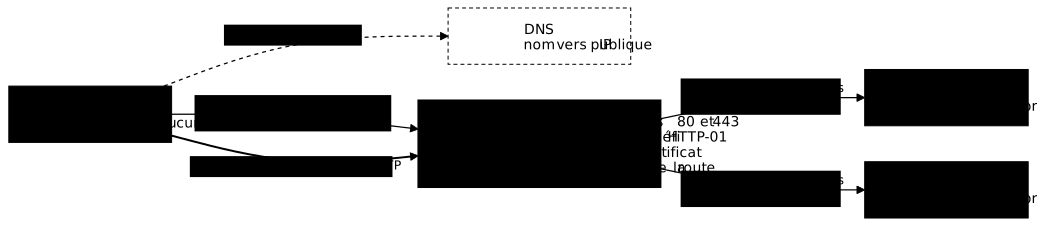
Concrètement, avec un service nommé app.exemple.fr :
- Le navigateur demande au DNS l'adresse de
app.exemple.fr. L'enregistrementA(ouAAAA) renvoie l'IP publique de la machine qui porte le proxy, pas celle de l'application. - Étape facultative : la requête arrive d'abord en HTTP sur le port 80 quand elle suit un lien en
http://, vient d'un ancien client ou d'un outil commecurl, ou quand l'essai en HTTPS a échoué. Les navigateurs récents essaient en effet HTTPS d'abord : pour un nom tapé sans schéma (Chrome depuis sa version 90, en 2021), puis aussi pour un lien enhttp://(Chrome 115, en 2023), et ne retombent sur HTTP qu'en repli. Le proxy répond sur le 80 par une redirection vershttps://app.exemple.fr/. - Le navigateur ouvre une connexion TCP vers cette IP, port 443. Le pare-feu ou la box doit laisser passer ce port jusqu'au proxy.
- Il engage la négociation TLS en annonçant le nom voulu (c'est le SNI, détaillé plus bas), puis envoie sa requête HTTP chiffrée.
- Le proxy déchiffre, choisit la route, ouvre sa propre connexion vers un backend et recopie la réponse vers le client.
Le port 80 doit donc rester ouvert, pour deux raisons. Sans lui, un client qui ne tente pas HTTPS d'abord (curl, un script, un navigateur ancien) n'obtient rien, au lieu d'être redirigé. Et le défi HTTP-01 de la validation de certificat s'y déroule : l'autorité de certification interroge le proxy en HTTP, comme le détaille la leçon Certificats automatiques : ACME, défis HTTP-01, TLS-ALPN-01 et DNS-01.
Une fois la redirection suivie, l'en-tête HSTS (Strict-Transport-Security) peut demander au navigateur de ne plus repasser par HTTP pour ce nom pendant la durée indiquée : il va directement en HTTPS. Son réglage dans Traefik est montré dans Sécuriser Traefik : authentification, rate limiting et bonnes pratiques ; il ne dispense pas d'ouvrir le port 80 pour les clients qui y arrivent encore.
Dix noms peuvent pointer vers la même IP pour dix applications : c'est le proxy qui distingue les applications, jamais le DNS. Le HTTP/3, qui voyage en UDP sur le port 443, sort du périmètre de cette leçon.
Comment le proxy choisit-il le certificat, puis la route ?
Section intitulée « Comment le proxy choisit-il le certificat, puis la route ? »Le proxy prend deux décisions distinctes, à deux moments distincts : le SNI choisit le certificat avant tout HTTP, l'en-tête Host choisit la route une fois la requête déchiffrée. Les confondre est la source de la plupart des diagnostics faux.
Le SNI (Server Name Indication) est une extension de la négociation TLS : le client y écrit le nom du serveur voulu, en clair, dans son premier message (ClientHello). Sans lui, le proxy ne saurait pas quel certificat présenter, puisqu'une même IP et un même port 443 servent plusieurs noms. S'il ne trouve aucun certificat pour ce nom, il présente un certificat par défaut, et le client affiche une erreur de certificat : le nom ne correspond pas.
Parce que le SNI circule en clair, un intermédiaire peut lire le nom visité. ECH (Encrypted Client Hello) est l'extension récente qui chiffre ce nom ; elle sort du cadre de cette leçon, et le guide le diagnostic TLS avec openssl en dit l'essentiel.
L'en-tête Host est un en-tête HTTP, donc chiffré dans la requête. Le proxy le lit après déchiffrement pour trouver la route : quel backend reçoit app.exemple.fr, lequel reçoit wiki.exemple.fr. En HTTP/2 (RFC 9113, section 8.3.1) comme en HTTP/3, le même rôle est tenu par le pseudo-champ :authority, que les proxys traitent de la même façon.
Que devient une requête dont le Host ne correspond à aucune route ? Cela dépend du produit. Traefik répond un 404 produit par lui-même. Nginx envoie la requête au server désigné comme default_server (à défaut, le premier déclaré), et HAProxy au default_backend. Un défaut qui sert une application est un piège classique : elle répond alors à n'importe quel nom, y compris à une IP nue. La règle est de déclarer un défaut qui refuse (404, ou fermeture de la connexion).
Comment observer le certificat choisi par le SNI ?
Section intitulée « Comment observer le certificat choisi par le SNI ? »La commande openssl s_client lit le certificat que le proxy présente pour un nom donné. Le SNI se précise avec -servername, sans rien modifier côté serveur :
openssl s_client -connect 203.0.113.10:443 -servername app.exemple.fr </dev/null 2>/dev/null | openssl x509 -noout -subject -issuerRelancez-la en changeant -servername, ou en le retirant : le certificat présenté change, ce qui prouve que le SNI est bien le critère. L'adresse 203.0.113.10 appartient à une plage réservée à la documentation ; remplacez-la par celle de votre proxy.
Rejoué sur Traefik 3.7.6 (la formation vise la 3.7.15 : comportement à reconfirmer) avec deux certificats auto-signés (a.lab.test et b.lab.test), le résultat est le suivant :
-servername | Certificat présenté |
|---|---|
a.lab.test | subject=CN = a.lab.test |
b.lab.test | subject=CN = b.lab.test |
| un nom inconnu, ou aucun (une adresse IP ne s'envoie pas comme SNI) | subject=CN = TRAEFIK DEFAULT CERT, le certificat par défaut du proxy |
Comment tester la route avant que le DNS ne soit configuré ?
Section intitulée « Comment tester la route avant que le DNS ne soit configuré ? »L'option --resolve de curl force la résolution d'un nom, ce qui teste le routage avant la mise en place du DNS :
curl -v --resolve app.exemple.fr:443:203.0.113.10 https://app.exemple.fr/--resolve nom:port:ip fait croire à curl que le nom pointe vers cette IP, tout en gardant le nom dans le SNI et dans Host. Sur un port autre que 443, curl ajoute le port à Host (Host: app.exemple.fr:8443).
Pour dissocier les deux étages, ajoutez -H "Host: wiki.exemple.fr" : le certificat reste choisi par le SNI de l'URL, la route par le Host modifié. Sur le même banc Traefik, --resolve suivi de -H "Host: b.lab.test" a affiché le certificat CN=a.lab.test (SNI de l'URL) mais la réponse du backend b (route du Host), et un Host inconnu a renvoyé un 404 du proxy. Cette expérience est la meilleure façon de comprendre la différence.
Que change la terminaison TLS pour le backend ?
Section intitulée « Que change la terminaison TLS pour le backend ? »Terminer le TLS, c'est déchiffrer au niveau du proxy : le backend reçoit alors du HTTP en clair, sur un réseau que vous contrôlez. C'est le mode le plus courant, parce qu'il centralise les certificats en un seul endroit et permet au proxy de lire Host pour router.
Trois modes existent, selon l'endroit où le déchiffrement a lieu :
| Mode | Ce qui circule vers le backend | Ce que le proxy peut lire | Quand le choisir |
|---|---|---|---|
| Terminaison | HTTP en clair | tout (Host, chemin, en-têtes) | réseau privé de confiance, cas général |
| Re-chiffrement | HTTPS, avec un second certificat | tout | exigence de chiffrement de bout en bout interne |
| Passthrough | TLS d'origine, non déchiffré | uniquement le SNI | le backend doit garder son certificat |
Le re-chiffrement ajoute un certificat à gérer côté backend et coûte du calcul, mais rien ne circule en clair sur le réseau interne. Le passthrough relaie les octets sans les lire : le proxy ne voit ni Host ni chemin, ne peut router que d'après le SNI, ne peut ajouter aucun en-tête ni appliquer de protection HTTP. Pour un service web publié derrière un proxy applicatif, la terminaison est la règle, et le passthrough l'exception.
La terminaison a une conséquence directe : le backend ne voit plus le HTTPS, et selon le réglage du proxy il peut aussi perdre le nom d'origine (certains proxys remplacent Host par celui du backend). Il croit parler en HTTP à une machine voisine. Une application qui construit ses propres liens ou redirections peut alors produire des URL en http://, et provoquer des boucles de redirection : elle redirige vers HTTPS, le proxy lui reparle en HTTP, et elle redirige de nouveau. C'est le rôle des en-têtes de la section suivante.
La perte de l'IP du client n'est pas due à la terminaison TLS : elle vient du simple passage par un proxy, quel que soit le mode. Le backend voit une connexion TCP qui vient du proxy, donc l'IP du proxy. En terminaison, le proxy la signale par des en-têtes HTTP. En passthrough, il ne peut pas en ajouter, et le backend retrouve l'IP par le PROXY protocol : le proxy écrit l'adresse du client dans un en-tête placé au tout début de la connexion TCP (version 1 en texte, version 2 en binaire).
Le PROXY protocol s'active des deux côtés : un backend qui ne l'attend pas lit cet en-tête comme des données invalides, et un backend qui l'attend refuse une connexion qui ne le porte pas. Activé d'un seul côté, il casse donc la connexion. Le backend ne doit l'accepter que d'un proxy de confiance, sans quoi n'importe qui peut y écrire l'adresse de son choix. La configuration relève des leçons propres à chaque produit.
Que sait le backend du client réel, et peut-il le croire ?
Section intitulée « Que sait le backend du client réel, et peut-il le croire ? »Le proxy transmet l'origine de la requête dans des en-têtes, mais le backend ne doit les croire que s'ils viennent du proxy : n'importe quel client peut en envoyer lui-même. Sans cette règle, une IP se falsifie en une ligne.
Les en-têtes courants sont les suivants :
| En-tête | Contenu | Exemple |
|---|---|---|
X-Forwarded-For | liste des adresses des clients et proxys précédents, client en tête ; l'adresse du dernier proxy n'y figure pas, c'est la source TCP | 198.51.100.7, 192.0.2.10 |
X-Forwarded-Proto | protocole demandé par le client | https |
X-Forwarded-Host | nom demandé par le client | app.exemple.fr |
Forwarded | forme normalisée qui regroupe les trois (RFC 7239) | for=198.51.100.7;proto=https;host=app.exemple.fr |
X-Forwarded-* est une convention historique répandue ; Forwarded est sa version normalisée par la RFC 7239. Les deux coexistent, et une application lit celle que son framework supporte. Dans Forwarded, une adresse IPv6 ou une adresse avec port doit être entre guillemets : for="[2001:db8:cafe::17]:4711" (RFC 7239, section 6).
Le piège tient au mot « liste ». Chaque proxy qui reçoit une requête ajoute à la fin de X-Forwarded-For l'adresse de son interlocuteur, et c'est cette liste que le backend lit, en plus de la source TCP de la connexion. Avec deux proxys en chaîne, le schéma suivant montre ce qui circule : la source TCP change à chaque saut, tandis que la liste grandit d'une adresse. Regardez la dernière flèche : le backend reçoit 198.51.100.7, 192.0.2.10 dans l'en-tête, et 10.0.0.2 (le proxy B) comme source TCP.
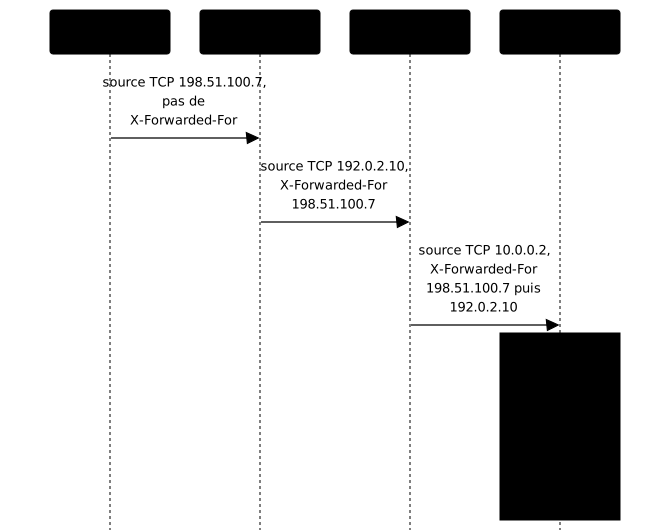
Si un client envoie lui-même X-Forwarded-For: 10.0.0.5 (une adresse interne de confiance) à un proxy qui lui fait confiance ou qui ajoute sans filtrer, le proxy y ajoute l'IP réelle du client, et le backend reçoit 10.0.0.5, 198.51.100.7 (avec un seul proxy, dont l'adresse est la source TCP). Une application qui lit le premier élément conclut que la requête vient de 10.0.0.5 : un filtrage par IP ou une limitation de débit est contourné.
Le comportement dépend du réglage du proxy. Mesuré avec Traefik 3.7.6 devant traefik/whoami, qui affiche les en-têtes reçus, un curl -H "X-Forwarded-For: 10.0.0.5" venu de 10.10.110.1 donne deux résultats. Par défaut, le client n'étant pas déclaré de confiance, le proxy écrase l'en-tête : le backend reçoit X-Forwarded-For: 10.10.110.1. Avec forwardedHeaders.trustedIPs: ["10.10.110.0/24"] sur le point d'entrée, le proxy conserve l'en-tête et ajoute l'IP observée : le backend reçoit X-Forwarded-For: 10.0.0.5, 10.10.110.1. Déclarer de confiance une plage qui contient des clients ouvre donc la falsification.
La règle de confiance a trois volets, deux du côté du backend et un du côté du proxy :
- le backend n'accepte ces en-têtes que d'une liste de proxys de confiance (le réglage s'appelle souvent trusted proxies), c'est-à-dire les adresses de vos propres proxys ;
- il part de la source TCP de la connexion, puis lit
X-Forwarded-Forde droite à gauche, en sautant les adresses de confiance : la première qui n'en est pas une est le client ; - un proxy placé en bordure d'Internet ne fait pas confiance aux en-têtes
X-Forwarded-*reçus d'un client inconnu : il les écrase par ce qu'il a lui-même observé.
Vous pouvez le tester avec curl : envoyez curl -H "X-Forwarded-For: 10.0.0.5" https://app.exemple.fr/ puis regardez dans le journal du backend quelle adresse il retient. Si le premier élément retenu est 10.0.0.5, la confiance est mal réglée. Le rappel du risque se trouve aussi dans HTTP et HTTPS ; la configuration, elle, dépend de chaque produit et vit dans les leçons qui les traitent.
Comment le proxy répartit-il la charge et détecte-t-il une panne ?
Section intitulée « Comment le proxy répartit-il la charge et détecte-t-il une panne ? »Quand plusieurs copies d'un service existent, le proxy choisit une copie pour chaque requête et retire celles qui ne répondent plus, d'après des sondes. Sans sonde, il continue d'envoyer des requêtes à une copie arrêtée, et les clients reçoivent des erreurs.
Le choix de la copie suit un algorithme : tour à tour (round robin), vers la copie qui a le moins de connexions ouvertes, ou avec un poids différent par copie. Pour un service sans état, le tour à tour suffit. Si l'application garde la session d'un utilisateur en mémoire, il faut en plus une persistance (« sticky session ») qui renvoie le même client vers la même copie.
Pour savoir quelles copies sont saines, deux familles de sondes existent :
| Sonde | Principe | Avantage | Limite |
|---|---|---|---|
| Active | le proxy interroge lui-même une route de santé à intervalle fixe | détecte la panne sans attendre l'échec d'un client | consomme quelques requêtes en continu ; délai de détection non nul |
| Passive | le proxy observe les échecs des vraies requêtes et retire la copie après N échecs | rien à configurer côté application | des clients subissent les premières erreurs |
Les deux se combinent. Certains proxys open source n'offrent que la détection passive (Nginx open source par exemple) : le résultat attendu reste le même, mais le chemin pour l'obtenir diffère. Une bonne sonde active interroge une route de santé dédiée, qui dit si la copie elle-même peut servir sans dépendre de toutes ses dépendances ; la logique complète, dont le piège d'une sonde qui retire toutes les copies à la fois, est détaillée dans Répartiteur de charge, passerelle d'API, ingress : les distinguer. Le critère de réussite est observable : on arrête une copie, et aucun client ne reçoit d'erreur durablement.
Attention à ce que la sonde active garantit vraiment. Elle détecte la panne sans attendre qu'une requête de client échoue, mais pas instantanément : le délai est d'environ intervalle × seuil (par exemple 10 secondes d'intervalle et 3 échecs consécutifs avant retrait, soit une trentaine de secondes). Pendant ce temps, des requêtes peuvent encore atteindre la copie arrêtée. Ce qui supprime l'erreur côté client, ce sont les nouvelles tentatives (retry) : le proxy rejoue la requête vers une autre copie. Cette parade a une limite : on ne rejoue sans risque que les requêtes idempotentes (une lecture, par exemple), jamais un paiement ou une création qui pourrait s'exécuter deux fois. Si aucune copie n'est saine, le code renvoyé dépend du produit.
Que ne doit jamais faire un proxy ?
Section intitulée « Que ne doit jamais faire un proxy ? »Un proxy publié ne doit jamais exposer les backends en direct, faire confiance aux en-têtes d'un client, ni ouvrir son interface d'administration à Internet. Chacune de ces trois erreurs annule la protection que le proxy est censé apporter.
-
Backends joignables en direct. Si l'application écoute aussi sur une IP publique, un attaquant la contacte sans passer par le proxy, donc sans limitation ni filtrage. Avec Docker, publier un port (
-p 8080:80) l'ouvre par défaut sur toutes les interfaces de l'hôte, et contourne les règles du pare-feu de la machine, par exemple ufw : Docker redirige ce trafic vers le conteneur, et il ne subit pas la règle « deny incoming » d'ufw.Mesuré sur Ubuntu 24.04 avec Docker 29.9.1 et ufw actif (
Default: deny (incoming), seul SSH autorisé) : depuis une autre machine,curl http://10.10.110.11:8080répondait 200, alors qu'un service lancé directement sur l'hôte (port 9090) restait injoignable.Pour restreindre l'accès, publiez sur
127.0.0.1(-p 127.0.0.1:8080:80, le port n'est alors plus joignable depuis l'extérieur), ou ne publiez aucun port et joignez le backend par un réseau privé interne. Filtrer un port déjà publié est possible dans la chaîneDOCKER-USER, mais avec un piège détaillé dans l'encadré ci-dessous. -
Confiance accordée aux en-têtes du client. C'est la règle de la section précédente : une IP, un protocole ou un nom lus dans un en-tête qui n'a pas été posé par le proxy n'ont aucune valeur.
-
Interface d'administration ouverte. La plupart des proxys offrent un tableau de bord ou une API pour voir et modifier leur configuration. Les exposer sur le même point d'entrée que les applications donne à n'importe qui la main sur le routage. Elles restent sur une interface locale ou derrière une authentification.
Ces trois règles se vérifient depuis l'extérieur : tester l'IP et le port du backend depuis une machine qui n'est pas sur le réseau privé doit échouer, et le tableau de bord ne doit pas répondre sur le nom public. La mise en œuvre est pratiquée dans les leçons Traefik de cette formation, avec les protections de chaque produit.
Quelles erreurs verrez-vous, et que disent-elles ?
Section intitulée « Quelles erreurs verrez-vous, et que disent-elles ? »Chaque code d'erreur d'un proxy désigne un étage précis du trajet, ce qui permet de localiser la panne avant de lire le moindre journal. Le tableau situe l'étage ; les journaux du proxy et du backend confirment ensuite la cause.
| Ce que vous voyez | Étage en cause | Cause probable |
|---|---|---|
| Erreur de certificat dans le navigateur | négociation TLS (SNI) | nom absent du certificat, certificat expiré ou certificat par défaut présenté |
| 404 produit par le proxy | choix de la route (Host) | aucune route ne correspond au nom demandé (Traefik ; Nginx et HAProxy servent leur défaut) |
| « Trop de redirections » dans le navigateur | transmission au backend | X-Forwarded-Proto non lu par l'application, ou non cru parce que le proxy n'est pas déclaré de confiance : elle redirige sans fin vers HTTPS |
| 502 Bad Gateway | connexion au backend | connexion refusée (backend arrêté, mauvais port) ou réponse invalide |
| 503 Service Unavailable | répartition | aucune copie saine disponible (selon le produit) |
| 504 Gateway Timeout | attente du backend | backend trop lent à répondre, ou connexion qui n'aboutit pas dans le délai |
Un moyen de retenir la logique : l'erreur de certificat arrive avant HTTP, le 404 se produit au moment de choisir la route, le 502 et le 504 apparaissent quand le proxy essaie de joindre le backend. Un 404 qui vient du backend lui-même (chemin inexistant dans l'application) ne dit en revanche rien du proxy : il faut regarder quel étage a produit la réponse.
Le choix entre 502 et 503 dépend du produit. La RFC 9110 définit le 502 comme une réponse invalide reçue d'en amont et le 503 comme un service momentanément incapable de traiter la requête ; selon le proxy, « aucune copie saine » donne un 503 ou un 502. Nginx open source 1.30.6, mesuré avec deux backends dans le même groupe upstream (la liste de backends que Nginx répartit), ne renvoie jamais de 503 ici. Le code dépend de la façon dont le backend est injoignable :
- Connexion refusée (backend arrêté, port fermé) : réponse 502 tout de suite. Le journal indique
connect() failed (111: Connection refused), puisno live upstreamstant que les copies sont écartées. - Silence (deux conteneurs arrêtés dont l'adresse ne répond plus) : la première requête attend l'expiration de la connexion et reçoit un 504, les suivantes un 502.
Pourquoi les délais comptent-ils pour les gros envois et les websockets ?
Section intitulée « Pourquoi les délais comptent-ils pour les gros envois et les websockets ? »Un proxy applique plusieurs délais : un pour établir la connexion vers le backend, un pour attendre la réponse (lecture), un pour couper une connexion inactive. Un délai de lecture trop court produit des 504 sur un traitement légitime mais long. Un délai d'inactivité coupe un téléversement volumineux dont le débit s'interrompt, ou une connexion websocket qui reste ouverte sans échanger pendant un moment. Les valeurs par défaut diffèrent selon le produit et ne sont pas données ici : repérez ces trois délais dans la documentation du vôtre avant de publier un envoi de gros fichiers ou un service temps réel.
Mettre en pratique
Section intitulée « Mettre en pratique »La section sur le SNI et l'en-tête Host annonçait deux décisions indépendantes ; le lab vous les fait observer sur deux noms publiés en TLS à la même adresse. Vous distinguez d'abord une résolution DNS normale d'une résolution forcée, puis vous constatez que le SNI choisit le certificat, chaîne et SAN vérifiés, tandis que l'en-tête Host décide seul de l'application atteinte. La validation contrôle ces quatre points, dont le dernier : un nom inconnu n'est servi par aucune application par accident.
À retenir
Section intitulée « À retenir »- Le DNS donne l'IP du proxy, jamais celle du backend ; le proxy est le seul point exposé.
- Le SNI choisit le certificat avant tout HTTP ; l'en-tête
Hostchoisit la route après déchiffrement. Sans route correspondante, Traefik répond 404, Nginx sert sondefault_serveret HAProxy sondefault_backend: déclarez un défaut qui refuse. - Le port 80 reste ouvert : redirection vers HTTPS et défi HTTP-01.
- La terminaison TLS donne au backend du HTTP en clair sur un réseau privé ; le re-chiffrement et le passthrough sont des variantes à justifier.
- Un backend ne croit
X-Forwarded-For,X-Forwarded-ProtoetForwardedque s'ils viennent d'un proxy de confiance, lus de droite à gauche depuis la source TCP. En passthrough, l'IP du client passe par le PROXY protocol. - Une sonde active détecte une panne sans attendre l'échec d'un client, en environ intervalle × seuil ; une sonde passive réagit après des échecs réels. Les nouvelles tentatives vers une autre copie, limitées aux requêtes idempotentes, masquent l'intervalle de détection.
- Un proxy n'expose jamais les backends en direct (un port publié par Docker contourne ufw), ne croit pas les en-têtes du client et garde son administration fermée.
- Erreur de certificat : TLS. 404 : route. 502 : backend qui refuse la connexion ou répond mal. 504 : backend qui ne répond pas dans le délai. 503 : aucune copie saine, selon le produit (Nginx ne le renvoie pas dans ce cas). « Trop de redirections » :
X-Forwarded-Protonon lu ou non cru.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Certificats automatiques : ACME, défis HTTP-01, TLS-ALPN-01 et DNS-01
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications