Un bloc upstream répartit les requêtes entre plusieurs backends (les serveurs d'application placés derrière le proxy), et Nginx open source retire un backend défaillant d'après les requêtes réelles de vos clients, jamais en l'interrogeant de lui-même. Cette leçon s'adresse à une personne qui sait déjà publier une application avec proxy_pass : elle approfondit le bloc upstream que la leçon précédente n'a fait que présenter. Elle enseigne comment déclarer un groupe de serveurs, comment régler la détection passive (max_fails, fail_timeout), pourquoi proxy_next_upstream peut doubler une action si on le règle mal, et comment mesurer le temps que Nginx met à retirer une panne. Le résultat attendu est le même qu'avec Traefik, un backend malade qui sort de la rotation, mais le chemin diffère.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »La leçon suit le fil d'une panne : déclarer, détecter, rejouer, mesurer.
- Déclarer un groupe de backends avec poids, serveur de secours et algorithme.
- Régler
max_failsetfail_timeoutavec des valeurs que vous savez justifier. - Choisir ce que
proxy_next_upstreamrejoue, sans doubler une écriture. - Mesurer le retrait d'un backend fautif par le trafic qu'il reçoit encore, pas par les erreurs vues.
- Distinguer la capacité de Nginx open source des fonctions commerciales.
Prérequis
Section intitulée « Prérequis »La leçon suppose que vous savez publier un service derrière Nginx et lire un échange HTTP.
- Publier une application avec
proxy_pass: Publier une application avec Nginx. - Le trajet d'une requête jusqu'au backend : Publier un service web.
- La notion de méthode idempotente : Lire HTTP avant de configurer un proxy.
- Un compte avec
sudosur une machine Debian 13, où Nginx 1.31.8 est installé depuis le dépôt de l'éditeur (nginx.org) : la configuration vit dans/etc/nginx/conf.d/.
Comment Nginx répartit-il les requêtes entre plusieurs backends ?
Section intitulée « Comment Nginx répartit-il les requêtes entre plusieurs backends ? »Un bloc upstream nomme un groupe de serveurs, et proxy_pass désigne ce groupe par son nom ; sans autre réglage, Nginx tourne tour à tour sur chaque serveur. La leçon Publier une application avec Nginx en a montré le principe ; voici les réglages qu'elle n'a pas détaillés. Le groupe se déclare au niveau http, à côté des blocs server, et chaque ligne server du groupe prend une adresse suivie de paramètres.
upstream applicatif {    server 127.0.0.1:18095 weight=3;    server 127.0.0.1:18096;    server 127.0.0.1:18097 backup;}
server {    listen 80;    server_name app.lab.test;
    location / {        proxy_pass http://applicatif;        proxy_set_header Host $host;    }}
Trois paramètres de ligne server servent tous les jours. Le weight donne un poids : ici le premier backend reçoit trois requêtes pour une au deuxième (le poids par défaut vaut 1). Le paramètre backup désigne un serveur de secours, utilisé seulement quand tous les serveurs normaux sont indisponibles. Le paramètre down marque un serveur retiré à la main, utile pour une maintenance planifiée.
Le choix de l'algorithme se fait par une directive en tête de groupe. Par défaut, c'est le tourniquet (round robin), qui sert les serveurs l'un après l'autre en tenant compte des poids. least_conn envoie la requête au serveur qui a le moins de connexions actives, ce qui convient quand les durées de traitement varient beaucoup. ip_hash associe une adresse cliente à un serveur, ce qui donne une affinité grossière, mais fausse dès que beaucoup d'utilisateurs partagent une adresse, par exemple derrière un NAT (plusieurs machines qui sortent sous une seule adresse publique).
Un dernier réglage change les performances sans changer la répartition : les connexions persistantes vers les backends. Au lieu d'ouvrir puis de fermer une connexion TCP à chaque requête, Nginx garde des connexions inactives en attente, par processus worker (les processus qui traitent les requêtes). Elles sont actives d'office (depuis la 1.29.7), au nombre de 32 par worker, et Nginx parle HTTP/1.1 à ses backends par défaut : le location n'a besoin d'aucune directive supplémentaire.
La directive keepalive N, placée dans le bloc upstream, change ce plafond de connexions inactives. Elle ne limite pas le nombre total de connexions ouvertes vers l'amont, seulement celles qui attendent sans servir. Un paramètre local empêche en outre leur partage entre des location différents.
upstream applicatif {    server 127.0.0.1:18095;    server 127.0.0.1:18096;    keepalive 64;}
location / {    proxy_pass http://applicatif;}
Pour porter le plafond à 64 sous forte charge, l'exemple ci-dessus suffit. Lisez la version avec nginx -v, ou avec nginx -V comme dans la leçon Installer Nginx : master, workers et contextes, avant de copier un exemple trouvé en ligne : les directives disponibles changent d'une version à l'autre.
Comment Nginx détecte-t-il un backend en panne sans sonde ?
Section intitulée « Comment Nginx détecte-t-il un backend en panne sans sonde ? »Nginx open source n'a aucune sonde active : il ne va jamais demander à un backend s'il va bien, il juge d'après les requêtes que les clients lui font déjà passer. Cette détection passive repose sur deux paramètres de la ligne server, max_fails et fail_timeout. Le premier est le nombre d'échecs qui déclenchent le retrait, le second est une durée qui sert deux fois : c'est la fenêtre dans laquelle les échecs s'additionnent, puis la durée pendant laquelle le backend retiré reste écarté. Les valeurs par défaut sont max_fails=1 et fail_timeout=10s : sans réglage, un seul échec suffit à écarter un backend pendant dix secondes.
upstream applicatif { server 127.0.0.1:18095 max_fails=3 fail_timeout=15s; server 127.0.0.1:18096 max_fails=3 fail_timeout=15s;}Lisez ces valeurs ainsi : si trois tentatives échouent sur un backend en moins de quinze secondes, Nginx le considère indisponible pendant quinze secondes. À l'échéance, il lui renvoie une requête réelle pour voir s'il répond. Si elle réussit, le backend reprend sa part du trafic ; sinon il repart pour une nouvelle période. Le schéma ci-dessous montre ce cycle : suivez le chemin d'une requête qui échoue, jusqu'au retrait et au retour du backend.
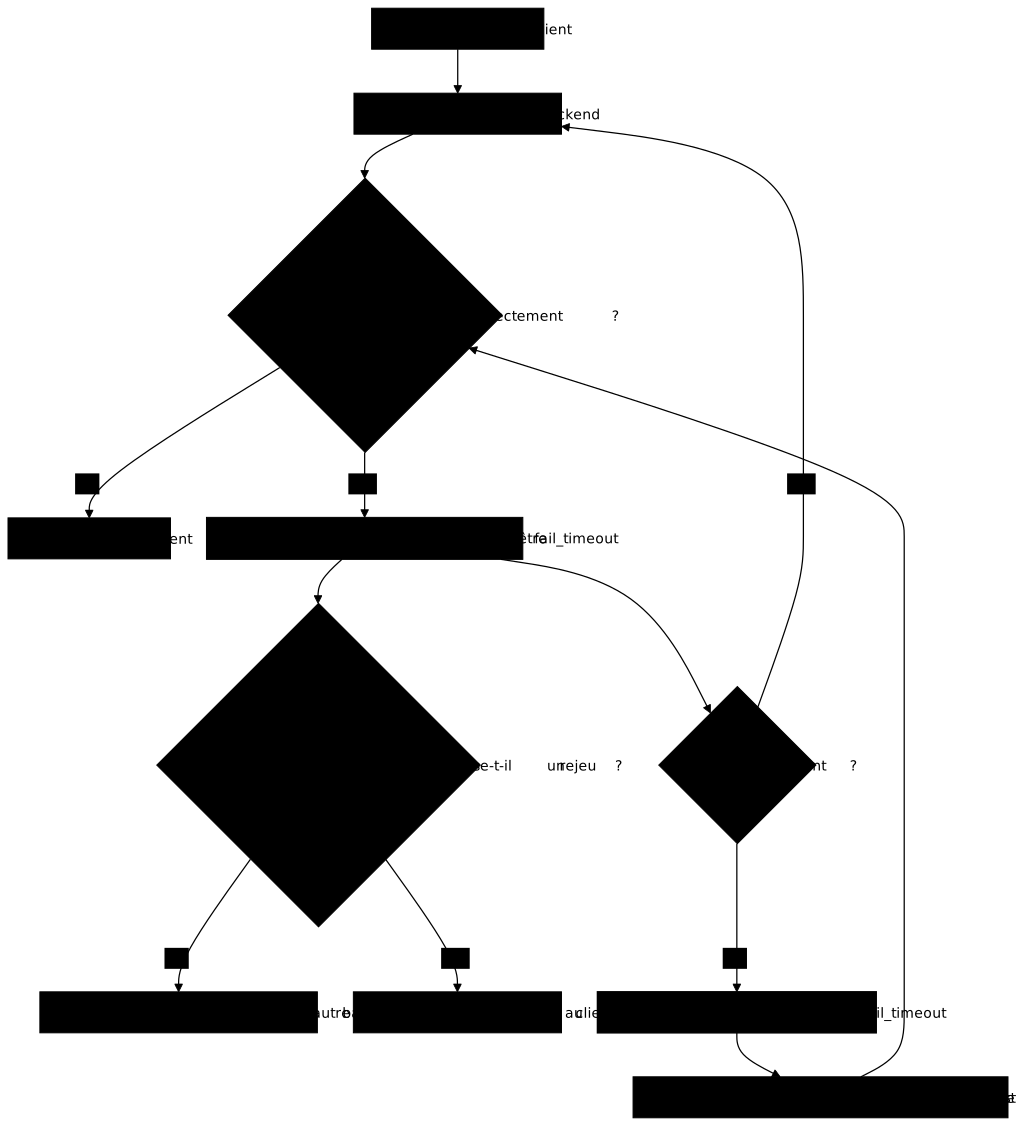
Deux valeurs piègent les débutants. max_fails=0 désactive la détection : le compteur n'existe plus, et un backend en erreur garde sa part du trafic indéfiniment. Et un groupe d'un seul serveur ignore max_fails et fail_timeout : ce serveur n'est jamais déclaré indisponible, puisqu'il n'y a nulle part où envoyer le trafic à sa place. Une configuration avec un seul backend n'a donc pas les mêmes effets de retrait qu'un vrai groupe.
Reste à savoir ce qui compte comme un échec, et la réponse tient en trois catégories. Les cas error (erreur de connexion ou de transmission), timeout (dépassement de délai), denied et invalid_header comptent toujours, même s'ils ne figurent pas dans la directive proxy_next_upstream, décrite juste après. Les codes 500, 502, 503, 504 et 429 ne comptent que s'ils figurent dans proxy_next_upstream : un backend qui répond 500 sans que http_500 y soit listé n'accumule donc aucun échec et n'est jamais retiré. Un code 404 ou 403 de l'application n'est jamais compté, quelle que soit la configuration.
Les délais proxy_connect_timeout et proxy_read_timeout fixent ce que « trop lent » veut dire. Si proxy_read_timeout est plus long que la lenteur d'un backend lent, aucun timeout ne se produit et ce backend n'est jamais compté en échec.
Que se passe-t-il quand Nginx rejoue une requête sur un autre backend ?
Section intitulée « Que se passe-t-il quand Nginx rejoue une requête sur un autre backend ? »La directive proxy_next_upstream liste les situations dans lesquelles Nginx rejoue la requête sur le serveur suivant du groupe, et c'est elle qui décide si une action peut être faite deux fois. Le défaut est error timeout. On y ajoute volontiers http_502 ou http_503 pour rejouer aussi quand un backend répond par une erreur de passerelle.
location / { proxy_pass http://applicatif; proxy_next_upstream error timeout http_502 http_503; proxy_next_upstream_tries 2; proxy_next_upstream_timeout 5s;}Les deux directives voisines bornent le rejeu : proxy_next_upstream_tries limite le nombre de serveurs essayés au total, et proxy_next_upstream_timeout limite la durée totale. Leur valeur par défaut est 0, c'est-à-dire aucune limite. Sans elles, une requête sur un groupe très dégradé peut parcourir tous les serveurs et attendre longtemps. Dans l'exemple ci-dessus, 2 et 5s bornent le rejeu à deux serveurs essayés et cinq secondes au total.
Le point critique est l'idempotence. Une méthode est idempotente quand la répéter donne le même état final : un GET lit, un second GET ne change rien. Un POST qui crée une commande n'est pas idempotent : le rejouer crée une seconde commande. Par défaut, Nginx ne rejoue pas une requête non idempotente (POST, LOCK, PATCH) dès qu'elle a été envoyée au backend. Une connexion qui échoue avant tout envoi reste rejouable, puisque rien n'est arrivé au backend. Le mot-clé non_idempotent, ajouté à proxy_next_upstream, lève cette protection.
La conséquence se lit des deux côtés. Avec le réglage par défaut, un POST dont le backend tombe en cours de traitement reçoit l'erreur, sans doublon : c'est le prix de la sûreté, et c'est au client de décider de réessayer. Avec non_idempotent, le client a plus de chances d'obtenir une réponse, au risque de la duplication.
Le danger tient à ce que le client et le proxy ne peuvent pas distinguer une réponse perdue d'une action qui n'a pas eu lieu. Si un backend enregistre la commande puis échoue avant de répondre, un rejeu sur l'autre backend l'enregistre une seconde fois. Le client, lui, reçoit une erreur dans les deux cas. La page Lire HTTP avant de configurer un proxy explique pourquoi les méthodes se classent ainsi ; ici, retenez la règle : ne mettez non_idempotent que si l'application gère elle-même les doublons, par exemple avec une clé d'idempotence.
Cette directive a aussi un effet de bord utile à connaître : un rejeu masque la panne au client. Si le premier backend renvoie une erreur et que le second répond, le client ne voit rien, alors que l'échec a bien été compté pour max_fails. Détection et rejeu travaillent donc ensemble : l'un protège la requête en cours, l'autre épargne les suivantes.
Comment mesurer que la détection fonctionne ?
Section intitulée « Comment mesurer que la détection fonctionne ? »On mesure la détection par le trafic que reçoit encore le backend fautif, jamais par l'absence d'erreurs côté client. Il faut distinguer deux choses : les échecs comptés par Nginx pour max_fails, et les erreurs vues par le client. Avec un rejeu actif, le premier backend échoue, le second répond, et le client ne voit aucune erreur alors que l'échec a bien été compté. Le rejeu peut donc masquer les erreurs : Nginx apprend la panne par les requêtes envoyées au backend, pas par les erreurs qui atteignent le client.
Le critère « zéro erreur » ne prouve donc rien. Prenez l'état fautif max_fails=0, qui désactive toute détection : le backend en panne reste dans le groupe et reçoit sa part de requêtes. Si proxy_next_upstream rejoue ses 502 sur le backend sain, le client ne voit pourtant aucune erreur, et la mesure est verte sans détection. C'est une leçon de méthode qui vaut au-delà de Nginx : un critère qui réussit aussi quand la fonction testée est absente ne discrimine rien. Le critère honnête porte sur ce qui diffère entre une détection réglée et une détection absente : après un petit nombre de requêtes, le backend fautif ne reçoit plus de trafic, et il revient quand il est de nouveau sain.
La mesure se fait depuis un client, avec une rafale de requêtes séquentielles qui note qui a répondu. Faites-la une première fois avec les deux backends sains, puis une seconde pendant qu'un des deux est en erreur.
for i in $(seq 1 30); do curl -s --max-time 12 "http://${IP_EDGE}/" || echo "echec"done | sort | uniq -c${IP_EDGE} désigne l'adresse de la machine qui porte Nginx. La commande affiche, pour chaque ligne de réponse distincte, le nombre de fois où elle est apparue ; echec n'apparaît que si curl lui-même échoue (délai dépassé, connexion refusée), alors qu'une page d'erreur de Nginx s'affiche comme n'importe quelle réponse. Dans le banc du lab, chaque backend se désigne dans son corps de réponse (backend=a ou backend=b), ce qui permet de voir la répartition. Découpez ensuite la rafale en deux moitiés, et lisez le bon indicateur. Avec un rejeu actif, backend=b seul dans la seconde moitié ne suffit pas : c'est aussi ce que vous verriez avec max_fails=0, puisque a échoue et b reprend la requête. Il faut compter les requêtes reçues par le backend fautif (le compteur ou le journal de ce backend), ou lire dans le journal d'accès de Nginx la variable $upstream_addr, qui liste les serveurs essayés et affiche deux adresses quand un rejeu a eu lieu. La détection a eu lieu si, dans la seconde moitié, le backend fautif n'est plus essayé du tout.
Lisez aussi $upstream_status avec prudence : renseigné, elle ne prouve pas que l'application a répondu. Quand Nginx abandonne un serveur, il écrit lui-même le statut : 504 sur délai dépassé, 502 par défaut, donc sur une connexion refusée. Un 502 dans le journal peut ainsi venir d'un backend arrêté, sans qu'aucune réponse applicative n'ait existé. Si le client a déjà fermé, la requête se finalise en 499 avant l'écriture du statut.
Si la rafale ne retire jamais le backend en erreur, cherchez d'abord ce qu'il renvoie : un code 5xx qui ne figure pas dans proxy_next_upstream n'est pas compté, et la détection ne se déclenche pas.
Trois grandeurs permettent de justifier vos valeurs. Le temps de détection dépend de max_fails et de la cadence des requêtes. Un raisonnement, non une mesure : avec un tourniquet à deux serveurs de même poids, une requête sur deux tombe sur le serveur fautif, donc max_fails=3 demande de l'ordre de six requêtes. Le chiffre réel varie avec les poids, le rejeu et le trafic simultané. Le temps de retour dépend de fail_timeout : un backend rétabli ne revient qu'à l'échéance. Enfin, la fenêtre de comptage vaut fail_timeout aussi : sur un trafic faible, des échecs espacés de plus de cette durée ne s'additionnent jamais, et le backend n'est jamais retiré.
Les valeurs sont donc un compromis, et il faut pouvoir le dire. Un max_fails bas retire vite, mais un incident bref ou une requête isolée peut écarter un serveur sain. Un fail_timeout long protège les utilisateurs plus longtemps, mais retarde le retour d'un serveur réparé.
Que faire des noms DNS et des fonctions commerciales ?
Section intitulée « Que faire des noms DNS et des fonctions commerciales ? »Un nom de domaine dans une ligne server est résolu au démarrage ou au rechargement de Nginx, pas à chaque requête, et les sondes actives relèvent de NGINX Plus. Ces deux points sont des frontières : les ignorer produit des pannes silencieuses ou des configurations refusées.
Pour la résolution, la règle de base est que l'adresse trouvée au démarrage est mémorisée. Si le backend change d'adresse (conteneur recréé, service derrière un nom géré par un orchestrateur), Nginx continue d'envoyer le trafic à l'ancienne adresse. Deux voies existent. La première est le paramètre resolve de la ligne server, disponible en open source depuis la 1.27.3, qui exige une directive zone, laquelle place le groupe en mémoire partagée entre les workers, et un resolver, qui désigne le serveur DNS à interroger. Ce resolver peut se déclarer dans le bloc upstream lui-même. La seconde voie est un proxy_pass qui porte une variable, résolue à l'exécution et qui demande elle aussi un resolver.
Pour les sondes, la directive health_check interroge les backends à intervalle régulier : elle appartient à NGINX Plus, l'offre commerciale, et n'existe pas dans le build open source. Les sondes actives et l'API de supervision des upstreams de Plus ne sont pas disponibles non plus. Le chemin open source pour observer la santé d'un groupe passe par les journaux, le module stub_status et un exportateur, traités dans la leçon Protéger et observer Nginx. Des modules tiers existent pour ajouter des sondes ; comme ils se compilent avec Nginx et dépendent de sa version, ils ne font pas partie de ce que vous pouvez supposer disponible.
À l'inverse, Traefik sait faire une sonde active, comme le montre la leçon Traefik : entrypoints, routers, services et middlewares. Le livrable est le même, un backend malade qui sort de la rotation, mais avec Nginx open source le retrait se déclenche après de vraies requêtes en échec.
Mettre en pratique : mesurer répartition et détection passive
Section intitulée « Mettre en pratique : mesurer répartition et détection passive »Le lab pose deux backends identifiables derrière Nginx, que vous pilotez en écrivant un mot dans un fichier (ok, erreur ou lent). La répartition fonctionne au départ, avec deux défauts : la détection passive est désactivée, et le rejeu autorise un POST à être compté deux fois. Vous réglez des seuils que vous savez justifier et vous corrigez la politique de rejeu.
La validation mesure quatre choses : les deux backends reçoivent du trafic quand ils sont sains ; un backend en erreur cesse de recevoir du trafic sur la seconde moitié d'une rafale de trente requêtes ; il revient une fois sain ; et un compteur métier prouve qu'une commande envoyée n'est jamais comptée deux fois.
À retenir
Section intitulée « À retenir »- Un bloc
upstreamnomme un groupe de backends ;weight,backupetdownrèglent la part de chacun,least_connouip_hashchangent l'algorithme. - Nginx open source n'a aucune sonde active : la détection est passive et apprend des requêtes réelles des clients.
max_failscompte les échecs etfail_timeoutsert deux fois, comme fenêtre de comptage et comme délai avant de retenter le backend retiré ;max_fails=0désactive la détection, et un groupe d'un seul serveur n'est jamais retiré.proxy_next_upstreamvauterror timeoutpar défaut : les5xxn'y comptent que s'ils sont listés,403et404jamais.- Un
POST,LOCKouPATCHdéjà envoyé n'est pas rejoué par défaut ;non_idempotentpeut doubler une action et ne se pose que si l'application gère les doublons. - On mesure la détection par le trafic que reçoit encore le backend fautif, jamais par l'absence d'erreurs : un rejeu les masque, même avec
max_fails=0. - Les connexions persistantes vers les backends sont actives d'office, 32 par worker, en HTTP/1.1 par défaut :
keepalive Najuste le plafond d'inactives, sans limiter le total. $upstream_statusrenseigné ne prouve pas que l'application a répondu : Nginx écrit lui-même 504 sur délai dépassé et 502 sur connexion refusée.health_checkrelève de NGINX Plus ;resolveest disponible en open source depuis la 1.27.3 et exigezone: on vérifie sur le binaire installé, jamais sur un exemple trouvé en ligne.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de ce guide est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Nginx TLS : servir et renouveler un certificat
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications