Une passerelle devant un service web peut le rendre plus rapide en trois gestes, attendre moins longtemps, réessayer et réutiliser des réponses, et chacun de ces gestes devient dangereux dès qu'il est réglé sans discernement. Cette leçon s'adresse à une personne qui sait publier un service derrière un reverse proxy et veut comprendre ce que ces trois gestes peuvent casser : une commande passée deux fois, les données d'Alice servies à Bob, un appelant bloqué dix minutes sur un backend mort. Elle pose les notions, valables pour n'importe quel outil, puis vous fait corriger une politique fournie.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »La leçon va des durées aux réponses réutilisées, puis à la preuve que rien n'est altéré.
- Distinguer les phases d'une requête qui ont une durée, et celles qu'une borne doit couvrir.
- Choisir une borne de lecture en mesurant la réponse légitime la plus lente, sans prendre une durée ronde.
- Décider du rejeu d'une requête sur sa méthode, et jamais sur ce qu'on observe.
- Expliquer pourquoi un rejeu masque une panne au client et peut doubler une écriture.
- Énoncer les conditions pour qu'une réponse soit mise en cache sans fuite entre utilisateurs.
- Prouver un cache et son isolation par une mesure indépendante de ses propres en-têtes.
Prérequis
Section intitulée « Prérequis »La leçon suppose que vous savez lire un échange HTTP et lancer une requête avec curl.
- Lire une requête, une réponse, leurs en-têtes, les méthodes et les codes de statut : Lire HTTP avant de configurer un proxy.
- Situer la passerelle sur le trajet d'une requête : Publier un service web.
- Savoir modifier un fichier YAML simple. Le lab fournit la machine et les services, vous n'installez rien.
Que traite cette leçon, et que laisse-t-elle aux pages d'outil ?
Section intitulée « Que traite cette leçon, et que laisse-t-elle aux pages d'outil ? »Cette leçon pose les notions communes à tous les proxys ; la syntaxe d'un outil précis vit dans sa propre page. Elle répond à trois questions : quelles phases d'une requête ont une durée, ce qu'un rejeu peut casser sur une écriture, et à quelles conditions une réponse se met en cache sans fuite. Une passerelle est ici le serveur placé devant l'application, celui qui reçoit les appelants et relaie leurs requêtes vers le backend, l'application qui produit réellement la réponse.
Les pages d'outil reprennent ces notions avec leurs directives. Pour Nginx, Nginx cache : prouver qu'aucune réponse privée ne fuite donne proxy_cache, la clé de cache, proxy_no_cache et la compression. Pour HAProxy, Borner temps, files et flux longs avec HAProxy donne les bornes par phase et retry-on. Ici, le lab utilise une passerelle d'enseignement dont la politique tient dans un fichier YAML : le vocabulaire y est volontairement neutre, pour que le raisonnement se transpose.
Quelles phases d'une requête ont une durée, et laquelle faut-il borner ?
Section intitulée « Quelles phases d'une requête ont une durée, et laquelle faut-il borner ? »Une requête qui traverse une passerelle attend à au moins trois endroits, et chacun mérite sa propre borne : l'établissement de la connexion, l'attente de la réponse, et la durée totale vue par l'appelant. Un délai (timeout) est le temps maximal accordé à une phase avant d'abandonner. Sans lui, un élément qui ne répond jamais retient la requête indéfiniment, et la requête retient à son tour une connexion, un processus, un appelant.
La première phase est la connexion : la passerelle ouvre un canal TCP vers le backend. Deux pannes de backend s'y distinguent. Un hôte qui refuse la connexion (application arrêtée, port fermé) se détecte presque immédiatement, puisque l'échec revient tout de suite. Un hôte injoignable, dont les paquets sont perdus sans réponse, est bien plus lent à trancher : la passerelle attend la borne de connexion, qui vaut 60 secondes par défaut dans Nginx (proxy_connect_timeout, qui ne peut pas dépasser 75 secondes en général). Cette borne se règle donc comme les autres.
La seconde phase est la lecture : la connexion est ouverte, la requête est envoyée, et la passerelle attend la réponse. C'est la phase qui s'éternise avec un backend vivant mais bloqué, par exemple sur une base de données saturée. Dans Nginx (proxy_read_timeout) et dans HAProxy (timeout server), ce délai de lecture court entre deux réceptions successives d'octets, pas sur la durée totale de la réponse : un backend qui envoie un octet par seconde ne le déclenche jamais tant que cet intervalle reste sous la borne.
La troisième durée n'est pas dans la passerelle, elle est chez l'appelant : un navigateur, un script curl --max-time, un autre service. L'appelant a sa propre patience, et la règle qui en découle est simple. La borne de la passerelle doit être plus courte que celle de l'appelant, sinon l'appelant abandonne le premier, ne reçoit jamais le message d'erreur propre de la passerelle, et ne sait plus si la requête a abouti.
Comment choisir une borne de lecture qui ne coupe pas ce qui marche ?
Section intitulée « Comment choisir une borne de lecture qui ne coupe pas ce qui marche ? »On choisit une borne de lecture en mesurant la réponse légitime la plus lente du service, puis en ajoutant une marge ; on ne prend pas une durée ronde. Une borne trop longue laisse la panne se propager : chaque appelant attend, les connexions s'accumulent, et un seul backend mort finit par immobiliser toute la passerelle. Une borne trop courte produit l'effet inverse, plus discret : elle rejette des réponses lentes mais correctes, et c'est une panne qu'on s'inflige soi-même.
Les deux moitiés comptent donc ensemble. Dans le lab, l'application expose une route /lent qui répond correctement au bout de deux secondes, et une route /panne qui ne répond jamais. Une borne de lecture acceptable laisse passer la première et coupe la seconde assez tôt pour que l'appelant ne reste pas bloqué indéfiniment. Aucune de ces deux conditions ne suffit seule : une borne d'une seconde coupe /panne mais casse /lent, et une borne de dix minutes sert /lent mais laisse l'appelant pendre sur /panne.
La méthode tient en trois gestes. Mesurez d'abord, sur le service réel, la durée de la réponse légitime la plus lente. Ajoutez ensuite une marge qui absorbe un pic raisonnable, sans la gonfler. Vérifiez enfin les deux côtés, la lenteur légitime qui passe et la panne qui est coupée. Une borne se règle sur une mesure ; la valeur de l'exercice ne se recopie pas sur votre trafic.
Pourquoi décide-t-on du rejeu sur la méthode de la requête ?
Section intitulée « Pourquoi décide-t-on du rejeu sur la méthode de la requête ? »On décide de rejouer une requête d'après sa méthode HTTP, parce que seule la méthode dit si l'exécuter deux fois a le même effet que de l'exécuter une fois. Un rejeu (retry) renvoie la même requête après un échec. Une méthode est idempotente lorsque l'envoyer une fois ou plusieurs fois a le même effet voulu par le client. La RFC 9110 range dans les méthodes idempotentes PUT, DELETE et les méthodes dites sûres, c'est-à-dire en lecture seule : GET, HEAD, OPTIONS et TRACE. POST ne l'est pas, puisque chaque POST /commande peut créer une commande de plus. La RFC parle d'effet voulu, pas d'état du serveur : un serveur reste libre de journaliser chaque requête, et deux GET laissent deux lignes de journal sans que la méthode cesse d'être idempotente.
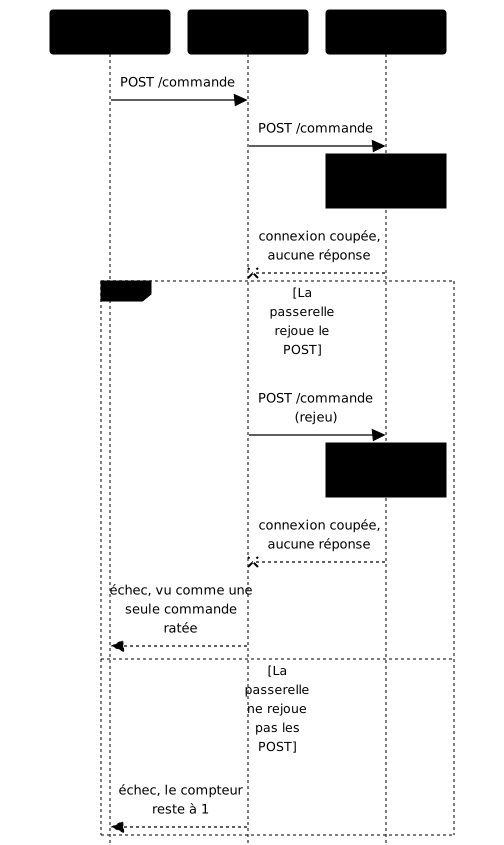
La difficulté vient de ce que le client ne voit pas la même chose que le serveur. Imaginez une application qui incrémente son compteur de commandes, puis perd la connexion avant d'envoyer sa réponse. Pour la passerelle, c'est une connexion coupée sans réponse. Pour l'appelant, c'est la même chose. Mais dans un cas la commande n'a jamais eu lieu, et dans l'autre elle a eu lieu et c'est la réponse qui s'est perdue. Rien ne les distingue de l'extérieur : seul le compteur métier, côté application, connaît la vérité.
Regardez le schéma de haut en bas. L'application compte la commande, puis coupe sans répondre. Si la passerelle rejoue le POST, le compteur passe à deux, et le client ne voit qu'un échec. Si elle ne rejoue pas, le compteur reste à un, et le client voit le même échec. L'observation est identique des deux côtés de la branche, ce qui est précisément la raison de ne pas fonder la décision sur elle.
Qu'est-ce qu'un rejeu masque au client, et que peut-il casser ?
Section intitulée « Qu'est-ce qu'un rejeu masque au client, et que peut-il casser ? »Un rejeu masque la panne au client : l'échec est bien arrivé et compté côté passerelle, mais l'appelant ne voit rien, ce qui est un avantage pour une lecture et un piège pour une écriture. Quand la passerelle rejoue un GET et que le second essai réussit, l'appelant reçoit sa page sans jamais savoir qu'un premier essai a échoué. C'est utile : une panne passagère disparaît du point de vue de l'utilisateur. C'est aussi un risque d'observation, puisque les échecs absorbés doivent être comptés quelque part, faute de quoi un backend défaillant reste invisible tant que le second essai passe.
Pour une écriture, le même masquage change de nature. Si la passerelle rejoue un POST dont la réponse s'est perdue, l'écriture a lieu deux fois, et le client, qui reçoit éventuellement un succès au second essai, croit n'en avoir passé qu'une. Les outils posent la frontière à des endroits comparables. Avec HAProxy, retry-on all-retryable-errors rejoue une écriture dont la réponse s'est perdue, alors que retry-on conn-failure ne rejoue que ce qui n'a pas atteint le serveur ; la leçon Borner temps, files et flux longs avec HAProxy en détaille les directives.
La règle qui en découle est de rejouer ce qui est idempotent, et de ne pas rejouer une écriture dont on ignore l'issue. Un POST dont on ignore s'il a été traité ne se rejoue pas. La RFC 9110 est même plus stricte : « A proxy MUST NOT automatically retry non-idempotent requests », sans exception prévue pour un proxy. HAProxy et Nginx n'y dérogent que dans un cas : une connexion qui échoue avant que la requête ait pu être envoyée est rejouée quelle que soit la méthode, puisque rien n'a eu lieu côté serveur. C'est une pratique de ces deux outils, cohérente avec l'esprit de la RFC (savoir que la requête n'a jamais été appliquée), pas une permission qu'elle accorde : ne la supposez pas d'un autre proxy. Dans le lab, la politique de départ rejoue GET et POST ; la correction consiste à retirer ce qui ne doit pas l'être, sans interdire tout rejeu.
Restreindre les rejeux n'est pas les supprimer. Une passerelle qui ne rejouerait plus rien gagnerait en sûreté en perdant sa tolérance aux pannes passagères : une lecture dont la connexion échoue doit pouvoir réussir au second essai. C'est donc le rejeu sélectif, par méthode, qui tient les deux exigences.
À quelles conditions une réponse peut-elle être mise en cache ?
Section intitulée « À quelles conditions une réponse peut-elle être mise en cache ? »Une réponse peut être mise en cache si elle est identique pour tous ceux qui la demandent, ou si la clé qui la range distingue précisément ce qui la rend différente. Un cache garde la réponse d'une requête pour la rendre à la suivante sans solliciter le backend. Il est utile parce qu'il économise du travail, et dangereux pour la même raison : la réponse rangée pour un utilisateur peut être rendue à un autre.
Deux familles de réponses se distinguent. Une réponse publique est la même pour tout le monde : une page d'accueil, un catalogue, un fichier statique. Elle se met en cache sans réserve. Une réponse privée dépend de celui qui la demande : le contenu d'un compte, une facture, un panier. Le serveur applicatif connaît cette nature, et il la déclare avec l'en-tête Cache-Control. Trois directives comptent ici, et elles ne disent pas la même chose (RFC 9111). private interdit le stockage aux seuls caches partagés, comme celui de la passerelle : le cache du navigateur de l'utilisateur peut, lui, garder la réponse. no-store va plus loin et l'interdit à tous les caches, navigateur compris. max-age, enfin, n'autorise rien : il fixe la durée de fraîcheur d'une réponse déjà stockable, tandis que public autorise explicitement un cache partagé à la stocker. Le principe général, décrit par la RFC 9111, est que le cache applique le contrat de l'origine au lieu de le contredire.
Dans le lab, la politique est plus rudimentaire : elle liste les routes à mettre en cache sous cache.cacher. Le défaut de départ est d'y avoir mis /prive, une route dont la réponse dépend de l'utilisateur. C'est le cas typique d'une optimisation qui donne l'impression de marcher : les réponses arrivent plus vite, le cache a l'air efficace, et personne ne voit que chaque appelant reçoit la première réponse rangée, quelle que soit son identité.
Comment la variation évite-t-elle de servir la mauvaise version ?
Section intitulée « Comment la variation évite-t-elle de servir la mauvaise version ? »La variation indique au cache quels éléments de la requête distinguent deux réponses : tout ce qui change le contenu et qui n'est pas déclaré fait servir la mauvaise version. Une clé de cache est la chaîne qui désigne une entrée rangée : deux requêtes qui produisent la même clé reçoivent la même réponse. Par défaut, elle se limite à l'adresse demandée. Or deux requêtes vers la même adresse peuvent attendre des contenus différents, par exemple une page en français pour l'un et en anglais pour l'autre.
Le mécanisme normalisé s'appelle Vary : le serveur y liste les en-têtes de requête dont dépend sa réponse, par exemple Vary: Accept-Language. Le cache range alors une entrée par valeur de cet en-tête. Dans le lab, la même idée s'écrit sous cache.varier_sur, une liste d'en-têtes qui distinguent deux entrées. Un en-tête absent de cette liste ne distingue rien : sans Accept-Language dans la liste, la première version rangée, par exemple le français, est servie à qui demande l'anglais.
Pour une route privée, deux remèdes existent, et ils n'ont pas le même coût. Le premier est de ne pas la mettre en cache : on la retire de cache.cacher, et l'isolation devient évidente. Le second est de varier sur l'identité, par exemple l'en-tête Authorization : chaque utilisateur obtient sa propre entrée. Pour une réponse privée, nous recommandons le premier, et c'est un choix de prudence, non une règle du protocole : varier sur l'identité suppose de ne jamais oublier l'en-tête, et comme chaque entrée n'a qu'un seul lecteur, le gain du cache ne dépend plus que des fois où un même utilisateur redemande la même page, souvent peu.
Deux pièges méritent d'être nommés. Une clé trop pauvre mélange des réponses, et une clé trop riche disperse le cache : varier sur la valeur brute de Accept-Language crée une entrée par formulation, alors que le contenu ne change pas. Et supprimer le cache partout satisfait l'isolation tout en échouant à la promesse de vitesse : la page publique doit rester servie depuis le cache.
Comment prouver qu'un cache fonctionne sans croire ses en-têtes ?
Section intitulée « Comment prouver qu'un cache fonctionne sans croire ses en-têtes ? »On prouve un cache par ce que le backend produit, jamais par ce que la passerelle déclare. Un HIT est une réponse servie depuis le cache, un MISS une requête qui part vers le backend. Beaucoup de passerelles ajoutent un en-tête de diagnostic qui affiche HIT ou MISS, mais ce n'est qu'une déclaration du proxy que l'on cherche justement à vérifier : un en-tête écrit à la main afficherait HIT partout, y compris sur une réponse qui vient de traverser le backend.
La mesure fiable repose sur une réponse qui change à chaque passage. Dans le lab, /public porte un numéro tiré au hasard à chaque requête qui atteint l'application. Deux requêtes identiques qui reçoivent le même numéro prouvent qu'il y a eu un cache, puisque le backend n'a produit le numéro qu'une fois. Deux numéros différents prouvent qu'il n'y en a pas. Aucun en-tête n'est cru sur parole.
La même logique prouve la variation et l'isolation. Pour la langue, une requête en anglais ne doit pas recevoir la réponse française rangée. Pour l'identité, Alice et Bob présentent chacun un jeton dans l'en-tête Authorization, et la réponse privée de chacun porte son nom : Bob ne doit jamais voir celle d'Alice, ni l'inverse. Ce qui rend ces constats probants, c'est qu'ils lisent le corps de la réponse, c'est-à-dire ce que l'utilisateur recevrait réellement.
La preuve complète associe toujours une contre-épreuve. Isolation seule : ne rien mettre en cache la satisfait. Réutilisation seule : tout mettre en cache la satisfait. Le travail se trouve dans leur rencontre, une page publique réellement servie depuis le cache et une page privée qui ne quitte jamais son propriétaire. Pour la mise en œuvre côté Nginx, avec la mesure d'un HIT par un compteur d'origine, lisez Nginx cache : prouver qu'aucune réponse privée ne fuite.
Quels défauts chercher dans une politique rapide, et comment chacun se mesure-t-il ?
Section intitulée « Quels défauts chercher dans une politique rapide, et comment chacun se mesure-t-il ? »Une politique rapide et dangereuse se reconnaît à quatre défauts, et chacun se mesure par un effet que le client ne voit pas à l'œil nu. Le tableau croise le défaut, son symptôme caché et la mesure qui le démontre. Il se lit de gauche à droite : on part de ce qui est écrit dans la politique, on passe à ce qui se passe réellement, puis on regarde comment l'établir.
| Défaut dans la politique | Ce qui se passe réellement | Comment le démontrer |
|---|---|---|
| Une route privée est mise en cache | Un utilisateur reçoit la réponse d'un autre | Deux comptes demandent la même route, chacun doit lire son propre nom |
| Le cache ne varie sur rien | Une langue est servie à qui en demande une autre | Une requête en français puis en anglais doit rendre deux corps différents |
Le POST est rejoué | Une commande est comptée deux fois | Un seul POST : le compteur métier doit monter d'une seule unité |
| Aucune borne de lecture réaliste | Un backend mort retient l'appelant | /lent répond, et /panne est coupée avant l'abandon de l'appelant |
Deux de ces mesures sont critiques parce qu'elles portent sur une faute irréparable : la fuite de données privées entre utilisateurs et la commande doublée. Les deux autres, la variation de langue et la borne, dégradent le service sans exposer personne. Ce classement guide l'ordre de correction : corrigez d'abord ce qui ne se rattrape pas.
Le troisième défaut est celui qui ne se devine pas. Le client observe exactement la même chose, un échec, que la commande soit comptée une fois ou deux. Seule la lecture du compteur de l'application, avant puis après une seule tentative, le révèle. C'est pour cela que la décision de rejouer se prend sur la méthode, et que la vérification se fait sur l'état du système, pas sur la réponse reçue.
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab vous donne une politique de cache et de délais fournie, qui accélère bien les réponses et porte les quatre défauts du tableau ci-dessus. Vous la corrigez dans son fichier YAML, sans toucher à l'application : le cache doit continuer d'accélérer ce qui peut l'être, sans jamais servir la donnée d'un utilisateur à un autre, sans doubler une commande, et sans laisser un appelant attendre indéfiniment.
La validation ne lit aucun en-tête de diagnostic. Elle vérifie que deux requêtes identiques sur /public reçoivent le même corps et qu'une autre langue reçoit un corps différent, qu'Alice et Bob ne partagent jamais une réponse privée, qu'une commande envoyée une fois est comptée une fois dans le compteur métier, et que /lent répond alors que /panne est coupée avant vingt secondes.
À retenir
Section intitulée « À retenir »- Une requête attend à plusieurs endroits : connexion, lecture et patience de l'appelant. La borne de la passerelle doit rester plus courte que celle de l'appelant.
- Une borne de lecture se choisit en mesurant la réponse légitime la plus lente : trop longue, elle propage la panne ; trop courte, elle en crée une.
- Une méthode idempotente (
GET,HEAD,OPTIONS,TRACE,PUT,DELETE) peut être rejouée ; unPOSTdont la réponse s'est perdue ne doit pas l'être, car l'appelant ne distingue pas une réponse perdue d'une action qui n'a pas eu lieu. - Un rejeu masque la panne au client. L'échec doit être compté côté passerelle, sans quoi un backend défaillant reste invisible.
- Le rejeu sélectif tient les deux exigences : rejouer ce qui est idempotent, ne pas rejouer une écriture dont l'issue est inconnue. Rejouer une requête qui n'a pas pu être envoyée est une pratique de HAProxy et de Nginx, alors que la RFC 9110 interdit à un proxy de réessayer une requête non idempotente.
- Une réponse privée ne se met pas en cache sous une clé qui ne distingue pas l'utilisateur. Le plus simple est de ne pas la mettre en cache ; l'origine le déclare par
Cache-Control:privatel'interdit aux caches partagés,no-storeà tous les caches, etmax-agen'autorise rien. - La variation (
Vary, oucache.varier_surdans le lab) déclare ce qui distingue deux entrées. Un en-tête non déclaré ne distingue rien. - Un cache se prouve par ce que le backend produit, avec une réponse qui change à chaque passage, et jamais par un en-tête de diagnostic. La preuve d'isolation s'accompagne de sa contre-épreuve : la page publique reste servie depuis le cache.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Ces questions vérifient que vous savez décider d'un délai, d'un rejeu et d'une mise en cache, et choisir la mesure qui le prouve.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Reconnaître les besoins des flux longs et des protocoles applicatifs
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications