Un répartiteur de charge envoie chaque requête à l'un de plusieurs backends, et c'est sa sonde de santé, pas le nombre d'instances, qui décide si la perte de l'une d'elles passe inaperçue. Cette leçon s'adresse à une personne qui sait publier un service derrière un reverse proxy et qui veut comprendre ce que « deux instances » promet vraiment. Elle pose les notions communes à tous les outils : ce qu'un algorithme de répartition change, ce qu'une sonde prouve, comment calculer puis mesurer le retrait d'un backend malade, et pourquoi le répartiteur reste un point de panne. Le lab vous fait corriger un répartiteur qui rate chacun de ces points.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »La leçon suit le fil d'une panne : répartir, sonder, calculer, mesurer, puis chercher ce qui reste fragile.
- Expliquer ce qu'un algorithme de répartition et des poids changent, et ce qu'ils ne garantissent pas.
- Distinguer un processus vivant, un backend prêt et un service utilisable.
- Opposer la sonde active et la détection passive, avec les limites de chacune.
- Calculer le délai de retrait et le délai de retour à partir de l'intervalle et des seuils.
- Mesurer un retrait par le trafic reçu par le backend fautif, pas par l'absence d'erreurs.
- Identifier le point de panne unique d'une topologie à deux backends.
Prérequis
Section intitulée « Prérequis »La leçon suppose que vous savez lire un échange HTTP et situer un proxy sur le trajet d'une requête.
- Le trajet d'une requête du client jusqu'au backend : Publier un service web.
- Les méthodes et les codes de statut, en particulier
200et503: Lire HTTP avant de configurer un proxy. - Ce qu'un rejeu masque au client : Maîtriser délais, tentatives et cache sans altérer les réponses.
- Aucune installation : le lab fournit la machine, les deux backends et le répartiteur.
Que traite cette leçon, et que laisse-t-elle aux pages d'outil ?
Section intitulée « Que traite cette leçon, et que laisse-t-elle aux pages d'outil ? »Cette leçon pose les notions de répartition et de santé indépendamment de l'outil ; la syntaxe de chaque proxy vit dans sa propre page. Un backend est l'instance de l'application qui produit réellement la réponse. Un répartiteur (on dit aussi load balancer) est le composant placé devant eux, qui reçoit les clients et choisit, pour chaque requête, le backend qui la traitera. Un backend « dans la rotation » est un backend à qui le répartiteur envoie du trafic.
Les pages d'outil reprennent ces notions avec leurs directives. Pour HAProxy, Choisir la répartition et mesurer les sondes donne balance, check, inter, fall, rise et le drainage d'un serveur. Pour Nginx, Nginx upstream : répartir la charge et retirer les pannes donne upstream, max_fails et fail_timeout. La perte d'un nœud d'entrée, c'est-à-dire de la machine qui porte le répartiteur lui-même, est un autre sujet, traité dans Tester la disponibilité du point d'entrée HAProxy. Ici, le lab utilise un répartiteur d'enseignement dont la politique tient dans un fichier YAML : le vocabulaire est neutre pour que le raisonnement se transpose.
Que change réellement un algorithme de répartition ?
Section intitulée « Que change réellement un algorithme de répartition ? »Un algorithme de répartition décide seulement quel backend reçoit la requête suivante parmi ceux que le répartiteur tient pour sains ; il ne dit rien de leur état de santé. Le plus simple est le tourniquet (round robin) : chaque backend reçoit une requête à son tour. Le moins de connexions (least connections) envoie la requête vers le backend qui en traite le moins au moment du choix, ce qui convient quand les durées de traitement sont très inégales. Le hasard tire un backend au sort. Le hachage associe un client à un backend, ce qui donne une affinité : le même client retombe sur la même instance.
Les poids déclarent la capacité relative des backends. Un backend de poids 3 face à un backend de poids 1 reçoit trois requêtes sur quatre quand les deux sont sains. L'affinité sert quand l'instance garde en mémoire locale l'état d'une session, mais elle a un prix : si ce backend est retiré, ses clients vont ailleurs et perdent ce que cette mémoire contenait.
Un point surprend les débutants : une alternance parfaite ne se mesure presque jamais. Dès que plusieurs clients envoient des requêtes en même temps, que les poids diffèrent ou que l'algorithme tire au hasard, la séquence observée ne ressemble plus à « a, b, a, b ». Un échantillon de huit requêtes sur un tirage au hasard à deux backends manque l'un des deux une fois sur cent vingt-huit environ (deux fois la probabilité de huit tirages identiques, soit 2 sur 256 : un calcul, pas une mesure). La bonne question n'est donc pas « l'ordre est-il régulier ? » mais « les deux backends reçoivent-ils du trafic ? ». C'est exactement ce que le lab vérifie, sans imposer d'alternance exacte.
Le répartiteur du lab démarre avec une politique qui désactive la répartition : tant que les deux backends répondent, il envoie tout au premier de la liste et ne touche jamais au second. Seul un échantillon de trafic le révèle. Une instance qui ne sert jamais n'est ni une capacité de plus, ni une assurance : c'est un backend inconnu, dont personne ne sait s'il fonctionne.
Un backend vivant est-il pour autant utilisable ?
Section intitulée « Un backend vivant est-il pour autant utilisable ? »Non : un backend peut être vivant, c'est-à-dire avoir un processus qui tourne et un port ouvert, tout en étant incapable de servir une requête utile. Il faut distinguer trois niveaux. Le processus vivant (liveness) répond à la question « tourne-t-il ? ». Le backend prêt (readiness) répond à « peut-il servir maintenant ? », ce qui suppose que ses dépendances, une base de données par exemple, répondent aussi. Le service utilisable est ce que vit le client : une requête réelle qui aboutit.
Une panne applicative illustre l'écart. Le processus tourne, le port accepte les connexions, mais l'application a perdu l'accès à sa base de données. Un contrôle qui se contente d'ouvrir une connexion TCP voit un backend en bonne santé, alors que chaque requête utile échoue. Kubernetes oppose les mêmes notions : voir Probes Kubernetes : liveness, readiness, startup sans faux positifs.
Dans le lab, chaque backend expose une route de santé, /sante. Poser un fichier de drapeau sur un backend simule la panne applicative : cette route répond alors 503 au lieu de 200. Notez un détail instructif du banc : le backend marqué malade continue de répondre normalement sur sa route de service. La panne simulée n'est visible que de la route de santé, ce qui est le cas le plus insidieux, celui qu'une bonne sonde doit couvrir.
Que prouve une sonde, et que ne prouve-t-elle pas ?
Section intitulée « Que prouve une sonde, et que ne prouve-t-elle pas ? »Une sonde prouve qu'une route précise a répondu comme attendu à un instant donné ; elle ne prouve jamais que les requêtes des clients réussiront. Une sonde est une requête que le répartiteur émet de lui-même, à intervalle régulier, vers une route dédiée de chaque backend, pour décider s'il le garde dans la rotation. On l'appelle sonde active, par opposition à la détection passive, où le répartiteur n'émet rien et déduit la santé d'un backend des vraies requêtes des clients qu'il lui a envoyées.
Le tableau ci-dessous compare les deux modèles. Lisez-le colonne par colonne : chacune a un angle mort que l'autre comble.
| Question | Sonde active | Détection passive |
|---|---|---|
| Qui apprend la panne ? | Le répartiteur, par ses propres requêtes | Le répartiteur, par le résultat des requêtes clientes |
| Sans aucun trafic ? | La panne est vue | Rien n'est vu : aucune requête, aucune information |
| Coût | Des requêtes supplémentaires, en permanence | Des échecs subis par de vrais utilisateurs |
| Angle mort | Ne teste que la route de santé | Ne détecte que ce que le trafic réel exerce |
Aucune des deux n'est meilleure dans l'absolu, et les pages d'outil le montrent : HAProxy sonde activement, alors que Nginx open source ne fait que de la détection passive. Une sonde active a deux limites à connaître. La première : sa route de santé peut mentir par omission, en répondant 200 alors que la base est tombée, parce que personne n'y a mis le test. La seconde est l'inverse : une route de santé qui interroge une dépendance partagée par tous les backends les retire tous en même temps le jour où cette dépendance ralentit, et le service entier tombe pour une panne que chaque backend aurait pu encaisser. Une bonne route de santé vérifie ce dont le backend a besoin pour servir, pas plus.
Comment mesurer le retrait d'un backend sans se fier aux erreurs ?
Section intitulée « Comment mesurer le retrait d'un backend sans se fier aux erreurs ? »On mesure le retrait d'un backend par le trafic qu'il reçoit encore, jamais par l'absence d'erreurs côté client. Il faut séparer deux choses : les échecs comptés par le répartiteur, qui nourrissent sa décision de retirer un backend, et les erreurs vues par le client. Un rejeu (renvoyer la requête échouée vers un autre backend) peut masquer l'échec au client alors que le répartiteur l'a bien compté. La détection apprend des requêtes envoyées au backend, pas des erreurs qui atteignent le client.
Le critère « le client ne voit plus d'erreur » est donc trompeur. Imaginez un backend en panne que le répartiteur n'a jamais retiré : si chaque requête qui tombe sur lui est rejouée sur l'autre, le client ne voit aucune erreur, et la mesure est verte sans détection. Un critère qui réussit aussi quand la fonction testée est absente ne discrimine rien. Le critère honnête porte sur ce qui diffère entre une détection réglée et une détection absente : après un délai, le backend fautif ne reçoit plus de trafic, et il en reçoit de nouveau une fois rétabli.
La méthode tient en trois gestes. Identifiez chaque backend dans sa réponse, par exemple par un champ « backend a » ou « backend b ». Envoyez un petit échantillon fini de requêtes à travers le répartiteur et notez quelles identités répondent. Attendez la fenêtre prévue et recommencez, jusqu'à ce que l'identité du backend fautif disparaisse de l'échantillon. Le test du lab ne regarde que ces identités : il rejoue un petit échantillon toutes les secondes, et exige que le backend malade ait disparu et que le sain soit toujours là.
Cette seconde condition compte autant que la première. Un répartiteur qui rendrait 503 à tout le monde « retirerait » lui aussi le backend fautif de l'échantillon, mais ne servirait plus personne. Le retrait honnête se lit donc des deux côtés : le fautif disparaît, le sain continue de recevoir.
Comment régler l'intervalle et les seuils d'une sonde ?
Section intitulée « Comment régler l'intervalle et les seuils d'une sonde ? »Le délai de retrait d'un backend vaut à peu près l'intervalle de sonde multiplié par le seuil d'échecs, et le délai de retour vaut l'intervalle multiplié par le seuil de succès. L'intervalle est le temps entre deux sondes. Le seuil d'échecs est le nombre d'échecs consécutifs qui retire un backend de la rotation ; le seuil de succès est le nombre de succès consécutifs qui l'y remet. Le mot consécutifs est décisif : un seul succès au milieu remet le compteur d'échecs à zéro.
Le schéma ci-dessous montre les deux états d'un backend et les deux compteurs qui les relient. Suivez la flèche épaisse du haut : N échecs de suite retirent le backend. Suivez celle du bas : M succès de suite le ramènent. Les flèches pointillées rappellent la remise à zéro.
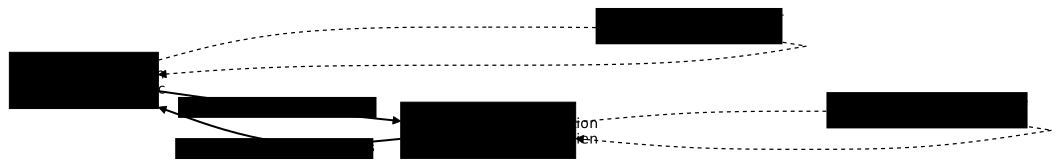
Faites le calcul sur la configuration de départ du lab, qui sonde toutes les 20 secondes et exige 20 échecs : un backend malade reste dans la rotation pendant de l'ordre de 400 secondes, soit près de sept minutes, et le seuil de retour étant le même, un backend rétabli en attend autant. Si le répartiteur alterne, une requête sur deux tombe pendant ce temps sur un backend qui ne sert à rien. Le test du lab accorde 12 secondes pour le retrait, puis 12 autres pour le retour, et échantillonne chaque seconde : le produit de l'intervalle par le seuil doit donc tenir nettement sous cette fenêtre, marge d'échantillonnage comprise. Le raisonnement vaut au-delà du lab : on choisit un délai que l'on peut défendre, puis on en déduit l'intervalle et le seuil.
Pourquoi ne pas tout mettre à 1 pour réagir au plus vite ? Parce que chaque hoquet devient alors une bascule. Un redémarrage, une pause de quelques secondes ou une micro-coupure réseau échoue une seule sonde ; avec un seuil de 1, le backend sort de la rotation, tout le trafic se reporte sur l'autre, et ce report peut faire tomber le second à son tour. Le seuil d'échecs protège donc contre l'instabilité. Le seuil de retour protège de la même façon dans l'autre sens : avec un seuil de succès de 1, une seule sonde capricieuse ramène dans la rotation un backend qui n'est pas guéri. Un seuil plus haut que 1 est un compromis : plus de patience contre moins d'oscillations.
Une sonde a enfin son propre délai d'attente. Un backend qui répond au bout de plusieurs secondes est compté comme en échec quand la sonde abandonne avant sa réponse, et cet échec compte comme un autre dans le seuil. Un intervalle court détecte vite, mais multiplie les sondes, et une sonde qui interroge la base peut charger un service déjà fragile.
Que devient le service quand un backend est retiré ?
Section intitulée « Que devient le service quand un backend est retiré ? »Quand un backend est retiré, le backend restant porte tout le trafic, et la question à poser avant la panne est de savoir s'il le supporte. Deux backends de même taille donnent, une fois l'un retiré, un seul serveur face à la charge qui était répartie sur deux. Si chacun tournait déjà à 70 % de sa capacité, le survivant doit absorber 140 % : il sature, répond lentement, et la sonde, qui l'interroge aussi, finit par le retirer à son tour. C'est la capacité restante, et elle se calcule à froid, avant l'incident.
Quand plus aucun backend n'est sain, le répartiteur n'a plus personne à qui envoyer les requêtes. Celui du lab rend alors un 503 accompagné d'un message « aucun backend sain ». C'est la réponse honnête : une erreur claire vaut mieux qu'une connexion suspendue.
Retirer brutalement n'est pas la seule façon de sortir un serveur. Pour une maintenance planifiée, on draine le serveur : on cesse de lui affecter de nouvelles requêtes tout en laissant finir celles en cours. Le lab ne le fait pas pratiquer ; la page Choisir la répartition et mesurer les sondes le détaille pour HAProxy.
Deux backends suffisent-ils à rendre le service disponible ?
Section intitulée « Deux backends suffisent-ils à rendre le service disponible ? »Non : tant que le répartiteur est unique, deux backends ne rendent pas le point d'entrée disponible, parce que le répartiteur est lui-même un point de panne unique. Un point de panne unique (single point of failure) est un composant dont la perte arrête tout le service, quel que soit le nombre d'exemplaires des autres. Ajouter des backends protège de la perte d'un backend ; cela ne protège pas de la perte de ce qui les précède.
Le lab le démontre honnêtement. Il arrête le répartiteur, puis interroge les deux backends directement : chacun répond toujours. Pourtant, du point de vue d'un client, qui n'a que l'adresse du répartiteur, rien ne répond. Les backends sont vivants, prêts, sains, et inatteignables par le chemin que le client emprunte. La phrase « il a deux instances » décrit une capacité à survivre à une panne d'instance, pas une disponibilité du service.
Cette limite ne se corrige pas en réglant mieux la sonde : elle demande de dupliquer le point d'entrée lui-même, ce que traite Tester la disponibilité du point d'entrée HAProxy pour HAProxy. Retenez ici le réflexe qui la dévoile : pour chaque topologie, demandez « si je retire ce composant, qui répond encore au client ? », et recommencez pour chaque composant du chemin.
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab vous donne deux backends identiques derrière un répartiteur fourni et opaque, avec des sondes et des seuils paramétrables dans un fichier de politique relu à chaque sonde, sans redémarrage. La configuration livrée porte trois erreurs à la fois. Vous les corrigez en vous aidant du sondeur fourni, qui émet de vraies requêtes HTTP et note les identités qui répondent. La validation mesure quatre choses : les deux backends sains reçoivent tous deux du trafic, un backend marqué malade sort de la rotation dans une fenêtre raisonnable tout en laissant le sain servir, il y revient dans une fenêtre raisonnable une fois rétabli, et l'arrêt du répartiteur rend les deux backends injoignables par le chemin du client alors qu'ils répondent encore directement.
À retenir
Section intitulée « À retenir »- Un algorithme de répartition choisit un backend parmi ceux tenus pour sains : il ne juge pas leur santé, et l'alternance observée n'est jamais parfaite.
- Le bon critère de répartition est que chaque backend sain reçoit du trafic, pas que l'ordre soit régulier.
- Un processus vivant n'est pas un backend prêt, et un backend prêt n'est pas un service utilisable ; la route de santé doit vérifier ce dont le backend a besoin pour servir.
- Une sonde active interroge une route dédiée et voit une panne sans trafic ; la détection passive apprend des requêtes réelles des clients et ne voit rien sans elles.
- Le délai de retrait vaut à peu près l'intervalle multiplié par le seuil d'échecs, le délai de retour l'intervalle multiplié par le seuil de succès, tous deux comptés sur des sondes consécutives.
- Des seuils à 1 transforment chaque hoquet en bascule ; des seuils trop hauts laissent un backend malade servir pendant des minutes.
- On mesure un retrait par le trafic que reçoit encore le backend fautif, jamais par l'absence d'erreurs : un rejeu masque les erreurs au client alors que l'échec est compté.
- Le répartiteur unique reste un point de panne : deux backends ne rendent pas le point d'entrée disponible.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que vous savez raisonner sur la santé d'un service derrière un répartiteur, sans vous appuyer sur un outil précis.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Observer le service rendu et préparer les alertes
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications