Avant de placer un reverse proxy devant une application, il faut savoir lire ce que ce proxy (un serveur intermédiaire qui reçoit les requêtes à la place de l'application et les lui transmet) va relayer : une méthode, une autorité, des en-têtes, un corps, un code de réponse, et prévoir ce que devient une requête rejouée ou redirigée. Cette leçon fait suite à Ce qu'est un service web et ce que signifie le publier et prépare le socle « Noms et exposition ». Elle ne reprend pas toute la mécanique HTTP, déjà détaillée dans HTTP et HTTPS : elle se concentre sur ce qui, dans une requête, décide du comportement d'un proxy ou d'un client qui réessaie, deux pièges que vous retrouverez à chaque reverse proxy que vous configurerez.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Lire méthode, autorité, chemin, en-têtes, corps et code de réponse dans un échange HTTP
- Prédire l'effet d'une redirection ou d'une nouvelle tentative sur une requête, selon qu'elle est idempotente (rejouable sans changer l'état du service) ou non
- Expliquer pourquoi un code HTTP seul ne désigne jamais le composant qui l'a réellement émis
- Écrire les gestes d'un client prudent : lire le code HTTP et le code de
sortie de
curl, et rejouer une écriture avec une clé d'idempotence
Prérequis
Section intitulée « Prérequis »Cette leçon suppose la précédente,
Ce qu'est un service web et ce que signifie le publier.
Pour la mécanique complète du protocole (toutes les méthodes, le détail
du handshake TLS, la lecture avec curl -v), reportez-vous à
HTTP et HTTPS : cette leçon-ci en
suppose les bases et n'en reprend que ce qui conditionne directement le
comportement d'un futur reverse proxy.
Que contient une requête, et que faut-il y lire en premier ?
Section intitulée « Que contient une requête, et que faut-il y lire en premier ? »Une requête HTTP se résume à cinq informations qui suffisent à prédire ce
qu'un serveur ou un proxy va en faire : la méthode, l'autorité visée, le
chemin, les en-têtes et le corps. La méthode (GET, POST, PUT…) dit
l'intention ; le chemin désigne la ressource ; les en-têtes portent
des métadonnées (format attendu, longueur du corps, informations de
session) ; le corps, facultatif, porte la donnée envoyée, par exemple le
JSON d'un formulaire.
L'autorité mérite une attention particulière : en HTTP/1.1, c'est
l'en-tête Host (Host: app.exemple.fr) ; en HTTP/2 et HTTP/3, c'est le
pseudo-en-tête :authority, qui porte la même information sous un autre nom.
Dans les deux cas, l'autorité dit à quel nom de service la requête
s'adresse, ce qui devient décisif dès qu'un seul point d'entrée reçoit
plusieurs noms : c'est elle, et non l'adresse IP de destination, qui
permet de choisir la bonne application. La leçon
Publier un service web montre
comment un proxy s'en sert pour router, aux côtés d'une autre décision prise
plus tôt dans la connexion, le SNI (le nom de serveur que le client annonce
au moment de la négociation TLS, avant d'envoyer la moindre requête HTTP).
Comment lire un échange complet, en-tête par en-tête ?
Section intitulée « Comment lire un échange complet, en-tête par en-tête ? »Un échange HTTP se lit comme un formulaire : chaque ligne de la requête
pose une question, chaque ligne de la réponse y répond, et curl -v affiche
les deux côte à côte. Voici la création d'une commande sur l'API du lab (la
petite API de démonstration que fournit le lab de cette leçon). Les lignes >
sont envoyées par le client, les lignes < reçues du serveur ; les lignes de
connexion (préfixées *) sont retirées pour la lisibilité. Port, date,
versions et durées sont les valeurs de ma capture du 2026-10-25 : mon essai
tourne sur le port 18412, adaptez l'URL à celle de votre API et attendez-vous à
d'autres valeurs. La première ligne est un avertissement de curl : -d
suffit à choisir POST, le -X est superflu ici, tant qu'aucune redirection
n'entre en jeu (la section sur les redirections explique pourquoi on le garde).
curl -sS -v -X POST \ -H 'Content-Type: application/json' \ -H 'Idempotency-Key: cmd-A-100' \ -d '{"ref":"A-100"}' http://127.0.0.1:18412/commandes 2>&1 | grep -v '^\*'Note: Unnecessary use of -X or --request, POST is already inferred.> POST /commandes HTTP/1.1> Host: 127.0.0.1:18412> User-Agent: curl/8.18.0> Accept: */*> Content-Type: application/json> Idempotency-Key: cmd-A-100> Content-Length: 15>} [15 bytes data]< HTTP/1.1 201 Created< Server: BaseHTTP/0.6 Python/3.12.13< Date: Sun, 25 Oct 2026 21:10:01 GMT< Content-Type: application/json< Content-Length: 35<{ [35 bytes data]{"ref": "A-100", "statut": "creee"}Lisez la requête ligne par ligne, en vous demandant à chaque fois ce que cette ligne décide :
| Ligne | Ce qu'elle décide |
|---|---|
POST /commandes HTTP/1.1 | La méthode (créer) et le chemin (la collection de commandes) ; HTTP/1.1 est la version du protocole |
Host: 127.0.0.1:18412 | L'autorité : à quel nom de service la requête s'adresse, donc quelle application un proxy choisira (ici une IP et un port, puisqu'on interroge par adresse ; avec un nom DNS, on lirait app.exemple.fr) |
User-Agent, Accept | Qui parle et quel format le client accepte ; informatifs, mais précieux dans les journaux |
Content-Type: application/json | Comment le serveur doit interpréter le corps ; sans lui, un {"ref":"A-100"} peut être lu comme du texte brut |
Idempotency-Key: cmd-A-100 | Une clé choisie par le client : dans l'API du lab, si la même clé revient, le serveur répond sans refaire l'action (convention d'API, pas règle de HTTP : voir plus bas) |
Content-Length: 15 | La taille du corps en octets : les 15 caractères de {"ref":"A-100"}, ni plus ni moins |
Côté réponse, la ligne de statut 201 Created dit que la ressource a été
créée (un simple 200 aurait dit « traité »). Server dit qui a répondu,
c'est l'indice utilisé plus bas pour attribuer une réponse à son émetteur.
Content-Type et Content-Length: 35 décrivent le corps JSON qui suit, et la
dernière ligne est ce corps. Une vérification confirme l'état côté serveur :
curl -sS -i http://127.0.0.1:18412/commandes/A-100HTTP/1.1 200 OKServer: BaseHTTP/0.6 Python/3.12.13Date: Sun, 25 Oct 2026 21:10:01 GMTContent-Type: application/jsonContent-Length: 16
{"ref": "A-100"}La commande existe : le 201 de tout à l'heure n'était pas une promesse en
l'air. Gardez ce réflexe, vérifier par une seconde requête ce qu'une
première a affirmé : il sert dans la dernière section de cette leçon.
Comment une méthode décide-t-elle si on peut la rejouer sans risque ?
Section intitulée « Comment une méthode décide-t-elle si on peut la rejouer sans risque ? »Une méthode est idempotente quand la rejouer plusieurs fois produit le même
effet que la rejouer une seule fois ; GET et HEAD le sont toujours,
POST ne l'est jamais par défaut. Cette distinction, détaillée avec sa
table complète dans HTTP et HTTPS,
a une conséquence directe une fois un service publié : les clients, et
parfois les proxys eux-mêmes, réessaient automatiquement une requête dont
la réponse s'est perdue (coupure réseau, délai dépassé). Réessayer un GET
ne change pas l'état du service : le second appel laisse la ressource
telle que le premier l'a trouvée. Cela ne veut pas dire qu'il est gratuit :
il consomme du temps de calcul, une place dans la file du serveur, et il
laisse sa trace dans les journaux comme dans les compteurs. Réessayer un
POST dont le serveur a bien reçu et traité la demande, mais dont la réponse
ne vous est jamais revenue, rejoue l'action métier qu'il décrit.
C'est le premier des deux pièges annoncés en introduction, à comprendre avant
de publier un service : rejouer un POST peut doubler une action métier,
un paiement facturé deux fois, un message envoyé deux fois, un
enregistrement créé en double. Un service exploitable traite ce risque soit
en rendant l'opération réellement idempotente côté serveur (une clé
d'idempotence fournie par le client), soit en acceptant que la couche réseau ne doit jamais rejouer
silencieusement un POST à sa place.
Une redirection change-t-elle la méthode d'une requête ?
Section intitulée « Une redirection change-t-elle la méthode d'une requête ? »Cela dépend du code : 301 et 302 peuvent transformer un POST en
GET, 307 et 308 garantissent que la méthode est conservée. Le tableau
complet des cinq codes de redirection (et leur différence avec 304) est
dans HTTP et HTTPS, à la section
« Famille 3xx : Redirections ».
Ce qui compte ici, c'est l'usage que vous en ferez une fois le proxy en
place : un reverse proxy redirige très souvent du port 80 vers le port
443 en 301, ce qui ne pose aucun problème pour un GET de navigateur, mais
casse silencieusement un client qui envoyait un POST en HTTP nu et ne
suit pas la redirection en conservant sa méthode. Pour une API, préférer
307 ou 308 dès que la redirection ne doit rien changer au comportement du
client appelant.
Le voir plutôt que le croire
Section intitulée « Le voir plutôt que le croire »L'API du lab accepte un chemin /redir/<code>/<cible> qui renvoie le code
de votre choix. Envoyez le même POST deux fois, en changeant seulement le
code, et demandez à curl de suivre la redirection avec -L :
# le serveur répond, puis curl suit la redirection (adaptez le port à votre API)curl -sS -L -X POST -d '{"ref":"A-1"}' http://127.0.0.1:18412/redir/302/commandescurl -sS -L -X POST -d '{"ref":"B-1"}' http://127.0.0.1:18412/redir/307/commandesLa réponse de redirection est courte, et c'est son en-tête Location qui
porte la cible :
HTTP/1.1 302 FoundServer: BaseHTTP/0.6 Python/3.12.13Location: /commandesContent-Length: 0Mais la redirection ne dit pas ce que le client renverra. Pour le savoir, il faut regarder du côté du serveur : l'API journalise chaque requête reçue, méthode, chemin et corps. Voici ce qu'elle a enregistré pour ces deux appels :
POST /redir/302/commandes corps='{"ref":"A-1"}'POST /commandes corps=''POST /redir/307/commandes corps='{"ref":"B-1"}'POST /commandes corps='{"ref":"B-1"}'Le schéma suit le trajet des deux requêtes : le client reçoit la même redirection, mais ce qu'il renvoie ensuite diffère.
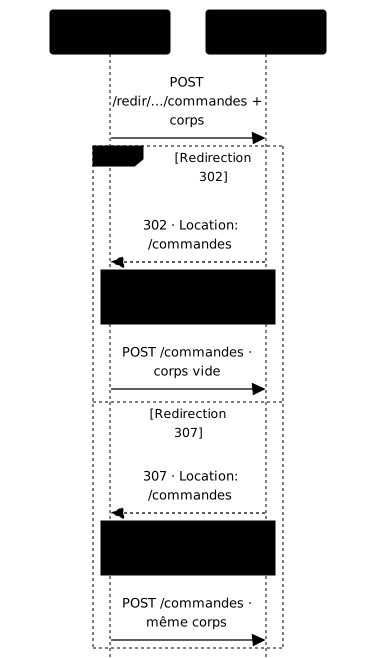
Lisez la deuxième ligne de chaque paire, c'est là que tout se joue. Après
le 302, le serveur reçoit bien un POST sur la cible (c'est -X POST qui
force curl à garder la méthode, voir la note ci-dessous), mais son corps a
disparu : la commande A-1 n'existe nulle part, et pourtant rien n'a
échoué, aucun code d'erreur n'est remonté. Après le 307, le POST
arrive avec son corps et la commande B-1 est créée.
Un client qui ne vérifie pas ce qu'il a réellement envoyé croit donc avoir posté deux commandes. Il en a posté une. C'est ce silence qui rend le cas dangereux en production, bien plus que le changement de méthode ou la perte du corps eux-mêmes.
Comment la négociation de contenu et la compression changent-elles ce qui est transmis ?
Section intitulée « Comment la négociation de contenu et la compression changent-elles ce qui est transmis ? »Le Content-Type dit comment interpréter le corps, le Content-Length dit
sa taille en octets, et la négociation de contenu laisse le client demander
un format ou une compression précise. Le client envoie un en-tête
Accept (« je préfère du JSON, sinon du XML ») et le serveur répond avec
le Content-Type réellement choisi : les deux ne coïncident pas toujours, et
un client strict doit vérifier ce qu'il a reçu plutôt que ce qu'il a
demandé.
La compression (Accept-Encoding: gzip, puis Content-Encoding: gzip
dans la réponse) réduit la taille transmise, mais change le nombre
d'octets réellement posés sur le fil : un Content-Length lu avant
décompression ne décrit pas la taille du contenu final. Une fois un reverse
proxy en place, c'est souvent lui qui décide de compresser ou non, et qui
recalcule ce Content-Length : savoir à quel étage la compression a lieu
évite de chercher une fuite de données là où il n'y a qu'un en-tête mal lu.
Pourquoi un code HTTP seul n'identifie-t-il pas le composant responsable ?
Section intitulée « Pourquoi un code HTTP seul n'identifie-t-il pas le composant responsable ? »Un même code, par exemple 503, peut être renvoyé par l'application, par
un composant intermédiaire, ou être produit localement par le client sans
qu'aucun serveur n'ait répondu. Ce point relève du diagnostic plus que de la
configuration : le code seul ne dit pas qui l'a émis. Une fois un reverse proxy
introduit, cette question devient centrale, parce que le proxy peut produire
ses propres réponses (502, 503, 504) sans jamais contacter le backend (l'application située derrière le proxy), par
exemple quand aucun backend sain n'est disponible.
Lire une réponse HTTP correctement demande donc de regarder, en plus du
code, la source de la réponse : un en-tête Server différent de
celui attendu, un corps de page d'erreur qui ne ressemble pas à celui de
l'application, ou l'absence totale de trace de la requête dans les
journaux applicatifs sont les trois indices qui trahissent une réponse
produite en amont du backend. Cette distinction est développée plus en
détail dans
Publier un service web, qui
associe chaque code d'erreur à son origine la plus probable.
Comment écrire un client qui ne double pas une écriture ?
Section intitulée « Comment écrire un client qui ne double pas une écriture ? »Un client fiable ne se contente pas du texte affiché : après chaque envoi il
lit trois choses, le code HTTP, le code de sortie de curl, et ce que le
serveur a réellement enregistré. Les deux premiers se récupèrent d'un seul
geste : -w '%{http_code}' écrit le code HTTP sur la sortie standard, et le
code de sortie reste disponible dans $? juste après la commande. Voici une
petite fonction Bash qui affiche les deux, et ses cinq résultats réels :
lire() { local code code=$(curl -s -o /dev/null --max-time 5 -w '%{http_code}' "$@") echo "curl sorti avec $?, code HTTP vu : $code"}| Situation | Sortie de curl | Code HTTP vu |
|---|---|---|
Création normale (POST sur /commandes) | 0 | 201 |
| Route inconnue | 0 | 404 |
Route inconnue avec l'option -f | 22 | 404 |
| Réponse perdue : l'API a écrit, puis coupé la connexion | 52 | 000 |
| Port fermé, aucun serveur | 7 | 000 |
Le tableau contient trois leçons. Un 404 n'est pas une panne pour curl :
il sort en 0 tant qu'il a reçu une réponse, et c'est l'option -f qui
transforme un code d'erreur HTTP en sortie 22. Ensuite, 000 signifie qu'aucun
code HTTP n'est arrivé, et le code de sortie dit pourquoi : 7 pour une
connexion impossible, 52 pour une connexion fermée sans réponse (Empty reply from server). Enfin, le cas 52 est le seul où la situation est ambiguë : le
client ne sait pas si le serveur a traité la demande avant de couper.
Que se passe-t-il alors si on rejoue sans précaution ? La fixture du lab
simule ce cas : pour certaines références, l'API écrit la commande puis ferme la
connexion sans répondre. Sans clé, voici la réponse perdue puis le rejeu
naïf, avec le nombre d'écritures que l'API a réellement faites (relevé dans son
fichier d'état, ici ecritures.jsonl : son emplacement dépend de votre
installation) :
curl -sS -X POST -d '{"ref":"perdue-demo"}' http://127.0.0.1:18412/commandesgrep -c perdue-demo ecritures.jsonl # 1 écriture déjà faitecurl -sS -X POST -d '{"ref":"perdue-demo"}' http://127.0.0.1:18412/commandesgrep -c perdue-demo ecritures.jsonl # le rejeu en a fait une deuxièmecurl: (52) Empty reply from server1{"ref": "perdue-demo", "statut": "creee"}2Le client croyait ne rien avoir écrit, il en a écrit deux : c'est le
paiement facturé deux fois de la section sur l'idempotence. Le remède
se joue des deux côtés. Côté serveur, l'API du lab honore l'en-tête
Idempotency-Key : un rejeu avec la même clé ne refait pas l'action et
renvoie la réponse d'origine. Attention, ce comportement (dont le 200 au lieu
du 201) est celui de cette API, pas une règle de HTTP : Idempotency-Key
n'est pas défini par la RFC 9110, et un brouillon de l'IETF
(draft-ietf-httpapi-idempotency-key-header, version 07 d'octobre 2025) le
décrit encore sans être une norme. Chaque API choisit si elle le gère et
comment elle répond.
Reprenons l'échange annoté plus haut et envoyons-le une seconde fois à l'identique :
curl -sS -i -X POST -H 'Content-Type: application/json' \ -H 'Idempotency-Key: cmd-A-100' -d '{"ref":"A-100"}' \ http://127.0.0.1:18412/commandesHTTP/1.1 200 OKServer: BaseHTTP/0.6 Python/3.12.13Date: Sun, 25 Oct 2026 21:10:01 GMTContent-Type: application/jsonContent-Length: 35
{"ref": "A-100", "statut": "creee"}Comparez avec l'échange initial : le corps est identique, mais le code est
200 au lieu de 201, et le fichier d'état compte toujours une seule
écriture pour A-100. Le serveur a reconnu la clé. Pour que ce mécanisme
protège le client, celui-ci doit donc choisir sa clé avant le premier envoi
et la réutiliser telle quelle à chaque rejeu : une clé neuve à chaque
tentative rendrait le serveur incapable de reconnaître la demande.
Vous disposez maintenant des quatre gestes qu'exige un client prudent :
distinguer trois situations (une réponse reçue, une erreur HTTP, aucune
réponse) à partir de -w et du code de sortie de curl ; reconnaître le
cas ambigu (sortie 52, code 000) ; envoyer une clé d'idempotence
stable ; vérifier par un GET ce que le serveur a enregistré. Assembler
ces gestes en un script qui décide quand rejouer, combien de fois et quel code
de sortie rendre est le travail du lab.
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab vous fait lire un véritable échange HTTP et attribuer chaque réponse à son émetteur, preuves à l'appui. Vous y observez le comportement de chaque code de redirection, vous notez le code rendu par plusieurs routes, puis vous écrivez un client Bash qui crée une commande exactement une fois, même quand la réponse ne revient jamais. Les tests rejouent les redirections, envoient des références neuves et comptent les écritures réellement faites par l'API.
À retenir
Section intitulée « À retenir »- Une requête se lit en cinq points : méthode, autorité (
Hostou:authority), chemin, en-têtes, corps. - Une méthode idempotente (
GET,HEAD) peut être rejouée sans changer l'état du service, ce qui ne la rend ni gratuite ni invisible dans les journaux ; rejouer unPOSTpeut doubler une action métier. 301/302peuvent changer la méthode d'une requête redirigée,307/308la conservent toujours ; dans la mesure de cette leçon, un302suivi parcurl -X POSTa gardé la méthode mais perdu le corps, sans aucune erreur.Content-Type,Content-Lengthet la négociation de contenu décrivent ce qui est réellement transmis, pas ce qui a été demandé.- Un échange se lit ligne par ligne : chaque en-tête décide quelque chose
(
Hostchoisit l'application,Content-Typele décodage du corps,Idempotency-Keyla reconnaissance d'un rejeu). curlsort en 0 sur un 404 (sauf avec-f, sortie 22) ; un code000avec une sortie 52 est le cas ambigu où l'écriture a pu être faite.- Rejouer avec la même clé d'idempotence ne refait pas l'action : le serveur répond 200 au lieu de 201.
- Un code HTTP seul n'identifie jamais le composant qui l'a émis : il faut regarder la source de la réponse.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Préparer les noms DNS et leur bascule
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications