Avant d'exposer un service, il faut savoir précisément depuis quel réseau son socket est réellement joignable, et avoir écrit la liste des flux attendus plutôt que de supposer qu'un pare-feu les bloque déjà. Un socket, ici, est le point d'écoute d'un processus : une adresse IP et un port. Cette leçon conclut le socle « Publier un service web » : elle s'appuie sur Préparer les noms DNS et leur bascule et prépare la leçon suivante sur le trajet complet d'une requête. La mécanique détaillée du pare-feu, du NAT et des ports est déjà couverte par des guides dédiés, cités au fil du texte : ici, l'objectif est de savoir construire et vérifier une matrice de flux, pas de réapprendre chaque commande.
Deux mots reviendront tout au long de la leçon. Le point d'entrée est le service qui reçoit les requêtes des clients (le reverse proxy des leçons précédentes). Le backend est l'application qu'il appelle derrière lui, et qui ne doit pas être jointe directement par un client externe.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Identifier depuis quel réseau un socket est réellement accessible, selon son adresse d'écoute
- Lire les écoutes avec
ss -ltnet sonder par le code HTTP (jamais par le corps) pour remplir une matrice de flux - Construire une matrice de flux qui n'expose jamais un backend directement au client externe
- Expliquer pourquoi tester depuis la machine elle-même ou empiler des conteneurs sur un même hôte ne prouve ni l'un ni l'autre ce qu'on croit
Prérequis
Section intitulée « Prérequis »Cette leçon suppose
Préparer les noms DNS et leur bascule
et les bases réseau détaillées dans
TCP vs UDP (ports, test avec
netcat), Pare-feu (ingress,
egress, règles) et Le NAT (port
forwarding). Elle ne les réexplique pas, et se concentre sur un seul geste :
savoir, pour un socket donné, qui peut réellement l'atteindre.
Depuis quel réseau un socket est-il réellement accessible ?
Section intitulée « Depuis quel réseau un socket est-il réellement accessible ? »L'adresse sur laquelle un processus écoute détermine, avant toute règle de
pare-feu, qui peut même tenter de s'y connecter. Trois cas reviennent sans
cesse : une écoute sur 127.0.0.1 (loopback) n'est joignable que depuis
la machine elle-même, aucun pare-feu n'est nécessaire pour la protéger d'un
réseau distant ; une écoute sur une adresse privée précise
(10.10.110.11 par exemple) n'est joignable que depuis un réseau qui route
vers cette adresse ; une écoute sur 0.0.0.0 (toutes interfaces) répond
sur chaque adresse IP que porte la machine, y compris une adresse publique si
elle en a une.
Confondre ces trois cas produit une exposition accidentelle : un service
censé rester interne, lancé par erreur sur
0.0.0.0 plutôt que sur l'adresse privée prévue, devient joignable depuis
n'importe quel réseau qui atteint la machine, y compris Internet si une
règle de redirection de port existe par ailleurs. Vérifier l'adresse
d'écoute réelle (pas celle qu'on croit avoir configurée) est donc le tout
premier geste, avant même de lire une seule règle de pare-feu.
Comment lire les écoutes avec ss -ltn ?
Section intitulée « Comment lire les écoutes avec ss -ltn ? »ss -ltn liste les sockets TCP en écoute (-l) en numérique (-n), et la
colonne Local Address donne l'adresse d'écoute réelle de chaque processus.
C'est la source de vérité pour le premier geste, plus fiable que la
configuration que l'on croit avoir écrite. Relevé réel, avec deux services
d'essai de la machine de test : le premier écoute en loopback (port 18103), le
second sur toutes les interfaces (port 18104). Les ports et adresses de cette
leçon sont ceux de cette capture, vous n'avez pas à les recréer : chez vous,
la même commande liste vos propres services.
ss -ltn | grep -E 'State|:1810[34] 'State Recv-Q Send-Q Local Address:Port Peer Address:PortProcessLISTEN 0 5 0.0.0.0:18104 0.0.0.0:*LISTEN 0 5 127.0.0.1:18103 0.0.0.0:*La différence se lit dans la colonne Local Address : 127.0.0.1:18103
n'est joignable que depuis la machine, 0.0.0.0:18104 l'est sur chacune
de ses adresses. Le même service lancé avec une option différente change
donc sa surface d'exposition, sans qu'aucune règle de pare-feu n'ait
bougé.
Quelle sonde dit qu'un port est ouvert : le code ou le corps ?
Section intitulée « Quelle sonde dit qu'un port est ouvert : le code ou le corps ? »Pour tester une écoute HTTP, lisez le code de la réponse : 000 signifie
qu'aucune réponse n'est arrivée (port fermé, filtré ou injoignable), tout
autre code HTTP signifie que le port est ouvert et répond. Lire le corps
de la réponse est un piège : un service peut répondre correctement sans
corps du tout. Le premier service d'essai renvoie 204 No Content, le code
HTTP prévu pour « j'ai réussi, je n'ai rien à vous dire ». On le sonde depuis
la machine (127.0.0.1) puis depuis une autre de ses adresses
(192.168.1.71, l'adresse du réseau local du poste de test : chez vous,
hostname -I liste les vôtres), avec le port 18199 comme témoin fermé. Cette
« autre adresse » appartient à la même machine : ce n'est pas encore un
test depuis l'extérieur, la limite est détaillée plus bas.
for t in 127.0.0.1:18103 192.168.1.71:18103 127.0.0.1:18104 \ 192.168.1.71:18104 127.0.0.1:18199; do c=$(curl -s -o /dev/null -w '%{http_code}' --max-time 2 "http://$t/") printf '%-22s code %s\n' "$t" "$c"done127.0.0.1:18103 code 204192.168.1.71:18103 code 000127.0.0.1:18104 code 200192.168.1.71:18104 code 200127.0.0.1:18199 code 000Chaque ligne est une sonde curl sur une adresse différente, et
-w '%{http_code}' n'affiche que le code. Le service en loopback répond
204 en local et 000 via l'adresse du réseau : joignable ici,
injoignable là. Le second répond 200 des deux côtés. Et le port 18199, où
rien n'écoute, donne aussi 000.
Voyons maintenant la sonde fautive, celle qui télécharge la réponse et teste si le corps est non vide, sur les deux mêmes services :
127.0.0.1:18103 -> corps vide : conclu FERME127.0.0.1:18104 -> corps non vide : conclu OUVERTCette sonde conclut « fermé » pour le service qui répond 204 : c'est une
fausse conclusion de fermeture, alors que le port est ouvert et répond
correctement. Le corps ne mesure que ce que le service a décidé d'écrire, pas
ce que le réseau laisse passer. À l'inverse, le code 000 ne dit pas
pourquoi : curl rend Failed to connect ... Could not connect to server
(code de sortie 7) pour un port où rien n'écoute. De son côté, nc -z (qui
ouvre la connexion sans rien envoyer) tranche par son code de sortie : 0
pour une connexion acceptée, 1 pour une connexion refusée, sans lire un seul
octet de la réponse.
Un port « fermé » et un port « filtré » donnent le même 000 mais n'ont pas
la même cause. Un port fermé est un port où la machine répond
explicitement qu'aucun processus n'écoute : le refus est immédiat. Un port
filtré est un port où un pare-feu jette le paquet sans rien répondre : le
client attend jusqu'à son délai maximal (avec --max-time 2, curl s'arrête
alors avec le code de sortie 28). Pour distinguer un refus d'un filtrage
silencieux en détail, voyez TCP vs UDP.
Pourquoi la sécurité d'un fournisseur cloud ne remplace-t-elle pas le pare-feu de l'hôte ?
Section intitulée « Pourquoi la sécurité d'un fournisseur cloud ne remplace-t-elle pas le pare-feu de l'hôte ? »Un groupe de sécurité cloud (security group) et le pare-feu installé sur la machine (iptables, nftables) sont deux contrôles distincts, appliqués à des moments différents du trajet, et aucun des deux ne dispense de l'autre. Le groupe de sécurité filtre le trafic avant qu'il n'atteigne l'interface réseau de la machine, au niveau de l'infrastructure du fournisseur ; le pare-feu de l'hôte filtre ensuite, une fois le paquet arrivé sur cette interface. Une règle ouverte dans l'un sans équivalent fermé dans l'autre expose exactement ce que l'autre contrôle croyait protéger.
Un moteur de conteneurs ajoute encore un niveau : Docker, par exemple, manipule ses propres règles iptables pour router le trafic publié vers un conteneur, parfois en contournant des règles posées manuellement sur l'hôte si elles ne sont pas écrites dans la bonne chaîne. Le guide Réseau Docker détaille cette interaction. Construire une matrice de flux exige donc de lister, pour chaque service, les trois niveaux qui peuvent laisser passer ou bloquer un flux : le groupe de sécurité cloud, le pare-feu de l'hôte, et les règles propres au moteur de conteneurs.
Comment construire une matrice de flux qui n'expose pas les backends ?
Section intitulée « Comment construire une matrice de flux qui n'expose pas les backends ? »Une matrice de flux liste, pour chaque service, qui a le droit de lui parler : le client externe, un éventuel réseau d'administration, et le réseau backend qui ne doit être joignable que par le point d'entrée prévu. Trois catégories d'origine suffisent pour la plupart des publications : le client externe, qui ne doit atteindre que le port public du point d'entrée ; le réseau d'administration, réservé aux personnes qui opèrent le service (SSH, console de supervision) et qui ne doit jamais être ouvert au client externe ; le réseau backend, où vivent les applications elles-mêmes, qui ne doit accepter de connexions que depuis le point d'entrée, jamais directement depuis l'extérieur.
Écrire cette matrice de flux avant de poser la moindre règle de pare-feu change la question posée : au lieu de se demander « quelle règle dois-je ajouter ? », on se demande « quel flux ai-je décidé d'autoriser, et pourquoi ? ». Les guides Pare-feu et Le NAT montrent comment traduire cette matrice en règles concrètes, en IPv4 comme en IPv6 : l'absence de NAT, courante en IPv6 où chaque machine garde une adresse routable, ne signifie pas l'absence de filtrage, comme le détaille IPv6 en pratique.
À quoi ressemble la topologie à vérifier ?
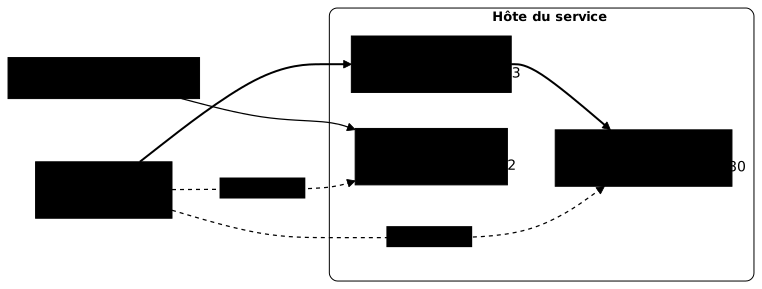
Section intitulée « À quoi ressemble la topologie à vérifier ? »La topologie dit qui doit pouvoir joindre quoi : le client externe n'a droit qu'au point d'entrée, l'administration qu'à SSH, et le backend qu'au point d'entrée. Sur le schéma, les flèches pleines sont les flux voulus ; les pointillées sont les chemins qui doivent échouer et que vos sondes vont chercher. Notez que le backend écoute en loopback : même sans pare-feu, il n'est pas joignable de l'extérieur.
Comment remplir la matrice avec ce que l'on observe ?
Section intitulée « Comment remplir la matrice avec ce que l'on observe ? »On remplit deux colonnes par service : ce que la politique autorise, et ce
que l'observation montre depuis chaque point de test ; une divergence entre
les deux colonnes est un défaut à traiter. La colonne « politique » vient de
votre décision d'architecture ; la colonne « observation » vient de
ss -ltn et des sondes ci-dessus. Avec les trois services d'essai (le
premier joue un backend, le second un point d'entrée, le dernier un service
qui devrait être fermé), la matrice remplie donne :
| Service | Politique voulue | Écoute (ss -ltn) | Depuis la machine | Depuis une autre adresse | Verdict |
|---|---|---|---|---|---|
| Backend (18103) | Machine seule | 127.0.0.1 | 204 (ouvert) | 000 | Conforme |
| Point d'entrée (18104) | Ouvert à tous | 0.0.0.0 | 200 (ouvert) | 200 (ouvert) | Conforme |
| Port 18199 | Fermé | absent | 000 | 000 | Conforme |
Cette matrice a une limite à connaître : l'« autre adresse » est une adresse de la même machine. Elle prouve que l'écoute en loopback est bien invisible depuis le réseau local, mais elle ne traverse aucun pare-feu périmétrique (celui qui garde la frontière du réseau, entre Internet et vos machines) : cette matrice ne prouve donc rien sur lui. Seule une sonde lancée depuis un autre réseau le fait, et c'est ce que demande le lab.
Que conclure quand les deux colonnes divergent ?
Section intitulée « Que conclure quand les deux colonnes divergent ? »Quand la politique et l'observation divergent, on cherche d'abord dans
l'écoute (ss -ltn), puis dans les filtres. Trois cas se rencontrent :
| Divergence | Cause la plus probable | Où chercher |
|---|---|---|
Backend voulu fermé, mais 200 depuis une autre adresse | Écoute sur 0.0.0.0 au lieu de 127.0.0.1 | Local Address dans ss -ltn |
Service voulu ouvert, 000 partout, absent de ss -ltn | Service arrêté ou mal lancé | Le processus, ses journaux |
Service voulu ouvert, présent dans ss -ltn, 000 depuis l'extérieur seulement | Un filtre entre les deux (pare-feu hôte, groupe de sécurité, règle du moteur de conteneurs) | Les trois niveaux décrits plus haut (groupe de sécurité, pare-feu de l'hôte, moteur de conteneurs) |
Le troisième cas est celui où le pare-feu devient suspect : c'est pourquoi on ne commence pas par lui.
Pourquoi un test depuis la machine elle-même ne prouve-t-il rien sur l'accessibilité externe ?
Section intitulée « Pourquoi un test depuis la machine elle-même ne prouve-t-il rien sur l'accessibilité externe ? »Une requête qui réussit depuis la machine qui héberge le service emprunte
souvent un chemin réseau totalement différent de celui d'un client externe,
et ne traverse ni le pare-feu périmétrique ni, parfois, aucune règle du
tout. C'est la première erreur à écarter avant de déclarer un service
exposé correctement : tester depuis la VM ne prouve pas
l'inaccessibilité depuis l'extérieur, ni d'ailleurs son accessibilité. Un
processus qui répond en local via 127.0.0.1 ou l'adresse interne de la
machine peut rester totalement injoignable depuis un réseau distant, ou à
l'inverse, un service qu'on croit protégé peut déjà être exposé
publiquement sans qu'un test local ne le révèle jamais.
Vérifier une exposition demande donc un test effectué depuis un point d'observation extérieur réel, sur un réseau distinct de celui de la machine testée, avec les mêmes ports et le même protocole qu'un vrai client emploierait. C'est exactement ce que vérifie la matrice de flux une fois posée : pas « le service répond-il ? » mais « depuis quel réseau précisément répond-il, et depuis lequel refuse-t-il ? ».
Pourquoi deux conteneurs sur le même hôte ne constituent-ils pas de la haute disponibilité ?
Section intitulée « Pourquoi deux conteneurs sur le même hôte ne constituent-ils pas de la haute disponibilité ? »Deux conteneurs, deux réplicas ou deux instances d'une application qui tournent sur la même machine physique partagent le même point de panne : l'hôte. C'est la seconde erreur à écarter avant de publier un service qu'on croit résilient : multiplier les instances protège contre la panne d'un processus, jamais contre la panne de la machine qui les héberge toutes. Une matrice de flux bien construite identifie non seulement les réseaux autorisés, mais aussi les points de panne partagés derrière chaque flux qu'elle décrit : une redondance qui s'arrête au même hôte, à la même alimentation électrique ou à la même baie réseau n'en est pas une.
Cette distinction ne se résout pas par une règle de pare-feu : elle se résout par une décision d'architecture, répartir les instances sur des machines physiquement distinctes, qui dépasse le périmètre de cette leçon mais doit être posée avant de qualifier un service de hautement disponible.
Le lab applique la démarche de la leçon : une publication répond, mais expose trop de ports. Vous établissez la matrice de flux, puis fermez les chemins qui contournent le point d'entrée, en vérifiant depuis un client sur un autre réseau.
À retenir
Section intitulée « À retenir »- Une écoute en loopback, sur une adresse privée ou sur toutes
interfaces (
0.0.0.0) ne détermine pas la même surface d'accessibilité. - Le groupe de sécurité cloud, le pare-feu de l'hôte et les règles du moteur de conteneurs sont trois contrôles distincts, et aucun ne dispense des deux autres.
- Une matrice de flux liste le client externe, le réseau d'administration et le réseau backend, et n'expose ce dernier qu'au point d'entrée prévu.
- Une sonde HTTP lit le code :
000= aucune réponse (port fermé ou filtré), tout autre code = port ouvert. Un204sans corps est un port ouvert, pas fermé. - Tester depuis la machine elle-même ne prouve ni l'accessibilité ni l'inaccessibilité externe : seul un test depuis un réseau distinct le prouve. Une autre adresse de la même machine ne traverse aucun pare-feu périmétrique.
- Deux conteneurs sur le même hôte partagent le même point de panne : ce n'est pas de la haute disponibilité.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Reverse proxy : rôle, limites et chemin d'une requête
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications