Une application placée derrière un point d'entrée ne voit plus ni le schéma, ni le nom, ni l'identité réels du client : elle doit les apprendre du proxy, ou elle les devine mal. Le point d'entrée est le service qui reçoit les requêtes à la place de l'application, le plus souvent un reverse proxy. Cette leçon s'adresse à qui publie une application qu'il n'a pas écrite, ou qu'il a écrite sans penser au proxy. Elle traite les pannes courantes : une connexion qui boucle, un cookie que le navigateur ne renvoie pas, une session perdue d'une copie de l'application à l'autre, une politique d'origine trop large et un en-tête d'identité recopié depuis le client.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Faire connaître à l'application le schéma, le nom et le chemin que voit le client.
- Choisir les attributs d'un cookie de session et reconnaître un cookie que le navigateur refuse.
- Placer l'état d'une session sans le cacher derrière une affinité.
- Expliquer ce que CORS autorise, et ce qu'il n'interdit pas.
- Distinguer authentification, autorisation, CORS et protection CSRF.
- Décider l'identité côté serveur et refuser celle qu'un client injecte.
Prérequis
Section intitulée « Prérequis »Cette leçon suppose que vous savez lire un échange HTTP et que vous avez déjà publié un service derrière un proxy. Elle ne réexplique ni la terminaison TLS, ni les en-têtes X-Forwarded-*, ni la confiance accordée à un en-tête :
- Lire un échange HTTP : en-têtes, codes de statut, redirections.
- Publier un service web : le trajet d'une requête : terminaison TLS,
X-Forwarded-For,X-Forwarded-ProtoetX-Forwarded-Host. - Définir une politique de sécurité du point d'entrée : authentification, autorisation et confiance accordée à un en-tête.
Pourquoi une application correcte seule casse-t-elle derrière un proxy ?
Section intitulée « Pourquoi une application correcte seule casse-t-elle derrière un proxy ? »Parce que l'application se fie à ce qu'elle reçoit, et que le proxy change trois choses : le schéma, le nom et l'origine de la connexion. Seule, l'application reçoit directement du HTTPS, avec le nom que le client a tapé. Derrière un proxy qui termine le TLS, elle reçoit du HTTP en clair, venu d'une adresse interne, parfois avec un Host remplacé. Tout ce qu'elle déduit de la requête (« suis-je en HTTPS ? », « quel est mon nom public ? ») devient faux sans que rien ne plante.
Quatre questions ressortent, et la leçon les traite dans cet ordre. Quelle URL l'application croit-elle et génère-t-elle ? Que devient le cookie de session ? Où vit l'état de cette session quand plusieurs copies de l'application répondent ? Qui décide d'autoriser une origine et de connaître l'identité ?
| Ce que l'application déduit | Ce qui est vrai derrière le proxy | Conséquence |
|---|---|---|
| Le client parle en HTTP | Le client parle HTTPS, le proxy parle HTTP à l'application | Redirection vers HTTPS en boucle |
| Mon nom est celui de la requête | Le nom public est celui que le client a tapé | Liens et redirections vers un nom interne |
| Je suis à la racine du site | Le proxy publie l'application sous un préfixe | Liens qui sortent du préfixe |
| L'appelant est celui qui me joint | L'appelant est le proxy | Identité et adresse à lire dans des en-têtes |
Quelle URL l'application doit-elle croire et générer ?
Section intitulée « Quelle URL l'application doit-elle croire et générer ? »L'application doit connaître le schéma, le nom et le préfixe publics, par les en-têtes du proxy ou par un réglage explicite, et ne croire ces en-têtes que du proxy. La page Publier un service web a déjà posé la règle de confiance sur les en-têtes X-Forwarded-* (X-Forwarded-Proto pour le schéma, X-Forwarded-Host pour le nom), avec la liste des proxys de confiance (trusted proxies). Elle n'est pas redite ici. Ce qui lui manque, c'est la conséquence côté application : l'URL que celle-ci génère.
Une application produit des URL à plusieurs endroits : l'en-tête Location d'une redirection (l'adresse où la réponse renvoie le navigateur), les liens d'une page, les adresses de retour d'un parcours de connexion, les liens d'un courriel. Pour chacune, elle choisit un schéma, un nom et un chemin. Si elle croit être en HTTP, elle écrit http://. Si elle redirige vers HTTPS quand elle se croit en HTTP, et que le proxy lui parle toujours en HTTP, la boucle est certaine : le navigateur reçoit une redirection, la suit, et retombe sur la même réponse jusqu'à abandonner. Le détail des codes de redirection est dans Lire un échange HTTP.
Le base path est le préfixe sous lequel le proxy publie l'application, par exemple /compte/ pour une application qui, seule, vit à la racine. Si le proxy retire le préfixe avant de transmettre, l'application ne le voit jamais et génère des liens vers /login au lieu de /compte/login. Le navigateur suit alors un lien qui sort du préfixe et tombe sur une autre route, ou sur un 404.
Ajouter des en-têtes au proxy ne corrige donc pas toutes les URL générées. Un en-tête ne sert que si l'application le lit. Beaucoup de frameworks exigent un réglage (proxys de confiance, URL publique, préfixe) avant de s'en servir, et certaines URL ne passent par aucune requête : un lien dans un courriel, une adresse de retour enregistrée chez un fournisseur d'identité, une valeur écrite en dur dans la configuration. Le nom exact de ces réglages dépend du framework : lisez sa documentation, ce que la leçon ne peut pas faire à sa place.
Pour voir ce que l'application génère, regardez la redirection sans la suivre :
curl -ski https://app.exemple.fr/compte | grep -i '^location'Les options -s (silencieux), -k (accepter un certificat auto-signé, à réserver à un essai) et -i (afficher les en-têtes) laissent voir le Location brut. S'il commence par http:// ou par un nom interne alors que vous êtes en HTTPS sur le nom public, l'application a mal appris son URL, et c'est elle qu'il faut régler.
Qu'est-ce qu'un cookie de session, et quels attributs règle-t-on ?
Section intitulée « Qu'est-ce qu'un cookie de session, et quels attributs règle-t-on ? »Un cookie est une petite valeur que le serveur demande au navigateur de mémoriser et de renvoyer à chaque requête vers lui ; un cookie de session porte l'identifiant de la connexion de l'utilisateur. Le serveur le pose par l'en-tête de réponse Set-Cookie, le navigateur le renvoie dans l'en-tête de requête Cookie. Une session est l'état que l'application garde pour un utilisateur connecté (qui il est, ce qu'il a fait) entre deux requêtes : HTTP n'ayant pas de mémoire, le cookie est le fil qui relie les requêtes d'une même personne.
Cinq attributs règlent ce que le navigateur en fait. Les définitions viennent de la page Set-Cookie de MDN.
| Attribut | Ce qu'il décide | Piège |
|---|---|---|
Secure | Le cookie n'est envoyé qu'en https: (sauf sur localhost) | Posé par une réponse reçue en http:, il est refusé : cause possible de « connexion réussie, puis anonyme » |
HttpOnly | Le JavaScript de la page ne peut pas le lire, par exemple via document.cookie | Le cookie reste envoyé aux requêtes lancées par fetch() |
SameSite | Le cookie est-il envoyé quand la requête vient d'un autre site : Strict, Lax ou None | None exige Secure |
Domain | À quels noms le cookie est renvoyé | Une valeur qui n'est ni le nom de l'émetteur ni un parent est ignorée |
Path | Quels chemins reçoivent le cookie | Ce n'est pas une mesure de sécurité |
Deux attributs demandent un mot de plus, Domain puis SameSite. Sans Domain, le cookie est limité à l'hôte exact qui l'a posé (MDN parle de host-only cookie) : c'est plus restrictif que d'indiquer le nom, car les sous-domaines ne le reçoivent pas. Avec Domain=exemple.fr, tous les sous-domaines le reçoivent.
SameSite décide d'un envoi entre sites (un site est un domaine enregistrable : app.exemple.fr et api.exemple.fr sont du même site exemple.fr). Avec Strict, le cookie ne part que pour des requêtes issues du même site ; avec Lax, il part aussi pour une navigation de haut niveau avec une méthode qui ne modifie rien (GET), comme un clic sur un lien ; avec None, il part toujours, à condition d'être Secure. Les navigateurs Chromium (Chrome, Edge, Opera) appliquent Lax quand l'attribut est absent, avec une exception : le cookie part aussi avec un POST de navigation entre sites pendant les deux minutes qui suivent sa pose. D'après les données de compatibilité de MDN, Firefox et Safari n'appliquent pas ce défaut. Écrivez donc l'attribut plutôt que de compter sur lui.
Voici un cookie de session raisonnable pour une application servie sur un seul nom :
Set-Cookie: session=a1b2c3; Path=/; Secure; HttpOnly; SameSite=LaxIl n'a pas de Domain, donc il reste attaché à l'hôte qui l'a posé. Sauf réglage explicite du proxy, celui-ci ne modifie pas ces attributs : c'est l'application qui émet le cookie.
Pourquoi un cookie au mauvais Domain disparaît-il sans erreur ?
Section intitulée « Pourquoi un cookie au mauvais Domain disparaît-il sans erreur ? »Parce que le navigateur ignore silencieusement un cookie dont le Domain n'est ni le nom de celui qui répond, ni un de ses parents. MDN le formule ainsi : une réponse de api.exemple.fr peut fixer Domain=api.exemple.fr ou Domain=exemple.fr, mais pas Domain=autre.exemple.fr ni Domain=fr (un suffixe public), et les cookies qui enfreignent ces règles sont ignorés.
Le symptôme est déroutant : la connexion réussit (le serveur répond 302 avec son Set-Cookie), puis la page suivante vous traite en anonyme. Rien dans la réponse ne signale l'erreur, et curl ne la montre pas : sans fichier de cookies, il n'évalue pas le cookie et affiche simplement l'en-tête. C'est le navigateur qui le rejette, et c'est dans ses outils de développement qu'il faut chercher. Une connexion qui « marche » en curl et échoue au navigateur doit donc faire regarder les attributs du Set-Cookie, à commencer par Domain. La correction la plus sûre est le plus souvent de ne pas poser Domain : le cookie revient à l'hôte qui l'a émis.
Où vit la session quand plusieurs copies de l'application répondent ?
Section intitulée « Où vit la session quand plusieurs copies de l'application répondent ? »L'état d'une session doit vivre ailleurs que dans la mémoire d'une instance, sinon l'utilisateur est déconnecté dès qu'une autre instance répond. Derrière un proxy qui répartit la charge, deux requêtes d'une même personne peuvent atteindre deux instances. Si la session est gardée dans la mémoire de la première, la seconde ne la connaît pas : l'utilisateur est déconnecté « au hasard ».
Il existe trois emplacements, et le choix est un choix d'architecture, pas de proxy :
| Emplacement de l'état | Ce qu'il faut | Contrepartie |
|---|---|---|
| Stockage partagé (une base ou un cache commun) | Toutes les instances lisent le même magasin | Un composant de plus à rendre disponible |
| Dans le cookie lui-même, signé par le serveur | Une clé de signature commune aux instances | Le cookie grossit ; la clé devient un secret à protéger |
| Mémoire de l'instance | Que le proxy renvoie toujours le client à la même instance | C'est l'affinité, voir ci-dessous |
L'affinité (sticky session) fait coller un client à une instance, souvent par un cookie que le proxy pose lui-même. Elle fonctionne, et la leçon Borner temps, files et flux longs avec HAProxy montre jusqu'où elle tient. Mais elle cache un état mal placé au lieu de le corriger : quand l'instance redémarre ou tombe, les sessions qu'elle portait disparaissent, et la répartition de charge devient inégale. Une affinité se choisit en connaissance de cause, jamais pour masquer une session oubliée en mémoire.
Que fait CORS, et que ne fait-il pas ?
Section intitulée « Que fait CORS, et que ne fait-il pas ? »CORS (Cross-Origin Resource Sharing) est un mécanisme de navigateur par lequel un serveur indique quelles autres origines peuvent lui envoyer certaines requêtes et lire ses réponses ; il n'empêche aucun client de joindre le serveur. Une origine est le triplet schéma, nom et port : https://app.exemple.fr et http://app.exemple.fr:8080 sont deux origines différentes. Par défaut, un navigateur interdit au JavaScript d'une page de lire la réponse d'une autre origine (la politique de même origine). CORS est l'exception contrôlée : le serveur de l'API répond par l'en-tête Access-Control-Allow-Origin pour dire quelle origine est admise.
Le pré-vol (preflight) est la demande préalable que le navigateur envoie, avec la méthode OPTIONS, avant certaines requêtes. Il s'en dispense pour une requête simple : une méthode GET, HEAD ou POST, des en-têtes limités, et pour le corps un type application/x-www-form-urlencoded, multipart/form-data ou text/plain. Un POST avec un corps application/json n'est pas simple : le navigateur interroge d'abord l'API avec OPTIONS, annonçant la méthode et les en-têtes prévus, puis n'envoie la vraie requête que si la réponse l'y autorise.
Regardez le schéma de gauche à droite et de haut en bas. Les quatre premiers échanges montrent une origine A autorisée : pré-vol, POST, réponse lisible. Les deux derniers montrent une origine C pour laquelle la réponse ne porte pas Access-Control-Allow-Origin : l'API a répondu, mais c'est le navigateur qui renonce à la suite, sans envoyer le POST ni rien livrer à la page C.
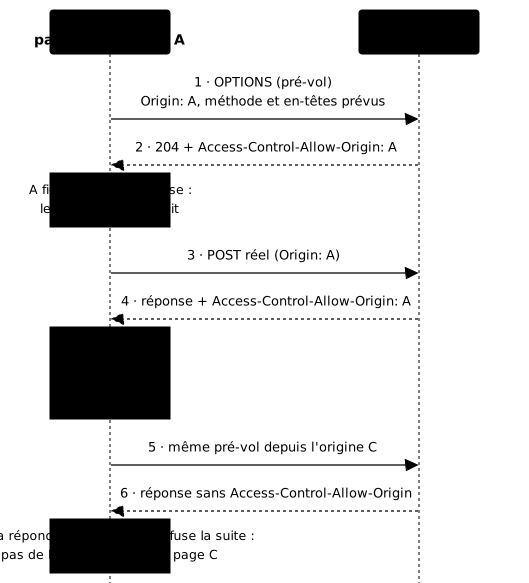
Deux points évitent les contresens. D'abord, un serveur qui répond Access-Control-Allow-Origin: * autorise toute origine pour des requêtes sans identifiants. Avec des identifiants (le cookie), la page doit les demander (option credentials: "include" de fetch()), la réponse doit porter Access-Control-Allow-Credentials: true, et MDN précise que le joker est interdit : le serveur doit nommer une origine explicite, faute de quoi le navigateur refuse la réponse à la page et signale une erreur CORS. Ensuite, quand le serveur renvoie une origine précise, qui peut varier selon la requête, plutôt que *, MDN indique que la réponse devrait porter Vary: Origin, pour qu'un cache ne serve pas à une origine la réponse prévue pour une autre. La syntaxe des réglages côté point d'entrée est dans Protéger le point d'entrée Traefik.
CORS interdit-il à un client non navigateur de joindre l'API ?
Section intitulée « CORS interdit-il à un client non navigateur de joindre l'API ? »Non : CORS n'est pas un contrôle d'accès, il n'instruit qu'un navigateur. Un client qui n'est pas un navigateur, comme curl, un script ou une application serveur, n'applique aucune politique de même origine. Il envoie sa requête, lit la réponse, et ignore Access-Control-Allow-Origin. L'en-tête Origin que le navigateur ajoute est d'ailleurs écrit par le client : un autre client y met ce qu'il veut.
La différence se mesure avec une commande. Elle joue le rôle d'un script hostile, annonce une origine inventée et atteint l'API quelle que soit la politique d'origine :
curl -sk -o /dev/null -w '%{http_code}\n' -X POST \ -H 'Origin: https://site-hostile.test' \ -H 'Content-Type: application/json' -d '{}' \ https://app.exemple.fr/api/questionLa commande affiche le code que l'API a choisi de rendre (200, ou 401 si elle exige une authentification) : la requête est arrivée, et aucune erreur CORS ne peut apparaître, puisque seul un navigateur en produit. Le même appel, fait par le JavaScript d'une page de https://site-hostile.test, est arrêté par le navigateur si l'API n'autorise pas cette origine : le corps étant en JSON, le pré-vol échoue et le POST n'est pas envoyé. Même un navigateur envoie parfois la requête avant de savoir : MDN note qu'une requête simple part sans pré-vol, parce qu'un formulaire HTML peut déjà viser n'importe quelle origine. CORS décide donc de ce qu'une page tierce peut envoyer et lire depuis un navigateur, il ne protège pas l'API. Ce qui protège l'API, c'est l'authentification (qui appelle ?) et l'autorisation (a-t-il le droit ?), comme le pose la politique du point d'entrée.
Que protège SameSite, et qu'est-ce que le CSRF ?
Section intitulée « Que protège SameSite, et qu'est-ce que le CSRF ? »Le CSRF (Cross-Site Request Forgery) est une attaque où un site tiers fait envoyer par le navigateur d'une victime une requête qui porte son cookie de session ; SameSite en réduit le risque en retenant le cookie. Si vous êtes connecté à une banque et qu'une autre page déclenche un virement vers elle, le navigateur joint votre cookie, et la banque croit à votre demande. Avec SameSite=Lax ou Strict, le cookie ne part pas pour une requête de formulaire issue d'un autre site avec une méthode qui modifie des données, comme un POST.
Il ne faut pas confondre ces quatre notions, qui répondent à des questions différentes :
| Notion | Question à laquelle elle répond | Qui décide |
|---|---|---|
| Authentification | Qui est cet appelant ? | Le serveur |
| Autorisation | A-t-il le droit de faire cela ? | Le serveur |
| CORS | Quelle origine peut, depuis un navigateur, envoyer cette requête et lire la réponse ? | Le navigateur, sur indication du serveur |
| Protection CSRF | Une requête portant mon cookie vient-elle vraiment de moi ? | Le serveur, aidé de SameSite |
Quel en-tête d'identité le serveur peut-il croire ?
Section intitulée « Quel en-tête d'identité le serveur peut-il croire ? »Un en-tête d'identité ne vaut que si le point d'entrée le décide lui-même, à partir d'une preuve qu'il a vérifiée, et jamais en le recopiant depuis le client. Une architecture courante charge le proxy de reconnaître l'utilisateur, puis de transmettre son nom à l'application dans un en-tête (appelons-le X-Utilisateur). C'est pratique, et dangereux dès que le proxy recopie un X-Utilisateur déjà présent dans la requête : un en-tête est du texte, et n'importe quel client peut l'écrire.
La parade a deux gestes. Le point d'entrée supprime l'en-tête d'identité reçu du client, quelle qu'en soit la valeur. Puis il en pose un nouveau seulement s'il a validé une preuve, par exemple un cookie de session que lui seul sait vérifier, parce qu'il est signé avec un secret du serveur ou parce qu'il désigne une entrée d'un magasin de sessions. Sans preuve valide, l'application ne reçoit aucun en-tête, et traite l'appelant comme anonyme.
Cette règle est la même que dans deux autres leçons de la formation : la politique du point d'entrée pose qu'un en-tête d'identité n'est cru que posé par un proxy de confiance, et les identités client et backend distinguent une identité d'une autorisation. Les deux défenses se complètent : la politique dit à quelles adresses l'application croit l'en-tête, et la parade ci-dessus garantit que le proxy de confiance n'en relaie jamais un écrit par le client. Retenez la distinction : le point d'entrée établit qui appelle ; ce que cet appelant a le droit de faire reste une décision d'autorisation, prise ensuite.
Pour le vérifier, envoyez une requête sans session, avec un en-tête d'identité que vous avez écrit vous-même :
curl -sk -H 'X-Utilisateur: etudiant' https://app.exemple.fr/api/identiteLa réponse doit présenter l'appelant comme anonyme. Si elle le présente comme etudiant, le point d'entrée croit un en-tête que le client a écrit.
Quelles erreurs verrez-vous, et que disent-elles ?
Section intitulée « Quelles erreurs verrez-vous, et que disent-elles ? »Chaque panne de cette leçon a un symptôme précis, qui désigne l'attribut ou le réglage fautif.
| Symptôme | Cause probable | Où regarder |
|---|---|---|
| Le navigateur abandonne après trop de redirections | L'application se croit en HTTP et redirige vers HTTPS | Location brut avec curl -i, réglage du schéma de l'application |
| Connexion réussie, puis page « anonyme » | Cookie refusé : Domain invalide, ou cookie Secure sur une connexion en http: | Outils de développement du navigateur, en-tête Set-Cookie |
| Liens qui mènent à un 404 | Préfixe retiré par le proxy et inconnu de l'application | URL générées dans la page, réglage du base path |
Erreur CORS dans la console, alors que curl répond | L'origine n'est pas autorisée, ou * est utilisé avec des identifiants | Réponse du pré-vol, en-tête Access-Control-Allow-Origin |
| Déconnexion au hasard avec plusieurs instances | Session gardée en mémoire d'une instance | Emplacement de la session |
Comment prouver la réparation dans un vrai navigateur ?
Section intitulée « Comment prouver la réparation dans un vrai navigateur ? »Deux de ces pannes ne se voient que dans un navigateur : le rejet d'un cookie et le refus CORS sont des décisions du navigateur, pas du serveur. Un test fait avec curl voit le Set-Cookie et un code 200, et conclut que tout va bien, alors que le navigateur a rejeté le cookie et empêché la page d'appeler l'API. Le lab de cette leçon pilote donc un vrai navigateur automatisé (Chromium, piloté par un script fourni), qui joue le parcours à la place d'un humain. Cela change la nature de la preuve : vous observez ce que l'utilisateur vivrait, pas ce que dit un en-tête.
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab réunit quatre des pannes de la leçon sur une petite application derrière un point d'entrée TLS : une connexion qui boucle, un cookie de session cantonné à un domaine qu'aucun navigateur n'acceptera, une politique d'origine qui dit oui à tout, et un en-tête d'identité que le point d'entrée répète depuis le client. Vous corrigez un seul fichier de politique et observez chaque effet avec le navigateur fourni. La validation mesure, dans ce navigateur, que la connexion aboutit en HTTPS sans boucle et que la page de compte affiche la session ; que l'origine partenaire lit la réponse de l'API alors que l'origine intruse ne le peut pas ; et qu'un en-tête d'identité forgé, sans session, n'est pas reconnu comme une identité par l'API. Les attributs Secure et SameSite sont enseignés ci-dessus mais ne sont pas mesurés par ce lab.
À retenir
Section intitulée « À retenir »- L'application apprend son URL publique du proxy ou d'un réglage : un en-tête ne corrige pas les URL qu'elle génère hors requête, ni celles d'un préfixe qu'elle ignore.
- Une boucle de redirection vient d'une application qui se croit en HTTP alors que le client est en HTTPS.
- Un cookie dont le
Domainest invalide est ignoré en silence par le navigateur : c'est dans ses outils qu'on le voit. Secure,HttpOnlyetSameSitese posent explicitement, etSameSiteréduit le risque de CSRF ; sansDomain, le cookie reste attaché à l'hôte émetteur.- L'état d'une session se place dans un stockage partagé ou dans un cookie signé ; l'affinité ne fait que cacher un état mal placé.
- CORS n'est pas un contrôle d'accès : il règle ce qu'une page d'une autre origine peut envoyer et lire, et
curljoint l'API sans en tenir compte. - Une identité se décide côté serveur : le point d'entrée supprime l'en-tête reçu du client et n'en pose un qu'après avoir validé une preuve.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Ces huit questions portent sur les gestes de la leçon : lire une URL générée, choisir un attribut de cookie, placer une session, interpréter CORS et refuser une identité forgée.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Diagnostic TLS : déboguer les erreurs SSL avec openssl
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications