Un flux long (WebSocket, SSE, gRPC) ne se publie pas comme une page : Nginx doit transmettre la poignée de main, ne rien retenir en tampon, parler le bon protocole au backend et attendre plus longtemps, sur ces routes seulement. Cette leçon s'adresse à une personne qui publie déjà une application derrière Nginx et qui voit une connexion temps réel se couper, arriver en retard ou ne jamais s'établir. Elle enseigne les directives de chaque transport, les délais côté backend et la façon de prouver qu'un flux fonctionne. Les délais de lecture de la requête par le client, client_body_timeout et client_header_timeout, relèvent de la leçon Nginx limites.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »La leçon traite les trois transports un par un, puis les délais qu'ils partagent.
- Transmettre une poignée de main WebSocket avec
UpgradeetConnection. - Livrer des événements SSE au rythme où le backend les émet, avec
proxy_buffering. - Publier un service gRPC avec
grpc_passet lire son statut sans le confondre avec le statut HTTP. - Allonger les délais de lecture et d'envoi vers le backend, route par route.
- Prouver qu'un flux fonctionne par une mesure de rythme et un échange dans les deux sens.
Prérequis
Section intitulée « Prérequis »La leçon suppose que vous savez déjà relayer une requête vers un backend et lire un échange HTTP.
- Publier une application avec
proxy_pass: Publier une application avec Nginx. - Lire une requête, une réponse et leurs en-têtes : Lire HTTP avant de configurer un proxy.
- Valider et recharger une configuration (
nginx -t,systemctl reload nginx) : Installer Nginx. - Une machine Debian 13 avec
sudo, où Nginx 1.31.8 est installé depuis le dépôt de l'éditeur (nginx.org) : la configuration vit dans/etc/nginx/conf.d/et les workers tournent sous l'utilisateurnginx.
Pourquoi un proxy HTTP ordinaire casse-t-il les flux longs ?
Section intitulée « Pourquoi un proxy HTTP ordinaire casse-t-il les flux longs ? »Un proxy configuré pour des pages suppose une requête courte, une réponse qui se termine, et un échange qui tient en quelques secondes ; un flux long viole ces trois hypothèses. Un WebSocket est une connexion qui, après une poignée de main (un premier échange HTTP ordinaire où le client demande à changer de protocole), devient un canal bidirectionnel où les deux côtés envoient des messages quand ils veulent. Le SSE (Server-Sent Events) est une réponse HTTP qui ne se termine pas : le serveur y écrit des événements au fil du temps. gRPC est un protocole d'appels de procédure qui circule sur HTTP/2.
Chacun exige quelque chose de différent du proxy, et c'est ce qui rend le diagnostic déroutant : le même Nginx peut très bien servir les pages du site et échouer sur ces trois routes, chacune pour une raison propre.
| Transport | Ce qu'il exige de Nginx | Symptôme quand c'est absent |
|---|---|---|
| WebSocket | Transmettre Upgrade et Connection au backend | La poignée de main n'aboutit pas, ou aboutit sans que rien ne circule |
| SSE | Ne rien mettre en tampon | Les événements arrivent tous ensemble à la fin |
| gRPC | HTTP/2 côté client (http2 on;), grpc_pass vers le backend | L'appel échoue au niveau du transport |
| Les trois | Un délai de lecture plus long que le silence normal du flux | La connexion se coupe en pleine conversation |
La dernière ligne du tableau est la plus insidieuse. Nginx ne ferme pas une connexion parce qu'elle dure, mais parce qu'aucune donnée n'a circulé pendant le délai. Un flux qui reste silencieux dix secondes, sous un délai de lecture réglé à dix secondes, est coupé alors que rien n'est cassé.
Comment faire passer un WebSocket avec Upgrade et Connection ?
Section intitulée « Comment faire passer un WebSocket avec Upgrade et Connection ? »Pour un WebSocket, Nginx doit retransmettre les en-têtes Upgrade et Connection du client, qu'il supprime sinon. Ces deux en-têtes sont dits hop-by-hop : ils décrivent la connexion entre deux maillons voisins, pas la requête de bout en bout, et un proxy ne les propage donc pas de lui-même. Or c'est précisément Upgrade: websocket qui demande au backend de basculer le protocole. Sans lui, le backend répond comme à une requête ordinaire.
Voici un location de WebSocket pour une application temps réel fictive qui écoute sur le port 9000.
# Dans le contexte http, hors de tout servermap $http_upgrade $connexion_upgrade {    default upgrade;    ''      close;}
server {    listen 80;    server_name temps-reel.lab.test;
    location /live/ {        proxy_pass http://127.0.0.1:9000;        proxy_set_header Upgrade $http_upgrade;        proxy_set_header Connection $connexion_upgrade;        proxy_set_header Host $host;    }}
Le bloc map calcule la valeur de Connection à partir de Upgrade. Si le client envoie un Upgrade, Nginx transmet Connection: upgrade ; s'il n'en envoie pas, il transmet Connection: close. C'est la réponse au piège classique : écrire proxy_set_header Connection "upgrade"; en dur, comme on le trouve partout, force la bascule de protocole sur toute requête qui traverse ce location, y compris celles qui n'en demandent aucune. Cela fonctionne tant que la route ne sert que du WebSocket, mais ce n'est pas un modèle universel.
Aucune directive proxy_http_version n'est nécessaire : Nginx 1.31.8 parle HTTP/1.1 à ses backends par défaut, et c'est cette version du protocole qui connaît le mécanisme Upgrade. Sur cette route, le map ci-dessus décide seul de la valeur de Connection envoyée. Les connexions persistantes vers les backends sont actives d'office, mais elles ne concernent pas cette route : une fois la bascule faite, la connexion devient un tunnel dédié à un seul client. Elles sont détaillées dans la leçon Répartir la charge avec upstream.
Si le site est servi en HTTPS, le client utilise wss:// et c'est le server en listen 443 ssl décrit dans Nginx TLS qui déchiffre le trafic avant ce location (la terminaison TLS) : la configuration ci-dessus ne change pas.
Comment vérifier qu'un WebSocket fonctionne vraiment ?
Section intitulée « Comment vérifier qu'un WebSocket fonctionne vraiment ? »La poignée de main réussie est la moitié de la preuve ; l'autre moitié est un message qui revient. Un 101 Switching Protocols montre que le backend a accepté la bascule, pas que les trames circulent ensuite. Une connexion établie qui ne transporte rien est la version la plus difficile à diagnostiquer de ce défaut, parce que tout paraît en ordre côté client comme côté serveur, et que seul l'échange fait défaut.
Pour la poignée de main seule, curl suffit : il envoie les en-têtes de bascule et affiche la réponse.
curl -i -N --max-time 5 \ -H 'Connection: Upgrade' \ -H 'Upgrade: websocket' \ -H 'Sec-WebSocket-Version: 13' \ -H 'Sec-WebSocket-Key: dGhlIHNhbXBsZSBub25jZQ==' \ http://temps-reel.lab.test/live/La première ligne de la réponse doit être HTTP/1.1 101 Switching Protocols. Un 400, un 200 ou une réponse de page signifie que l'Upgrade n'est pas arrivé au backend. Le test du lab va plus loin : il envoie une trame (un message WebSocket) de texte après la poignée de main et exige que le backend la renvoie, ce que curl ne sait pas faire. Un client WebSocket réel, ou un court script, devient alors nécessaire pour la seconde moitié.
Comment livrer un flux SSE sans que Nginx le retienne ?
Section intitulée « Comment livrer un flux SSE sans que Nginx le retienne ? »Un flux SSE exige proxy_buffering off; sur sa route : avec le tampon actif, tous les événements arrivent, mais ensemble et trop tard. La mise en tampon (buffering) est le comportement par défaut de Nginx : il lit la réponse du backend aussi vite que possible, la range en mémoire, puis la distribue au client à son rythme. C'est excellent pour une page, parce que le backend est libéré tout de suite. C'est fatal pour un flux, parce que Nginx attend d'avoir assez de données avant d'écrire vers le client.
Regardez le schéma de haut en bas. Dans le premier cas, le backend émet trois événements espacés d'une seconde et le client ne reçoit rien avant que Nginx décide de vider son tampon. Dans le second cas, chaque événement ressort dès qu'il entre.
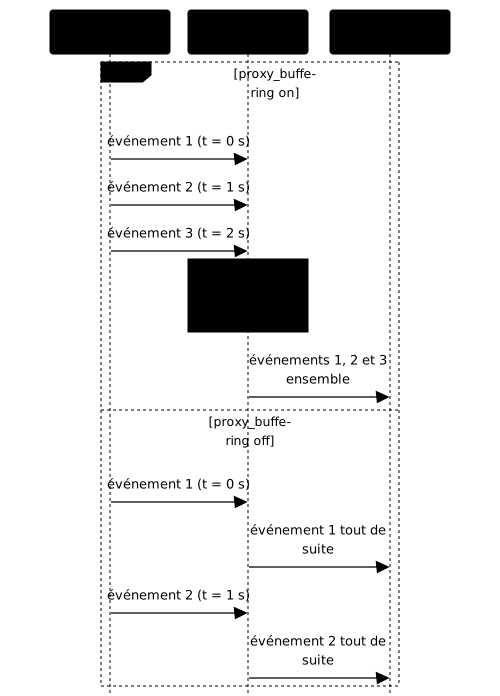
La correction tient en une directive, posée dans le location du flux et non au niveau du server ou de http.
location /evenements/ { proxy_pass http://127.0.0.1:9001; proxy_buffering off;}Le choix du contexte compte autant que la directive. Le tampon reste utile pour toutes les autres routes, qui servent des pages et libèrent leur backend rapidement : le désactiver globalement dégrade tout le reste pour réparer une seule route. Une alternative existe côté application : un backend qui répond avec l'en-tête X-Accel-Buffering: no demande à Nginx de ne pas mettre cette réponse en tampon, ce qui laisse la décision à l'application. Les deux se combinent.
Pourquoi ce défaut passe-t-il les tests naïfs ?
Section intitulée « Pourquoi ce défaut passe-t-il les tests naïfs ? »Un test qui compte les événements reçus passe au vert avec un proxy qui retient tout, parce que les événements finissent par arriver. Ce qui distingue un flux d'un lot est le rythme. La validation du lab mesure donc un délai d'arrivée : le backend émet six événements, un par seconde, et elle chronomètre le temps nécessaire pour en recevoir soixante octets, soit les deux premiers, qui doit rester sous quatre secondes. Sans tampon ce temps vaut environ deux secondes : une pour le rythme du backend, une seconde pour que curl s'aperçoive que head est parti. Avec un tampon, rien n'arrive avant la fin du flux, donc six secondes.
Le seuil de quatre secondes sépare donc bien les deux cas, et le lab a raison d'employer cette commande pour son backend : avec ses événements de trente-six octets, deux secondes et six secondes tombent de part et d'autre du seuil. La portée de ce réglage s'arrête là. Avec des événements deux fois plus courts, la commande rendrait quatre secondes sans aucun tampon, le seuil serait atteint, et le verdict basculerait du mauvais côté.
Vous pouvez mesurer la même chose à la main, en mieux : plutôt que d'attendre un nombre d'octets, visez le premier octet. %{time_starttransfer} le rapporte directement, sans dépendre de la taille des événements. Les trois autres options servent à ne mesurer que cela : -s tait la barre de progression, -o /dev/null jette le corps puisqu'on ne veut que le chronomètre, et --max-time 20 borne l'attente, un flux d'événements ne se terminant pas de lui-même.
curl -sN --max-time 20 -o /dev/null \ -w 'premier octet : %{time_starttransfer}s\n' \ http://temps-reel.lab.test/evenements/Sans tampon sur Nginx, la valeur reste sous la seconde ; avec un tampon, elle monte à six secondes environ pour ce flux de six événements, le temps que le backend finisse d'émettre.
N'utilisez pas time curl … | head -c 60 pour cette mesure, même si la tournure est répandue : time chronomètre le pipeline entier, et curl ne s'arrête qu'à sa première écriture après la sortie de head. La raison tient en une phrase : head attend soixante octets, donc plusieurs événements, et curl ne l'apprend qu'à l'événement suivant. Ce que cette commande rend dépend donc de la taille des événements et non du proxy : avec les trente-six octets du lab, environ deux secondes ; avec des événements deux fois plus courts, quatre secondes, mesurées au banc, alors que le premier octet était arrivé tout de suite, et l'on conclut à un tampon qui n'existe pas.
Une précision sur -N : avec -o /dev/null, il ne change pas la valeur mesurée, puisque le corps n'est pas affiché. Il redevient nécessaire dès que vous retirez -o /dev/null pour voir les événements arriver, car curl met alors sa propre sortie en tampon.
Un dernier point sur le SSE : une absence de données n'est pas une fermeture. Un flux d'événements peut rester muet longtemps entre deux changements d'état, et c'est le délai de lecture, vu plus bas, qui décide si Nginx coupe ce silence. Les serveurs SSE émettent souvent une ligne de commentaire (une ligne commençant par :, que le client ignore) à intervalle régulier, pour que la connexion ne paraisse jamais inactive.
Comment faire passer gRPC avec grpc_pass ?
Section intitulée « Comment faire passer gRPC avec grpc_pass ? »gRPC se publie avec grpc_pass et non proxy_pass, sur un server où http2 on; active HTTP/2. gRPC transporte ses appels sur HTTP/2, la version du protocole qui multiplexe plusieurs échanges sur une seule connexion et qui sait envoyer des trailers, des en-têtes placés après le corps. gRPC y place son statut. Un proxy HTTP/1 ne sait faire ni l'un ni l'autre, d'où l'échec.
HTTP/2 s'active par la directive http2 on; (contextes http et server, défaut off, disponible depuis la 1.25.1) ; le paramètre http2 de listen est déprécié. Voici un service gRPC fictif qui écoute en clair sur le port 50052, publié sur son propre port.
server {    listen 50051;    http2 on;    server_name grpc.lab.test;
    location /catalogue.Stock/ {        grpc_pass grpc://127.0.0.1:50052;    }}
Deux choix se lisent dans cet exemple. Le préfixe grpc:// indique un backend en clair (HTTP/2 sans TLS, souvent appelé h2c) ; grpcs:// en désignerait un chiffré. Et le service a son propre server sur son propre port : le mêler au site HTTP/1 obligerait à choisir, sur un même listen, entre deux protocoles qui ne se parlent pas de la même façon. Le chemin du location est celui de la méthode gRPC, de la forme /paquet.Service/Methode.
Comment lire un statut gRPC sans le confondre avec le statut HTTP ?
Section intitulée « Comment lire un statut gRPC sans le confondre avec le statut HTTP ? »Un appel gRPC rendu par un refus applicatif porte un code HTTP 200, et c'est un statut gRPC, placé dans les trailers, qui dit ce qui s'est passé. Les deux statuts sont distincts : le premier dit que la requête HTTP s'est bien déroulée, le second dit ce que l'application en a fait. Même un appel réussi répond :status 200 et porte son grpc-status dans les trailers. INVALID_ARGUMENT signifie que la requête est refusée parce que son contenu est invalide, UNAVAILABLE que le service ne peut pas répondre pour l'instant.
La différence a une conséquence pratique forte. Un client gRPC n'a pas de politique de nouvelle tentative par défaut : c'est la configuration du client qui liste les codes à rejouer, et UNAVAILABLE, qui peut réussir la fois suivante, y figure typiquement ; un INVALID_ARGUMENT, qui échouera toujours, n'a aucune raison d'y figurer. Si le proxy transforme le second en premier, un client ainsi configuré peut rejouer une requête qui n'aboutira jamais, et charger le backend pour rien. Le lab le mesure donc des deux côtés : un appel normal doit aboutir, et un appel dont la charge provoque un refus applicatif doit revenir comme un refus, pas comme une panne de transport. Le client fourni par le lab, client-grpc, imprime ok, erreur ou transport selon ce qu'il observe, ce qui rend la distinction lisible sans lire un seul octet de trailer.
Quels délais allonger, et pour quelles routes seulement ?
Section intitulée « Quels délais allonger, et pour quelles routes seulement ? »Les délais vers le backend se règlent route par route : un flux long a besoin d'un proxy_read_timeout plus grand qu'une page, et l'accorder à tout le site laisse des connexions mortes s'accumuler. Deux délais gouvernent ce que Nginx attend du backend : proxy_read_timeout borne le temps d'attente entre deux lectures consécutives sur la connexion vers le backend, et proxy_send_timeout celui entre deux écritures. Leur valeur par défaut est de 60 secondes. Pour gRPC, les directives équivalentes s'appellent grpc_read_timeout et grpc_send_timeout.
Le mot décisif est « entre deux ». Ce délai ne limite pas la durée totale de la connexion : il se réinitialise à chaque donnée reçue. Un flux qui émet un événement toutes les trente secondes ne se coupe jamais sous un délai de soixante, alors qu'un WebSocket silencieux pendant une minute est fermé. La documentation de Nginx le dit pour le WebSocket : par défaut, la connexion se ferme si le backend ne transmet aucune donnée pendant 60 secondes.
location /live/ {    proxy_pass http://127.0.0.1:9000;    proxy_set_header Upgrade $http_upgrade;    proxy_set_header Connection $connexion_upgrade;
    # Valeurs propres à cette route : un échange peut se taire un moment    proxy_read_timeout 1h;    proxy_send_timeout 1h;}
Pour choisir la valeur, partez du plus long silence normal du flux : l'intervalle entre deux messages, ou le battement (ping) que l'application s'impose, plus une marge. Une heure n'est pas un chiffre universel, c'est un exemple pour une application qui peut se taire longtemps. Un chiffre énorme « pour être tranquille » transforme une protection en risque.
La raison de cette prudence est l'effet inverse. Quand un backend ferme proprement la connexion, Nginx s'en aperçoit tout de suite et libère le client, quelle que soit la valeur du délai. Mais quand le backend disparaît sans prévenir (machine éteinte, câble coupé), Nginx n'a aucun signal de fermeture à lire. Il ne lui reste alors, par défaut, que deux issues : une écriture vers le backend qui échoue, ou le délai qui expire. En effet, proxy_socket_keepalive, qui active le keepalive TCP vers le backend (des sondes périodiques qui détectent un correspondant disparu), est à off par défaut.
Avec un délai réglé à vingt-quatre heures, la connexion vers un backend mort peut donc rester ouverte jusqu'à vingt-quatre heures, si aucune écriture ne l'a fait échouer avant. Multipliée par chaque client, cette connexion orpheline peut finir par épuiser le proxy, et le symptôme apparaît des semaines après sous la forme « le site est lent ». Ce comportement dépend du moment et de la manière dont le backend disparaît : ne le tenez pas pour acquis avant de l'avoir observé. Le geste qui le constate est un comptage des connexions établies, ss -tn state established '( sport = :80 )' : leur nombre ne doit pas rester gonflé. Ce n'est pas ce que mesure le lab. Sa dernière épreuve prend le problème par l'autre bout, le silence : un flux se tait quinze secondes là où le réglage de départ coupe à dix, et il doit survivre. C'est la même nuance qu'au paragraphe précédent, un flux bavard ne déclenchant jamais proxy_read_timeout, si bien que le défaut reste invisible jusqu'au jour où la conversation n'a rien à dire.
Quand c'est le client qui part, la situation est inverse : proxy_ignore_client_abort est à off par défaut, et Nginx ferme alors sa connexion vers le backend. Le backend peut ainsi être prévenu qu'un abonné SSE a disparu et cesser d'émettre pour lui, mais cela reste à observer : la documentation décrit le client qui part sans attendre de réponse, alors qu'un abonné SSE part en cours de réponse, et c'est le comportement de votre backend qui dit s'il s'arrête.
Quelle différence entre délais côté client et côté backend ?
Section intitulée « Quelle différence entre délais côté client et côté backend ? »Les délais côté client protègent Nginx d'un client lent ; les délais côté backend décident combien de temps Nginx attend un serveur silencieux. Ce sont des directives différentes, pour des menaces différentes, et les confondre conduit à régler la mauvaise.
| Question | Directive | Où se règle-t-elle |
|---|---|---|
| Un client envoie-t-il son corps trop lentement ? | client_body_timeout | Nginx limites |
| Un client lit-il la réponse trop lentement ? | send_timeout (60 secondes par défaut) | Hors périmètre de cette leçon et de Nginx limites |
| Le backend se tait-il trop longtemps ? | proxy_read_timeout, grpc_read_timeout | Cette leçon |
| Nginx écrit-il trop lentement vers le backend ? | proxy_send_timeout, grpc_send_timeout | Cette leçon |
Cette leçon ne règle ni la taille des requêtes ni le débit : ces limites appartiennent à la leçon Nginx limites, qui détaille les limites de charge à poser sur une route.
Quel symptôme pointe vers quelle cause ?
Section intitulée « Quel symptôme pointe vers quelle cause ? »Chaque transport tombe en panne d'une façon reconnaissable : lisez le symptôme avant de modifier quoi que ce soit. Le tableau croise ce que vous observez avec la cause la plus probable dans le cadre de cette leçon, et la vérification qui la confirme.
| Symptôme | Cause probable | Vérification |
|---|---|---|
| Le client WebSocket échoue à l'ouverture | Upgrade ou Connection non transmis au backend | Le curl d'en-têtes de bascule doit rendre un 101 |
| Le WebSocket s'ouvre puis plus rien ne circule | Les trames ne reviennent pas : backend muet, ou connexion coupée par un délai trop court | Envoyer une trame et attendre son retour, pas seulement le 101 |
| Les événements SSE arrivent tous ensemble | proxy_buffering actif sur cette route | curl -sN -w '%{time_starttransfer}' : plusieurs secondes |
| Le flux se coupe à intervalle fixe | proxy_read_timeout inférieur au silence normal | Comparer l'intervalle de coupure à la valeur du délai |
| L'appel gRPC échoue avec une erreur de transport | proxy_pass au lieu de grpc_pass, ou http2 on; absent | nginx -t, puis le client du lab doit imprimer ok |
| Un refus applicatif revient comme panne | Passage par un proxy HTTP ordinaire | Le client du lab doit imprimer erreur sur la charge de refus |
| Le proxy ralentit des semaines après | Connexions orphelines, délais trop longs | Compter les connexions établies avant et après une coupure du backend |
Un symptôme n'a souvent qu'une cause dans ce tableau, mais deux défauts peuvent cohabiter : un WebSocket corrigé n'est pas pour autant protégé d'un délai trop court. Corrigez une chose, vérifiez, puis passez à la suivante, comme le fait la validation du lab.
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab pose trois transports derrière un Nginx qui les traite tous comme des pages : un WebSocket, un flux SSE de six événements espacés d'une seconde, et un service gRPC sur un port dédié. Vous corrigez la configuration jusqu'à ce que la poignée de main WebSocket aboutisse et qu'une trame revienne, que les premiers événements SSE arrivent en moins de quatre secondes, qu'un appel gRPC passe et qu'un refus applicatif reste un refus, puis qu'un flux resté silencieux quinze secondes survive au délai de lecture.
La validation note ces quatre mesures sur le comportement du proxy, pas sur les directives que vous avez tapées : vous pouvez donc la rejouer après chaque modification.
Un détail de l'énoncé du lab demande grpc_pass sur un server dont le listen porte http2, la forme dépréciée. Elle reste acceptée, au prix d'un avertissement que nginx -t affiche, et le lab la valide comme l'autre puisqu'il mesure le comportement du service : écrivez http2 on;, qui est la forme de cette leçon.
À retenir
Section intitulée « À retenir »- Un flux long viole les hypothèses d'un proxy de pages : requête courte, réponse qui se termine, échange rapide. Chaque transport exige autre chose.
- WebSocket :
UpgradeetConnectionretransmis, car ce sont des en-têtes hop-by-hop que Nginx supprime sinon. HTTP/1.1 vers le backend est le défaut. - Un
mapsur$http_upgradeévite de forcerConnection: upgradesur toute requête, ce qui n'est pas un modèle universel. - SSE :
proxy_buffering off;dans lelocationdu flux seulement. Le tampon ne perd aucun événement, il détruit leur rythme. - gRPC :
grpc_passethttp2 on;sur son propreserver. Un refus applicatif ne doit jamais devenir une panne de transport, sans quoi un client configuré pour réessayer rejoue une requête vouée à l'échec. - Les délais
proxy_read_timeoutetgrpc_read_timeoutmesurent le silence entre deux lectures, pas la durée de la connexion. Réglez-les par route, à partir du plus long silence normal. - Un délai démesuré peut garder ouvertes les connexions vers un backend disparu sans prévenir : mesurez les connexions établies avant et après une coupure.
- Une preuve de flux se prend sur le rythme et sur l'échange dans les deux sens, jamais sur le seul nombre d'événements ou la seule poignée de main.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de ce guide est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Nginx cache : prouver qu'aucune réponse privée ne fuite
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications