Avec Traefik 3.7.15, on bascule un service de v1 vers v2 en limitant les
erreurs, grâce à un poids sur chaque serveur d'un même service et à une sonde
de santé sur ce service ; en revanche, rien de tout cela ne protège le point
d'entrée lui-même : deux Traefik sur la même machine tombent ensemble avec
elle. Cette
leçon s'adresse à qui publie déjà un service derrière Traefik et se demande
« est-ce disponible ? ». Elle sépare deux questions que l'on mélange souvent :
la bascule des backends (changer de version sans interrompre les clients) et
la panne du point d'entrée (que devient le service quand Traefik, ou son
hôte, disparaît). Elle dit aussi, sans détour, ce qu'un lab sur une seule
machine ne peut pas prouver.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »La leçon suit l'ordre d'un changement de version : déplacer, surveiller, puis se demander ce qui arrive si le proxy lui-même tombe.
- Déplacer le trafic de
v1versv2avec des poids, et mesurer les erreurs. - Revenir à
v1sans intervention quandv2est retirée de la rotation. - Distinguer la perte d'un processus Traefik de la perte de son hôte.
- Dire ce que prouve un lab sur une seule machine, et ce qu'il ne prouve pas.
- Éviter qu'une rotation de certificat concurrente dépareille la paire.
Prérequis
Section intitulée « Prérequis »La leçon suppose que vous savez écrire une route Traefik dans un fichier et lire un code HTTP. Le lab fournit la machine, les backends et le client.
- Le modèle de Traefik (point d'entrée, router, service) : Traefik : entrypoints, routers, services et middlewares.
- Le fichier dynamique relu à chaud : le fournisseur fichier.
- La sonde de santé, ses paramètres et le retry, que cette leçon ne répète pas : Maîtriser santé, délais et flux avec Traefik.
- La mise à jour de Traefik lui-même et son retour arrière : Monter de version Traefik.
Quelles pannes une bascule de backend traite-t-elle, et lesquelles lui échappent ?
Section intitulée « Quelles pannes une bascule de backend traite-t-elle, et lesquelles lui échappent ? »Une bascule de backend traite les pannes qui se produisent derrière Traefik ; une panne de Traefik lui-même n'est couverte par aucun réglage de backend. Un backend est le serveur d'application qui se trouve derrière le proxy. Une bascule est le déplacement progressif ou brusque du trafic d'une version vers une autre. Ces deux gestes se règlent dans la configuration de Traefik : poids des serveurs, sonde de santé.
Un point de défaillance unique (single point of failure) est un élément dont la panne arrête tout le service parce que rien ne peut le remplacer. Le point d'entrée en est un tant qu'il est seul : tout le trafic passe par lui. Vous pouvez avoir dix backends sains et redondants, le client ne voit rien du tout si le seul Traefik est arrêté.
Un point d'entrée désigne, dans cette leçon, un processus Traefik qui
reçoit les connexions des clients sur ses ports d'écoute. Ne le confondez
pas avec la section entryPoints de la configuration, qui déclare ces ports :
quand elle apparaît, elle est nommée telle quelle.
Un domaine de panne est l'ensemble de ce qui tombe en même temps quand un élément défaille. Le processus Traefik en forme un, l'hôte qui le porte en forme un autre, plus large. La page sœur sur HAProxy pose le même cadre ; cette leçon l'applique à Traefik, en traitant d'abord la bascule, puis la panne du point d'entrée.
Comment déplacer le trafic de v1 vers v2 avec des poids ?
Section intitulée « Comment déplacer le trafic de v1 vers v2 avec des poids ? »On déplace le trafic en listant v1 et v2 comme deux serveurs d'un même
loadBalancer, chacun avec un weight : plus le poids est grand, plus le
serveur reçoit de requêtes. Le poids (weight) est un entier attaché à un
serveur. D'après la documentation de Traefik 3.7, la stratégie par défaut,
wrr (Weighted Round Robin, tourniquet pondéré), répartit les requêtes entre
les serveurs en respectant ces poids.
# FRAGMENT : service du fichier dynamique, routers et tls non montréshttp: services: app: loadBalancer: servers: - url: http://pub-zds-app-v1:8080 weight: 3 - url: http://pub-zds-app-v2:8080 weight: 1Au départ du lab, le service app ne cite que v1, câblé en dur. Le bloc
ci-dessus le remplace par deux serveurs ; pour avancer, vous augmentez le poids
de v2 et vous diminuez celui de v1, puis vous recommencez. Le fichier
dynamique est relu à chaud par les deux points d'entrée du lab : aucun
redémarrage n'est nécessaire pour changer un poids. Les poids 3 et 1 sont
un exemple, pas une recommandation.
Le test du lab échantillonne 40 requêtes et exige au moins 5 réponses de
chaque version. Une part de 10 % pour v2 (des poids 9 et 1) donnerait
environ 4 réponses sur 40, sous ce seuil : c'est une contrainte du test. Ni ces
poids ni les poids 3 et 1 n'ont été mesurés ici. Le même test tolère
2 erreurs au plus sur l'échantillon : le critère est une erreur bornée, pas
une erreur nulle (la dernière section de la leçon y revient).
Le lab impose aussi la forme : deux serveurs d'un même service, et non le
type weighted, qui combine plusieurs services nommés (des sous-services)
et donne un poids à chacun. Le scénario du lab affirme que ce second type ne
retire jamais un sous-service malsain dans Traefik v3 : c'est trop absolu.
La documentation de la 3.7 décrit un healthCheck propre au type weighted :
quand un de ses enfants est signalé hors service, le service weighted l'ignore.
Le code de la 3.7.15 (fichier pkg/server/service/service.go du dépôt Traefik)
ne câble ce signal que si le service weighted déclare lui-même un
healthCheck, ce qui exige que tous ses descendants en aient un, et la
documentation ne le prévoit que pour le fournisseur fichier. Sans ce
healthCheck, un sous-service malade reste dans la rotation. La forme du lab
reste la plus simple pour cette leçon, mais pas la seule qui retire un serveur
malade. Ce point a été lu à la source, pas rejoué.
Comment revenir à v1 sans intervention humaine ?
Section intitulée « Comment revenir à v1 sans intervention humaine ? »Le retour arrière automatique repose sur une sonde de santé placée dans le
loadBalancer : elle retire de la rotation le serveur qui échoue, et le trafic
retourne seul vers v1. Une sonde de santé (healthCheck) interroge
périodiquement une route de chaque serveur ; une rotation est l'ensemble des
serveurs entre lesquels Traefik répartit les requêtes. Les paramètres de la
sonde (path, interval, timeout) et la durée de sa fenêtre de détection
sont l'objet de la leçon Santé, délais et flux ;
ils ne sont pas répétés ici.
# FRAGMENT : à ajouter sous loadBalancer, à côté de servers healthCheck: path: /health interval: 2sDans le lab, vous simulez la panne de v2 en supprimant son marqueur
/app/healthy avec docker exec pub-zds-app-v2 rm /app/healthy. Le backend
répond alors 503 sur /health et 500 sur ses autres routes. Le test attend
au plus une quinzaine d'essais espacés d'une seconde que v2 disparaisse de
l'échantillon sans aucune erreur, puis restaure le marqueur et vérifie que v2
reçoit de nouveau du trafic. La sonde doit donc faire deux choses : retirer
un serveur malade, et le réintégrer quand il redevient sain.
Une limite se lit dans ce critère : le test attend un état propre, il ne
mesure pas ce qui se passe pendant la fenêtre de détection. Tant que la
prochaine passe de la sonde n'a pas eu lieu, v2 malade reste dans la rotation
et peut produire des erreurs. Réduire l'intervalle rétrécit la fenêtre sans la
supprimer, et un mécanisme de nouvelle tentative a ses propres risques, traités
dans la leçon sur la santé et les délais.
Qu'est-ce que le drainage, et que fait Traefik quand il s'arrête ?
Section intitulée « Qu'est-ce que le drainage, et que fait Traefik quand il s'arrête ? »Le drainage consiste à cesser d'envoyer de nouvelles requêtes à un composant
tout en laissant finir celles qui sont en cours ; Traefik le fait pour lui-même
grâce à deux délais réglés dans la section entryPoints de sa configuration.
Pour un backend, drainer revient à le sortir de la rotation avant de l'arrêter.
La sonde le fait après coup, quand elle juge le serveur malade ; elle ne
l'anticipe pas quand vous décidez de l'éteindre pour une mise à jour. Le lab ne
mesure pas ce second cas.
Pour Traefik lui-même, la référence des entryPoints de la 3.7 documente
transport.lifeCycle.graceTimeOut et transport.lifeCycle.requestAcceptGraceTimeout.
Le premier est la durée accordée aux requêtes actives pour se terminer avant
l'arrêt gracieux (l'arrêt qui laisse finir le travail en cours au lieu de
couper net), soit 10 secondes par défaut ; la documentation précise que,
pendant ce délai, aucune nouvelle requête n'est acceptée.
Le second, un délai d'acceptation, est la durée pendant laquelle Traefik continue d'accepter des requêtes avant de lancer cet arrêt gracieux (0 seconde par défaut) ; la documentation l'explique par le besoin de laisser le temps à un répartiteur situé en amont (un équipement ou un service placé devant Traefik) de retirer Traefik de sa rotation.
# FRAGMENT : fichier STATIQUE de Traefik, redémarrage nécessaireentryPoints: websecure: address: ":443" transport: lifeCycle: requestAcceptGraceTimeout: 5s graceTimeOut: 15sCes valeurs sont un exemple pour lire les noms d'options, pas une mesure : le lab ne les teste pas. Elles concernent l'arrêt volontaire, par exemple lors d'une montée de version. Elles ne changent rien à une panne brutale, où personne n'a eu le temps de drainer.
Que devient le service quand un point d'entrée tombe ?
Section intitulée « Que devient le service quand un point d'entrée tombe ? »Si un point d'entrée Traefik tombe alors qu'un second tourne, ce dernier
continue de répondre ; si les deux partagent la même machine, la perte de la
machine les emporte ensemble. Le lab démarre deux points d'entrée
jumeaux, pub-zds-entry-a et pub-zds-entry-b, qui lisent la même
configuration dynamique et servent le même certificat. Ils écoutent sur deux
ports différents de la même machine edge.lab. Le client de mesure, poste.lab,
interroge chacun depuis l'extérieur.
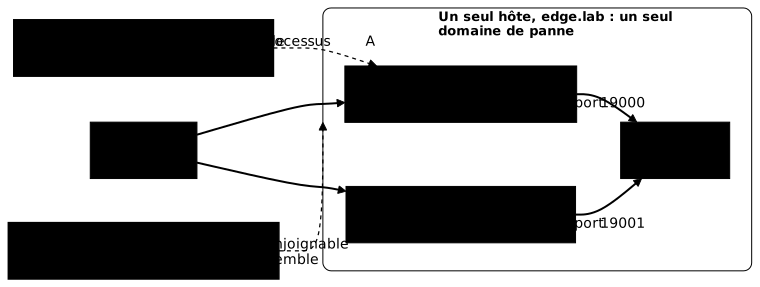
Regardez d'abord le cadre : il entoure les deux points d'entrée et les backends, parce qu'ils partagent un hôte. La première flèche en pointillé ne vise que le point d'entrée A ; la seconde vise le cadre entier. Voilà tout l'écart entre les deux pannes.
Le lab vous demande de les provoquer pour de vrai et d'écrire votre
conclusion dans /home/student/domaine-de-panne.yaml, avec deux clés,
perte_processus et perte_hote, qui prennent chacune la valeur survit ou
ne_survit_pas. Ici, survit veut dire « l'autre point d'entrée répond
encore », pas « le client n'a rien remarqué ». La consigne est de ne pas
deviner : d'après le scénario, prétendre à une résilience que le lab n'a pas est
pire que d'en admettre la limite.
Les deux gestes du test sont les suivants. Pour la perte d'un processus, il
arrête le conteneur pub-zds-entry-a avec docker stop, puis interroge les
deux ports depuis poste.lab : A ne doit plus répondre 200, B doit répondre
200. Pour la perte de l'hôte, il bloque les deux ports de la machine avec
une règle iptables (le pare-feu de Linux), posée très tôt sur le trajet des
paquets : table raw, chaîne PREROUTING. Selon les commentaires du test, une
règle ordinaire sur la chaîne INPUT ne verrait pas ce trafic, parce que
Docker a déjà aiguillé le paquet vers le conteneur avant qu'il n'atteigne
cette chaîne. Le test retire la règle ensuite.
Que prouve le lab sur la panne du point d'entrée, et que ne prouve-t-il pas ?
Section intitulée « Que prouve le lab sur la panne du point d'entrée, et que ne prouve-t-il pas ? »Le lab prouve qu'un second processus Traefik continue de répondre quand le premier s'arrête, et que bloquer les deux ports d'un même hôte rend les deux points d'entrée injoignables ; il ne prouve ni la bascule d'un client, ni la survie à une vraie panne de machine. C'est la limite qu'il faut savoir énoncer, parce qu'elle sépare une démonstration d'une garantie. Le scénario du lab la dit lui-même : les deux points d'entrée partagent un seul domaine de panne, ce que le lab demande d'observer et non de contourner.
| Le lab démontre | Le lab ne démontre pas |
|---|---|
| Le point d'entrée B répond quand le processus A est arrêté | Qu'un client passe de A à B sans qu'on le lui dise |
Deux ports bloqués rendent A et B injoignables depuis poste.lab | Qu'une machine réellement éteinte, ou un disque plein, se comporte de la même façon |
| Les deux pannes donnent deux résultats différents | Qu'une adresse unique puisse changer de machine |
A cesse de répondre 200 quand son processus est arrêté | Le temps de reprise réel d'un mécanisme de bascule |
Deux points méritent d'être soulignés. D'abord, le client du test interroge A puis B, chacun sur son port : aucun mécanisme du lab ne le fait passer seul de l'un à l'autre. Dire « B répond » ne dit donc pas « le client est servi ». Ensuite, bloquer deux ports par une règle réseau simule l'injoignabilité vue du client, pas la panne d'une machine : les processus tournent toujours, et c'est le test qui bloque lui-même les deux ports. Que les deux points d'entrée partagent leur sort vient donc de la construction du lab (une seule machine), pas d'une mesure ; le test ne mesure aucune reprise. Il compare aussi votre fichier à deux valeurs fixes : il ne juge pas votre raisonnement.
Comment survivre à la perte de l'hôte ?
Section intitulée « Comment survivre à la perte de l'hôte ? »Pour survivre à la perte d'un hôte, il faut au moins deux hôtes distincts, qui ne partagent pas à leur tour un même élément unique (hyperviseur, alimentation, réseau), et un moyen pour que les clients atteignent le second sans rien changer de leur côté. Redonder des conteneurs sur une seule machine ne supprime pas la panne de cette machine : c'est l'erreur que le lab fait toucher du doigt. Trois voies existent, avec chacune une limite.
Une adresse virtuelle (ou adresse flottante, VIP) est une adresse de service qui n'est câblée sur aucune machine en particulier : la machine élue la porte, et si elle tombe, une autre la reprend. Le protocole VRRP et le démon keepalived en sont la voie classique ; la leçon Tester la disponibilité du point d'entrée HAProxy enseigne le mécanisme complet, y compris son piège principal (surveiller le service et non la machine). Il n'a pas été rejoué avec Traefik ici : le principe n'est pas propre à un proxy, mais c'est un point à valider sur votre réseau.
Les deux autres voies sont un répartiteur amont (un équipement ou un service qui distribue les connexions devant les deux Traefik, et qui devient lui-même le point à protéger) et le DNS avec plusieurs adresses, dont le retrait d'une adresse morte dépend du cache des clients. Chacune de ces trois voies déplace le problème sans l'abolir : il faut savoir ce qui reste unique.
Un orchestrateur de conteneurs comme Kubernetes change le cadre : la page Traefik sur Kubernetes recommande de déployer plusieurs réplicas (copies d'un même programme) pour la haute disponibilité, ce que ce lab ne traite pas.
Comment partager un certificat entre deux points d'entrée sans le corrompre ?
Section intitulée « Comment partager un certificat entre deux points d'entrée sans le corrompre ? »Deux points d'entrée qui servent le même certificat doivent lire une paire
cohérente, et l'outil qui la renouvelle doit tenir quand deux exécutions
tournent en même temps. Dans le lab, les deux Traefik montent le même
répertoire de certificat en lecture seule, et un script,
/opt/pub-zds/outils/tourner-certificat.sh, le régénère. Écrit en supposant
qu'il ne tourne jamais deux fois à la fois, ce script dépose le certificat puis
la clé, ou l'inverse, avec une pause entre les deux : deux exécutions
simultanées peuvent laisser un certificat issu de l'une et une clé issue de
l'autre. Une paire dépareillée, dont le certificat et la clé ne se correspondent pas,
ne peut pas servir du TLS valide.
Le test lance deux exécutions en parallèle, plusieurs fois, puis exige que le
certificat et la clé soient lisibles et que leurs clés publiques coïncident. Il
exige enfin que les deux points d'entrée servent encore du TLS valide. À vous
de corriger le script. Le raisonnement à tenir est le suivant : renommer un
fichier est atomique (l'opération se fait en un bloc, sans état
intermédiaire visible), mais renommer deux fichiers l'un après l'autre ne forme
pas une opération unique, car une autre exécution peut s'intercaler. La
sérialisation, qui fait passer les exécutions l'une après l'autre grâce à un
verrou (l'outil flock, documenté par son manuel), est l'autre piste citée
par le lab. Choisir et vérifier est votre travail. Un verrou n'ordonne que les
écrivains entre eux : il n'empêche pas un lecteur de tomber entre deux écritures.
Dans le monde réel, partager un certificat entre instances se complique avec ACME, le protocole par lequel Let's Encrypt délivre et renouvelle des certificats automatiquement. La page ACME de la documentation de Traefik 3.7 écrit, dans la sous-section consacrée à Let's Encrypt avec le fournisseur Ingress de Kubernetes, qu'il n'est pas possible d'exécuter plusieurs instances avec Let's Encrypt activé, faute de garantie que la bonne instance reçoive le défi de validation, et recommande Traefik Enterprise pour cela. Cette sous-section est écrite pour la version 2.0 et n'a pas été vérifiée contre le comportement de la 3.7. Le script du lab est une représentation locale hors ligne de ce partage, pas un test d'ACME. Pour la gestion des certificats d'une seule instance, voir Traefik et HTTPS automatique.
Zéro erreur sur un test prouve-t-il zéro interruption ?
Section intitulée « Zéro erreur sur un test prouve-t-il zéro interruption ? »Non : un test borné prouve seulement que, sur cet échantillon, à cet instant et
avec cette charge, le nombre d'erreurs est resté dans la limite tolérée (2 au
plus ici) ; il ne garantit pas l'absence d'interruption sous une autre
charge. Les trois mesures de cette leçon ont chacune leur borne.
L'échantillon de 40 requêtes tolère 2 erreurs ; le retrait de v2 est jugé sur
un état propre atteint après quelques secondes ; la panne de l'hôte est une
règle réseau sur deux ports.
Ce qui reste invisible : une requête longue coupée par un arrêt, une charge plus forte qui allonge la fenêtre de détection de la sonde, une connexion déjà ouverte au moment de la panne (elle meurt avec le processus qui la portait, le client doit se reconnecter). Un test qui passe est une preuve limitée, qu'il faut nommer comme telle dans votre compte rendu. Écrire « testé sur 40 requêtes, 2 erreurs tolérées » dit la vérité ; écrire « zéro coupure » ne la dit pas.
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab part de deux points d'entrée Traefik jumeaux sur edge.lab, d'un backend
v1 en production et d'une candidate v2 saine. Vous construisez un chemin
progressif de v1 vers v2 avec deux serveurs pondérés, vous ajoutez la sonde
qui retire v2 quand elle est malsaine, vous provoquez les deux pannes depuis
poste.lab pour écrire un fichier de conclusion honnête, puis vous corrigez
l'outil de rotation de certificat. La validation mesure la répartition réelle du
trafic, le retrait puis la réintégration de v2, votre fichier de conclusion
comparé aux deux pannes que le test déclenche lui-même, et la cohérence de la
paire certificat et clé après des rotations concurrentes.
À retenir
Section intitulée « À retenir »La disponibilité d'un service derrière Traefik se juge à deux endroits : derrière le proxy, et sur le proxy lui-même.
- Une bascule de backend se règle par des poids sur les serveurs d'un même
loadBalancer; une sonde les retire et les réintègre. - Le critère de répartition du lab est une erreur bornée (2 sur 40 au plus), pas nulle ; la fenêtre de détection de la sonde n'est pas mesurée.
- Le drainage vaut pour un arrêt volontaire :
graceTimeOutetrequestAcceptGraceTimeouten sont les réglages, non testés ici. - Un point d'entrée seul est un point de défaillance unique ; deux sur le même hôte partagent un domaine de panne.
- Le lab prouve que B répond quand le processus A est arrêté, et que les deux points d'entrée deviennent injoignables quand leurs ports sont bloqués ; il ne prouve ni la bascule du client, ni une vraie panne de machine.
- Survivre à la perte d'un hôte demande deux hôtes et une adresse virtuelle, un répartiteur amont ou le DNS, chacun avec sa limite.
- Un outil de rotation de certificat doit tenir à deux exécutions simultanées : sérialiser ou rendre la publication atomique, ne pas supposer.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Ces questions vérifient que vous savez prévoir ce que chaque réglage couvre, et ce qu'il laisse découvert.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Épreuve Traefik niveau 1 : publier deux services en HTTPS
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications