Observer un Nginx qui sert de reverse proxy, c'est pouvoir dire pour chaque requête si le temps perdu ou l'erreur vient de Nginx ou de l'application derrière lui. Nginx open source ne le fait pas seul : il n'expose ni métriques Prometheus natives ni sondes actives. Cette leçon s'adresse à une personne qui publie déjà une application avec Nginx. Elle apprend à corréler (mettre en regard) la requête vue par le proxy avec celle vue par l'amont, c'est-à-dire l'application que Nginx interroge (upstream en anglais), à lire les compteurs de stub_status, le module de Nginx qui expose des totaux globaux, pour ce qu'ils valent, et à bâtir une alerte qui repose sur des données mesurées. La mise en place minimale du journal JSON se trouve déjà dans Protéger et observer Nginx : ici, on apprend à lire ce qu'il dit.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »La leçon part de ce que Nginx sait mesurer, puis monte vers l'alerte.
- Lister ce que Nginx open source permet d'observer, et ce qu'il ne permet pas.
- Interpréter
status,upstream_status,request_timeetupstream_response_time. - Écrire un
log_formatJSON échappé, avec un identifiant de requête et sans secret. - Lire les compteurs de
stub_statuset en tirer un débit. - Construire une alerte fondée sur les journaux et sur une sonde extérieure.
Prérequis
Section intitulée « Prérequis »Vous publiez déjà une application avec proxy_pass et vous savez lire un code de statut HTTP.
- Publier une application derrière Nginx : Publier une application avec Nginx.
- Le vocabulaire HTTP (méthode, en-tête, code de statut) : Lire HTTP avant de configurer un proxy.
- Valider et recharger une configuration, vérifier les modules compilés : Installer Nginx.
- Une machine Debian 13 avec
sudo.
Que peut-on observer avec Nginx open source ?
Section intitulée « Que peut-on observer avec Nginx open source ? »Nginx open source s'observe par trois voies : ses journaux, le module stub_status et un exportateur externe. Il n'a ni endpoint de métriques au format Prometheus intégré, ni sondes actives qui interrogent les backends à intervalle régulier : la directive health_check appartient à l'offre commerciale NGINX Plus, comme le rappelle la leçon Nginx upstream. Une configuration trouvée en ligne qui annonce des métriques « natives » vise donc un autre produit.
| Voie | Ce qu'elle donne | Ce qu'elle ne donne pas |
|---|---|---|
| Journal d'accès | Une ligne par requête : statut, durées, chemin, amont contacté | Une vue agrégée sans outil de collecte |
stub_status | Sept compteurs globaux sur les connexions et les requêtes | Statut, latence, route, amont |
| Exportateur | Les compteurs de stub_status au format Prometheus | Ce que stub_status ne compte pas |
Le tableau se lit ligne à ligne : chaque voie a un angle mort, et c'est leur combinaison qui donne une observation utile. Un exportateur est un petit programme qui lit une source (ici stub_status) et la republie dans un format qu'un outil de supervision sait collecter, comme décrit dans la page sur les exportateurs Prometheus. Pour obtenir des taux d'erreur ou des latences par route, il faut donc exploiter le journal, pas les compteurs.
Comment relier la requête du proxy à celle de l'application ?
Section intitulée « Comment relier la requête du proxy à celle de l'application ? »Quatre variables suffisent pour savoir qui a fait quoi : $status, $upstream_status, $request_time et $upstream_response_time. Le proxy et l'application sont deux acteurs distincts, chacun avec son code de réponse et sa durée. Le journal par défaut (combined) n'écrit que le premier de chaque paire, ce qui rend impossible de départager un proxy lent d'une application lente.
$statusest le code envoyé au client.$upstream_statusest celui reçu de l'amont, ou celui que Nginx note lui-même quand la tentative échoue (Nginx y inscrit502ou504pour une connexion refusée ou un délai dépassé, sans que l'application ait répondu ; si le client a déjà fermé la connexion, la requête se finalise en499avant l'écriture du statut). Quand Nginx répond seul, sans contacter l'amont,$upstream_statusvaut-.$request_timeest la durée totale vue par Nginx : le temps écoulé depuis la lecture des premiers octets envoyés par le client, lecture de la requête comprise.$upstream_response_timeest le temps passé avec l'amont, de la connexion à la fin de la réception de sa réponse, en secondes avec une résolution de la milliseconde.$upstream_addrdit quel backend a été contacté, utile dès qu'un groupe en compte plusieurs.
Le schéma suivant montre une requête vers une page que l'application met deux secondes à produire. Regardez les deux notes : elles disent où chaque durée se mesure.
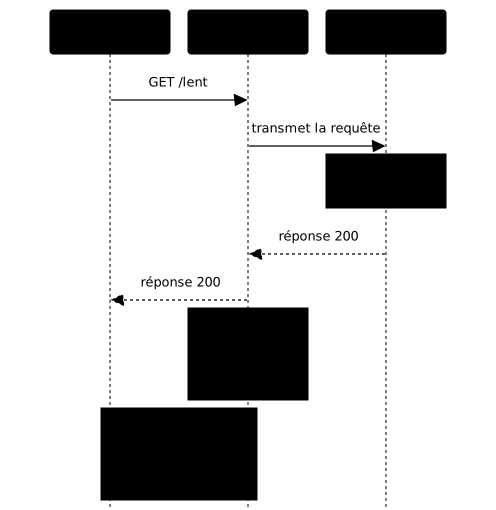
L'écart entre les deux durées oriente le diagnostic, il ne le conclut pas. Si upstream_response_time est proche de request_time, le temps s'est passé du côté de l'amont : une application lente, mais aussi une connexion lente à établir, puisque cette durée la comprend. Si request_time est bien plus grand, le temps s'est passé autour de l'amont : requête que le client envoie lentement (le chronomètre de $request_time démarre dès les premiers octets lus chez le client), réseau lent, client lent à lire la réponse ou réponse volumineuse. Dans les deux cas, l'écart dit où creuser ; la cause se confirme ensuite dans les journaux.
Deux subtilités évitent de mal lire une ligne. D'abord, quand Nginx réessaie un autre backend (voir proxy_next_upstream dans la leçon sur les upstreams), $upstream_status et $upstream_response_time portent plusieurs valeurs séparées par des virgules, une par tentative : ce ne sont donc pas des nombres. Lors d'un changement de groupe d'amont (redirection interne par error_page ou X-Accel-Redirect), les valeurs des deux groupes sont séparées par un deux-points.
Ensuite, un même $status final peut cacher des causes différentes. Un 503 envoyé par l'application s'écrit avec $upstream_status à 503. Un 503 produit par Nginx seul, par exemple parce qu'une limite de débit a refusé la requête (limit_req répond 503 par défaut, voir Nginx limites), s'écrit avec $upstream_status à - : Nginx a répondu sans contacter l'amont. Même code vu du client, deux causes, deux équipes à prévenir.
Un troisième cas piège la lecture : un 502 ou un 504 s'écrit avec un $upstream_status renseigné même quand l'application n'a rien répondu, puisque Nginx y inscrit lui-même le code de l'échec (connexion refusée, délai dépassé). Un $upstream_status renseigné prouve donc que Nginx a tenté de joindre l'amont, pas que l'application a répondu. Pour trancher un 502 ou un 504, on lit le journal d'erreurs, que la leçon Diagnostiquer Nginx détaille.
Comment écrire un journal JSON qui dise quelque chose ?
Section intitulée « Comment écrire un journal JSON qui dise quelque chose ? »Un journal utile est une ligne JSON par requête, produite par log_format ... escape=json, qui porte au moins le statut et les deux durées. Le JSON se filtre sans analyse de texte, et escape=json (paramètre apparu en 1.11.8) protège la ligne en échappant ", \ et les caractères de contrôle comme l'exige JSON : sans lui, une URL qui contient un guillemet casse l'objet, et un collecteur rejette la ligne sans bruit.
log_format observation escape=json  '{"heure":"$time_iso8601","id":"$request_id","methode":"$request_method",'  '"uri":"$uri","status":"$status","upstream_status":"$upstream_status",'  '"request_time":"$request_time","upstream_response_time":"$upstream_response_time",'  '"amont":"$upstream_addr"}';
access_log /var/log/nginx/access.json observation;
Les valeurs d'amont sont écrites entre guillemets : puisqu'elles peuvent porter plusieurs valeurs ou -, elles ne sont pas toujours des nombres, et un collecteur les convertit côté lecture. $request_id est un identifiant unique construit à partir de 16 octets aléatoires et écrit en hexadécimal (32 caractères), généré par Nginx pour chaque requête depuis la 1.11.0. Pour relier la ligne du proxy à celle de l'application, transmettez-le avec proxy_set_header X-Request-ID $request_id; : l'application l'écrit dans son propre journal, et la même chaîne retrouve la requête des deux côtés.
Après chaque modification, validez puis rechargez avec sudo nginx -t && sudo systemctl reload nginx, puis envoyez une requête et lisez la dernière ligne du fichier. Un champ présent n'est pas un champ qui mesure : un request_time figé à 0.000 serait parsable et inutile. Le contrôle se fait en provoquant un fait connu, par exemple une route que l'application ralentit de deux secondes, et en exigeant que la ligne le dise.
La conservation se décide, elle ne se subit pas. Cherchez la règle logrotate de votre installation plutôt que de la supposer : dpkg -L nginx | grep logrotate dit si le paquet en fournit une, et ls /etc/logrotate.d/ montre celles qui sont en place. Lisez-la ensuite pour connaître la rotation réelle, et vérifiez que son motif couvre le nom que vous avez choisi : une règle écrite pour *.log ne tourne pas un access.json, qui grossit alors sans limite jusqu'à remplir la partition. Si le paquet n'en fournit aucune, ou si le motif ne correspond pas, écrivez votre propre règle. Nginx rouvre ses fichiers à la réception du signal USR1 (nginx -s reopen). Le fonctionnement de logrotate est traité dans la leçon logrotate.
Que dit stub_status, et que ne dit-il pas ?
Section intitulée « Que dit stub_status, et que ne dit-il pas ? »stub_status expose des compteurs globaux depuis le démarrage de Nginx : connexions actives, connexions acceptées et traitées, requêtes, et l'état des connexions (lecture, écriture, attente). Le module n'est pas toujours compilé : vérifiez la présence de --with-http_stub_status_module dans nginx -V, comme montré dans la leçon d'installation. La page se déclare dans un location portant la seule directive stub_status;, placé dans un server qui écoute sur 127.0.0.1 ; la configuration complète est dans Protéger et observer Nginx.
La documentation de nginx.org décrit le format de la réponse, avec des valeurs d'exemple :
Active connections: 291server accepts handled requests 16630948 16630948 31070465Reading: 6 Writing: 179 Waiting: 106La deuxième ligne est un en-tête qui nomme les colonnes ; sur la troisième, les trois nombres sont des cumuls depuis le démarrage : connexions acceptées, connexions traitées, requêtes. Un cumul seul ne dit rien de l'instant. Pour obtenir un débit, relevez le compteur deux fois à un intervalle connu et divisez la différence par la durée, ce que fait un exportateur à votre place. Le rapport requêtes sur connexions traitées indique combien de requêtes passent par connexion, ce qui varie avec les connexions persistantes (keep-alive).
Ce que stub_status ne dit pas compte autant que ce qu'il dit. Il ne distingue ni les codes de réponse, ni les routes, ni les durées, ni les backends. Une alerte « taux de 502 sur /api/ » ne peut donc pas venir de lui, mais du journal. En revanche, une hausse durable du compteur Waiting ou de Active connections sans hausse du débit signale souvent des connexions qui s'accumulent : à confirmer dans le journal avant de conclure.
Reste l'exposition. Un point d'état exposé à tous donne à n'importe qui le nombre de connexions en cours de votre service. Le geste est de l'attacher à la boucle locale et de vérifier qu'il est refusé depuis l'adresse du réseau : curl en local doit répondre, curl vers l'adresse de la machine ne doit pas répondre 200. Une collecte depuis une autre machine passe par un exportateur placé sur le serveur, ou par un accès réseau restreint, pas par l'ouverture du point d'état.
Comment construire une alerte à partir de ces données ?
Section intitulée « Comment construire une alerte à partir de ces données ? »Une alerte fiable part d'un symptôme mesuré dans le journal et se recoupe avec une sonde qui regarde de l'extérieur. Trois signaux couvrent l'essentiel, chacun avec sa source :
| Signal | Source | Condition à seuiller |
|---|---|---|
| Taux d'erreur | Journal | Part des status en 5xx sur une fenêtre, par route |
| Latence | Journal | Durée request_time dépassant la valeur tolérée, sur un percentile |
| Saturation | stub_status | Active connections ou Waiting en hausse durable |
Le tableau dit quoi mesurer ; le seuil se choisit à partir du trafic normal observé, jamais d'un chiffre copié. Pour départager Nginx de l'application dans une alerte de latence, ajoutez le rapport entre upstream_response_time et request_time : c'est lui qui oriente la première minute du diagnostic.
Une sonde externe complète le tableau : une requête envoyée depuis l'extérieur de la machine vers le nom public (DNS, port, certificat, route) vérifie le chemin que suit réellement un utilisateur. Un stub_status local qui répond ne prouve rien sur ce chemin. Cela vaut aussi dans un lab : voir le point d'état fonctionner dans la machine ne dispense pas de tester l'accès par le réseau.
Une alerte sans consigne de réaction vaut peu. Le runbook (la fiche d'intervention) tient en quatre lignes : quel signal a déclenché, quelle ligne de journal lire en premier (la dernière en 5xx, avec son upstream_status), quelle commande confirmer (nginx -T, curl sur la route), et quand revenir à la normale. La leçon Diagnostiquer Nginx enchaîne sur cette démarche. Après la panne, rejouez la requête fautive : l'alerte doit retomber, sinon elle ne mesurait pas ce que vous pensiez. Pour un contraste, Traefik expose ses propres métriques (voir Traefik observabilité) : ce que Nginx demande de construire à la main, il le fournit.
Quelles erreurs fait-on le plus souvent ?
Section intitulée « Quelles erreurs fait-on le plus souvent ? »Cinq confusions reviennent, et chacune se détecte par un test simple.
- Croire que
stub_statusdonne des métriques par route. Il n'a que des compteurs globaux : le détail par route vient du journal. - Journaliser
$request_timeseul. Sans$upstream_response_time, une page lente reste inattribuable. - Considérer le point d'état comme protégé parce qu'il répond en local. Il faut vérifier qu'il est refusé ailleurs.
- Laisser un champ qui ne mesure rien. Un format parsable mais figé passe tous les contrôles de forme.
- Écrire un secret dans le journal. Un jeton en paramètre d'URL finit en clair dans un fichier lisible par plusieurs comptes.
Mettre en pratique
Section intitulée « Mettre en pratique »Dans le lab, Nginx publie une application de test mais n'en dit rien : journal par défaut, aucun point d'état. Vous exposez stub_status sur la boucle locale, vous remplacez le journal par un format JSON portant au moins status, request_time et upstream_response_time, puis vous prouvez que ces champs mesurent. La validation provoque des faits : elle vérifie que le point d'état répond en local et qu'il est refusé depuis l'adresse du réseau, elle parse chaque ligne comme du JSON, elle demande une page que l'application met deux secondes à servir et exige que request_time le dise, puis elle compare une erreur 503 de l'amont à une requête saine en 200.
À retenir
Section intitulée « À retenir »Observer un proxy, c'est mesurer deux acteurs et non un seul.
- Nginx open source n'a ni métriques Prometheus natives ni sondes actives : l'observation passe par le journal,
stub_statuset un exportateur. $request_timeest la durée totale vue par Nginx,$upstream_response_timecelle passée avec l'amont, connexion comprise : leur écart dit où chercher, sans nommer le coupable.$upstream_statusvaut-quand Nginx répond seul : deux503identiques peuvent avoir deux causes. Renseigné, il ne prouve pas que l'application a répondu, car Nginx y inscrit lui-même502ou504quand l'amont échoue.- Un
log_formatavecescape=jsonproduit un objet par ligne, et$request_idtransmis à l'application relie les deux journaux. - Un champ de journal doit mesurer, et se vérifie contre un fait provoqué.
stub_statuscompte des cumuls globaux : un débit se calcule par différence, et le détail par route vient du journal.- Le point d'état se restreint à la boucle locale, avec un refus vérifié depuis le réseau, et le journal ne porte aucun secret.
- Une alerte s'appuie sur le journal, se recoupe avec une sonde externe et s'accompagne d'un runbook.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de ce guide est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Diagnostiquer Nginx avec les bons indices
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications