Sonder un backend, c'est demander à HAProxy de vérifier à intervalle régulier que le serveur peut vraiment servir, et de le retirer de la rotation quand il ne le peut plus. Cette leçon s'adresse à une personne qui route déjà des requêtes avec HAProxy et qui veut que le trafic évite les serveurs défaillants sans bascule inutile. Elle couvre les algorithmes de répartition et les poids, les sondes actives check et option httpchk, les seuils inter, fall et rise, la différence entre un port ouvert et un service prêt, puis le drainage, qui retire un serveur sans couper ce qu'il sert déjà. Contrairement à Nginx, qui ne détecte une panne que passivement (voir Nginx upstream : répartir la charge et retirer les pannes), HAProxy sonde activement.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »La leçon va du choix de la répartition à la mesure d'une convergence.
- Choisir
roundrobinouleastconn, des poids et un serveurbackupselon le besoin. - Déclarer une sonde applicative avec
check,option httpchk,inter,falletrise. - Distinguer un port TCP ouvert, un service vivant et un service prêt.
- Retirer, drainer et réintégrer un serveur, puis lire les compteurs de HAProxy pour le prouver.
- Vérifier qu'une panne plus courte que le seuil ne provoque aucune bascule.
Prérequis
Section intitulée « Prérequis »La leçon suppose que vous savez écrire un frontend et un backend HAProxy et interroger son socket.
- Installer HAProxy, lire ses sections et parler au socket d'administration : Installer HAProxy et lire ses sections de configuration.
- Router des requêtes vers des backends : Router par noms et chemins avec ACL et maps.
- Le lab tourne sur Debian 13 avec HAProxy 3.4.7, le paquet
3.4.7-1~bpo13+1du dépôttrixie-backports-3.4. Le nombre de colonnes deshow statvarie d'une version à l'autre, c'est pourquoi on les lit par leur nom et jamais par leur position.
Comment HAProxy répartit-il le trafic entre serveurs ?
Section intitulée « Comment HAProxy répartit-il le trafic entre serveurs ? »HAProxy choisit un serveur du backend selon l'algorithme balance et les poids des serveurs : roundrobin fait tourner les requêtes en proportion des poids, leastconn envoie vers le serveur qui a le moins de connexions actives. Ni l'un ni l'autre n'est meilleur dans l'absolu : le bon choix dépend de la durée des requêtes. Et il s'écrit : sans directive balance, HAProxy 3.4 applique random, qui tire un serveur au hasard (c'est le défaut depuis la 3.3).
Avec roundrobin, chaque serveur reçoit tour à tour une requête, en respectant les poids. C'est le bon choix quand les requêtes sont courtes et homogènes. Avec leastconn, HAProxy compare le nombre de connexions ouvertes et choisit le moins chargé : il convient aux requêtes longues ou très inégales (téléchargements, sessions, flux), où un tour de rôle laisserait un serveur accumuler les connexions lentes.
Écrivez donc toujours balance vous-même, y compris pour roundrobin. Avec random, il n'existe aucun tour de rôle : une démonstration qui compte sur « une requête chez l'un, la suivante chez l'autre » ne se vérifie plus qu'en moyenne. Le backend de départ du lab déclare pour cette raison balance roundrobin noir sur blanc, et c'est ce qui rend l'alternance prévisible.
Les poids déclarent la capacité relative. weight 3 face à weight 1 signifie que le premier prend trois requêtes sur quatre en état sain. Le lab prescrit justement des poids 3 et 1, et mesure la part prise sur un échantillon. Un serveur marqué backup ne reçoit rien tant que tous les serveurs ordinaires sont tombés : c'est le dernier recours, pas un serveur de plus.
backend api balance leastconn option httpchk GET /sante http-check expect status 200 default-server inter 2s fall 3 rise 2 server api1 127.0.0.1:9101 check weight 2 server api2 127.0.0.1:9102 check weight 1 server api3 127.0.0.1:9103 check backupCet exemple est volontairement différent du lab : un autre algorithme, déclaré lui aussi explicitement, d'autres seuils, un serveur de secours. default-server fixe les réglages communs de tous les serveurs du backend, ce qui évite de les répéter. La recette du lab, elle, prescrit ses propres valeurs : lisez-les dans /opt/pub-haproxy-sante/recette.txt plutôt que de copier celles-ci.
Que se passe-t-il quand personne ne sonde ?
Section intitulée « Que se passe-t-il quand personne ne sonde ? »Sans sonde, un serveur tombé reste dans la rotation : HAProxy continue de lui envoyer sa part du trafic, et les clients reçoivent des erreurs. Le lab part de cet état, à poids égaux, sans check ni option httpchk.
Constatez-le avant d'écrire quoi que ce soit. Le scénario le fait en passant le fichier d'état du serveur beta à casse, puis en envoyant six requêtes :
echo casse > /opt/pub-haproxy-sante/etat-betafor i in $(seq 6); do curl -s -o /dev/null -w '%{http_code} ' http://127.0.0.1/; doneecho pret > /opt/pub-haproxy-sante/etat-betaÀ poids égaux et sous balance roundrobin, HAProxy envoie une requête sur deux à beta, qui répond une erreur 500 : environ la moitié des réponses sont des échecs, alors que le processus beta tourne toujours. Remettre l'état à pret ensuite évite de laisser le service cassé. Le point à retenir : tant que HAProxy ne sait pas que beta est malade, il ne peut rien faire.
Un port ouvert prouve-t-il que le service est prêt ?
Section intitulée « Un port ouvert prouve-t-il que le service est prêt ? »Non : un check seul vérifie qu'une connexion TCP s'ouvre, ce que fait aussi un service qui a perdu sa base de données. Il faut distinguer trois niveaux de santé, et chacun répond à une question différente.
| Niveau | Question posée | Exemple de sonde | Ce qu'elle manque |
|---|---|---|---|
| Port ouvert (TCP) | Le processus écoute-t-il ? | check seul | Un service vivant mais incapable de répondre |
| Liveness (vivant) | Le processus répond-il en HTTP ? | option httpchk GET /vivant | Une dépendance tombée : le processus répond, mais ne sert rien d'utile |
| Readiness (prêt) | Le service peut-il servir ? | option httpchk GET /ready | Rien d'essentiel, si /ready vérifie ce dont le service a besoin |
Dans le lab, chaque backend expose /ready. L'état casse fait rendre 503 à la sonde et 500 aux requêtes utiles : c'est la situation qu'une sonde de readiness existe pour couvrir, celle d'un service vivant dont une dépendance est tombée. Un check seul continuerait de voir le port ouvert et laisserait beta dans la rotation. Kubernetes oppose les mêmes notions de liveness et de readiness : voir Probes Kubernetes : liveness, readiness, startup sans faux positifs.
Le contrôle du lab exige que la sonde soit de niveau 7 (la couche applicative, celle du protocole HTTP, par opposition au niveau 4, celui de la connexion TCP), ce que HAProxy rapporte par le champ check_status de show stat. La valeur L7OK signifie que la sonde a lu une réponse applicative acceptable ; L4OK signifie seulement qu'un port a accepté une connexion. Les deux se distinguent à la lecture, et un check seul ne donnera jamais mieux que L4OK.
Une sonde peut aussi aller plus loin qu'un statut : http-check expect vérifie le statut ou le contenu de la réponse (http-check expect status 200, ou une chaîne attendue dans le corps). check-ssl force la sonde à passer en TLS, que le serveur soit ou non déclaré en ssl pour le trafic : on s'en sert surtout quand la sonde vise un autre port ou une autre addr et n'hérite donc pas du TLS du serveur. Pour une sonde HTTPS, le SNI (le nom de serveur annoncé dans la poignée de main TLS) est dérivé de l'en-tête Host par défaut (sni-auto, depuis la 3.3). Ces variantes ne sont pas rejouées dans le lab, qui sonde en HTTP clair.
Comment régler inter, fall et rise ?
Section intitulée « Comment régler inter, fall et rise ? »inter est l'intervalle entre deux sondes, fall le nombre d'échecs consécutifs avant de retirer un serveur, rise le nombre de succès consécutifs avant de le réintégrer. Ces trois nombres fixent la fenêtre pendant laquelle une panne passe inaperçue, et celle pendant laquelle un serveur rétabli reste dehors.
Le calcul est direct. Avec inter 1s, fall 5 et rise 3 (les valeurs de la recette du lab), un serveur est retiré au bout d'environ cinq secondes d'échec continu, et réintégré après environ trois secondes de succès continu. On retrouve ces bornes dans le test : il attend fall × inter + 8 secondes pour constater le retrait, et rise × inter + 12 pour constater le retour, avec une marge ajoutée à chaque fois.
Pourquoi ne pas mettre fall 1 pour réagir plus vite ? Parce qu'une sonde réglée trop court transforme chaque hoquet en bascule, et la bascule coûte plus que le hoquet : tout le trafic neuf se reporte sur le serveur restant, et la charge qu'il encaisse peut le faire tomber à son tour. Seul ce trafic neuf est déplacé. Le manuel dit de l'option on-marked-down shutdown-sessions : « Actions are disabled by default ». On en déduit que, sans elle, HAProxy ne coupe pas les connexions déjà établies vers un serveur qu'il marque DOWN ; le manuel ne l'énonce pas en une phrase générale. Un seuil bien réglé retire donc ce qui est réellement tombé et ignore ce qui ne dure pas.
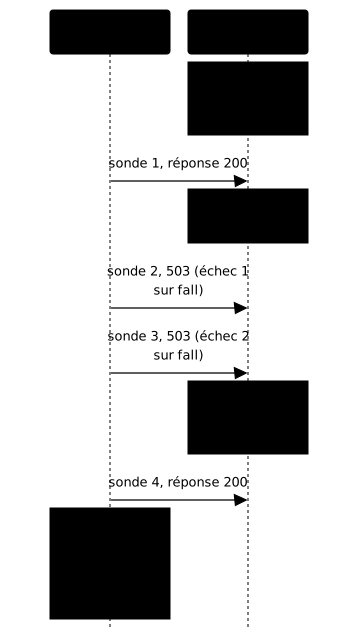
Réglez donc inter, fall et rise d'après ce que votre service tolère. Un inter court détecte vite, mais envoie plus de sondes : s'il y en a beaucoup, chacune charge le service même en pleine panne. Une sonde coûteuse, qui interroge la base à chaque appel, peut elle-même aggraver un incident. HAProxy propose deux variantes, à ne pas confondre : fastinter remplace inter pendant une transition (serveur en train de tomber après un échec, ou de remonter, ou pas encore sondé), pour trancher plus vite ; downinter remplace inter quand le serveur est entièrement DOWN, utile pour ralentir les sondes d'un serveur déjà mort. Sans elles, inter s'applique partout (2000 ms par défaut, fall à 3 et rise à 2 si rien n'est précisé).
Comment lire les compteurs de HAProxy ?
Section intitulée « Comment lire les compteurs de HAProxy ? »show stat, par le socket d'administration, rend une ligne par serveur avec son état courant et des compteurs de transitions ; ce sont les compteurs, pas l'état, qui disent ce qui s'est passé. Les colonnes utiles ici sont status, check_status, weight, chkfail et chkdown.
chkfail compte les sondes échouées tant que le serveur est UP (une fois DOWN, il ne bouge plus), chkdown les descentes, c'est-à-dire les fois où le serveur est passé de UP à DOWN. Un état seul ne distingue pas deux histoires opposées : un serveur UP dix secondes après une panne courte peut n'avoir jamais été retiré, ou avoir été retiré puis remis. Avec rise 3 et inter 1, les deux donnent UP au même instant. Seul chkdown dit laquelle des deux a eu lieu : c'est exactement la différence entre une sonde stable et une sonde qui oscille.
Le test du lab lit les colonnes par leur nom, dans la première ligne de la sortie, qui commence par # pxname,svname,.... Le décalage d'une colonne ajoutée par une version de HAProxy casserait une lecture par position. Vous pouvez faire pareil :
echo 'show stat' | sudo socat -t3 stdio /run/haproxy/admin.sock |awk -F, 'NR==1 { sub(/^# /, ""); for (i=1; i<=NF; i++) col[$i]=i; next } $col["pxname"]=="applicatif" && $col["svname"]!="FRONTEND" && $col["svname"]!="BACKEND" { print $col["svname"], $col["status"], $col["check_status"], $col["chkfail"], $col["chkdown"] }'Ce script affiche, pour chaque serveur du backend applicatif, son nom, son état, le type de sonde et les deux compteurs. Il n'a pas été rejoué en machine : si une colonne manque, vérifiez le nom exact dans la première ligne de votre sortie. Les valeurs de status à connaître sont UP, DOWN, DRAIN et MAINT.
Comment retirer un backend non prêt, et le mesurer ?
Section intitulée « Comment retirer un backend non prêt, et le mesurer ? »Rendre /ready en échec sur un serveur vivant le fait passer à DOWN après fall échecs, et le client ne voit plus d'erreur une fois la convergence atteinte. C'est le geste à prouver, et la preuve est une descente comptée, pas un état constaté.
La démonstration suit la panne sans arrêter le processus. On met le fichier d'état de beta à casse : le processus tourne, /ready rend 503, la sonde échoue. HAProxy compte les échecs, puis au fall-ième il retire beta. Le test exige alors trois choses : un statut autre que UP dans la fenêtre prévue, une descente de plus dans chkdown (plus d'une signifie que le serveur est tombé, revenu, puis retombé, donc que les seuils oscillent), et plus aucune requête vers beta après convergence, sans erreur côté client.
Le retour se mesure de la même façon. On rétablit l'état pret : la sonde recommence à réussir, et au rise-ième succès consécutif le serveur revient à UP. Ce qui se passe entre les deux est la capacité restante : avec des poids 3 et 1, retirer le serveur de poids 3 laisse le serveur de poids 1 porter tout le trafic. Posez-vous la question avant la panne, pas pendant : le serveur restant tient-il la charge ? Sinon, maxconn sur la ligne server plafonne ses connexions simultanées et timeout queue fixe combien de temps une requête attend en file avant d'échouer : les requêtes patientent plutôt que de saturer le serveur.
Pour réintégrer sans à-coup, slowstart fait remonter progressivement le poids d'un serveur qui revient : il reprend sa part sur la durée que vous fixez plutôt que d'un coup. Ce réglage n'est pas rejoué dans le lab ; testez-le avec une charge bornée avant de le retenir.
Pourquoi une panne courte ne doit-elle rien retirer ?
Section intitulée « Pourquoi une panne courte ne doit-elle rien retirer ? »Une sonde est bien réglée quand elle retire un serveur réellement tombé et ignore une baisse plus courte que son seuil ; le test de la seconde moitié est le contre-test qui évite d'accepter fall 1. Sans lui, un seuil trop court passerait la mesure précédente haut la main.
Le test du lab fait tomber beta pendant (fall - 2) × inter secondes, soit 3 secondes avec les valeurs de la recette, puis le rétablit. Assez pour que des sondes échouent, pas assez pour atteindre le seuil. Il exige alors que chkfail ait augmenté, preuve que la panne a bien été vue, et que chkdown n'ait pas bougé, preuve qu'aucune descente n'a eu lieu. Si chkfail n'augmente pas, la sonde est plus lente que la baisse ou ne lit pas /ready : le test n'a rien mesuré.
Lisez ce contre-test comme une propriété de votre configuration, pas comme une astuce de lab. En exploitation, les redémarrages de service, les pauses de ramasse-miettes et les micro-coupures réseau peuvent durer quelques secondes. Une sonde qui retire à chacun d'eux fait osciller le backend, et chaque oscillation déplace brutalement le trafic neuf vers les autres serveurs (et coupe aussi les connexions établies si on-marked-down shutdown-sessions est posé).
Que changent arrêt, panne HTTP et lenteur ?
Section intitulée « Que changent arrêt, panne HTTP et lenteur ? »Une sonde distingue trois pannes : un processus arrêté refuse la connexion, une panne HTTP répond un mauvais statut, une lenteur dépasse le délai de la sonde ; chacune laisse une trace différente dans check_status. Les connaître évite de chercher au mauvais endroit.
Un serveur arrêté ne répond plus du tout : la sonde échoue sur la connexion TCP, et check_status porte une valeur de niveau 4. Une panne HTTP, comme le 503 de /ready dans le lab, laisse la connexion s'établir mais la réponse n'est pas acceptable : la valeur est de niveau 7, avec un statut inattendu. Une lenteur qui dépasse timeout check (ou inter quand timeout check n'est pas posé) est comptée comme un échec de délai. Aucune des trois n'a le même remède : relancer un processus, corriger une dépendance, ou régler un délai.
Pour tester ces cas sans abîmer la machine, bornez le débit de test. Envoyez un nombre fini de requêtes (vingt, quarante), avec curl --max-time, et jamais une boucle sans fin. Le lab fournit un utilitaire côté client qui compte les réponses par serveur sur un échantillon fixe, ce qui rend la mesure reproductible et empêche de saturer le service qu'on est en train de diagnostiquer.
Comment drainer un serveur sans couper ce qu'il sert ?
Section intitulée « Comment drainer un serveur sans couper ce qu'il sert ? »Drainer un serveur arrête les nouvelles affectations mais laisse finir les connexions déjà établies, alors qu'arrêter le processus les coupe ; c'est ce qui permet une maintenance sans coupure visible. La différence entre drainer et arrêter est celle que le lab mesure sur un flux ouvert.
L'état se pilote par le socket d'administration :
echo 'set server applicatif/beta state drain' | sudo socat -t3 stdio /run/haproxy/admin.sockecho 'set server applicatif/beta state ready' | sudo socat -t3 stdio /run/haproxy/admin.sockUn serveur drainé apparaît en DRAIN dans show stat. Les nouvelles requêtes ne l'atteignent plus, sauf celles qu'une persistance de session (le mécanisme qui renvoie un même client vers le même serveur) lui rattache. Un flux long, ouvert avant le drainage, continue jusqu'à son terme. L'état maint (ou la commande disable server) retire le serveur de la rotation et arrête aussi ses sondes ; il ne laisse pas passer les sessions persistantes que drain accepte encore. Le retour à ready remet le serveur dans la rotation, et la sonde reste juge de son état.
Le test enchaîne deux drainages : il draine d'abord alpha, pour qu'un flux long ne puisse atterrir que chez beta, de façon déterministe, sans ouvrir au hasard et réessayer. Puis il rétablit alpha, draine beta, et mesure deux choses. Quarante nouvelles requêtes n'atteignent plus beta et ne produisent aucune erreur ; et le flux établi chez beta continue de recevoir ses lignes, sans message d'erreur. Si le flux s'arrête dès le drainage, vous n'avez pas drainé, vous avez arrêté.
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab vous donne deux backends qui servent la même application derrière HAProxy, sans sonde ni poids. Vous déclarez la sonde /ready et les seuils prescrits par la recette, les poids 3 et 1, puis vous montrez que vous retirez un serveur sans couper ce qu'il sert. La validation mesure quatre choses : la part de chaque serveur et une sonde de niveau 7, le retrait d'un backend vivant mais non prêt dans la fenêtre calculée, l'absence de retrait sur une panne plus courte que le seuil, et un drainage qui arrête les nouvelles affectations sans couper le flux établi.
À retenir
Section intitulée « À retenir »roundrobinconvient aux requêtes courtes et homogènes,leastconnaux requêtes longues ou inégales, et sansbalanceHAProxy 3.4 appliquerandom: on écrit l'algorithme ; les poids fixent la part de chaque serveur,backupne sert que quand tous les autres sont tombés.- Un
checkseul ne vérifie qu'un port ouvert (L4OK) ; une sondeoption httpchklit une réponse applicative (L7OK) et couvre le cas du service vivant dont une dépendance est tombée. inter,falletrisefixent la fenêtre de détection et de retour : environfall × intersecondes pour retirer,rise × interpour réintégrer.- Un
falltrop court transforme chaque hoquet en bascule : le contre-test exige quechkfailmonte et quechkdownne bouge pas sur une panne plus courte que le seuil. - Une bascule déplace le trafic neuf vers les autres serveurs ; les connexions déjà établies ne sont pas coupées par un passage en
DOWN(déduit du manuel), sauf sion-marked-down shutdown-sessionsest posé. - Les compteurs
chkfailetchkdowndeshow statdisent ce qui s'est passé ; un étatUPne dit pas si le serveur est tombé et revenu. Les colonnes se lisent par leur nom. - Avant la panne, calculez la capacité restante : le serveur qui reste doit tenir la charge ;
maxconnettimeout queuebornent la file. - Drainer (
set server ... state drain) arrête les nouvelles affectations sans couper l'établi ; arrêter le processus coupe les flux établis. - Testez avec un débit borné : un nombre fini de requêtes, jamais une boucle sans fin sur un service déjà fragile.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de ce guide est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : HAProxy et certificats ACME : un cycle de renouvellement éprouvé
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications