Avant d'ouvrir un service au public, on le réceptionne, on prouve qu'on sait le perdre et le récupérer, et on sait défaire une bascule qui tourne mal. Cette leçon s'adresse à une personne qui a déjà publié un service derrière un point d'entrée HTTPS et qui n'a vérifié qu'une chose : qu'il démarre. Elle montre comment dresser une recette depuis un vrai client, restaurer une sauvegarde jamais essayée, défaire une bascule cache compris, et nommer ce qu'un laboratoire ne démontre pas. Elle ne donne aucune directive d'outil : le raisonnement vaut pour n'importe quel proxy.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »La leçon va de la réception d'une publication à l'aveu de ses limites.
- Dresser une matrice de recette qui couvre le nom, le certificat, la route métier et un refus.
- Exécuter cette recette depuis un client indépendant de la machine qui héberge le service.
- Prouver qu'une sauvegarde se restaure, en rejouant la perte de la configuration et de l'état.
- Défaire une bascule défaillante sans attendre l'expiration d'un cache.
- Distinguer ce qu'un retour arrière rattrape de ce qu'il laisse en l'état.
- Nommer ce qu'une recette de laboratoire laisse à vérifier avant une vraie mise en service.
Prérequis
Section intitulée « Prérequis »La leçon suppose que vous savez lire une réponse HTTP, lancer un curl, et que vous avez déjà vu un service publié derrière un point d'entrée.
- Lire un échange HTTP, ses codes de statut et ses en-têtes : Lire HTTP avant de configurer un proxy.
- Situer le point d'entrée sur le trajet d'une requête : Publier un service web.
- Connaître le rôle d'un cache et d'une durée de vie (TTL) : Maîtriser délais, tentatives et cache sans altérer les réponses.
- Le lab fournit les machines et le service : vous n'installez rien.
Que traite cette leçon, et que laisse-t-elle aux autres pages ?
Section intitulée « Que traite cette leçon, et que laisse-t-elle aux autres pages ? »Cette leçon traite de la décision de mettre en service : ce qu'on vérifie avant d'ouvrir, comment on revient en arrière, et ce que ce retour ne rattrape pas. Une mise en service est le moment où une publication cesse d'être un essai de l'équipe et devient un service dont d'autres dépendent. Une recette est l'ensemble des vérifications qui permet de dire « conforme » ou « refusé » avant ce moment.
Deux sujets voisins existent déjà sur le site, et cette leçon ne les redit pas. La mécanique d'un rechargement et d'une bascule entre deux générations se lit côté outil : Recharger, mettre à jour et reprendre HAProxy pour HAProxy, Mettre à jour, restaurer et rebooter Nginx pour Nginx. La sauvegarde et le plan de reprise d'un système entier, avec la règle 3-2-1, sont dans Conserver : sauvegarde, restauration et plan de reprise (PRA). Ici, l'angle est plus étroit : une seule publication, et le geste de la recevoir, de la restaurer et de la défaire.
Pourquoi réceptionner une publication depuis un client indépendant ?
Section intitulée « Pourquoi réceptionner une publication depuis un client indépendant ? »Il faut réceptionner depuis un client qui n'est pas la machine du service, parce que l'opérateur voit son service de l'intérieur, alors qu'un vrai client le traverse tout entier. Depuis la machine qui l'héberge, un curl sur localhost réussit même si le nom n'est pas déclaré dans le DNS (le service qui traduit un nom en adresse), même si le certificat ne correspond pas au nom, même si un pare-feu coupe l'accès de l'extérieur. Un client indépendant est une autre machine, avec son propre résolveur et sa propre liste d'autorités de confiance : c'est la seule position qui éprouve la chaîne complète.
Le scénario du lab prend ce cas : un service est déjà en place, une route métier derrière du TLS (le chiffrement qui authentifie le serveur), servie par deux origines, une active et une candidate pour une future bascule. Le seul contrôle déjà fait est qu'elle démarre : cela dit que le processus tourne, pas qu'un client obtient la bonne réponse.
Nous recommandons de désigner ce client de recette dès le départ et de ne jamais le confondre avec l'opérateur. Dans le lab, c'est la machine poste.lab. La preuve de joignabilité repose sur ce qu'elle y observe, pas sur ce que l'opérateur voit depuis edge.lab.
Que doit couvrir une matrice de recette ?
Section intitulée « Que doit couvrir une matrice de recette ? »Une matrice de recette croise ce qu'on attend d'une publication et la mesure qui le démontre, et elle couvre au minimum le nom, le certificat, la route métier et un refus. Le tableau ci-dessous se lit ligne par ligne : on part de l'attente, on regarde la mesure faite depuis le client, puis le piège qu'elle évite.
| Attente | Mesure depuis le client | Piège évité |
|---|---|---|
| Le nom mène au service | dig service.mes.test A interroge le résolveur du client | Un contournement par --resolve ou par /etc/hosts cache une entrée DNS manquante |
| Le certificat est de confiance | curl --cacert ca.pem https://… valide la chaîne | -k (--insecure) accepte n'importe quel certificat |
| La route métier répond | Statut 200 et un corps qui contient le champ attendu | Un 200 d'une page d'erreur personnalisée ne prouve rien |
| Une route interne est refusée | Statut 403 sur la route de gestion | Une route interne exposée passe inaperçue tant qu'on ne la demande pas |
Une autorité de certification (AC) est l'organisme dont la signature atteste qu'un certificat appartient bien à un nom. Dans le lab, l'AC est une autorité de test dont le certificat est déposé sur le client : le contrôle TLS la désigne explicitement par --cacert, et n'utilise jamais --insecure. À garder hors du lab aussi : un contrôle qui désactive la vérification ne contrôle plus le certificat.
La dernière ligne mérite qu'on s'y arrête. Un refus est une réponse attendue négative : le service doit répondre 403 à qui demande une route de gestion. Une recette qui ne teste que ce qui doit marcher laisse passer ce qui ne devrait pas marcher. Dans le lab, la configuration de départ expose cette route interne par erreur ; la recette la trouve, et la correction passe par la configuration, pas par la recette.
Comment écrire une recette qui dit la vérité ?
Section intitulée « Comment écrire une recette qui dit la vérité ? »Une recette honnête déclare ses résultats après les avoir mesurés, et elle doit pouvoir échouer : une grille qui répond « conforme » dans tous les cas ne contrôle rien. Le lab demande un fichier de recette qui déclare, pour le DNS, le TLS, le HTTP et le refus, que la mesure passe. Le test ne se contente pas de lire ces déclarations : il rejoue lui-même les mesures depuis le client.
Voici l'ordre de travail que nous recommandons, et c'est une habitude de prudence plutôt qu'une règle de protocole. D'abord, exécuter chaque mesure et lire sa sortie. Ensuite, corriger ce qui échoue à la source, dans la configuration du service. Enfin, réécrire la grille avec les résultats obtenus après correction, sans retoucher une case pour la faire passer.
Le contrôle doit passer par le résolveur du client, c'est-à-dire le serveur auquel la machine demande les adresses. Si vous forcez l'adresse avec curl --resolve, la requête réussit, mais vous n'avez rien appris sur le DNS : le lab le vérifie séparément par dig. Pour préparer le nom et sa bascule, voir Préparer les noms DNS et leur bascule.
Pourquoi une sauvegarde jamais restaurée n'est-elle qu'une croyance ?
Section intitulée « Pourquoi une sauvegarde jamais restaurée n'est-elle qu'une croyance ? »Une sauvegarde n'est prouvée que le jour où on l'a restaurée : tant qu'elle ne l'a pas été, on croit qu'elle fonctionne, on ne le sait pas. Le scénario le dit sans détour : une sauvegarde dont personne n'a jamais restauré le contenu est une croyance, pas un fait. Les pannes qu'un exercice révèle sont banales : un fichier vide, un chemin qui a changé, un droit d'accès manquant.
La restauration d'une publication comporte deux éléments distincts. La configuration décrit comment le service route et se protège. L'état est la donnée que le service produit et qu'on ne sait pas recréer, ici un stock. Perdre l'un sans l'autre donne un service qui démarre avec de fausses valeurs : une configuration restaurée sur un état par défaut répond 200, mais avec un stock qui ne correspond à rien.
C'est pourquoi le lab mesure la valeur restaurée et pas seulement le statut. Après la perte simulée, la route métier ne doit plus répondre 200, ce qui prouve que la perte était réelle. Une fois la procédure exécutée, elle doit répondre 200 dans les quinze secondes, avec le stock d'origine, pas une valeur par défaut. Un service qui répond 200 avec une donnée inventée est, à notre avis, pire qu'un service arrêté : personne ne s'en aperçoit.
Comment préparer la restauration avant la perte ?
Section intitulée « Comment préparer la restauration avant la perte ? »Nous recommandons d'écrire et d'essayer la procédure de restauration avant d'avoir perdu quoi que ce soit, parce qu'une procédure rédigée pendant l'incident se rédige sous la pression, par quelqu'un qui n'a jamais restauré. Le lab exige donc un script de restauration présent avant la perte contrôlée. Le test le contrôle ainsi : le fichier doit exister, puis le test supprime la configuration et l'état actifs, puis il exécute le script.
Une procédure de restauration utile répond à quatre questions. Où se trouve la sauvegarde, et est-elle lisible depuis la machine qui doit la restaurer ? Quoi remettre en place, configuration et état ensemble ? Comment le service reprend-il en compte ce qui vient d'être rétabli, rechargement ou redémarrage ? Comment vérifie-t-on que la reprise est réelle, et pas simplement que le script s'est terminé sans erreur ? La dernière question compte : un script qui sort avec le code 0 prouve qu'il n'a rien rencontré d'anormal, pas que le service sert la bonne donnée.
Nous recommandons aussi de ne pas laisser la copie de secours sur la machine qu'elle protège. Dans le lab, elle est posée juste à côté du service pour simplifier l'exercice, ce qui n'est pas un modèle : une sauvegarde qui disparaît avec la machine ne sauvegarde rien. La règle 3-2-1 (trois copies, deux supports, une hors site) est décrite dans la leçon sur la conservation ; c'est un conseil de prudence répandu, pas une obligation.
Comment défaire une bascule défaillante, cache compris ?
Section intitulée « Comment défaire une bascule défaillante, cache compris ? »Défaire une bascule défaillante demande de remettre l'ancienne cible en service et de purger le cache : modifier la configuration seule laisse le cache rendre la réponse défaillante jusqu'à la fin de sa durée de vie. Une bascule est le changement de cible du trafic, ici de l'origine active vers l'origine candidate. Un cache garde une réponse pour la rendre aux requêtes suivantes sans interroger l'origine ; sa durée de vie (TTL) dit combien de temps il la garde.
Le schéma oppose les deux façons de revenir. Sur la première branche, on corrige seulement la configuration : le cache n'a aucune raison de savoir que la cible a changé, et il rend encore la réponse défaillante jusqu'à l'expiration de sa durée de vie. Sur la seconde, on corrige la configuration puis on purge le cache : le client reçoit la bonne réponse dès la purge. Regardez la durée entre l'erreur et la reprise : c'est ce que le lab mesure.
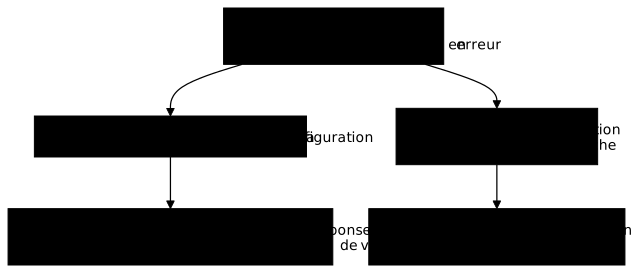
Dans le lab, la durée de vie du cache est réglée à 24 secondes dans la configuration. La bascule injectée vers l'origine candidate, invalide, fait répondre 500 à la route métier. Le test lance alors votre script de retour arrière et exige que la route réponde 200 en moins de six secondes : attendre simplement les 24 secondes de la durée de vie ne passerait pas. Le test juge donc que le retour s'est fait par une décision, pas par l'attente. C'est le sens de l'exigence : un retour arrière qui ne marche que si l'on patiente n'est pas une procédure, c'est de la chance.
Que ne rattrape pas un retour arrière ?
Section intitulée « Que ne rattrape pas un retour arrière ? »Un retour arrière remet la configuration dans son état précédent, mais il ne défait ni les effets déjà produits ni les copies de la réponse qui vivent ailleurs. Trois familles d'effets lui échappent, et il faut les connaître avant de promettre « on revient en arrière en une commande ».
La première est l'état métier écrit pendant la bascule, la donnée du service. Si la cible défaillante a accepté des écritures avant d'être corrigée, revenir à l'ancienne cible ne recrée ni ne supprime ces écritures. Une restauration de l'état peut les défaire, au prix de la perte de ce qui a été écrit depuis la sauvegarde. Le retour arrière de configuration et la restauration de données sont donc deux gestes distincts, avec des coûts distincts.
La deuxième est la copie qu'un tiers a gardée, dont la durée de vie vous échappe. Un navigateur, un résolveur DNS ou un cache intermédiaire que vous ne contrôlez pas a pu mémoriser une réponse ou une adresse. Vous purgez votre cache, pas le leur : la correction se propage selon leur durée de vie, pas selon votre décision. C'est la raison pour laquelle le DNS se prépare avant une bascule, en abaissant la durée de vie en amont.
La troisième est la génération qu'on croit retirée, celle de la livraison précédente. Une livraison ne retire pas la génération qu'elle remplace, car les anciennes connexions lui parlent encore ; elle retire celle qui avait été remplacée à la livraison précédente. Cette règle, détaillée dans Recharger, mettre à jour et reprendre HAProxy, implique qu'un retour arrière réaliste peut compter sur la génération précédente, encore présente. Nous recommandons donc de ne pas s'en séparer trop tôt.
Un dernier rappel, souvent confondu avec ce qui précède : « sans coupure au rechargement » ne veut pas dire « sans coupure en cas de panne de l'hôte ». Un rechargement propre préserve les connexions d'un processus qui continue de tourner. Il ne protège pas d'une machine qui s'arrête ; ce cas relève de la reprise, donc de la restauration, pas du retour arrière.
Que prouve une recette de laboratoire, et que laisse-t-elle de côté ?
Section intitulée « Que prouve une recette de laboratoire, et que laisse-t-elle de côté ? »Une recette de laboratoire prouve que la méthode fonctionne sur un banc simulé, pas que la mise en service réelle sera conforme : elle doit finir par une liste de ce qu'elle n'a pas démontré. Le lab se termine par un compte rendu de limites, et c'est volontaire. Le scénario demande un compte rendu honnête de ce que la recette doit encore à une vraie mise en service exposée sur Internet.
Quatre limites sont nommées par le test, et chacune a un contenu précis. Le résolveur public : le nom du lab, en .test, est résolu par un résolveur privé ; ce suffixe est réservé aux essais (RFC 6761) et n'existe pas dans le DNS public, donc la propagation, les caches des opérateurs et la présence d'adresses IPv4 et IPv6 n'ont pas été éprouvés. Le client externe : la recette s'exécute depuis une machine du laboratoire, pas depuis Internet ; le pare-feu de bordure, la traduction d'adresses (NAT) et les chemins réseau d'un vrai visiteur sont hors du champ. L'autorité publique : le certificat est signé par une autorité de test que le client a reçue à part ; un navigateur du public ne lui fait pas confiance, et le renouvellement automatique auprès d'une vraie autorité n'a pas été joué. Enfin la simulation : la perte a été simulée en supprimant des fichiers, pas en perdant un disque ou une machine.
Le test vérifie que ces quatre éléments sont mentionnés dans le compte rendu, fichier d'une certaine longueur minimale. Pour l'écrire utilement, rattachez chaque limite à la vérification qu'il faudra faire le jour de la mise en service, par exemple « interroger le nom depuis un résolveur public » ou « tester depuis un réseau extérieur ».
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab vous confie une publication en service dont personne n'a vérifié ni la recette, ni la sauvegarde, ni le retour arrière. Vous la réceptionnez depuis le client indépendant et corrigez ce que la recette révèle. Vous écrivez ensuite une procédure de restauration et une de retour arrière, puis le compte rendu des limites.
La validation exécute les mesures elle-même : elle interroge le DNS depuis le client, vérifie le certificat avec l'autorité du lab, exige 200 et 403, supprime la configuration et l'état avant d'exécuter votre restauration, et compare le stock restauré à la valeur d'origine. Elle injecte aussi une bascule défaillante et exige que votre retour arrière rende 200 en moins de six secondes.
À retenir
Section intitulée « À retenir »- Réceptionner une publication se fait depuis un client indépendant : DNS par le vrai résolveur, TLS avec l'autorité de confiance désignée et jamais
--insecure, route métier et refus d'une route interne. - Une recette qui ne teste que ce qui doit marcher laisse passer ce qui ne devrait pas marcher : le refus fait partie de la matrice.
- Une sauvegarde n'est prouvée que le jour où elle est restaurée, configuration et état ensemble, et la preuve porte sur la valeur restaurée, pas sur le seul statut.
- Nous recommandons d'écrire et d'essayer la procédure de restauration avant la perte, pas pendant.
- Un retour arrière de bascule demande de remettre l'ancienne cible et de purger le cache : changer la configuration seule laisse le cache rendre la réponse défaillante jusqu'à la fin de sa durée de vie.
- Un retour arrière ne défait ni les écritures faites pendant la bascule ni les copies gardées par des tiers, et une livraison ne retire pas la génération qu'elle remplace.
- « Sans coupure au rechargement » ne veut pas dire « sans coupure en cas de panne de l'hôte ».
- Une recette de laboratoire finit par ce qu'elle n'a pas prouvé : résolveur public, client externe, autorité publique, simulation.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Ces questions vérifient que vous savez choisir la mesure d'une recette, prouver une restauration et décider d'un retour arrière.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Diagnostiquer un service web par couches
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications