Diagnostiquer Nginx, c'est suivre un ordre de lecture fixe, de la configuration chargée jusqu'au journal d'erreur, avant de toucher à quoi que ce soit. Un code 403, 404, 502 ou 504 n'est pas une cause : c'est un symptôme qui doit être rattaché à un composant, le proxy, l'application ou la liaison entre eux. Cette leçon s'adresse à une personne qui sait déjà publier une application avec Nginx. Elle apprend où regarder, dans quel ordre, comment distinguer ce qui vient du proxy de ce qui vient de l'application, et pourquoi le premier correctif qui vient à l'esprit est souvent le plus dangereux.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »La leçon suit le trajet d'une requête, du fichier de configuration jusqu'au backend.
- Lire la configuration effectivement chargée avec
nginx -T. - Situer une panne côté proxy ou côté application avec le journal d'accès.
- Retrouver le motif exact d'un refus dans le journal d'erreur.
- Résoudre une mauvaise sélection de route, un refus de permission, une panne de backend et un certificat refusé.
- Vérifier la réparation par une recette qui contient aussi ce qui doit rester refusé.
Prérequis
Section intitulée « Prérequis »Vous savez publier une application avec Nginx et lire une ligne de journal.
- La publication,
nginx -tetreload: Publier une application avec Nginx et Installer Nginx. - La sélection d'une
location: Nginx routage. - Les variables de journal
status,upstream_statuset les durées : Observer Nginx. - Une machine Debian 13 avec
sudo.
Dans quel ordre faut-il regarder ?
Section intitulée « Dans quel ordre faut-il regarder ? »On regarde d'abord ce que Nginx a réellement chargé, puis ce que la requête a vécu, et seulement ensuite le motif du refus. Cet ordre évite l'erreur classique : lire un fichier de configuration que Nginx n'utilise pas, ou corriger la cause apparente alors que la cause réelle est ailleurs.
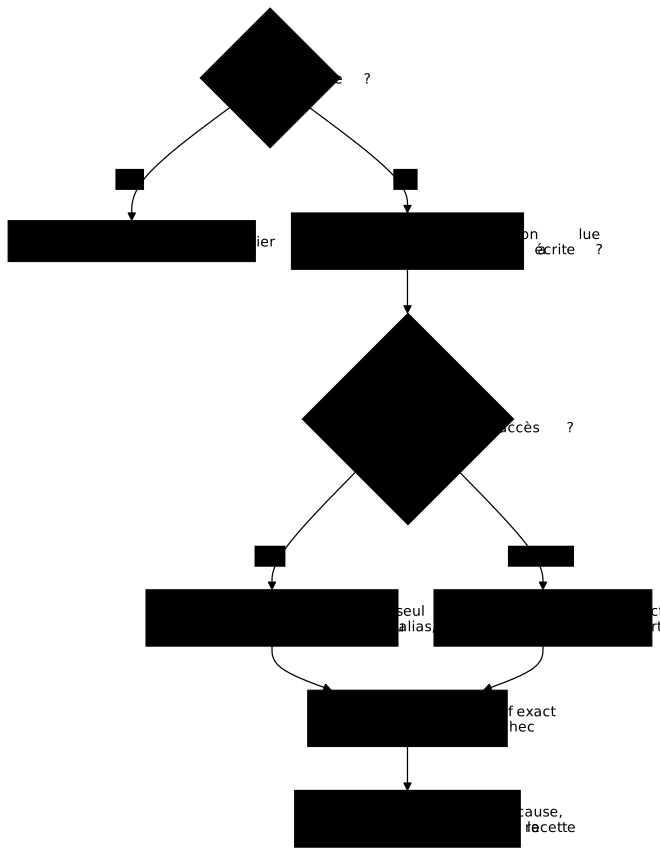
Le schéma se lit de haut en bas, et ses deux branches sont décidées par un seul champ. Si Nginx n'a pas contacté l'amont (le backend vers lequel il transmet la requête), le champ vaut - et le problème est dans le proxy : sélection de route, permissions, fichier introuvable, corps trop gros. S'il l'a contacté, le problème est entre Nginx et l'application, ou dans l'application elle-même : le champ dit que la tentative a eu lieu, pas que l'application a répondu. Dans les deux cas, la dernière marche est le journal d'erreur, qui nomme le fichier, l'adresse ou le certificat en cause.
Trois commandes tiennent les premières marches. systemctl status nginx dit si le service tourne. sudo nginx -t valide la syntaxe et nomme le fichier et la ligne en cause. sudo nginx -T fait la même validation puis affiche toute la configuration effective, tous les include résolus : c'est elle qui tranche entre ce qu'on croit avoir écrit et ce que le processus lit vraiment. Pour voir quels fichiers sont chargés et dans quel ordre, filtrez les lignes de repère :
sudo nginx -T 2>&1 | grep -nE '^# configuration file|server_name|location|proxy_pass|error_log'La sortie liste les fichiers lus et les directives utiles ; vérifiez que le fichier modifié y figure, et que le server_name et la location attendus y sont. Un fichier absent de cette liste n'est pas lu : c'est une cause fréquente de « ma modification ne change rien ».
Que faire du bruit autour de la panne ?
Section intitulée « Que faire du bruit autour de la panne ? »Une configuration réelle contient du bruit qui a l'air suspect sans rien expliquer : un bloc server pour un domaine abandonné, un fichier de conf.d/ qui ne contient que des commentaires, une directive en double, un proxy_pass commenté. Le réflexe est de les « nettoyer » en premier ; c'est une perte de temps, et un risque de casser autre chose.
La règle est simple : un élément n'est une cause que si le symptôme observé passe par lui. Un proxy_pass commenté avec un mauvais port ne peut rien causer, puisqu'il n'est pas chargé : nginx -T ne le montre pas, ou le montre comme commentaire. Un bloc server pour un autre nom n'est sélectionné que pour ce nom. Pour savoir si un bloc ou une location est concerné par votre requête, rejouez-la avec curl -v en imposant le nom (-H 'Host: ...') et lisez la ligne correspondante dans le journal d'accès. On corrige une cause prouvée, jamais une impression.
Comment départager le proxy de l'application ?
Section intitulée « Comment départager le proxy de l'application ? »Rejouez la requête deux fois : une fois vers le proxy, une fois directement vers le backend sur son adresse locale. Si la réponse directe est correcte et que celle du proxy ne l'est pas, la panne est dans la liaison ou dans le proxy. Si les deux échouent pareil, l'application est en cause, et la configuration de Nginx n'y est pour rien.
# Par le proxy, avec le nom de la publicationcurl -sv -H 'Host: publication.exemple.test' http://127.0.0.1/api/ -o /dev/null
# Directement vers le backend (adresse et port à relever dans nginx -T)curl -sv http://127.0.0.1:18102/ -o /dev/null
Comparez les codes de réponse et la ligne < des en-têtes dans chaque sortie ; l'adresse du backend se lit dans la directive proxy_pass de nginx -T. Puis ouvrez le journal d'accès : un upstream_status renseigné dit que Nginx a tenté l'amont, et avec quel code. Attention : sur une connexion refusée ou un délai dépassé, c'est Nginx qui inscrit 502 ou 504, et l'application peut n'avoir rien répondu ; le journal d'erreur tranche. Une exception mérite d'être connue : si le client ferme la connexion avant la réponse, Nginx finalise la requête en 499, un code qui lui est propre, écrit avant le statut de l'amont. Un 499 ne dit donc rien de l'application : il dit que le demandeur est parti. Quand les deux réponses sont différentes, la différence est votre piste.
Où est le journal d'erreur, et que dit-il ?
Section intitulée « Où est le journal d'erreur, et que dit-il ? »Le journal d'erreur est le fichier que désigne la directive error_log, et il donne le motif exact d'un refus que le code de statut ne dit pas. Le chemin ne se devine pas, il se lit : sudo nginx -T | grep -n error_log. Sur Debian 13, avec le paquet de nginx.org, il est écrit dans /var/log/nginx/error.log. Un point mérite l'attention : Nginx a deux sorties. Les messages de fonctionnement partent dans le fichier de error_log, tandis que journalctl -u nginx ne montre que ce que le service a écrit sur sa sortie d'erreur, par exemple un démarrage ou un rechargement refusé. Chercher une requête refusée dans journalctl fait chercher au mauvais endroit.
Le niveau compte aussi : par défaut, seules les erreurs sont écrites. Pour comprendre une sélection de route ou une négociation, relevez temporairement le niveau (error_log ... info;), rechargez, rejouez, puis revenez en arrière : un niveau très bas écrit beaucoup et finit par masquer l'utile.
Voici ce que chaque famille de panne laisse le plus souvent comme trace. Les fragments sont des morceaux du texte de l'erreur, pas des libellés garantis ; la ligne complète nomme aussi le fichier, l'adresse ou le certificat.
| Symptôme | Fragment typique dans error.log | Ce qu'il désigne |
|---|---|---|
403 | Permission denied | Un fichier ou un répertoire du chemin n'est pas lisible par le worker (le processus Nginx qui traite les requêtes) |
404 | No such file or directory | Le chemin tenté n'existe pas : voir root ou alias |
502 | Connection refused | Rien n'écoute sur l'adresse du backend |
502 | certificate verify ou does not match | Le certificat du backend n'est pas accepté |
504 | timed out | Le backend n'a pas répondu dans le délai fixé |
413 | too large body | Le corps dépasse client_max_body_size |
Le tableau se lit en deux temps : le code vient du journal d'accès, le fragment du journal d'erreur, et c'est leur paire qui oriente. Un 502 sans fragment connu est à relire en entier : il nomme l'adresse en cause. À vérifier en machine : les fragments certificate verify, does not match, timed out et too large body viennent du code de Nginx (par exemple upstream SSL certificate does not match, client intended to send too large body), tandis que Permission denied, No such file or directory et Connection refused sont le texte du système, entre parenthèses derrière un numéro (13:, 2:, 111:). L'association entre un code HTTP et un fragment donné n'a pas été vérifiée en machine : le tableau oriente la recherche, il ne promet aucun libellé exact. Comparez avec ce que votre journal affiche.
Comment résoudre un 403 et un 404 sans desserrer les droits ?
Section intitulée « Comment résoudre un 403 et un 404 sans desserrer les droits ? »Un 403 de permission veut dire qu'un compte ne peut pas parcourir ou lire un chemin : on corrige le propriétaire, le groupe ou le mode du fichier concerné, pas ceux de tout le système. Les workers tournent sous un compte non privilégié (nginx avec le paquet de nginx.org, directive user), et il faut deux droits : le droit de traverser (x) chaque répertoire du chemin, et le droit de lire (r) le fichier. Il suffit qu'un seul maillon manque.
La commande namei -l affiche le propriétaire et le mode de chaque maillon d'un chemin, ce qui désigne le répertoire fautif d'un coup d'œil :
namei -l /var/www/catalogue/index.htmlCherchez le premier maillon dont le mode n'accorde pas x (répertoire) ou r (fichier) au compte du worker, puis corrigez uniquement celui-là. Pour la lecture des modes, voir Permissions Linux.
Pour un 404, la ligne d'erreur qui porte No such file or directory nomme en principe le chemin réel tenté. Comparez-le à celui que vous attendiez : root ajoute l'URL entière au répertoire, alias remplace le préfixe de la location. Le détail est dans Servir des fichiers avec Nginx. Si le chemin est le bon mais la route n'est pas celle attendue, retournez à nginx -T : une location plus prioritaire a capté la requête, et l'ordre de sélection (=, puis ^~, puis les expressions régulières dans l'ordre du fichier, puis le plus long préfixe) n'est pas celui de l'écriture.
Comment résoudre un 502 ou un 504 ?
Section intitulée « Comment résoudre un 502 ou un 504 ? »Un 502 dit que Nginx n'a pas obtenu de réponse valide du backend ; un 504 dit qu'il l'a attendue trop longtemps. Le journal d'erreur départage les causes, et chacune a son correctif propre.
- Le nom ne se résout plus. Un nom de domaine placé dans
proxy_passou dans unupstreamest résolu au chargement : si le nom a disparu (une ligne de/etc/hostsretirée, un DNS qui ne répond plus),nginx -tou le démarrage échoue en nommant le fichier et la ligne, si bien que ce cas se détecte à la validation, avant même un502. Les détails de la résolution sont dans Nginx upstream. - Le backend refuse la connexion.
Connection refused: le service n'écoute pas sur l'adresse ou le port deproxy_pass. Vérifiez le service lui-même, pas Nginx. - Le certificat du backend n'est pas accepté. Avec
proxy_ssl_verify on, Nginx vérifie le certificat du backend contre l'autorité fournie parproxy_ssl_trusted_certificateet le nom donné parproxy_ssl_name. Un502accompagné d'un message de vérification signale une autorité absente ou un nom qui ne correspond pas : on corrige le fichier d'autorité ou le nom, jamais la vérification. - Le délai est plus court que le service.
timed outsur une route que l'application sait servir lentement : la borneproxy_read_timeoutest trop basse pour un usage légitime.
Un proxy_read_timeout allongé ne répare pas un backend indisponible : il fait seulement attendre plus longtemps l'utilisateur, et il garde la connexion et le worker occupés. À l'inverse, un délai trop court refuse une lenteur légitime, et c'est alors une panne qu'on s'inflige. Le bon réglage se place entre la plus longue réponse normale et la patience tolérable. Pour les redirections, voir Nginx TLS ; pour la taille des corps, voir Nginx limites.
Comment prouver que la panne est réparée ?
Section intitulée « Comment prouver que la panne est réparée ? »Une réparation se prouve par une recette entière, positive et négative, rejouée après la correction. La recette positive vérifie que chaque route fait ce qu'elle doit : rendre son propre contenu. Un code 200 ne suffit pas : une route qui part vers le backend voisin répond aussi 200, et seul un marqueur propre à chaque route le montre. La recette négative vérifie ce qui doit rester refusé : un backend qui ne doit pas être joignable depuis le réseau, un certificat inconnu qui doit toujours donner 502, des workers qui ne doivent pas tourner en root, un répertoire qui ne doit pas être ouvert en écriture à tous.
La recette négative est celle qu'on oublie, et c'est elle qui attrape la correction qui répare une chose en cassant une autre, ou en desserrant une protection. Ajoutez un dernier contrôle : le délai d'une requête qui n'avance plus doit se solder par un 504 et non par un 000 ; avec curl, 000 signifie que c'est le client qui a abandonné, pas le proxy.
Terminez par le diagnostic écrit : le composant en cause, la cause, et les observations qui y ont mené (la commande lancée, la ligne de journal lue). Ce court texte est ce qui permet à une autre personne de comprendre sans refaire l'enquête.
Mettre en pratique
Section intitulée « Mettre en pratique »Dans le lab, une panne réelle a été injectée dans une pile de publication qui sert une page statique, deux backends et une route de contrôle. Elle est tirée au hasard parmi cinq familles : sélection de route, permission, résolution du nom, confiance TLS ou délai, avec du bruit de configuration autour. Vous trouvez la panne, la corrigez et rédigez un court fichier de diagnostic. La validation ne connaît pas la variante : elle rejoue l'état final de la recette, identique pour les cinq, vérifie que chaque route rend son marqueur, qu'une requête sans fin est coupée par un 504, que les workers ne tournent pas en root, que les ports des backends ne sont pas joignables depuis le réseau, que la racine statique n'est pas ouverte en écriture à tous, et qu'une route vers un backend à certificat inconnu reste refusée en 502.
À retenir
Section intitulée « À retenir »Un diagnostic est un ordre de lecture, pas une liste de codes.
- Lisez d'abord la configuration effective avec
nginx -T: c'est elle que le processus utilise. - Le champ
upstream_statusdu journal d'accès dit si l'amont a été contacté :-, le proxy a répondu seul ; renseigné, la tentative a eu lieu, sans prouver que l'application a répondu, car Nginx y inscrit lui-même502ou504sur un échec. - Le motif exact se lit dans le journal d'erreur, dont le chemin se lit avec
nginx -T | grep error_log;journalctl -u nginxne montre que la sortie du service. - Un
403se corrige en réparant le maillon de chemin fautif (namei -l), jamais parchmod 777ni en faisant tourner les workers enroot. rootajoute l'URL au répertoire,aliasremplace le préfixe : la ligne d'erreur nomme en principe le chemin réellement tenté.- Un
proxy_read_timeoutplus long ne répare pas un backend indisponible, etproxy_ssl_verify offne répare pas un certificat. - Un élément de configuration n'est une cause que si le symptôme passe par lui : le bruit autour ne se corrige pas d'abord.
- La réparation se prouve par une recette positive et négative, rejouée en entier, et se conclut par un diagnostic écrit.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de ce guide est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Déployer, mettre à jour et restaurer Nginx
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications