GitOps transforme Git en source de vérité déclarative pour l'état souhaité de vos systèmes. Concrètement : au lieu de vous connecter à un serveur pour modifier une configuration ou lancer un déploiement à la main, vous modifiez un fichier dans un dépôt Git. Un outil appelé opérateur (ou contrôleur) surveille ce dépôt en permanence et applique automatiquement les changements sur vos environnements.
Chaque modification passe par une pull request, ce qui permet une revue avant application. L'historique Git conserve la trace de qui a changé quoi, quand et pourquoi. En cas de problème, revenir en arrière consiste à faire un git revert.
Cette leçon couvre les fondamentaux : les quatre principes, la stratégie pull face à la stratégie push, le choix entre ArgoCD et Flux, une mise en œuvre pas à pas, puis les critères de réussite et les pièges à éviter.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Les quatre principes GitOps et pourquoi chacun compte
- La différence entre stratégie pull (recommandée) et stratégie push
- Comment structurer vos dépôts : app-repo et config-repo
- Comment choisir entre ArgoCD et Flux selon votre contexte
- Les critères pour valider que votre implémentation est solide
- Les pièges courants et comment les éviter
Prérequis
Section intitulée « Prérequis »Cette leçon suppose que vous savez ce qu'est un commit, une branche et une pull request dans Git, et que vous avez déjà manipulé un manifeste Kubernetes (un fichier YAML qui décrit un Deployment ou un Service). Elle s'appuie aussi sur l'idée d'Infrastructure as Code, présentée dans le guide Infrastructure as Code : décrire l'infrastructure dans des fichiers versionnés plutôt que la configurer à la main.
Pourquoi GitOps : le problème terrain
Section intitulée « Pourquoi GitOps : le problème terrain »Avant d'adopter GitOps, la plupart des équipes déploient leurs applications de manière impérative : quelqu'un se connecte au cluster, exécute kubectl apply, et espère que tout fonctionne. Cette approche pose des problèmes de traçabilité et de sécurité que vous reconnaîtrez peut-être si vous gérez déjà des environnements Kubernetes.
Les équipes sans GitOps rencontrent souvent ces symptômes :
- Déploiements manuels :
kubectl applyen direct, sans traçabilité - Drift non détecté : l'état réel diverge de l'état déclaré sans que personne ne le sache
- Pas de rollback simple : revenir en arrière oblige à retrouver la bonne configuration
- Accès trop larges : les développeurs ont des droits admin sur le cluster pour déployer
- Audit impossible : personne ne sait qui a changé quoi, ni quand
- Environnements incohérents : dev, staging et prod dérivent les uns des autres
Quels sont les quatre principes GitOps ?
Section intitulée « Quels sont les quatre principes GitOps ? »GitOps repose sur quatre principes définis par le projet OpenGitOps, issu du groupe de travail GitOps de la CNCF (Cloud Native Computing Foundation) et formalisés dans sa version 1.0.0. Ensemble, ils garantissent un déploiement fiable, traçable et reproductible, quel que soit l'outil qui les applique.
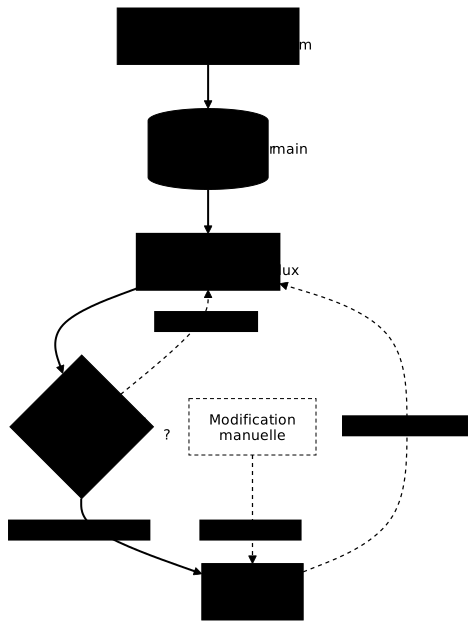
Le schéma résume la boucle que ces principes décrivent : l'état déclaré naît d'une pull request fusionnée, l'opérateur le compare sans cesse au cluster, et une modification manuelle n'est qu'une dérive de plus à corriger.
1. Déclaratif
Section intitulée « 1. Déclaratif »L'état souhaité est décrit dans des fichiers déclaratifs (YAML, HCL pour HashiCorp Configuration Language, JSON) : le fichier dit ce qui doit exister, pas la suite de commandes pour y arriver. C'est l'opposé d'un script impératif, qui décrit une séquence d'actions.
Pourquoi : un fichier déclaratif peut être versionné, comparé, audité. Un script impératif dépend de l'état initial du système au moment de son exécution, ce qui rend le résultat imprévisible si ce point de départ diffère.
2. Versionné et immuable
Section intitulée « 2. Versionné et immuable »Tout changement passe par Git : commit, pull request, review, merge. Chaque état appliqué correspond à un commit précis et immuable : impossible de le modifier après coup sans en laisser la trace.
Pourquoi : historique complet, rollback par git revert, audit natif, collaboration via pull request.
3. Récupéré automatiquement (pulled)
Section intitulée « 3. Récupéré automatiquement (pulled) »Un agent logiciel surveille le dépôt et récupère les changements sans intervention humaine, plutôt que de recevoir un ordre de déploiement d'un système externe.
Pourquoi : pas d'oubli, pas d'erreur de manipulation, déploiement reproductible à chaque merge. Aucun credential du cluster n'a besoin de sortir du périmètre de l'agent.
4. Réconcilié en continu
Section intitulée « 4. Réconcilié en continu »L'agent compare en permanence l'état réel à l'état déclaré et corrige les dérives automatiquement, sans attendre qu'un humain s'en aperçoive.
Pourquoi : si quelqu'un modifie le cluster à la main, l'agent remet l'état conforme au bout de quelques secondes ou minutes selon sa fréquence de synchronisation. Ce self-healing (autoréparation) constitue le principal bénéfice opérationnel de GitOps.
Pull ou push : qui déclenche le déploiement ?
Section intitulée « Pull ou push : qui déclenche le déploiement ? »Il existe deux grandes approches pour appliquer les changements Git sur vos environnements. La différence réside dans qui initie le déploiement, et ce choix conditionne directement votre surface d'attaque et les accès à sécuriser. Ne confondez pas ce choix avec les stratégies de déploiement comme le canary ou le blue-green : celles-ci décrivent comment la nouvelle version remplace l'ancienne, pull et push décrivent qui pousse la configuration.
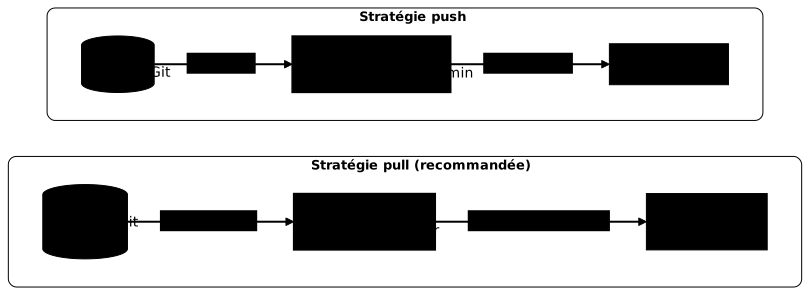
Stratégie pull (recommandée)
Section intitulée « Stratégie pull (recommandée) »En stratégie pull, un agent installé dans le cluster surveille Git et applique lui-même les changements. Ce renversement change la sécurité du dispositif : les accès au cluster ne quittent jamais le cluster.
Ses avantages :
- le pipeline CI n'a pas besoin d'accès au cluster ;
- la réconciliation continue corrige le drift sans intervention ;
- aucun credential du cluster n'est exposé dans la CI.
Les outils de référence sont ArgoCD, Flux et Fleet (Rancher).
Stratégie push
Section intitulée « Stratégie push »En stratégie push, c'est le pipeline CI qui pousse les changements vers le cluster, par exemple avec kubectl apply ou helm upgrade en fin de job. C'est le modèle historique du CI/CD.
Ses avantages :
- il est plus simple à mettre en place au départ ;
- il fonctionne hors Kubernetes (VM, ressources cloud).
Ses inconvénients :
- la CI détient un accès privilégié au cluster, donc un secret de grande valeur ;
- il n'y a pas de réconciliation continue : le drift n'est ni détecté ni corrigé.
ArgoCD ou Flux : quel opérateur choisir ?
Section intitulée « ArgoCD ou Flux : quel opérateur choisir ? »Pour Kubernetes, les deux opérateurs GitOps de référence sont ArgoCD et Flux. Les deux projets sont passés Graduated à la CNCF fin 2022 (Flux le 30 novembre, ArgoCD le 6 décembre), le plus haut niveau de maturité de la fondation : gouvernance ouverte, sécurité auditée, large adoption en production. Ils implémentent tous les deux les quatre principes et assurent une réconciliation continue solide.
Le tableau ci-dessous compare les deux outils sur les critères qui orientent le choix au quotidien. Lisez-le colonne par colonne : aucun n'est meilleur dans l'absolu, chacun porte une philosophie différente.
| Critère | ArgoCD | Flux |
|---|---|---|
| Interface utilisateur | Interface web intégrée | CLI et API ; interfaces web proposées par des projets tiers |
| Architecture | Serveur central avec ses composants | Ensemble de contrôleurs modulaires (GitOps Toolkit) |
| Multi-cluster | Une instance peut piloter plusieurs clusters | Un Flux par cluster, ou un cluster central qui pilote les autres |
| Approche | Opinionnée, centrée sur l'objet Application | Proche des API Kubernetes natives (CRD par fonction) |
| Notifications | Intégrées | Contrôleur de notifications inclus dans l'installation |
| Prise en main | Accessible grâce à l'interface | Plus technique, tout passe par des manifestes |
Comment choisir :
- vous débutez avec GitOps et voulez une visibilité immédiate : ArgoCD ;
- vous préférez une approche 100 % déclarative, orientée contrôleurs : Flux ;
- vous gérez de nombreuses équipes aux périmètres distincts : les deux conviennent, ArgoCD intègre davantage son RBAC et ses
AppProject. C'est aussi le terrain naturel du platform engineering, qui construit des plateformes internes en libre-service au-dessus de ces briques.
Les deux projets renforcent aussi la sécurité de la chaîne d'approvisionnement. ArgoCD sait par exemple vérifier la signature GPG des commits avant de synchroniser, et chiffrer en TLS les échanges entre ses composants internes : deux protections contre l'injection de manifestes non autorisés. Ces fonctions évoluent d'une version majeure à l'autre : lisez le changelog de la version installée avant une mise en production.
Pour du GitOps hors Kubernetes (Terraform, Ansible), des outils comme Atlantis, le Pulumi Kubernetes Operator ou Spacelift appliquent la même logique de revue par pull request.
Mise en œuvre pas à pas
Section intitulée « Mise en œuvre pas à pas »Les cinq étapes ci-dessous suivent l'ordre d'une première adoption : on structure les dépôts, on installe l'opérateur, on fixe le workflow, puis on traite les secrets et les environnements.
Étape 1 : structurer les dépôts
Section intitulée « Étape 1 : structurer les dépôts »Séparez le code applicatif et les manifestes de déploiement en deux dépôts distincts. Le premier produit une image ; le second décrit où et comment elle tourne :
app-repo/           # Code source + CI  src/  Dockerfile  .github/workflows/build.yml
config-repo/        # Manifestes GitOps  base/    kustomization.yaml    deployment.yaml    service.yaml  overlays/    dev/    staging/    prod/
Pourquoi deux dépôts : le code applicatif change souvent (commits de fonctionnalité) alors que les configurations de déploiement suivent un autre rythme (promotions, releases). Mélanger les deux crée du bruit dans l'historique et complique l'audit.
Étape 2 : installer l'opérateur
Section intitulée « Étape 2 : installer l'opérateur »L'opérateur GitOps (ArgoCD ou Flux) s'installe dans le cluster qu'il doit surveiller : c'est lui qui portera ensuite les accès au dépôt Git et à l'API Kubernetes locale, jamais la CI. L'installation crée un jeu de contrôleurs qui tournent en continu et qu'il faut inclure dans votre supervision au même titre que vos autres charges critiques.
Avec ArgoCD, par Helm (le gestionnaire de paquets de Kubernetes), en épinglant la version du chart pour que deux installations donnent le même résultat :
helm repo add argo https://argoproj.github.io/argo-helmhelm install argocd argo/argo-cd --version 10.9.6 \ --namespace argocd --create-namespaceLe chart 10.9.6 installe Argo CD v3.5.3. Vérifiez que les pods démarrent avec kubectl get pods -n argocd : tous doivent passer à l'état Running avant de configurer une première application.
Avec Flux, par sa CLI et la commande flux bootstrap (un jeton GitHub doit être disponible dans la variable GITHUB_TOKEN) :
flux bootstrap github \ --owner=mon-org \ --repository=config-repo \ --branch=main \ --path=clusters/mon-clusterCette commande crée le dépôt de configuration s'il n'existe pas, y commite les manifestes des contrôleurs Flux, puis les déploie : Flux se gère ainsi lui-même en GitOps. flux check confirme ensuite que chaque contrôleur est opérationnel.
Étape 3 : définir le workflow de contribution
Section intitulée « Étape 3 : définir le workflow de contribution »Une fois l'opérateur en place, le workflow de contribution décrit le chemin que suit chaque changement, de la modification d'un manifeste jusqu'à son application sur le cluster. Formaliser ces étapes évite les déploiements informels qui contournent la revue :
- le développeur modifie un manifeste dans une branche courte ;
- il ouvre une pull request, revue et validée automatiquement par
kubeconform(un validateur de manifestes contre les schémas Kubernetes) ; - la pull request est fusionnée dans
main; - l'opérateur détecte le nouveau commit et réconcilie le cluster ;
- une notification signale le succès ou l'échec.
Étape 4 : gérer les secrets
Section intitulée « Étape 4 : gérer les secrets »Les secrets ne doivent jamais être en clair dans Git. C'est le point le plus sensible d'une implémentation GitOps, car un dépôt Git a vocation à être cloné, forké, parcouru par plusieurs contributeurs : un secret en clair survit dans l'historique même après suppression du fichier. Trois approches dominent :
| Outil | Principe |
|---|---|
| Sealed Secrets | Chiffrement asymétrique : le secret chiffré est stocké dans Git, puis déchiffré dans le cluster par un contrôleur qui seul détient la clé privée |
| SOPS | Chiffrement des valeurs d'un fichier YAML avec une clé age ou PGP, ou une clé gérée par un KMS cloud (AWS KMS, GCP KMS, Azure Key Vault) |
| External Secrets | Synchronisation depuis un coffre-fort externe (Vault, AWS Secrets Manager) : Git ne contient que la référence, pas la valeur |
Le guide gestion des secrets détaille ces outils et les critères pour choisir entre eux.
Étape 5 : configurer les environnements
Section intitulée « Étape 5 : configurer les environnements »Utilisez Kustomize (un outil intégré à kubectl qui applique des correctifs, appelés patches, sur des manifestes de base sans les dupliquer) ou Helm pour gérer les variations entre environnements. Ici, l'overlay de production reprend la base et ne change que le nombre de réplicas :
apiVersion: kustomize.config.k8s.io/v1beta1kind: Kustomizationresources: - ../../basepatches: - path: patch-replicas.yamlLe correctif ne contient que ce qui diffère de la base, plus de quoi identifier la ressource visée (kind et metadata.name) :
apiVersion: apps/v1kind: Deploymentmetadata: name: cataloguespec: replicas: 3kubectl kustomize overlays/prod affiche le résultat : le Deployment catalogue de la base y apparaît avec replicas: 3. L'opérateur pointe vers l'overlay de chaque environnement. Cette approche évite de maintenir des copies quasi identiques des manifestes : seule la différence est versionnée, ce qui rend chaque écart explicite et revuable en pull request.
Critères de réussite
Section intitulée « Critères de réussite »Votre implémentation GitOps est solide quand vous pouvez cocher chacun des points suivants sans exception permanente. Utilisez cette liste comme grille d'audit avant de considérer une migration terminée.
- Aucun déploiement ne se fait par
kubectl applymanuel en dehors des incidents - Chaque changement en production a une pull request associée et fusionnée
- Le rollback se fait par
git revert, pas par manipulation directe du cluster - Les dérives (drift) sont détectées et corrigées automatiquement
- Les secrets ne sont jamais en clair dans le dépôt Git
- Les développeurs n'ont pas d'accès admin au cluster de production
- L'historique Git permet de répondre à « qui a changé quoi, quand »
- Les environnements (dev, staging, prod) sont gérés depuis le même dépôt de configuration
Scénarios concrets
Section intitulée « Scénarios concrets »Les deux scénarios suivants montrent comment ces étapes s'enchaînent sur des situations réelles : une migration depuis des déploiements manuels, puis la remise en ordre d'environnements qui ont dérivé.
Scénario 1 : migration progressive vers GitOps
Section intitulée « Scénario 1 : migration progressive vers GitOps »Contexte : une équipe développe une dizaine de microservices sur Kubernetes. Les déploiements se font par kubectl apply depuis les postes de travail. Des incidents surviennent à cause de configurations incohérentes entre staging et production.
Démarche possible :
- installation d'ArgoCD sur le cluster ;
- migration de deux services pilotes pour valider le workflow ;
- création du config-repo avec la structure
base/overlays; - formation de l'équipe au workflow pull request et synchronisation ArgoCD ;
- retrait progressif des accès
kubectldirects sur les clusters de production.
Ce que ça change : chaque déploiement est tracé dans Git, les environnements restent synchronisés, et le rollback se fait sans connaître la commande exacte appliquée lors de l'incident.
Scénario 2 : gestion multi-environnements
Section intitulée « Scénario 2 : gestion multi-environnements »Contexte : trois environnements (dev, staging, prod) dont les configurations dérivent. La production contient des paramètres « temporaires » jamais documentés.
Démarche possible :
- audit des configurations réelles face aux configurations déclarées, environnement par environnement ;
- création d'un config-repo unique avec un overlay Kustomize par environnement ;
- promotion explicite par pull request, de dev vers staging puis vers prod ;
- alertes ArgoCD configurées pour toute dérive détectée.
Ce que ça change : les différences entre environnements deviennent explicites, versionnées dans Git, et toute déviation est visible puis corrigée automatiquement.
Pièges courants
Section intitulée « Pièges courants »Certains pièges reviennent systématiquement lors d'une première adoption GitOps, souvent parce qu'ils ne se manifestent qu'une fois le système en production. Les connaître à l'avance évite de les découvrir lors d'un incident.
| Piège | Impact | Correctif |
|---|---|---|
| Secrets en clair dans Git | Fuite de credentials, non-conformité | Utiliser Sealed Secrets, SOPS ou External Secrets |
| Un seul dépôt app + config | Cycles de vie mélangés, bruit dans l'historique | Séparer en deux dépôts |
| Ignorer le drift | L'état réel diverge sans alerte | Configurer les alertes de l'opérateur |
| Trop de personnalisation par environnement | Maintenance complexe, merges difficiles | Garder les overlays minimaux, ne corriger que ce qui diffère |
| Pas de validation avant fusion | Manifestes invalides fusionnés et appliqués | Ajouter kubeconform dans la CI (kubeval n'est plus maintenu) |
| Accès kubectl conservés en prod | Contournement silencieux du workflow GitOps | Supprimer les accès après migration |
| Pas de stratégie de rollback testée | Panique en cas d'incident | Documenter et tester le git revert avant d'en avoir besoin |
| Oublier les CRD | L'opérateur échoue sur des ressources inconnues | Versionner les CRD dans le config-repo avec les autres manifestes |
À retenir
Section intitulée « À retenir »- Git est la source de vérité déclarative pour le périmètre géré par l'opérateur, pas pour tout le système au sens absolu.
- Quatre principes OpenGitOps : déclaratif, versionné et immuable, récupéré automatiquement, réconcilié en continu.
- Stratégie pull : l'opérateur tire les changements depuis Git, la CI ne touche pas le cluster.
- ArgoCD et Flux sont tous deux Graduated à la CNCF depuis fin 2022, un signal de maturité pour un choix en production.
- Deux dépôts : app-repo (code) et config-repo (manifestes) ont des cycles de vie différents.
- Réconciliation continue : le drift est détecté et corrigé automatiquement, le self-healing est le principal bénéfice opérationnel.
- Secrets séparés : jamais en clair dans Git, toujours chiffrés ou externalisés.
- Rollback = git revert : pas de manipulation manuelle, un commit suffit.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de ce guide est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Anti-patterns CI/CD
Continuer le cours : Les secrets dans les pipelines CI/CD
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications
FAQ : questions fréquentes
Section intitulée « FAQ : questions fréquentes »Les questions ci-dessous reprennent les points sur lesquels les équipes hésitent le plus quand elles adoptent GitOps : la différence avec le CI/CD classique, le choix de l'opérateur et les secrets.
kubectl apply, ce qui exige des accès privilégiés côté CI. GitOps repose sur une stratégie pull : un agent dans le cluster surveille Git et tire les changements lui-même. Ce renversement supprime l'exposition de credentials cluster dans la CI et ajoute une réconciliation continue qui corrige le drift automatiquement.git revert suffit pour revenir en arrière, et les développeurs n'ont plus besoin d'accès admin direct au cluster de production.