Le SAST (Static Application Security Testing) lit le code source d'une application sans l'exécuter et y repère les failles que vous avez vous-même écrites : injections, données non validées, appels dangereux. Cette leçon s'adresse à un DevOps ou un développeur qui veut comprendre ce qu'un scanner SAST voit réellement, ce qu'il ne voit pas, et comment le placer dans un pipeline sans noyer l'équipe sous les alertes. Les exemples s'appuient sur Semgrep 1.178.0, relevé sur une petite application Flask volontairement fautive.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Comprendre comment un scanner suit une donnée de sa source à son sink
- Distinguer ce que voient le SAST, la SCA et le DAST, et ce qui leur échappe
- Interpréter un vrai résultat SAST et repérer le bruit qu'il contient
- Placer le SAST dans un pipeline avec un blocage gradué
- Traiter un faux positif sans désactiver le contrôle pour tout le monde
- Rattacher ce contrôle à l'exigence SOCLE-APP-AST-1 du référentiel SOCLE
Qu'est-ce que le SAST ?
Section intitulée « Qu'est-ce que le SAST ? »Le SAST est une analyse statique : l'outil lit le code comme un relecteur très patient, sans lancer l'application. Il répond à une question précise, « mon code contient-il des constructions dangereuses ? », et c'est cette précision qui définit à la fois sa force et ses limites. Il voit tout le code, y compris une branche jamais exécutée par les tests, mais il ne voit ni l'application en marche ni le code des bibliothèques qu'elle importe.
Comment un scanner SAST raisonne-t-il ?
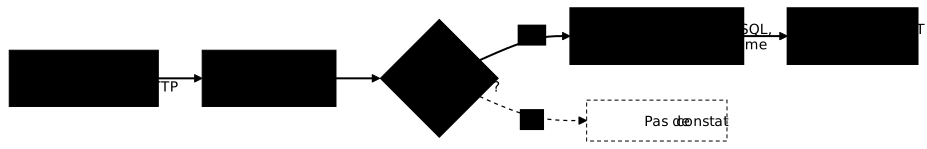
Section intitulée « Comment un scanner SAST raisonne-t-il ? »Un scanner moderne ne se contente pas de chercher des mots dans le texte. Il construit une représentation du programme, puis suit le chemin des données. Le vocabulaire est simple : une source est un point d'entrée contrôlé par l'extérieur (un paramètre HTTP), un sink est un appel dangereux (une requête SQL, une commande système), et le taint tracking consiste à vérifier si une donnée « teintée » par une source atteint un sink sans être assainie.
Le schéma montre ce raisonnement sur le cas de l'injection SQL : la donnée part d'un paramètre HTTP, traverse une variable, et ne produit un constat que si elle atteint le sink sans avoir été assainie en chemin.
-
Analyse syntaxique : le code devient un arbre syntaxique (AST), ce qui permet de reconnaître une concaténation ou un appel de fonction quelle que soit la mise en forme.
-
Correspondance de motifs : chaque règle décrit une construction dangereuse, par exemple « un appel à
subprocessavecshell=True». -
Suivi de flux : pour les règles de type taint, l'outil relie la source au sink à travers les variables intermédiaires.
-
Rapport : chaque constat indique la règle, le fichier, la ligne, une sévérité et souvent une piste de correction.
Que trouve le SAST, et que ne trouve-t-il pas ?
Section intitulée « Que trouve le SAST, et que ne trouve-t-il pas ? »Le SAST excelle sur les failles qui ont une forme reconnaissable dans le code : une donnée externe qui finit dans une requête, une fonction de hachage obsolète, une désérialisation non contrôlée. Il est en revanche structurellement aveugle à tout ce qui ne s'écrit pas en une construction locale : un contrôle d'accès oublié dans la logique métier, une faille dans une dépendance, une mauvaise configuration du serveur en production.
| Le SAST voit bien | Le SAST ne voit pas |
|---|---|
| Injections SQL, commande, chemin, XSS côté serveur | Un contrôle d'accès absent dans la logique métier |
| Cryptographie faible (MD5, SHA-1, mode ECB) | Les failles des dépendances tierces |
| Désérialisation de données non fiables | La configuration réelle du serveur déployé |
Appels système dangereux (shell=True, eval) | Ce qui dépend de l'exécution (session, timing) |
SAST, SCA, DAST : qui voit quoi ?
Section intitulée « SAST, SCA, DAST : qui voit quoi ? »Ces trois familles de contrôles se complètent parce qu'elles regardent trois objets différents. Le SAST lit votre code, la SCA (Software Composition Analysis) inventorie les bibliothèques que vous importez et les confronte aux vulnérabilités publiées, le DAST attaque l'application en marche. La fuite d'Equifax en 2017, 147 millions de personnes exposées, l'illustre bien : elle passait par une faille connue d'Apache Struts, une dépendance non mise à jour. C'est un cas d'école pour la SCA, pas pour le SAST, qui ne lit pas le code de Struts.
| Contrôle | Ce qu'il lit | Quand | Exemple de faille trouvée |
|---|---|---|---|
| SAST | votre code source | dès le commit | injection SQL dans votre route |
| SCA | vos dépendances | dès le commit | Struts vulnérable (Equifax) |
| DAST | l'application en marche | après déploiement de test | en-tête de sécurité absent, faille exploitable |
À quoi ressemble un vrai résultat SAST ?
Section intitulée « À quoi ressemble un vrai résultat SAST ? »Rien ne remplace un vrai scan pour comprendre le métier. L'application de test
tient en deux routes Flask : /user construit une requête SQL par
concaténation, /ping passe un paramètre à une commande système avec
shell=True. Le scan utilise le jeu de règles p/python du registre
Semgrep, téléchargé au lancement, et l'image officielle épinglée par digest.
L'option --metrics=off coupe l'envoi de statistiques d'usage à l'éditeur.
IMG="semgrep/semgrep:1.178.0@sha256:32e459968daabe7ab86968184a29109b9564aa00392401156f9788452b42786b"docker run --rm -v "$PWD:/src" -w /src "$IMG" \ semgrep scan --config p/python --metrics=off .Le scan remonte cinq constats pour deux failles réelles :
| Ligne | Règle | Sévérité |
|---|---|---|
| 9 | sql-injection-db-cursor-execute (règle Django) | WARNING |
| 11 | tainted-sql-string (règle Flask, taint) | ERROR |
| 19 | subprocess-injection | ERROR |
| 19 | dangerous-subprocess-use | ERROR |
| 19 | subprocess-shell-true | ERROR |
Ce tableau contient déjà les deux leçons du métier. D'abord, plusieurs règles signalent la même faille : trois constats pour une seule ligne 19. Ensuite, une règle écrite pour Django se déclenche sur du code Flask : elle a raison sur le fond, mais son intitulé égare. Le travail de tri commence donc avant même de parler de faux positifs, et il justifie de choisir un jeu de règles adapté à votre framework plutôt que d'activer tout le registre.
Le piège le plus coûteux est ailleurs : ce scan sort avec le code 0, malgré
cinq constats. Sans l'option --error, semgrep scan ne fait échouer aucun
pipeline, et un job « vert » peut cacher des injections. Avec --error, le même
scan sort en code 1, et c'est seulement là que le contrôle devient un
contrôle bloquant.
Choisir un outil SAST
Section intitulée « Choisir un outil SAST »Le choix se fait sur trois critères : les langages de vos dépôts, la licence au regard de votre usage, et la facilité à écrire vos propres règles. Dans cette formation, Semgrep sert d'implémentation de référence, pour ses règles lisibles et sa sortie SARIF, le format standard que GitHub et GitLab savent afficher. La leçon suivante lui est entièrement consacrée.
| Outil | Langages | Licence et usage | Point fort |
|---|---|---|---|
| Semgrep (CE) | 30+ | moteur libre, LGPL | règles lisibles, rapide, SARIF |
| Bandit | Python | libre, Apache 2.0 | simple, spécialisé Python |
| Bearer | JS, TS, Ruby, Python, Java, Go, PHP | source disponible, Elastic License 2.0 | flux de données sensibles |
| CodeQL | C/C++, C#, Go, Java, JS, Python, Ruby... | gratuit seulement pour le code open source | requêtes puissantes, intégré à GitHub |
| SonarQube | 25+ | édition communautaire LGPL, éditions avancées payantes | qualité et sécurité dans un tableau de bord |
La ligne CodeQL mérite une lecture attentive. Ses conditions d'utilisation autorisent l'outil sur du code publié sous licence open source ou pour la recherche académique, mais excluent explicitement l'analyse automatisée en intégration continue d'un code propriétaire sans contrat commercial. Sur un dépôt privé d'entreprise, il passe donc par une licence GitHub Advanced Security.
Le même principe statique s'applique à d'autres cibles que le code applicatif : les scanners IaC (Checkov, Trivy, KICS) lisent Terraform, Kubernetes ou un Dockerfile, les scanners de secrets (Gitleaks) lisent le code et l'historique Git. Ils ont leurs propres leçons dans la formation. Notez au passage que tfsec a été fondu dans Trivy par son éditeur, qui recommande désormais la migration : un guide qui le présente encore comme outil d'avenir est périmé.
Où placer le SAST dans la chaîne ?
Section intitulée « Où placer le SAST dans la chaîne ? »Le SAST se place à deux endroits qui ne jouent pas le même rôle. Sur le
poste, un hook pre-commit donne un retour immédiat au développeur, mais il
reste contournable d'un --no-verify. En CI, le même scan devient
incontournable et peut bloquer la fusion. Le poste sert le confort, la CI sert
la garantie : l'exigence SOCLE-APP-AST-1 demande précisément un SAST exécuté
à chaque build, avec des constats critiques bloquants.
Sur le poste : le hook pre-commit
Section intitulée « Sur le poste : le hook pre-commit »Semgrep publie ses hooks dans le dépôt semgrep/pre-commit, versionné comme
l'outil. Le hook ne scanne que les fichiers modifiés du commit, ce qui le
garde rapide. L'option --skip-unknown-extensions évite qu'il échoue sur un
type de fichier qu'aucune règle ne couvre.
repos: - repo: https://github.com/semgrep/pre-commit rev: v1.178.0 hooks: - id: semgrep args: ["--config", "p/python", "--error", "--skip-unknown-extensions"]En CI : un job qui bloque vraiment
Section intitulée « En CI : un job qui bloque vraiment »L'ancienne action semgrep-action est dépréciée par son éditeur, qui
recommande de lancer Semgrep directement dans son image officielle. Les deux
exemples ci-dessous suivent cette recommandation, avec l'image épinglée par
digest et l'option --error qui transforme les constats en échec du job.
Le job tourne dans le conteneur Semgrep. permissions: {} retire tous les
droits par défaut, contents: read suffit pour cloner, et
persist-credentials: false empêche le jeton de rester dans .git/config.
name: SAST
on:  pull_request:
permissions: {}
jobs:  semgrep:    runs-on: ubuntu-24.04    permissions:      contents: read    container:      image: semgrep/semgrep:1.178.0@sha256:32e459968daabe7ab86968184a29109b9564aa00392401156f9788452b42786b    steps:      - uses: actions/checkout@3d3c42e5aac5ba805825da76410c181273ba90b1 # v7.0.1        with:          persist-credentials: false      - name: Semgrep, échec sur constat        run: semgrep scan --config p/python --error --metrics=off .
Le job ne tourne que sur les merge requests. Sans --error, il passerait au
vert quel que soit le résultat, et allow_failure: false n'y changerait rien.
semgrep: stage: test image: semgrep/semgrep:1.178.0@sha256:32e459968daabe7ab86968184a29109b9564aa00392401156f9788452b42786b script: - semgrep scan --config p/python --error --metrics=off . rules: - if: $CI_PIPELINE_SOURCE == "merge_request_event" allow_failure: falseNe bloquer que les nouvelles failles
Section intitulée « Ne bloquer que les nouvelles failles »Activer un SAST bloquant sur un dépôt ancien fait échouer chaque merge
request à cause de la dette existante, et l'équipe finit par désactiver le
contrôle. L'option --baseline-commit règle ce problème : Semgrep compare au
commit indiqué et ne rapporte que les constats introduits depuis. Mesuré sur
le dépôt de test, le scan complet remonte 5 constats ; avec la branche
principale comme référence, il n'en remonte que 3, ceux de la nouvelle route
/ping, et sort bien en code 1 avec --error.
# Ne rapporter que ce qui a été introduit depuis la branche principalesemgrep scan --config p/python --error --baseline-commit "$(git merge-base origin/main HEAD)" .La dette ne disparaît pas pour autant : elle se traite dans un backlog daté, avec un scan complet planifié à côté, sinon la baseline devient un angle mort permanent.
Quelle stratégie de blocage ?
Section intitulée « Quelle stratégie de blocage ? »Bloquer sur tout paralyse les équipes, ne bloquer sur rien produit des rapports que personne ne lit. Une politique graduée fixe, par sévérité, ce qui bloque la fusion et ce qui ouvre seulement un ticket. Le point de départ raisonnable : bloquer sur les sévérités ERROR des règles de type taint, qui suivent une donnée externe réelle, et traiter le reste en revue.
| Sévérité Semgrep | Action | Exemple |
|---|---|---|
| ERROR | bloquer la fusion | donnée HTTP qui atteint une requête SQL |
| WARNING | ticket avec échéance | construction suspecte sans flux prouvé |
| INFO | information en revue | bonne pratique non suivie |
Gérer les faux positifs
Section intitulée « Gérer les faux positifs »Un faux positif est une alerte sur du code qui n'est pas réellement exploitable : la donnée est validée ailleurs, ou le code est un exemple de test. Mal traités, ils détruisent la confiance dans l'outil : une équipe qui ignore cent alertes finit par ignorer la cent unième, la vraie. Trois mécanismes existent, du plus ciblé au plus large, et le plus ciblé est presque toujours le bon.
Ignorer un constat précis : nosemgrep
Section intitulée « Ignorer un constat précis : nosemgrep »Le commentaire nosemgrep se pose sur la ligne où le constat est rapporté,
pas sur la ligne qui vous semble fautive. Mesuré sur une variante de
l'application de test, où la requête est d'abord construite dans une variable
query puis passée à cursor.execute(query) : un # nosemgrep posé sur la
ligne execute n'a rien retiré, parce que les constats étaient rapportés
sur d'autres lignes. Posé sur la ligne qui construit query, il a retiré ce
seul constat, et l'autre règle qui signalait la même faille est restée active.
# La forme qui nomme la règle n'éteint que celle-ci, sur cette lignequery = "SELECT * FROM users WHERE id = " + user_id # nosemgrep: python.flask.security.injection.tainted-sql-string.tainted-sql-stringNommez toujours la règle et justifiez l'exception en revue de code. Mesuré :
avec l'identifiant exact, le constat disparaît ; avec l'identifiant d'une autre
règle, il reste, ce qui protège d'une exception trop large. Un nosemgrep
nu, sans identifiant, éteint en revanche toutes les règles de la ligne. Pour
Bandit, l'équivalent est # nosec B105, avec l'identifiant du test.
Exclure des chemins : .semgrepignore
Section intitulée « Exclure des chemins : .semgrepignore »Le fichier .semgrepignore, à la racine du dépôt, exclut des chemins entiers
avec la syntaxe d'un .gitignore. Un piège mesuré change tout : sans ce
fichier, Semgrep applique une liste d'exclusion par défaut qui écarte déjà
tests/, et dès qu'un .semgrepignore existe, il remplace cette liste au
lieu de la compléter. Un fichier qui ne contient que qa/ fait donc soudain
scanner tests/, et un fichier vide fait tout scanner. Reprenez toujours les
exclusions par défaut que vous voulez garder. C'est le bon outil pour du code
généré ou des jeux de données, et un mauvais pour des tests qui contiennent
de la vraie logique.
tests/vendor/*.min.jsChanger de règles plutôt que de multiplier les exceptions
Section intitulée « Changer de règles plutôt que de multiplier les exceptions »Quand une même règle produit des faux positifs partout, le problème n'est plus la ligne mais le jeu de règles. Remplacez un registre large par celui de votre framework, ou écrivez une règle maison plus précise : c'est l'objet de la leçon Semgrep. Une exclusion globale qui grossit à chaque sprint est un contrôle désactivé qui ne dit pas son nom.
Dépannage
Section intitulée « Dépannage »La moitié des incidents SAST ne sont pas des failles mais des pipelines qui mentent. Un job vert ne prouve rien tant que vous n'avez pas vérifié qu'il peut échouer : poussez une fois une faille volontaire sur une branche de test et regardez le job tomber.
| Symptôme | Cause probable | Solution |
|---|---|---|
| Job vert malgré des constats | semgrep scan sans --error sort en code 0 | Ajouter --error |
| Erreur au téléchargement des règles | Pas d'accès réseau au registre Semgrep | Ouvrir l'accès ou versionner les règles dans le dépôt |
nosemgrep sans effet | Commentaire sur la mauvaise ligne | Le poser sur la ligne rapportée par le constat |
| Chaque MR échoue sur l'ancien code | Dette existante | --baseline-commit et backlog daté |
| Une règle Django sur du code Flask | Registre trop large | Choisir le jeu de règles du framework |
À retenir
Section intitulée « À retenir »- Le SAST lit votre code sans l'exécuter et suit une donnée de sa source à son sink.
- Il ne voit ni les dépendances (SCA) ni l'application en marche (DAST) : Equifax était un cas de SCA.
- Un vrai scan produit des doublons : plusieurs règles pour une seule faille.
- Sans
--error,semgrep scansort en code 0 et ne bloque rien. --baseline-commitne bloque que les failles nouvelles, la dette se traite à part.nosemgrepse pose sur la ligne rapportée, en nommant la règle.- CodeQL n'est gratuit que pour le code open source.
- Preuve attendue par SOCLE-APP-AST-1 : un job SAST bloquant et des tickets sur les constats critiques.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de cette leçon est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Analyse statique avec Semgrep
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications