Un audit demande que les conteneurs ne tournent plus sous root. Le geste paraît tenir en une ligne : ajouter un USER au Dockerfile, reconstruire, livrer. On le fait, et l'application cesse d'écrire, sur un répertoire que le Dockerfile vient de créer deux lignes plus haut. La tentation est alors de revenir en arrière, ou d'ouvrir le répertoire à tout le monde ; les deux font repartir l'application, et les deux ratent l'audit.
Cette leçon montre pourquoi, en séparant trois décisions que USER fait croire confondues, puis elle règle la façon dont l'image démarre. Elle ne traite que l'identité, les propriétaires et le démarrage. La leçon Organiser les couches et exploiter le cache vient après : elle traite de l'ordre des instructions du Dockerfile et du cache de construction, et n'est pas un prérequis. Les mesures qui suivent portent sur Docker 29.9.2, avec un socle alpine épinglé par digest, l'empreinte qui désigne son contenu exact.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Trois décisions distinctes : l'identité d'exécution, les droits des fichiers, la déclaration que l'image transmet
- Le piège mesuré :
USERchange l'uid du processus et aucun droit sur ce qui est déjà copié - La bonne réponse : aligner le propriétaire au build, pas élargir le mode
- L'ordre des instructions : pourquoi
USERse déclare en dernier - Le démarrage :
ENTRYPOINT,CMDet la forme exec, qui décident du processus qui reçoit les signaux COPY --chown: ce qu'il règle, ce qu'il laisse intact, et comment il échoue en silence- L'uid numérique : ce que
docker image inspecttransmet, et pourquoi un nom ne suffit pas - Ce qui n'est pas garanti :
--userau lancement écrase leUSERde l'image - Les ports sous 1024 : la vraie raison pour laquelle un non-root y écoute dans un conteneur
Prérequis
Section intitulée « Prérequis »La leçon Écrire un Dockerfile suffit comme socle : FROM, RUN, COPY et CMD. Il faut aussi un moteur Docker en service, et un répertoire de travail jetable.
L'application d'exemple, qui lit et qui écrit
Section intitulée « L'application d'exemple, qui lit et qui écrit »L'application d'exemple fait deux choses, et c'est volontaire : elle dit son identité et elle écrit un relevé de charge machine. Une image qui se contente de lire passerait en non-root sans que rien ne casse, et le piège resterait invisible. Le script est exécutable sur l'hôte (chmod +x collecte.sh) avant chaque construction.
#!/bin/shset -eecho "uid=$(id -u) gid=$(id -g)"cut -d' ' -f1 /proc/loadavg >> /srv/collecte/charge.logecho "releves=$(wc -l < /srv/collecte/charge.log | tr -d ' ')"Trois décisions que l'on confond
Section intitulée « Trois décisions que l'on confond »Sortir une image de root fait intervenir trois choses qui se décident séparément, à des moments différents, et qui ne se remplacent pas.
L'identité d'exécution est l'uid que prend le processus, c'est-à-dire le numéro qui désigne un utilisateur pour le noyau (le gid, son équivalent pour un groupe). Elle se pose avec USER, et c'est tout ce que USER fait.
Les droits des fichiers sont le propriétaire (un uid et un gid) et le mode (qui peut lire, écrire ou exécuter) de ce que l'image contient. La leçon Droits sur un volume les lit en détail. Ils sont gravés dans les couches au moment où chaque instruction s'exécute, et aucune déclaration d'identité ne les modifie après coup.
La déclaration de l'image est ce que l'image transmet à qui la lance : le champ Config.User, que docker image inspect rend. Ce n'est pas l'identité effective du conteneur, c'est une valeur par défaut, et le schéma ci-dessous montre à quel endroit la ligne de commande peut la contredire.
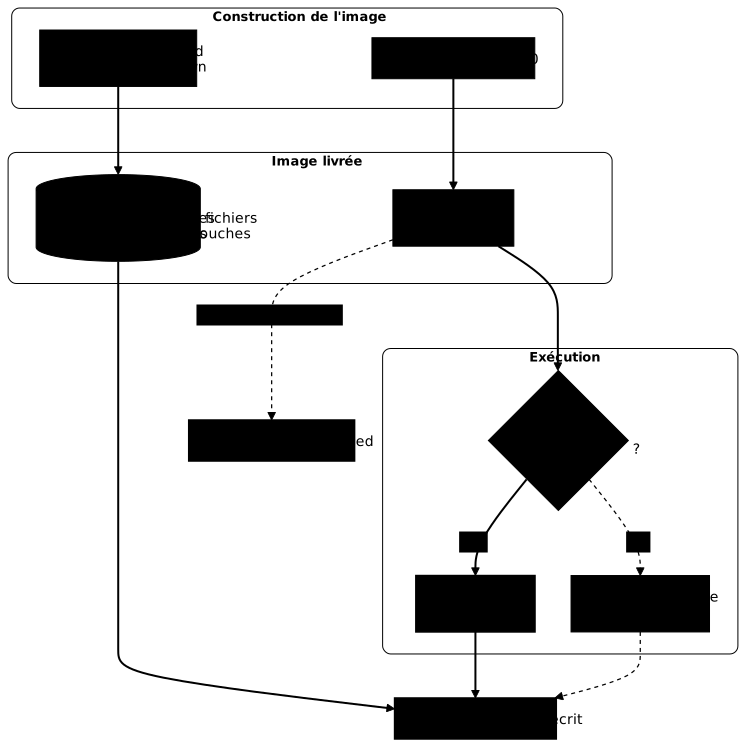
Le piège, mesuré
Section intitulée « Le piège, mesuré »Voici l'image de départ. Elle fonctionne, et elle tourne sous root. CMD fixe la commande que l'image lance par défaut, et la section sur le démarrage y revient.
FROM alpine:3.24@sha256:be2656061b536c1883c4034790e21d0a09c5aaaf51968b89368a3c0371ea2c9aRUN mkdir -p /srv/collecteCOPY collecte.sh /usr/local/bin/collecteCMD ["/usr/local/bin/collecte"]Ajoutons un utilisateur et la ligne qui change son identité, sans rien toucher d'autre :
FROM alpine:3.24@sha256:be2656061b536c1883c4034790e21d0a09c5aaaf51968b89368a3c0371ea2c9aRUN mkdir -p /srv/collecteCOPY collecte.sh /usr/local/bin/collecteRUN adduser -D -u 20500 collecteUSER 20500:20500CMD ["/usr/local/bin/collecte"]Chaque variante du Dockerfile est construite sous sa propre étiquette, collecte:root, collecte:user, collecte:sans-root et ainsi de suite, avec docker build -t collecte:root . pour la première. Ce suffixe dit laquelle est en jeu. La même application, sous les deux écritures :
docker run --rm collecte:rootuid=0 gid=0releves=1docker run --rm collecte:useruid=20500 gid=20500/usr/local/bin/collecte: line 4: can't create /srv/collecte/charge.log: Permission deniedL'identité a bien changé : l'uid passe de 0 à 20500. L'écriture, elle, est refusée. Il suffit de regarder le répertoire dans l'image pour voir pourquoi. L'option --entrypoint stat remplace la commande de l'image par stat, qui affiche propriétaire et mode sans lancer l'application :
docker run --rm --entrypoint stat collecte:user -c '%u:%g:%a %U' /srv/collecte0:0:755 rootLe RUN mkdir -p /srv/collecte s'est exécuté avant la ligne USER, donc sous root, et le répertoire appartient à root avec un mode 0755. Un processus d'uid 20500 n'y écrit pas, et c'est la règle ordinaire du système de fichiers : USER ne touche aucun fichier, aucun répertoire, aucun droit.
La bonne réponse : donner, pas ouvrir
Section intitulée « La bonne réponse : donner, pas ouvrir »Deux corrections font repartir l'application. La première consiste à donner le répertoire à l'utilisateur ; la seconde, à l'ouvrir à tout le monde avec un chmod 777. Les deux marchent, et la seconde défait exactement ce que le passage en non-root cherchait : n'importe quel processus du conteneur, quelle que soit son identité, peut alors y écrire.
La commande install -d crée un répertoire et fixe d'un coup son propriétaire (-o), son groupe (-g) et son mode (-m) : le répertoire n'existe jamais dans un état intermédiaire, propriété de root.
FROM alpine:3.24@sha256:be2656061b536c1883c4034790e21d0a09c5aaaf51968b89368a3c0371ea2c9aRUN adduser -D -u 20500 collecteRUN install -d -o 20500 -g 20500 -m 0700 /srv/collecteCOPY collecte.sh /usr/local/bin/collecteUSER 20500:20500CMD ["/usr/local/bin/collecte"]docker run --rm collecte:sans-rootdocker run --rm --entrypoint stat collecte:sans-root -c '%u:%g:%a %U' /srv/collecteuid=20500 gid=20500releves=120500:20500:700 collecteLe mode 0700 n'est pas décoratif : il dit que le droit vient du propriétaire et d'aucun autre. C'est ce qui distingue une correction d'un contournement, et un contrôle automatisé sait faire la différence en lisant le dernier chiffre du mode, celui des autres, qui doit rester sans écriture.
Deux détails de forme comptent dans ce Dockerfile. La création et l'attribution tiennent dans la même instruction, parce que le répertoire n'existe qu'à partir de là. Et l'uid est fixé à 20500 plutôt que laissé à l'image de base, pour que la valeur ne change pas quand l'image de base change de version.
Les autres étiquettes de la leçon sont des variantes de ces deux Dockerfile, dont on ne change que la ligne que chaque mesure décrit. Le tableau donne, pour chacune, le Dockerfile de base et la différence exacte :
| Étiquette | Dockerfile de base | Ce qui change |
|---|---|---|
collecte:chown | de départ | la ligne COPY devient COPY --chown=20500:20500 collecte.sh /usr/local/bin/collecte |
collecte:chownnom | de départ | la ligne COPY devient COPY --chown=collecte:collecte collecte.sh /usr/local/bin/collecte, sans adduser avant |
collecte:nom | corrigé | USER 20500:20500 devient USER collecte |
collecte:nominconnu | corrigé | USER collecte à la place de USER 20500:20500, et la ligne adduser supprimée |
collecte:uidseul | corrigé | la ligne adduser supprimée, USER 20500:20500 conservé |
L'ordre des instructions n'est pas libre
Section intitulée « L'ordre des instructions n'est pas libre »Toute instruction placée après USER s'exécute sous cette identité, sans pouvoir ni créer ni donner. Déplacer la ligne de trois rangs suffit à casser le build :
FROM alpine:3.24@sha256:be2656061b536c1883c4034790e21d0a09c5aaaf51968b89368a3c0371ea2c9aRUN adduser -D -u 20500 collecteUSER 20500:20500RUN mkdir -p /srv/collecte && chown collecte:collecte /srv/collectedocker build -t collecte:ordre .[...] > [3/3] RUN mkdir -p /srv/collecte && chown collecte:collecte /srv/collecte:0.130 mkdir: can't create directory '/srv/collecte': Permission denied------Dockerfile:4-------------------- 2 | RUN adduser -D -u 20500 collecte 3 | USER 20500:20500 4 | >>> RUN mkdir -p /srv/collecte && chown collecte:collecte /srv/collecte 5 |--------------------ERROR: failed to build: failed to solve: process "/bin/sh -c mkdir -p /srv/collecte && chown collecte:collecte /srv/collecte" did not complete successfully: exit code: 1La règle tient en une phrase : USER se déclare en dernier, juste avant la commande de démarrage, une fois que tout ce qui demandait des privilèges est fait.
Comment l'image démarre-t-elle : ENTRYPOINT, CMD et forme exec ?
Section intitulée « Comment l'image démarre-t-elle : ENTRYPOINT, CMD et forme exec ? »L'image démarre en lançant un seul processus, le PID 1 du conteneur (le processus numéro 1, celui auquel docker stop s'adresse), et l'utilisateur déclaré par USER est celui sous lequel il tourne. CMD donne la commande par défaut, que l'on remplace en la tapant après le nom de l'image dans docker run. ENTRYPOINT fixe au contraire le programme lancé : ce que l'on tape après le nom de l'image devient ses arguments, et CMD ne fournit plus que les arguments par défaut. Seule l'option --entrypoint, vue plus haut avec stat, le remplace.
Les deux s'écrivent sous deux formes. La forme exec est une liste JSON, comme dans les Dockerfile de cette page : CMD ["/usr/local/bin/collecte"] lance le programme directement, et c'est lui qui devient PID 1. La forme shell, CMD /usr/local/bin/collecte, confie la commande à /bin/sh -c, et ce qui devient PID 1 dépend alors du shell de l'image : le shell busybox d'Alpine remplace lui-même une commande unique par l'application, mais dès que la ligne enchaîne plusieurs commandes, le shell reste PID 1 et l'application n'est que son enfant. Or c'est à PID 1 que docker stop envoie le signal d'arrêt, et un shell ne le retransmet pas à l'application. Celle-ci ne s'arrête alors pas proprement, et le moteur finit par la tuer d'autorité.
La leçon Cycle de vie d'un conteneur et signaux mesure ces cas ; retenez ici deux règles : écrire ENTRYPOINT et CMD en forme exec, qui ne laisse rien au hasard du shell, et vérifier que le fichier lancé est exécutable et lisible par l'uid déclaré, puisque c'est ce compte qui le démarre.
COPY --chown : ce qu'il fait, et ce qu'il ne fait pas
Section intitulée « COPY --chown : ce qu'il fait, et ce qu'il ne fait pas »COPY --chown pose le propriétaire sur ce qu'il copie, au moment où il le copie. Il dispense d'un RUN chown séparé, et il économise une couche.
COPY --chown=20500:20500 collecte.sh /usr/local/bin/collectedocker run --rm --entrypoint stat collecte:chown -c '%n %u:%g %a' /usr/local/bin/collecte /srv/collecte/usr/local/bin/collecte 20500:20500 755/srv/collecte 0:0 755Le fichier copié appartient bien à 20500, et son mode reste celui qu'il avait dans le contexte de build : --chown change le propriétaire, pas les droits. Le répertoire /srv/collecte, créé par un RUN mkdir plus haut, appartient toujours à root : l'application échoue encore. Ce que COPY --chown ne fait pas est donc aussi important que ce qu'il fait. Il ne touche que ses propres destinations, il ne crée aucun utilisateur, et il ne corrige rien de ce qu'une autre instruction a déposé.
Il a un troisième comportement qui surprend. Un nom d'utilisateur se résout dans le /etc/passwd de l'image telle qu'elle est à cette étape. Si le nom n'existe pas, le build ne s'arrête pas : le fichier est écrit en 0:0, en silence. Avec COPY --chown=collecte:collecte et aucun adduser avant :
docker build -t collecte:chownnom .docker run --rm --entrypoint stat collecte:chownnom -c '%u:%g' /usr/local/bin/collecte[...]#8 naming to docker.io/library/collecte:chownnom done#8 unpacking to docker.io/library/collecte:chownnom 0.0s done#8 DONE 0.2s0:0Avec un RUN adduser -D -u 20500 collecte placé avant, le même COPY --chown=collecte:collecte rend bien 20500:20500. Le nom fonctionne donc, à condition d'exister au bon moment ; l'uid numérique, lui, n'a rien à résoudre.
La référence Dockerfile annonce pourtant que le build échoue si /etc/passwd ou /etc/group manquent ou ne contiennent pas les noms donnés. Le code de BuildKit (solver/llbsolver/ops/user_linux.go) fait autre chose : il laisse l'uid et le gid à zéro quand le nom est introuvable. C'est le comportement mesuré ci-dessus qui fait foi, pas la phrase de la documentation.
Déclarer l'utilisateur par un uid numérique
Section intitulée « Déclarer l'utilisateur par un uid numérique »USER accepte un nom comme des chiffres, et le conteneur tourne sous le bon uid dans les deux cas. La différence est dans ce que l'image transmet. Trois images, déclarées avec USER collecte, avec USER 20500:20500, et sans USER, donnent :
docker image inspect collecte:nom --format '{{.Config.User}}'docker image inspect collecte:sans-root --format '{{.Config.User}}'docker image inspect collecte:root --format '[{{.Config.User}}]'collecte20500:20500[]Un nom se résout dans le /etc/passwd de l'image. Un outil qui refuse les conteneurs root ne lit pas ce fichier : il lit la déclaration, et il ne peut pas prouver qu'un nom n'est pas root. Un uid numérique, lui, se vérifie sans rien ouvrir. La forme 20500:20500 déclare l'uid et le gid ; 20500 seul est également numérique et accepté.
Le nom a un second défaut, celui-là brutal : il se résout au lancement, et une image qui déclare un nom absent de son /etc/passwd ne démarre pas du tout. Le build, lui, est passé sans un mot.
docker run --rm collecte:nominconnudocker: Error response from daemon: unable to find user collecte: no matching entries in passwd file
Run 'docker run --help' for more informationUn uid numérique n'a pas ce point de rupture : il démarre même si aucune entrée ne lui correspond, et id rend alors l'uid sans nom.
docker run --rm --entrypoint id collecte:uidseuluid=20500 gid=20500 groups=20500Un chown 20500:20500 accepte les mêmes chiffres, si bien qu'une image non-root tient sans aucun adduser : elle tourne, elle écrit, et stat rend 20500:20500:700 UNKNOWN. Ce que l'entrée dans /etc/passwd apporte en plus est modeste mais réel : un $HOME (sinon /) et un uid que les outils savent nommer, là où whoami répond unknown uid 20500. C'est pour cela que le adduser reste dans le Dockerfile corrigé.
Le troisième cas mérite un regard : une image sans USER ne déclare rien du tout, pas même root. Elle tourne en root parce que c'est le défaut du moteur, et une chaîne vide ne se distingue pas d'une image dont on ignore l'intention.
Ce que l'image ne garantit pas
Section intitulée « Ce que l'image ne garantit pas »La déclaration est une valeur par défaut, pas une garantie. Qui lance décide :
docker run --rm --user 0:0 collecte:sans-rootuid=0 gid=0releves=1L'image non-root, lancée avec --user 0:0, tourne sous uid 0 et écrit sans difficulté. C'est pour cette raison qu'un contrôle qui veut mesurer ce qu'une image fait la lance sans aucune option d'identité : avec l'option, il mesurerait la commande. Et c'est aussi pourquoi le USER du Dockerfile ne remplace pas une politique côté plateforme : il dit l'intention de l'image, pas ce qu'une plateforme en fera.
Les ports sous 1024, et la croyance qu'ils entretiennent
Section intitulée « Les ports sous 1024, et la croyance qu'ils entretiennent »On lit souvent qu'un processus non root ne peut pas écouter sous le port 1024. Dans un conteneur Docker, il y arrive :
docker run --rm --user 20500:20500 alpine:3.24@sha256:be2656061b536c1883c4034790e21d0a09c5aaaf51968b89368a3c0371ea2c9a sh -c 'nc -l -p 80 & sleep 1; netstat -ltn | grep ":80 "'tcp 0 0 :::80 :::* LISTENLa raison n'est pas une capacité accordée au processus. Une capacité (capability) est un fragment des pouvoirs de root que le noyau accorde séparément, comme NET_BIND_SERVICE pour ouvrir un port bas ; la page Sécuriser Docker en production les présente. Un non-root dans un conteneur n'en a aucune :
docker run --rm --user 20500:20500 alpine:3.24@sha256:be2656061b536c1883c4034790e21d0a09c5aaaf51968b89368a3c0371ea2c9a grep -E '^Cap(Prm|Eff|Bnd)' /proc/self/statusCapPrm: 0000000000000000CapEff: 0000000000000000CapBnd: 00000000a80425fbL'ensemble effectif (CapEff, ce que le processus peut réellement exercer) est vide : seul l'ensemble englobant (CapBnd, le plafond) garde les capacités par défaut, et il ne sert qu'à borner ce qu'un processus pourrait acquérir. Ce qui rend le port 80 accessible est ailleurs, dans un réglage du noyau, ip_unprivileged_port_start (le premier numéro de port ouvert à tout processus), que le moteur pose dans l'espace de noms réseau du conteneur, c'est-à-dire dans la pile réseau propre à ce conteneur. Dans le conteneur, puis sur l'hôte :
docker run --rm alpine:3.24@sha256:be2656061b536c1883c4034790e21d0a09c5aaaf51968b89368a3c0371ea2c9a cat /proc/sys/net/ipv4/ip_unprivileged_port_startcat /proc/sys/net/ipv4/ip_unprivileged_port_start01024Deux mesures achèvent de le montrer. Retirer toutes les capacités du conteneur ne retire rien à l'écoute, et remettre le réglage à sa valeur habituelle fait revenir le refus, capacités intactes :
docker run --rm --cap-drop ALL --user 20500:20500 alpine:3.24@sha256:be2656061b536c1883c4034790e21d0a09c5aaaf51968b89368a3c0371ea2c9a sh -c 'nc -l -p 80 & sleep 1; netstat -ltn | grep ":80 "'docker run --rm --sysctl net.ipv4.ip_unprivileged_port_start=1024 --user 20500:20500 alpine:3.24@sha256:be2656061b536c1883c4034790e21d0a09c5aaaf51968b89368a3c0371ea2c9a nc -l -p 80tcp 0 0 :::80 :::* LISTENnc: bind: Permission deniedLe réglage appartient à l'espace de noms réseau du conteneur, et un conteneur lancé avec --network host partage celui de l'hôte. Il n'a alors plus son réglage à lui : le non-root retombe sur la valeur de l'hôte, ici 1024, et le refus revient. Le moteur interdit en plus de le corriger depuis la ligne de commande.
docker run --rm --network host --user 20500:20500 alpine:3.24@sha256:be2656061b536c1883c4034790e21d0a09c5aaaf51968b89368a3c0371ea2c9a nc -l -p 80 -w 1docker run --rm --network host --sysctl net.ipv4.ip_unprivileged_port_start=0 alpine:3.24@sha256:be2656061b536c1883c4034790e21d0a09c5aaaf51968b89368a3c0371ea2c9a truenc: bind: Permission denieddocker: Error response from daemon: failed to create task for container: failed to create shim task: OCI runtime create failed: runc create failed: sysctl "net.ipv4.ip_unprivileged_port_start" not allowed in host network namespaceLa conclusion pratique est courte : dans un conteneur Docker tel qu'il est livré et hors --network host, le port d'écoute n'est pas un argument pour rester root. Le choix du port se décide sur la lisibilité et sur la publication, pas sur les privilèges. Le reste du durcissement d'un conteneur non privilégié, dont les capacités à retirer, est traité dans Sécuriser Docker en production.
Comment nettoyer les images de cette leçon ?
Section intitulée « Comment nettoyer les images de cette leçon ? »Chaque variante construite reste dans le magasin d'images local. Cette commande retire celles de la leçon ; si vous n'avez pas construit toutes les variantes, elle signale celles qui manquent et retire les autres.
docker rmi collecte:root collecte:user collecte:sans-root collecte:chown collecte:chownnom collecte:nom collecte:nominconnu collecte:uidseulMettre en pratique
Section intitulée « Mettre en pratique »Le lab vous remet dans la situation du départ avec votre propre application : une image qui tourne, qui écrit, et qui est root. Vous ajoutez le USER, vous lisez le Permission denied, puis vous corrigez. La validation porte sur l'état du système et sur le moyen autant que sur l'effet : quatre contrôles de poids égal vérifient que l'image tourne sous un uid non nul sans qu'aucune option ne le lui impose, qu'elle écrit toujours son journal, que le répertoire de données lui appartient sans être inscriptible par tous, et qu'elle déclare son utilisateur par un uid numérique. Un chmod 777 fait passer le deuxième contrôle et échoue au troisième ; un USER par nom passe les trois premiers et échoue au quatrième.
À retenir
Section intitulée « À retenir »-
USERchange l'identité d'exécution et aucun droit. Les répertoires créés avant lui appartiennent à root, et l'application non-root n'y écrit plus. -
Aligner le propriétaire, ne pas élargir le mode. Donner le répertoire à l'utilisateur au build, avec un mode qui n'ouvre rien aux autres, fait écrire l'application ; un
chmod 777aussi, et il défait le bénéfice du passage en non-root. -
USERse déclare en dernier, juste avant la commande de démarrage : toute instruction qui le suit s'exécute sans privilège et échoue à créer ou à donner. -
Le démarrage s'écrit en forme exec.
ENTRYPOINTetCMDen liste JSON font de l'application le PID 1, celui qui reçoit le signal d'arrêt, alors que la forme shell laisse au shell de l'image le soin de décider, et le garde en PID 1 dès que la ligne enchaîne plusieurs commandes. -
COPY --chownne vaut que pour ses propres destinations. Il ne crée aucun utilisateur, ne corrige rien de ce qu'une autre instruction a déposé, et retombe silencieusement sur0:0si le nom donné n'existe pas encore dans l'image. -
Déclarer l'uid en chiffres. Un nom se résout dans le
/etc/passwdde l'image ; un uid numérique se lit dansConfig.Usersans rien ouvrir. Une image sansUSERne déclare pasroot, elle ne déclare rien. -
La déclaration est un défaut, pas une garantie.
docker run --user 0:0ramène l'image non-root sous uid 0 : mesurer une image se fait sans option d'identité. -
Le port 80 n'oblige pas à rester root. Un non-root n'a aucune capacité effective dans un conteneur, et il y écoute quand même parce que le moteur abaisse
ip_unprivileged_port_startà 0.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de ce guide est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Organiser les couches et exploiter le cache
Continuer le cours : Sécuriser Docker en production
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications