Dans une stack Compose, depends_on ordonne le lancement des conteneurs, pas leur disponibilité. Un service peut démarrer pendant que sa base initialise encore ses données, et son premier essai de connexion échoue. Cette leçon s'adresse à un débutant qui sait déjà écrire une stack Compose : vous apprenez à faire attendre un service jusqu'à ce que sa base réponde vraiment.
Pour cela, vous donnez à la base une sonde de santé (healthcheck), une commande que Docker lance régulièrement pour savoir si le service est prêt. Vous faites ensuite attendre le service dépendant, d'abord sur cette santé avec service_healthy, puis sur la fin d'une migration avec service_completed_successfully. Vous constatez enfin ce que Docker ne fait pas : un service devenu unhealthy n'est ni redémarré ni isolé. L'application doit donc réessayer elle-même.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Constater qu'un
depends_onsans condition ne garantit pas qu'une base soit prête. - Déclarer un
healthchecket choisir une sonde qui teste ce dont le dépendant a besoin. - Conditionner un service à la santé d'un autre avec
service_healthy. - Faire attendre une tâche ponctuelle, comme une migration, avec
service_completed_successfully, et lire son échec. - Expliquer pourquoi l'application doit réessayer quand sa dépendance disparaît, et reconnaître un client sans reprise.
- Constater qu'un service
unhealthyn'est pas redémarré par Docker.
Prérequis
Section intitulée « Prérequis »Il vous faut un hôte Linux avec Docker Engine 29.9.2 et son plugin Compose 5.6.1, installés depuis le dépôt officiel comme le montre la leçon d'installation de Docker. Les images sont épinglées par leur empreinte.
Vous savez écrire une stack avec la leçon Décrire une application avec Compose. Trois leçons voisines servent de base :
- Interpolation et fichiers d'environnement, pour
${VARIABLE:-défaut}et$$; - Persister les données d'une stack recréée, qui montre que l'image
postgresexécute son script d'initialisation sur un volume vide, et qu'il faut y relancer la requête tant que la base ne répond pas ; - Injecter les secrets, et connaître leurs limites, car la démonstration ci-dessous se passe d'un secret pour rester courte.
Les états d'un conteneur (Exited, Restarting) et les politiques de redémarrage sont expliqués dans Lire un conteneur qui ne démarre pas ou redémarre en boucle. Cette page ne les redit pas.
Vous travaillez dans un dossier ~/librairie, que la leçon vous fait créer. Le nom du dossier devient le nom du projet : les conteneurs s'appellent librairie-....
Pourquoi un service démarré n'est-il pas un service prêt ?
Section intitulée « Pourquoi un service démarré n'est-il pas un service prêt ? »Parce que depends_on, écrit sous sa forme courte, attend seulement que le conteneur dont on dépend soit lancé. Le programme qu'il contient peut ne pas encore répondre. Sur une machine rapide, une base qui s'initialise en une demi-seconde donne l'impression que l'ordre suffit. Pour voir le problème, il faut donc une base qui met vraiment du temps.
Créez le dossier, puis un script d'initialisation qui fait une pause de six secondes. Ce script simule une initialisation longue : l'image postgres l'exécute au premier démarrage, quand son dossier de données est vide.
mkdir -p ~/librairie/initdb ~/librairie/migrations ~/librairie/sitecd ~/librairieprintf 'SELECT pg_sleep(6);\n' > initdb/01-delai.sqlÉcrivez ensuite un premier compose.yaml. Le service base est un PostgreSQL. Le service catalogue essaie une seule fois de lire la base, affiche un message s'il échoue, puis reste en vie pour que vous puissiez lire ses journaux.
services:  base:    image: postgres:18.6-alpine3.24@sha256:10a5c69a83035ab5239f5620d708520e8b28f5aa1f2b20143e6024532edadfb5    environment:      POSTGRES_USER: librairie      POSTGRES_PASSWORD: demo-seulement      POSTGRES_DB: librairie    volumes:      - ./initdb:/docker-entrypoint-initdb.d:ro
  catalogue:    image: postgres:18.6-alpine3.24@sha256:10a5c69a83035ab5239f5620d708520e8b28f5aa1f2b20143e6024532edadfb5    environment:      PGPASSWORD: demo-seulement    command:      - sh      - -c      - psql -h base -U librairie -d librairie -tAc 'SELECT 1' || echo 'connexion impossible'; exec sleep infinity    depends_on:      - base
La valeur demo-seulement est celle d'une démonstration jetable, comme dans les leçons voisines : une vraie base reçoit son mot de passe par un secret. La variable PGPASSWORD donne ce mot de passe au client psql du service catalogue.
Le service catalogue réutilise l'image postgres parce qu'elle contient le client psql. Lancez la stack et lisez ce qu'il a affiché. Au tout premier lancement, Compose télécharge d'abord l'image, ce qui ajoute des lignes de progression avant celles ci-dessous.
docker compose up -ddocker compose logs catalogue[+] up 3/3 ✔ Network librairie_default Created 0.0s ✔ Container librairie-base-1 Started 0.3s ✔ Container librairie-catalogue-1 Started 0.4scatalogue-1 | psql: error: connection to server at "base" (172.18.0.2), port 5432 failed: Connection refusedcatalogue-1 | Is the server running on that host and accepting TCP/IP connections?catalogue-1 | connexion impossibleRegardez deux choses. Compose a lancé catalogue dès que base était démarré : la sortie ne montre aucune attente. Et la connexion est refusée, parce que la base n'écoute pas encore le réseau. L'adresse IP affichée peut différer chez vous. Attendez dix secondes, puis refaites la même requête depuis catalogue.
docker compose exec catalogue psql -h base -U librairie -d librairie -tAc 'SELECT 1'1La base répond maintenant. Elle n'est donc pas en panne : c'est catalogue qui est parti trop tôt, et rien dans le fichier ne le lui interdisait.
Comment déclarer une sonde de santé ?
Section intitulée « Comment déclarer une sonde de santé ? »Une sonde de santé est une commande que Docker lance régulièrement dans le conteneur : un code de sortie 0 la déclare réussie, tout code non nul la déclare échouée (Docker recommande le code 1). Docker en tire un état, visible dans docker inspect et docker compose ps.
Grâce à la sonde, le conteneur est dans l'un de trois états. Il est starting avant le premier succès, healthy quand la dernière sonde a réussi, et unhealthy après retries échecs consécutifs hors période de grâce. Le tableau donne les six réglages d'un healthcheck Compose, avec les valeurs par défaut de Docker.
| Réglage | Rôle | Défaut |
|---|---|---|
test | la commande, en ["CMD", ...] sans shell ou en ["CMD-SHELL", "..."] avec shell | aucune |
interval | délai entre deux sondes | 30 s |
timeout | durée au-delà de laquelle une sonde compte comme échouée | 30 s |
retries | nombre d'échecs consécutifs avant unhealthy | 3 |
start_period | période de grâce pendant laquelle les échecs ne comptent pas | 0 s |
start_interval | délai entre deux sondes pendant start_period (Docker Engine 25.0 ou plus) | 5 s |
La période de grâce ne retarde pas l'état healthy : une sonde qui réussit pendant start_period déclare tout de suite le service sain. Elle évite seulement de compter comme échecs les essais d'un service lent à démarrer. Pendant cette période, les sondes se suivent au rythme de start_interval et non d'interval.
Ces réglages fixent aussi le délai de détection d'une panne : environ interval fois retries, plus la durée de chaque sonde, et un peu moins si la panne tombe en milieu d'intervalle. Avec interval: 2s et retries: 3, le passage à unhealthy prend quelques secondes (4,6 secondes mesurées plus bas, sur un service nginx). Avec les valeurs par défaut, il prend environ une minute et demie, ce qui est long pour une démonstration et souvent raisonnable en production.
Quelle commande choisir pour tester une base PostgreSQL ?
Section intitulée « Quelle commande choisir pour tester une base PostgreSQL ? »La commande pg_isready répond à la question « le serveur accepte-t-il des connexions ? », mais sa réponse dépend de la façon de l'interroger. Au premier démarrage, l'image postgres lance d'abord un serveur temporaire, qui n'écoute que sur un point de connexion local au conteneur (le socket). Il exécute le script d'initialisation, s'arrête, puis le vrai serveur démarre sur le réseau.
Un pg_isready sans adresse interroge le socket : il peut répondre « prêt » trop tôt, alors que les autres conteneurs, qui passent par le réseau, sont encore refusés.
Mesurez-le. Repartez d'un volume vide, démarrez la base seule, puis lancez les deux formes de la commande dans les cinq premières secondes.
docker compose down -vdocker compose up -d basedocker compose exec base pg_isready -U librairie -d librairiedocker compose exec base pg_isready -h 127.0.0.1 -U librairie -d librairie/var/run/postgresql:5432 - accepting connections127.0.0.1:5432 - no responseLa première ligne annonce « accepting connections » à un moment où aucun autre conteneur ne peut encore se connecter. La seconde dit la vérité. Dans la mesure, répétée toutes les demi-secondes, la forme sans adresse répondait dès 0,8 seconde, et la forme -h 127.0.0.1 seulement à partir de 7,4 secondes, après la fin de l'initialisation. La sonde doit donc passer par -h 127.0.0.1, que le serveur temporaire n'écoute pas.
Si votre essai ne donne pas ce résultat, c'est une question de moment. Deux lignes « no response » : le serveur temporaire n'est pas encore lancé, attendez une seconde et relancez les deux commandes. Deux lignes « accepting connections » : vous avez dépassé les sept secondes, recommencez avec docker compose down -v.
Retenez le principe : une sonde teste ce dont le service dépendant a besoin, ici pouvoir se connecter par le réseau, et pas seulement l'existence du processus.
Ajoutez la sonde au service base du compose.yaml.
healthcheck: test: ["CMD-SHELL", "pg_isready -h 127.0.0.1 -U librairie -d librairie"] interval: 2s timeout: 3s retries: 10 start_period: 15sLes valeurs sont courtes pour la démonstration. La période de grâce de 15 secondes couvre largement l'initialisation de 6 secondes. Recréez la base et suivez son état toutes les deux secondes.
docker compose down -vdocker compose up -d basefor i in 1 2 3 4 5 6 7 8; do docker inspect -f '{{.State.Health.Status}}' librairie-base-1; sleep 2; donestartingstartingstartingstartingstartinghealthyhealthyhealthyRegardez le passage de starting à healthy. Il arrive après la fin de l'initialisation, pas au démarrage du conteneur : ici une dizaine de secondes après le lancement. Le calcul des sondes se trouve dans l'encadré facultatif plus haut.
Comment faire attendre un service jusqu'à ce que sa dépendance soit saine ?
Section intitulée « Comment faire attendre un service jusqu'à ce que sa dépendance soit saine ? »Avec la forme longue de depends_on, qui associe une condition à chaque dépendance. Il existe trois conditions, et seule la première est celle de la forme courte.
| Condition | Compose attend que la dépendance… | Cas d'usage |
|---|---|---|
service_started | soit lancée | aucun besoin d'être prête |
service_healthy | soit healthy | base, API, serveur qui met du temps à répondre |
service_completed_successfully | se soit terminée avec le code 0 | tâche ponctuelle, comme une migration |
La condition service_healthy suppose que la dépendance déclare un healthcheck : sans sonde, elle n'a rien à attendre. Modifiez le service catalogue pour la demander.
depends_on: base: condition: service_healthyRelancez la stack depuis un volume vide et regardez le déroulé.
docker compose down -vdocker compose up -ddocker compose logs catalogue[+] up 3/3 ✔ Network librairie_default Created 0.0s ✔ Container librairie-base-1 Healthy 10.8s ✔ Container librairie-catalogue-1 Started 10.9scatalogue-1 | 1Regardez les durées : base devient Healthy après environ dix secondes, et catalogue démarre juste après. Cette fois sa requête renvoie 1. Le service dépendant a été retardé jusqu'à ce que la base serve vraiment.
Comment attendre une tâche ponctuelle comme une migration ?
Section intitulée « Comment attendre une tâche ponctuelle comme une migration ? »Une migration est un script qui prépare le schéma de la base (tables, colonnes) avant que l'application ne s'en serve. Elle s'exécute une fois puis s'arrête : c'est une tâche, pas un service qui tourne. Vous la déclarez donc comme un service à part, et Compose attend sa fin réussie plutôt que sa santé.
Écrivez une migration répétable, comme celle de la leçon Persister les données d'une stack recréée : elle ne fait rien si son travail est déjà fait. Ici, IF NOT EXISTS et ON CONFLICT DO NOTHING évitent l'échec et le doublon au deuxième passage.
cat > migrations/001-livres.sql <<'EOF'CREATE TABLE IF NOT EXISTS livres ( id serial PRIMARY KEY, titre text NOT NULL UNIQUE);INSERT INTO livres (titre) VALUES ('Candide'), ('Germinal') ON CONFLICT DO NOTHING;EOFprintf 'SELEKT 1;\n' > migrations/002-erreur.sqlLe second fichier contient une faute volontaire, utilisée plus bas. Ajoutez ensuite le service migration, et faites attendre catalogue sur lui. Le fichier à exécuter se choisit par une variable, avec une valeur par défaut, pour pouvoir simuler un échec sans modifier le fichier.
migration: image: postgres:18.6-alpine3.24@sha256:10a5c69a83035ab5239f5620d708520e8b28f5aa1f2b20143e6024532edadfb5 environment: PGPASSWORD: demo-seulement command: - psql - -h - base - -U - librairie - -d - librairie - -v - ON_ERROR_STOP=1 - -f - /migrations/${FICHIER_MIGRATION:-001-livres.sql} volumes: - ./migrations:/migrations:ro restart: "no" depends_on: base: condition: service_healthyL'option -v ON_ERROR_STOP=1 fait sortir psql avec un code non nul à la première erreur du script. Sans elle, une migration cassée pourrait finir avec le code 0, et Compose la croirait réussie.
La valeur restart: "no" est le comportement par défaut. Elle est écrite ici pour dire que Docker ne doit pas relancer une tâche terminée. Elle n'empêche pas un nouveau docker compose up -d de la démarrer à nouveau, comme le montre l'essai plus bas ; les politiques de redémarrage sont détaillées dans la leçon de dépannage citée plus haut. Remplacez maintenant le depends_on de catalogue et sa requête.
catalogue: image: postgres:18.6-alpine3.24@sha256:10a5c69a83035ab5239f5620d708520e8b28f5aa1f2b20143e6024532edadfb5 environment: PGPASSWORD: demo-seulement command: - sh - -c - psql -h base -U librairie -d librairie -tAc 'SELECT count(*) FROM livres' || echo 'lecture impossible'; exec sleep infinity depends_on: migration: condition: service_completed_successfullyLe schéma suit l'ordre dans le temps, de haut en bas. Compose démarre base et attend qu'elle soit saine, lance la migration et attend son code 0, puis seulement catalogue. Regardez la note en bas à droite : une fois catalogue lancé, Compose ne surveille plus rien.
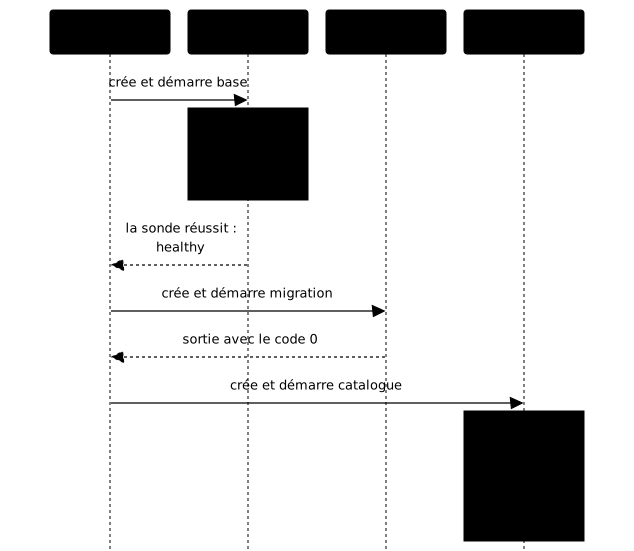
Lancez la stack et lisez l'état des trois services. L'option -a est nécessaire, parce que migration s'est arrêtée et que docker compose ps seul ne montre que les conteneurs qui tournent.
docker compose down -vdocker compose up -ddocker compose ps -a --format '{{.Service}} {{.Status}}'docker compose logs catalogue[+] up 4/4 ✔ Network librairie_default Created 0.0s ✔ Container librairie-base-1 Healthy 10.9s ✔ Container librairie-migration-1 Exited 11.5s ✔ Container librairie-catalogue-1 Started 11.6sbase Up 11 seconds (healthy)catalogue Up Less than a secondmigration Exited (0) Less than a second agocatalogue-1 | 2Regardez l'état de chaque service : base est healthy, migration est sortie avec le code 0 (Exited (0)) et catalogue lit les deux livres. Les durées de docker compose ps dépendent du moment où vous lisez l'état.
Rejouez maintenant la migration seule. L'option --no-deps évite de relancer ses dépendances, et --rm supprime le conteneur de la tâche à la fin.
docker compose run --rm --no-deps migrationdocker compose exec base psql -U librairie -d librairie -tAc 'SELECT count(*) FROM livres' Container librairie-migration-run-53a89a924edb Creating Container librairie-migration-run-53a89a924edb Createdpsql:/migrations/001-livres.sql:4: NOTICE: relation "livres" already exists, skippingCREATE TABLEINSERT 0 02Le deuxième passage ne crée rien et n'insère rien. psql signale que la table existe déjà, l'insertion rend INSERT 0 0 et la table contient toujours deux lignes. La ligne CREATE TABLE est seulement le nom de la commande exécutée, même quand elle n'a rien créé, et l'identifiant du conteneur temporaire change à chaque exécution.
Cette répétabilité est nécessaire : un nouveau docker compose up -d relance aussi la migration déjà terminée, parce que up démarre tout service arrêté du fichier, dépendant ou non.
Le même essai sur une tâche sans aucun dépendant, avec ou sans restart: "no", la relance de la même façon. Vérifiez-le en relançant la commande sans rien modifier.
docker compose up -d[+] up 3/3 ✔ Container librairie-catalogue-1 Running 0.0s ✔ Container librairie-base-1 Healthy 0.5s ✔ Container librairie-migration-1 Exited 0.7sCompose ne touche ni à base ni à catalogue, déjà en cours d'exécution, mais il redémarre le conteneur migration : le mot Exited à la fin signale qu'il s'est exécuté puis arrêté à nouveau. Le journal de la migration (docker compose logs migration) contient alors deux passages. Le second affiche INSERT 0 0, car les deux livres existent déjà. Une migration répétable se rejoue donc sans risque à chaque déploiement.
Que se passe-t-il quand la migration échoue ?
Section intitulée « Que se passe-t-il quand la migration échoue ? »Le service dépendant ne démarre jamais. Relancez la stack depuis zéro en désignant le fichier cassé par la variable.
docker compose down -vFICHIER_MIGRATION=002-erreur.sql docker compose up -ddocker compose ps -a --format '{{.Service}} {{.State}}'docker inspect -f '{{.State.ExitCode}}' librairie-migration-1[+] up 4/4 ✔ Network librairie_default Created 0.0s ✔ Container librairie-base-1 Healthy 10.9s ✘ Container librairie-migration-1 Error service "migration" didn't co... 11.5s ✔ Container librairie-catalogue-1 Created 0.1sservice "migration" didn't complete successfully: exit 3base runningcatalogue createdmigration exited3Regardez trois points :
- Compose s'arrête avec un message qui nomme le service et son code de sortie. La ligne du conteneur est coupée par la largeur du terminal, mais la dernière ligne de Compose donne le message en entier.
cataloguen'est jamais passé à l'étatrunning. Il reste à l'étatcreated: le conteneur existe, mais Compose ne l'a pas démarré.- Le code 3 est celui que
psqldonne à une erreur de script avecON_ERROR_STOP.
Pour comprendre la cause, lisez docker compose logs migration, qui contient ERROR: syntax error at or near "SELEKT".
Remettez ensuite la stack en état avec le fichier correct.
docker compose down -vdocker compose up -dPourquoi l'application doit-elle quand même réessayer ?
Section intitulée « Pourquoi l'application doit-elle quand même réessayer ? »Parce que depends_on ne protège que le démarrage. Une fois catalogue lancé, la base peut s'arrêter pour une maintenance ou un incident, et Compose ne surveille plus rien. Un client qui n'essaie qu'une fois, comme celui utilisé jusqu'ici, ne reprend alors jamais sa lecture.
Un client robuste réessaie après une pause. Remplacez la commande de catalogue par une boucle qui lit toutes les deux secondes et signale chaque échec. Le $$ laisse le signe $ au shell du conteneur, au lieu de laisser Compose l'interpréter. Un essai qui échoue dure lui-même environ cinq secondes, le temps que la résolution du nom base échoue : le nom d'un conteneur arrêté ne se résout plus, et psql répond « could not translate host name "base" to address » après 5,0 secondes mesurées. Le message d'échec revient donc environ toutes les sept secondes.
command: - sh - -c - | while true; do n=$$(psql -h base -U librairie -d librairie -tAc 'SELECT count(*) FROM livres' 2>/dev/null) \ && echo "lecture réussie : $$n livres" \ || echo "base indisponible, nouvel essai dans 2 s" sleep 2 doneAppliquez la modification, puis arrêtez la base. Les commandes sont à lancer une par une, avec une pause avant de lire les journaux.
docker compose up -ddocker compose stop basesleep 20docker compose logs --tail 2 cataloguedocker compose ps --format '{{.Service}} {{.Status}}'catalogue-1 | base indisponible, nouvel essai dans 2 scatalogue-1 | base indisponible, nouvel essai dans 2 scatalogue Up 20 secondsRegardez le service catalogue : il est toujours démarré, et Compose n'a rien fait de plus que l'arrêt demandé. La base arrêtée n'apparaît plus, parce que docker compose ps sans -a ne liste que les conteneurs qui tournent. Rallumez la base et laissez-lui le temps de répondre.
docker compose start basesleep 10docker compose logs --tail 2 cataloguedocker compose ps --format '{{.Service}} {{.Status}}'catalogue-1 | lecture réussie : 2 livrescatalogue-1 | lecture réussie : 2 livresbase Up 10 seconds (healthy)catalogue Up 30 secondsLa lecture a repris sans que personne n'ait touché à catalogue, qui est resté Up pendant tout l'arrêt. Les données de la base ont survécu, parce que l'arrêt n'efface pas son volume. Les tentatives de l'application couvrent donc le cas que ni la sonde ni l'ordre de démarrage ne couvrent : une dépendance qui disparaît après le démarrage.
Une boucle infinie et silencieuse reste pourtant un piège, car elle masque une panne durable. Une application réelle limite le nombre d'essais, allonge la pause entre deux essais (on parle d'attente croissante) et finit par échouer avec un message clair, pour que l'incident se voie.
Que fait Docker quand un service devient unhealthy ?
Section intitulée « Que fait Docker quand un service devient unhealthy ? »Rien. L'état unhealthy est une information, que lisent docker compose ps, la condition service_healthy au démarrage, ou un outil extérieur comme un reverse proxy. Docker ne redémarre pas le conteneur, et une politique de redémarrage ne s'en occupe pas non plus : elle réagit à la fin du processus, pas à son état de santé, comme le rappelle la leçon de dépannage.
Un reverse proxy comme Traefik peut en revanche lire cet état pour écarter l'instance, ce que Traefik avec Docker détaille.
Pour le constater, ajoutez un serveur web dont la sonde regarde un fichier d'état, et non la présence du processus. Créez les deux fichiers, puis le service.
printf 'Bienvenue\n' > site/index.htmlprintf 'ok\n' > site/etat.txt vitrine: image: nginx:1.30.6-alpine@sha256:0e52bd054126cdc040b1276c0af347aeb02a41b9cfe305d6094767ac30e97949 volumes: - ./site:/usr/share/nginx/html:ro healthcheck: test: ["CMD", "wget", "-q", "-O", "/dev/null", "http://127.0.0.1/etat.txt"] interval: 2s timeout: 2s retries: 3Le fichier d'état représente ce qu'une application réelle vérifierait avant de se déclarer disponible : base joignable, cache chargé. Lancez le service, vérifiez qu'il est sain, puis supprimez le fichier d'état sur l'hôte. Le dossier est en lecture seule dans le conteneur, pas sur votre hôte : vous pouvez donc y supprimer le fichier.
docker compose up -d vitrinesleep 6docker inspect -f '{{.State.Status}} {{.State.Health.Status}} redémarrages={{.RestartCount}}' librairie-vitrine-1rm site/etat.txtsleep 10docker inspect -f '{{.State.Status}} {{.State.Health.Status}} redémarrages={{.RestartCount}}' librairie-vitrine-1docker compose exec vitrine wget -q -O - http://127.0.0.1/running healthy redémarrages=0running unhealthy redémarrages=0BienvenueLisez les trois lignes. Le conteneur est d'abord sain, puis unhealthy quelques secondes après la suppression du fichier (4,6 secondes mesurées). Pourtant son statut reste running, le compteur de redémarrages reste à 0 et le serveur continue à répondre. Seule l'étiquette de santé a changé.
La sonde utilise wget, fourni par l'image nginx en version Alpine, ce qui n'est pas le cas de toutes les images. Le journal de la sonde dit pourquoi elle échoue.
docker inspect -f '{{range .State.Health.Log}}code={{.ExitCode}} {{.Output}}{{end}}' librairie-vitrine-1code=1 wget: server returned error: HTTP/1.1 404 Not Foundcode=1 wget: server returned error: HTTP/1.1 404 Not Foundcode=1 wget: server returned error: HTTP/1.1 404 Not Foundcode=1 wget: server returned error: HTTP/1.1 404 Not Foundcode=1 wget: server returned error: HTTP/1.1 404 Not FoundChaque ligne est une sonde échouée : wget n'a pas trouvé le fichier d'état et a rendu le code 1. Docker ne garde que les cinq dernières sondes dans ce journal. Remettez le fichier et attendez une sonde.
printf 'ok\n' > site/etat.txtsleep 4docker inspect -f '{{.State.Health.Status}} redémarrages={{.RestartCount}}' librairie-vitrine-1healthy redémarrages=0Le service est redevenu healthy sans redémarrage : c'est le même processus qui a repris. Retenez la conséquence : si vous voulez qu'une panne détectée déclenche une action, c'est à un autre outil de le faire, pas à la sonde.
Que faire quand le démarrage n'attend pas comme prévu ?
Section intitulée « Que faire quand le démarrage n'attend pas comme prévu ? »Partez de ce que vous voyez, puis lisez le journal de la sonde avant de modifier le fichier. Le tableau relie les symptômes de cette leçon à leur cause.
| Ce que vous observez | Cause probable | Ce que vous faites |
|---|---|---|
docker compose up -d s'arrête avec le code de sortie 1 et le message « dependency failed to start: container librairie-base-1 is unhealthy » | La sonde n'a jamais réussi : mauvaise commande, mauvais hôte, ou période de grâce trop courte | Lisez docker inspect -f '{{range .State.Health.Log}}{{.Output}}{{end}}' <conteneur>, testez la commande avec docker compose exec, puis corrigez test ou start_period |
| Le journal de la sonde contient « executable file not found » ou le code 127 | L'outil de la sonde n'existe pas dans l'image | Choisissez une commande présente dans l'image, ou installez l'outil dans l'image |
Le service reste longtemps en starting | interval trop long (ou start_interval pendant la période de grâce), ou initialisation plus longue que prévu | Raccourcissez interval ou start_interval et vérifiez que start_period couvre l'initialisation |
La sonde est healthy mais le client est refusé | La sonde teste autre chose que ce dont le client a besoin, par exemple le socket local au lieu du réseau | Faites tester la sonde par le même chemin que le client |
| Compose affiche « didn't complete successfully » suivi d'un code | La tâche a échoué | Lisez docker compose logs <tâche>, corrigez, et relancez docker compose up -d |
| Le dépendant démarre avant la fin de la migration | depends_on en forme courte, donc service_started | Utilisez la forme longue avec service_completed_successfully |
Le service est unhealthy et rien ne se passe | Comportement normal : Docker ne redémarre pas sur ce seul état | Corrigez la cause, ou confiez la réaction à un outil qui lit l'état |
| Le client échoue définitivement quand la base redémarre | Aucune tentative applicative | Ajoutez des essais bornés avec une pause |
Si up -d semble bloqué, ouvrez un second terminal : docker compose ps montre l'état starting ou unhealthy, et le journal de la sonde est déjà rempli.
Comment tout nettoyer après la démonstration ?
Section intitulée « Comment tout nettoyer après la démonstration ? »La démonstration laisse quatre conteneurs, un réseau, un volume anonyme créé par l'image postgres, le dossier ~/librairie et deux images. La commande docker compose down -v supprime les conteneurs, le réseau et ce volume.
cd ~/librairiedocker compose down -vRetirez ensuite les images, puis le dossier.
docker rmi postgres:18.6-alpine3.24@sha256:10a5c69a83035ab5239f5620d708520e8b28f5aa1f2b20143e6024532edadfb5docker rmi nginx:1.30.6-alpine@sha256:0e52bd054126cdc040b1276c0af347aeb02a41b9cfe305d6094767ac30e97949cd ~ && rm -r librairieAprès cela, docker ps -a ne montre plus de conteneur librairie-..., docker volume ls ne montre plus de volume de la stack, et ls ~/librairie répond que le dossier n'existe plus.
Mettre en pratique
Section intitulée « Mettre en pratique »Le premier lab vous donne deux images prêtes et aucun conteneur actif : un serveur dont la disponibilité arrive après une initialisation lente, et un client qui n'essaie qu'une fois. Vous écrivez le compose.yaml avec une sonde de disponibilité, pas une simple sonde de présence, un intervalle court et une période de grâce suffisante, puis vous conditionnez le client à la santé du serveur. La validation retire temporairement la disponibilité du serveur et attend qu'il devienne unhealthy dans un délai borné. Elle lance aussi des projets isolés avec un serveur plus lent, qui doit retarder le client, et un serveur qui n'est jamais prêt, avec lequel le client ne doit jamais démarrer.
Le nom de projet est imposé, avec l'option -p vue dans la première leçon Compose. Les images portent déjà leur commande : contrairement à la démonstration, vous ne la modifiez pas et vous n'ajoutez ni montage ni politique de redémarrage.
Le second lab donne une image avec un script de migration et un script d'application qui refuse de démarrer sans schéma. Vous déclarez la migration comme une tâche ponctuelle et vous faites attendre l'application sur sa fin réussie, avec un volume partagé que la migration et l'application montent en écriture. Ce volume nommé partagé est enseigné par la leçon Persister les données d'une stack recréée. La validation rejoue la migration deux fois pour vérifier qu'elle préserve les données déjà écrites, puis teste dans des projets séparés un volume vide et une migration qui sort avec une erreur, où l'application ne doit jamais démarrer.
Le nom de projet est imposé, avec l'option -p. La migration reçoit le script fourni comme commande, sans remplacer le point d'entrée de l'image. Le volume partagé est le seul montage, et la migration ne porte aucune politique de redémarrage qui la relancerait.
À retenir
Section intitulée « À retenir »-
Un
depends_onsous sa forme courte attend seulement que le conteneur soit lancé. Il ne dit rien de la disponibilité du programme qu'il contient, et sur une machine rapide il peut sembler suffire. -
Un
healthchecklance une commande à intervalle régulier et en tire les étatsstarting,healthyetunhealthy. Le délai de détection d'une panne vaut à peu prèsintervalfoisretries. La période de grâcestart_periodne compte pas les échecs d'un service lent à démarrer, sans retarder l'étathealthy. -
Une sonde teste ce dont le dépendant a besoin, par le même chemin que lui. Sur PostgreSQL,
pg_isreadysans adresse peut répondre pendant l'initialisation : visez127.0.0.1. -
La forme longue de
depends_onpose une condition :service_healthypour une dépendance qui doit servir,service_completed_successfullypour une tâche ponctuelle qui doit se terminer avec le code 0. -
Une migration se déclare comme un service à part, répétable, avec
ON_ERROR_STOPpour que l'erreur devienne un code non nul. Si elle échoue, le dépendant ne démarre pas. Un nouveaudocker compose up -dla relance, d'où l'intérêt qu'elle se rejoue sans risque. -
Un service
unhealthyn'est ni redémarré ni arrêté par Docker : l'état est une information, lue par ceux qui veulent s'en servir. -
depends_onne protège que le démarrage. Une dépendance qui disparaît ensuite se gère dans l'application, par des essais bornés espacés d'une pause.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de ce guide est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Encadrer ressources et redémarrage d'une stack
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications