Quand un conteneur s'arrête avec le code 137, ou n'arrive plus à lancer la moindre commande, deux plafonds sont à écarter en premier : la mémoire et le nombre de tâches. Cette leçon vous apprend à poser ces deux plafonds, à vérifier que le noyau les applique vraiment, puis à reconnaître laquelle des deux causes vous avez devant vous, grâce à des compteurs plutôt qu'à une impression. Les sorties viennent de Docker Engine 29.9.2 sur Debian 13.7 (noyau 6.12.113, cgroup v2, pilote systemd), sur une VM de 2 processeurs et 2,84 Gio de mémoire, sans swap.
Trois mots reviennent partout. Un cgroup est le groupe de contrôle du noyau Linux auquel Docker rattache chaque conteneur : c'est lui qui compte les ressources du conteneur et qui les plafonne. L'OOM (out of memory, plus de mémoire) est la décision du noyau de tuer un processus du groupe quand le plafond mémoire est franchi. Une tâche est un processus ou un fil d'exécution : le plafond de tâches borne leur nombre total dans le cgroup.
Deux autres notions reviennent souvent. Le PID 1 est le premier processus du conteneur, celui que Docker lance avec la commande donnée à docker run : quand il se termine, le conteneur s'arrête. Le swap est un espace sur disque que le noyau utilise comme extension de la mémoire.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Poser un plafond mémoire avec ou sans swap, et vérifier ce que le démon a demandé comme ce que le noyau applique
- Prouver un OOM par le compteur
oom_killdememory.events, et non par un code de sortie seul - Distinguer un processus enfant tué (le conteneur continue) de la mort du PID 1 (le conteneur s'arrête), et lire ce que
OOMKilledveut dire - Dimensionner un plafond sur la pointe d'usage mesurée dans
memory.peak, pas sur la taille finale - Poser
--pids-limit, lirepids.events, et expliquer pourquoiulimit -une le remplace pas - Diagnostiquer un conteneur saturé quand
docker execéchoue, reconnaître des zombies et les corriger avec--init - Relever ou abaisser un plafond à chaud avec
docker update
Prérequis
Section intitulée « Prérequis »- Brider un conteneur : processeur, ulimits et mémoire partagée : la lecture des fichiers du cgroup depuis le conteneur, le fait que
/dev/shmcompte dans la mémoire du conteneur et la notion d'ulimit. La limite de processeur (le throttling) y est traitée et ne l'est pas ici. - Recommandé : Encadrer ressources et redémarrage d'une stack, qui écrit ces plafonds dans un fichier Compose (
mem_limit,memswap_limit,pids_limit). Cette leçon pose les plafonds en ligne de commande et ne redit pas l'écriture Compose. - Un hôte Linux avec Docker Engine 29.9.2, un utilisateur membre du groupe
dockeret la lecture de/sys/fs/cgroupautorisée. Les commandes sont écrites pour bash. Pour comprendre d'où viennent les fichiers du cgroup, voir Comprendre les cgroups Linux et Namespaces et cgroups : mesurer l'isolation d'un conteneur.
Comment préparer le dossier de travail et les sondes ?
Section intitulée « Comment préparer le dossier de travail et les sondes ? »Tout ce que la leçon crée tient dans un dossier ~/plafonds et dans des conteneurs dont le nom commence par pl-. La VM que vous utilisez est peut-être partagée : le nettoyage de fin ne touche que ces objets. Les trois sondes sont de petits scripts, parce qu'il faut une charge connue pour que les compteurs aient un sens. La première alloue de la mémoire par blocs de 4 Mio, la deuxième fait doubler une chaîne d'octets, la troisième lance une rafale de sleep.
mkdir -p ~/plafonds/sondes && cd ~/plafonds/sondesÉcrivez alloue.py. Il prend une taille en Mio et une durée d'attente, alloue et touche la mémoire par blocs de 4 Mio, puis attend.
import sys, timemib = int(sys.argv[1]); hold = float(sys.argv[2]) if len(sys.argv) > 2 else 0b = []for i in range(mib // 4): b.append(bytearray(b"\x01") * (4 * 1024 * 1024)) print("tenu", (i + 1) * 4, "Mio", flush=True)time.sleep(hold)print("fini sans etre tue", flush=True)Écrivez doublement.py : une chaîne double de taille (s = s + s) jusqu'à la taille demandée, puis le processus attend.
import sys, timecible = int(sys.argv[1]) * 1024 * 1024s = b"x"while len(s) < cible: s = s + sprint("fait", len(s) // 1048576, "Mio", flush=True)time.sleep(120)Écrivez rafale.sh, qui lance $1 commandes sleep de $2 secondes en arrière-plan.
#!/bin/shi=0while [ $i -lt "$1" ]; do sleep "$2" & i=$((i+1))doneecho "boucle finie, pids.current=$(cat /sys/fs/cgroup/pids.current) pids.max=$(cat /sys/fs/cgroup/pids.max)"waitecho "wait fini rc=$?"Il reste à définir l'image épinglée et deux fonctions de lecture dans votre shell. cg renvoie le chemin réel du cgroup d'un conteneur, lu depuis l'hôte via le PID du conteneur ; etat affiche l'état que le démon connaît, dont OOMKilled, l'indicateur que le démon lève quand le noyau a tué un processus du conteneur faute de mémoire.
cd ~/plafondsIMG='python:3.13-alpine@sha256:7984cf56ceaddebe4fefeb75d64000b9f45d8b77b11a09b24524da6cdc3af0c8'docker pull -q "$IMG"cg() { local pid; pid=$(docker inspect -f '{{.State.Pid}}' "$1"); echo "/sys/fs/cgroup$(cut -d: -f3 /proc/$pid/cgroup)"; }etat() { docker inspect -f 'Running={{.State.Running}} Status={{.State.Status}} ExitCode={{.State.ExitCode}} OOMKilled={{.State.OOMKilled}} Restarts={{.RestartCount}}' "$1"; }Avec le pilote systemd, cg rend un chemin de la forme /sys/fs/cgroup/system.slice/docker-<id>.scope. Lire le cgroup depuis l'hôte plutôt que depuis le conteneur n'est pas un détail : plus bas, un conteneur saturé refuse docker exec, et ces fichiers restent alors la seule fenêtre ouverte.
Que demande-t-on au démon, et qu'applique le noyau ?
Section intitulée « Que demande-t-on au démon, et qu'applique le noyau ? »Un plafond se lit à deux endroits qui peuvent diverger : ce que vous avez demandé au démon (HostConfig) et ce que le noyau applique (les fichiers du cgroup). Le cgroup fait foi, parce que c'est lui qui tue. Lancez un conteneur avec 48 Mio de mémoire et lisez les deux vues.
docker run -d --name pl-a --memory 48m -v ~/plafonds/sondes:/p:ro "$IMG" sleep 600docker inspect -f 'Memory={{.HostConfig.Memory}} MemorySwap={{.HostConfig.MemorySwap}} OomKillDisable={{.HostConfig.OomKillDisable}}' pl-aP=$(cg pl-a); echo "memory.max=$(cat $P/memory.max) memory.swap.max=$(cat $P/memory.swap.max) pids.max=$(cat $P/pids.max)"Memory=50331648 MemorySwap=100663296 OomKillDisable=<nil>memory.max=50331648 memory.swap.max=50331648 pids.max=3393Regardez MemorySwap : vous n'avez pas demandé de swap, et Docker a posé le double de Memory. MemorySwap est un total mémoire plus swap : 96 Mio moins 48 Mio de mémoire laissent 48 Mio de swap, et le noyau l'applique, puisque memory.swap.max vaut 50331648. Un --memory seul n'interdit donc pas le swap. Ignorez pour l'instant le champ OomKillDisable ; une section plus bas y revient.
Pour interdire le swap, il faut passer --memory-swap égal à --memory. Le tableau résume les combinaisons mesurées.
| Options | MemorySwap dans HostConfig | memory.swap.max dans le cgroup |
|---|---|---|
--memory 48m | 100663296 (le double) | 50331648 (48 Mio de swap) |
--memory 48m --memory-swap 48m | 50331648 | 0 |
--memory 48m --memory-swap 96m | 100663296 | 50331648, comme --memory seul |
--memory 48m --memory-swap -1 | -1 | max (swap illimité) |
Vérifiez la deuxième ligne, la seule qui interdise le swap.
docker run -d --name pl-b --memory 48m --memory-swap 48m -v ~/plafonds/sondes:/p:ro "$IMG" sleep 600docker inspect -f 'Memory={{.HostConfig.Memory}} MemorySwap={{.HostConfig.MemorySwap}}' pl-bP=$(cg pl-b); echo "memory.max=$(cat $P/memory.max) memory.swap.max=$(cat $P/memory.swap.max)"Vous devez lire Memory et MemorySwap égaux à 50331648, puis memory.swap.max=0. Le démon refuse aussi les combinaisons incohérentes, avec le code 125 et sans rien créer : --memory-swap 128m sans --memory répond You should always set the Memory limit when using Memoryswap limit, see usage, et --memory 64m --memory-swap 32m répond Minimum memoryswap limit should be larger than memory limit, see usage.
Une réserve sur ce que cette leçon prouve. L'hôte de mesure n'a pas de swap (/proc/swaps est vide). Sans swap, --memory seul et --memory-swap égal tuent la même allocation, et nous n'avons pas mesuré le comportement d'un débordement vers un vrai swap. La différence entre les deux réglages se lit dans le cgroup ; sur un hôte qui a du swap, elle se verrait en production, et c'est pour cela qu'il vaut mieux la lire avant.
Que se passe-t-il quand une allocation dépasse le plafond ?
Section intitulée « Que se passe-t-il quand une allocation dépasse le plafond ? »Le noyau tue un processus du cgroup, et un compteur le prouve. Le fichier memory.events du cgroup compte trois choses : max pour les franchissements du plafond, oom pour les situations d'OOM et oom_kill pour les processus tués. Un compteur dit ce qui s'est produit ; un code de sortie peut avoir plusieurs causes. Lisez ce fichier avant, lancez une allocation de 80 Mio sous un plafond de 48 Mio, puis relisez-le.
P=$(cg pl-a)echo "avant : $(grep -E '^(max|oom|oom_kill) ' $P/memory.events | tr '\n' ' ')"docker exec pl-a python /p/alloue.py 80 | tail -3; echo "rc exec=${PIPESTATUS[0]}"echo "après : $(grep -E '^(max|oom|oom_kill) ' $P/memory.events | tr '\n' ' ')"etat pl-aavant : max 0 oom 0 oom_kill 0tenu 36 Miotenu 40 Miotenu 44 Miorc exec=137après : max 19 oom 1 oom_kill 1Running=true Status=running ExitCode=0 OOMKilled=true Restarts=0Regardez trois choses. La sonde n'a pas dépassé 44 Mio : le noyau l'a tuée avant que 48 Mio ne soient disponibles pour elle, parce que l'interpréteur Python occupe lui aussi une part du plafond. oom_kill est passé de 0 à 1, c'est la preuve de l'OOM. Et max est monté à 19, car le noyau a tenté de récupérer de la mémoire à chaque franchissement avant de tuer. Le code 137 (128 plus le signal 9) ne dit rien seul : seul oom_kill établit que c'est l'OOM qui a frappé.
Un détail piège : OOMKilled vaut true alors que le conteneur tourne toujours (Running=true). Le champ passe à true dès qu'un processus du conteneur est tué par l'OOM, et il le reste, même si une allocation suivante réussit. Relancez une allocation de 40 Mio, sous le plafond : elle se termine avec le code 0, les compteurs de memory.events ne bougent pas, et OOMKilled reste true. Le champ OOMKilled=true ne veut donc pas dire « conteneur arrêté ».
L'OOM tue-t-il le conteneur entier ?
Section intitulée « L'OOM tue-t-il le conteneur entier ? »Cela dépend du processus que le noyau choisit. S'il tue un processus enfant ou un processus lancé par docker exec, le conteneur continue. S'il tue le PID 1, le conteneur s'arrête. Le cas du docker exec est celui de la section précédente. Voyons un enfant du PID 1, avec un petit script qui lance la sonde, annonce son code de sortie, puis attend.
cat > ~/plafonds/sondes/enfant.sh <<'EOF'#!/bin/shpython /p/alloue.py 80 0echo "enfant fini rc=$?"sleep 600EOFdocker run -d --name pl-c --memory 48m -v ~/plafonds/sondes:/p:ro "$IMG" sh /p/enfant.shsleep 5docker logs pl-c 2>&1 | tail -3etat pl-c; docker inspect -f 'StartedAt={{.State.StartedAt}}' pl-ctenu 44 MioKilledenfant fini rc=137Running=true Status=running ExitCode=0 OOMKilled=true Restarts=0StartedAt=2026-11-04T12:59:20.957321761ZLe PID 1 (sh /p/enfant.sh) a survécu : son enfant Python est mort en 137, le shell a écrit Killed, puis il a continué. Les lignes Killed et enfant fini rc=137 passent par deux flux différents (erreur et sortie standard) : leur ordre peut s'inverser d'un essai à l'autre. Le conteneur n'a pas redémarré, et StartedAt est la preuve qu'il n'a pas été recréé. Votre valeur de StartedAt sera celle de votre propre démarrage. Maintenant, faites de la sonde elle-même le PID 1.
docker run -d --name pl-d --memory 48m -v ~/plafonds/sondes:/p:ro "$IMG" python /p/alloue.py 80 30docker wait pl-detat pl-ddocker inspect -f 'Error={{json .State.Error}}' pl-d137Running=false Status=exited ExitCode=137 OOMKilled=true Restarts=0Error=""Cette fois le conteneur est exited avec le code 137, et OOMKilled=true : le PID 1 a été tué, le conteneur n'a plus de raison de tourner. Le champ Error reste vide, parce que Docker n'a rien fait d'anormal : c'est le noyau qui a décidé. Un point de méthode : un conteneur arrêté n'a plus de cgroup. Il n'a plus de processus, donc plus de cgroup propre à lire, et la fonction cg n'a plus rien de fiable à rendre. cg ne sert donc que sur un conteneur en marche ; pour un PID 1 déjà mort, les événements du démon renseignent : ils doivent montrer l'ordre oom puis die, avec la réserve exposée plus bas. Pour les lire, il faut un PID 1 qui meurt à coup sûr : le fichier hog.py ci-dessous alloue des blocs de 4 Mio sans fin, ce qui garantit la mort du PID 1 sous un plafond de 40 Mio.
cat > ~/plafonds/sondes/hog.py <<'EOF'l = []while True: l.append(bytearray(4 * 1024 * 1024))EOFT0=$(date +%s)docker run -d --name pl-e --memory 40m -v ~/plafonds/sondes:/p:ro "$IMG" python /p/hog.py >/dev/nulldocker wait pl-e; T1=$(date +%s)docker events --since $T0 --until $((T1+1)) --filter container=pl-e --filter event=oom --filter event=die --format '{{.Action}} exitCode={{index .Actor.Attributes "exitCode"}}'137oom exitCode=die exitCode=137L'événement oom précède die, et seul die porte le code de sortie. Aucune ligne kill ni stop n'apparaît (avec le filtre retiré, la séquence est create, start, oom, die) : ce n'est pas Docker qui a arrêté le conteneur. Ces événements valent pour un OOM du PID 1. Sur cinq essais à 40 Mio, un seul a fait exception : le conteneur est sorti avec le code 137, mais sans événement oom et avec OOMKilled=false ; deux essais à 32 Mio n'ont montré aucune exception. La cause de cette exception reste inconnue. Dans ce cas, docker events ne montrait que die avec le code 137, et le cgroup avait disparu : un 137 sans OOMKilled ni événement oom ne permet pas de conclure. Une consommation proche du plafond, relevée avant l'arrêt (memory.peak, docker stats), rend l'OOM plausible. La lecture du code 137 face à docker kill, et la politique de redémarrage qui relance un conteneur tué, sont enseignées par Encadrer ressources et redémarrage d'une stack.
Comment dimensionner un plafond : taille finale ou pointe ?
Section intitulée « Comment dimensionner un plafond : taille finale ou pointe ? »Il faut dimensionner sur la pointe d'usage, pas sur la taille finale. Une chaîne qui double (s = s + s) garde un instant l'ancienne moitié et la nouvelle en mémoire, donc le plafond doit couvrir les deux. Le fichier memory.peak du cgroup garde le maximum atteint, et c'est lui qu'il faut lire : memory.current, lu après coup, retombe à la taille finale et cache le coût du doublement. Lancez la sonde sous un plafond large (512 Mio), attendez qu'elle ait fini, puis lisez les deux fichiers.
docker run -d --name pl-f --memory 512m -v ~/plafonds/sondes:/p:ro "$IMG" python /p/doublement.py 32until docker logs pl-f 2>&1 | grep -q fait; do sleep 0.25; doneP=$(cg pl-f); echo "memory.peak=$(cat $P/memory.peak) memory.current=$(cat $P/memory.current)"Sur notre VM, une chaîne de 32 Mio finaux donne une pointe d'environ 51,8 Mio pour 35,6 Mio de memory.current, à quelques centaines de Kio près d'un essai à l'autre. Répétée à plusieurs tailles, la mesure donne ceci.
| Taille finale | memory.peak | memory.current | Pointe divisée par la taille |
|---|---|---|---|
| interpréteur seul (script qui attend sans rien allouer) | 6,9 Mio | 3,5 Mio | |
| 4 Mio | 9,8 Mio | 7,5 Mio | 2,46 |
| 8 Mio | 15,7 Mio | 11,6 Mio | 1,96 |
| 16 Mio | 27,8 Mio | 19,6 Mio | 1,74 |
| 32 Mio | 51,8 Mio | 35,6 Mio | 1,62 |
Lisez la dernière colonne : le rapport baisse vers 1,5 quand la taille grandit. Sur de petites tailles, c'est l'interpréteur qui domine. Retirez ses 6,9 Mio, et la pointe vaut 0,73, 1,10, 1,31 puis 1,40 fois la taille finale. Elle tend vers 1,5, parce que l'ancienne moitié et la nouvelle coexistent pendant la copie.
La proportion dépend du langage et de son implémentation : la courbe ci-dessus est celle de Python, pas une constante.
La conséquence se vérifie en faisant varier le plafond avec une sonde équivalente. Une chaîne de 16 Mio finaux est tuée sous un plafond de 24 Mio et survit dès 28 Mio ; une chaîne de 32 Mio finaux est tuée sous 48 Mio et survit dès 56 Mio. Un plafond de 48 Mio paraît pourtant large pour 32 Mio de données : il ne l'est pas, parce que la pointe vaut environ 52 Mio.
La colonne MEM USAGE / LIMIT de docker stats donne une indication de même nature, et elle compte aussi l'interpréteur. Lancez la sonde de 40 Mio en arrière-plan avec une attente de 12 secondes, puis lisez docker stats pendant qu'elle tient sa mémoire.
docker run -d --name pl-s --memory 48m -v ~/plafonds/sondes:/p:ro "$IMG" sleep 600docker exec -d pl-s python /p/alloue.py 40 12sleep 4docker stats --no-stream pl-sQuatre secondes après le lancement, pendant que la sonde tient ses 40 Mio sous 48 Mio, docker stats affiche 43.8MiB / 48MiB et 91.25% : 40 Mio alloués, soit environ 43,8 Mio mesurés, parce que l'interpréteur compte aussi. Une fois la sonde terminée, la même colonne retombe à environ 384KiB / 48MiB. Retirez ensuite ce conteneur avec docker rm -f pl-s. Une lecture instantanée peut manquer la pointe, alors que memory.peak ne la manque pas. Fixez donc le plafond au-dessus de memory.peak, avec une marge pour absorber un pic plus haut que celui que vous avez mesuré : un plafond égal à la pointe ne laisse aucune réserve.
Que fait --oom-kill-disable avec le cgroup v2 ?
Section intitulée « Que fait --oom-kill-disable avec le cgroup v2 ? »Rien : Docker accepte l'option, avertit, et l'ignore. Vous la verrez recommandée dans d'anciens guides comme un moyen d'empêcher la mort du conteneur. Essayez-la.
docker run -d --name pl-g --memory 40m --oom-kill-disable "$IMG" sleep 600docker inspect -f 'OomKillDisable={{.HostConfig.OomKillDisable}}' pl-gWARNING: Your kernel does not support OomKillDisable. OomKillDisable discarded.<identifiant du conteneur>OomKillDisable=<nil>L'avertissement est écrit sur la sortie d'erreur, le code de retour est 0, le conteneur est créé et démarré, et le champ vaut <nil> : l'option est écartée. Le plafond memory.max est posé normalement. Le même avertissement apparaît sans --memory. Cette option n'est donc ni un levier ni un risque : elle ne permet pas d'empêcher l'OOM. Quand le noyau ne peut plus rien récupérer sous le plafond, il tue.
Comment plafonner le nombre de tâches ?
Section intitulée « Comment plafonner le nombre de tâches ? »Le plafond de tâches se pose avec --pids-limit, et le noyau l'applique dans pids.max. Sans l'option, pids.max hérite d'une valeur de l'hôte (3393 sur notre VM, elle dépend de la machine) et PidsLimit est nul dans HostConfig. Posez un plafond de 20 tâches et lancez une rafale de 40 sleep de 4 secondes.
docker run -d --name pl-p --pids-limit 20 -v ~/plafonds/sondes:/p:ro "$IMG" sleep 600docker inspect -f 'PidsLimit={{.HostConfig.PidsLimit}}' pl-pP=$(cg pl-p); echo "pids.max=$(cat $P/pids.max)"docker exec pl-p sh /p/rafale.sh 40 4; echo "rc exec=$?"echo "pids.events : $(cat $P/pids.events)"etat pl-pPidsLimit=20pids.max=20/p/rafale.sh: line 0: can't fork: Resource temporarily unavailablerc exec=2pids.events : max 1Running=true Status=running ExitCode=0 OOMKilled=false Restarts=0Regardez la ligne can't fork : c'est ce que voit le processus quand le plafond est atteint. La création d'une nouvelle tâche échoue avec l'erreur EAGAIN, traduite par Resource temporarily unavailable, et le shell s'arrête (code de retour 2). Le compteur max de pids.events monte, comme oom_kill pour la mémoire. Et le conteneur continue : Running=true, ExitCode=0, OOMKilled=false. Une saturation de tâches ne produit ni OOM ni code 137 : ce ne sont pas les mêmes compteurs.
Le plafond borne les processus et les fils d'exécution. Python le voit sous deux formes : avec un plafond de 10, un programme qui crée des enfants avec os.fork() en obtient 9 puis reçoit BlockingIOError(11, 'Resource temporarily unavailable'), et un programme qui crée des threads reçoit RuntimeError("can't start new thread"). Dans les deux cas, pids.events compte les refus, et max valait 2 après ces deux essais.
Que faire quand docker exec échoue lui-même ?
Section intitulée « Que faire quand docker exec échoue lui-même ? »Quand le cgroup est saturé, docker exec échoue aussi, parce qu'il doit ajouter un processus à ce même cgroup. C'est le piège qui fait croire que le conteneur est mort. Repartez d'un conteneur neuf : dans le précédent, les sleep terminés restent comptés comme des zombies et fausseraient la mesure. Dans un essai analogue, pids.current valait encore 19 sur 20 quatorze secondes après la rafale (la section suivante explique pourquoi). Lancez en arrière-plan une rafale qui dure 12 secondes, puis essayez de vous y connecter.
docker rm -f pl-pdocker run -d --name pl-p --pids-limit 20 -v ~/plafonds/sondes:/p:ro "$IMG" sleep 600P=$(cg pl-p)docker exec -d pl-p sh /p/rafale.sh 40 12sleep 2docker exec pl-p true; echo "rc exec=$?"OCI runtime exec failed: exec failed: unable to start container process: error executing setns process: exit status 1; runc init error(s): nsexec-0[757679]: unable to spawn stage-1: Resource temporarily unavailablerc exec=128Le code 128 et le message unable to spawn stage-1: Resource temporarily unavailable désignent la même cause que le can't fork de la section précédente : le noyau refuse une tâche de plus. Le numéro entre crochets est propre à chaque essai. Pour diagnostiquer, lisez depuis l'hôte, sans passer par le conteneur : cat $P/pids.current, cat $P/pids.max et cat $P/pids.events. La colonne PIDS de docker stats --no-stream pl-p donnait 19 pendant la saturation. Vous voyez ainsi un conteneur toujours Running, à OOMKilled=false, qui n'accepte plus rien : c'est la signature d'un plafond de tâches, pas d'un OOM.
Pourquoi un conteneur reste-t-il saturé alors qu'il ne fait rien ?
Section intitulée « Pourquoi un conteneur reste-t-il saturé alors qu'il ne fait rien ? »Le compteur de tâches ne retombe pas si le PID 1 ne récolte pas ses enfants. Un zombie est un processus terminé dont le parent n'a pas encore lu le code de sortie : il n'exécute plus rien, mais il occupe une place dans la table des processus, et le cgroup le compte.
Un processus orphelin est un processus dont le parent s'est terminé. Le PID 1 du conteneur l'adopte, et il doit alors appeler wait, l'appel système qui lit le code de sortie d'un enfant terminé. Un sleep 600 comme PID 1 ne le fait pas. Reproduisez le cas : quinze sleep de 1 seconde sont lancés dans un sous-shell qui sort aussitôt, ce qui les laisse orphelins, puis vous attendez 6 secondes.
docker run -d --name pl-z --pids-limit 20 "$IMG" sleep 600pid=$(docker inspect -f '{{.State.Pid}}' pl-z); P=$(cg pl-z)docker exec pl-z sh -c 'for i in $(seq 1 15); do (sleep 1 &); done'sleep 6echo "pids.current=$(cat $P/pids.current) pids.max=$(cat $P/pids.max) pids.events: $(tr '\n' ' ' < $P/pids.events)"echo "cgroup.procs: $(tr '\n' ' ' < $P/cgroup.procs)"ps -o pid,ppid,stat,cmd --ppid $pid | head -4docker exec pl-z true; echo "docker exec true rc=$?"pids.current=16 pids.max=20 pids.events: max 0cgroup.procs: 2158 PID PPID STAT CMD 2243 2158 Z [sleep] <defunct> 2245 2158 Z [sleep] <defunct> 2247 2158 Z [sleep] <defunct>OCI runtime exec failed: exec failed: unable to start container process: procReady not receiveddocker exec true rc=128Il y a quatre choses à lire. pids.current vaut 16 sur 20, alors que les quinze sleep ont fini depuis 5 secondes. cgroup.procs ne liste qu'un seul processus, le PID 1 : les zombies comptent dans pids.current mais ne figurent pas dans cette liste, et c'est ce décalage qui trahit le problème. ps les montre à l'état Z, tous enfants du PID 1 (PPID 2158). Et docker exec échoue ensuite, avec un message plus opaque (procReady not received), parce que le conteneur n'a plus assez de tâches libres pour les processus transitoires de exec. Les PID sont ceux de notre essai. Ces zombies restent tant que le PID 1 ne les récolte pas, et pids.events reste à max 0 : la rafale elle-même n'a pas dépassé 20.
La correction est un PID 1 qui récolte les orphelins, que fournit l'option --init : Docker place alors un petit programme d'initialisation (tini, installé sous le nom docker-init) comme PID 1. Rejouez le même essai avec docker run -d --name pl-i --init --pids-limit 20 "$IMG" sleep 600.
| Mode | pids.current (sur 20) | Enfants du PID 1 vus par ps | docker exec true ensuite |
|---|---|---|---|
sans --init (3 essais sur 3) | 16 | 15 processus [sleep] <defunct> à l'état Z | code 128 |
avec --init (3 essais sur 3) | 2 | 1 seul, sleep 600 à l'état S | code 0 |
Avec --init, le compteur revient à 2 (le programme d'initialisation et le sleep), et docker exec répond. Si votre conteneur lance des processus qui ne sont pas attendus (une application qui démarre des commandes et ne les attend pas), ajoutez --init, ou init: true dans Compose.
ulimit -u peut-il remplacer --pids-limit ?
Section intitulée « ulimit -u peut-il remplacer --pids-limit ? »Non : ulimit -u et --ulimit nproc sont des limites par utilisateur, portées par le processus, et elles n'ont aucun effet sur root. --pids-limit est un autre mécanisme : il écrit pids.max dans le cgroup et borne tous les processus du conteneur, quel que soit leur utilisateur. Un ulimit se voit dans /proc/self/limits et n'apparaît pas dans pids.max.
Pour le vérifier, ne posez pas --pids-limit, et lancez quinze sleep en root avec une limite de 10.
docker run --rm -v ~/plafonds/sondes:/p:ro "$IMG" sh -c 'ulimit -u 10echo "id=$(id -u) ulimit -u=$(ulimit -u) | $(grep -i "max processes" /proc/self/limits)"echo "pids.max=$(cat /sys/fs/cgroup/pids.max)"i=0; while [ $i -lt 15 ]; do sleep 3 & i=$((i+1)); doneecho "pids.current=$(cat /sys/fs/cgroup/pids.current) pids.events: $(tr "\n" " " < /sys/fs/cgroup/pids.events)"wait'id=0 ulimit -u=10 | Max processes 10 10 processespids.max=3393pids.current=17 pids.events: max 0Regardez pids.current=17 : les quinze sleep ont démarré malgré une limite de 10, et pids.max vaut toujours 3393. Le même résultat sort avec --ulimit nproc=10, et même avec --cap-drop ALL. Le manuel dit pourquoi (man 2 setrlimit, lu le 2026-11-04) : RLIMIT_NPROC est une limite sur le nombre de processus de l'identifiant d'utilisateur réel du processus appelant. Elle n'est pas appliquée aux processus qui ont CAP_SYS_ADMIN ou CAP_SYS_RESOURCE, ni à ceux dont l'identifiant réel est 0.
Nous avons mesuré que root reste exempt sans aucune capacité : l'exemption porte sur l'uid 0. L'exemption par capacité, que décrit le manuel, ne s'est pas observée avec --cap-add pour un utilisateur non root : le refus persiste. Le tableau suivant reprend un second essai, avec --ulimit nproc=5 et dix sleep, en faisant varier l'utilisateur et les capacités.
| Options | Résultat avec dix sleep et nproc=5 |
|---|---|
--user 0 | les dix sleep démarrent, non borné |
--user 0 --cap-drop ALL | les dix sleep démarrent, root reste exempt |
--user 1234 | sh: can't fork: Resource temporarily unavailable |
--user 1234 --cap-add SYS_RESOURCE ou SYS_ADMIN | refus aussi |
Un utilisateur non root est donc borné, mais ce n'est pas le cgroup qui refuse : pids.events reste à max 0, et le comptage se fait par utilisateur sur l'hôte, pas par conteneur. Seul --pids-limit arrête une rafale pour tout utilisateur, root compris.
Comment changer un plafond sans redémarrer le conteneur ?
Section intitulée « Comment changer un plafond sans redémarrer le conteneur ? »docker update modifie le cgroup d'un conteneur en marche, sans le redémarrer. Créez un conteneur avec 48 Mio et 30 tâches, notez son StartedAt, relevez les trois plafonds, puis relisez.
docker run -d --name pl-u --memory 48m --pids-limit 30 -v ~/plafonds/sondes:/p:ro "$IMG" sleep 600docker inspect -f '{{.State.StartedAt}}' pl-udocker update --memory 96m --memory-swap 96m --pids-limit 60 pl-uP=$(cg pl-u); echo "memory.max=$(cat $P/memory.max) memory.swap.max=$(cat $P/memory.swap.max) pids.max=$(cat $P/pids.max)"docker inspect -f '{{.State.StartedAt}}' pl-u<date de démarrage>pl-umemory.max=100663296 memory.swap.max=0 pids.max=60<même date de démarrage>La ligne pl-u est l'écho de docker update. Entre les deux relevés, StartedAt est resté identique : le conteneur n'a pas redémarré, et les nouvelles valeurs sont déjà dans le cgroup. Avec --pids-limit -1, pids.max passe à max.
Le démon refuse certains changements, et le message dit comment corriger. Passez --memory 200m seul alors que MemorySwap vaut déjà 96 Mio.
docker update --memory 200m pl-u; echo "rc=$?"Error response from daemon: Cannot update container <identifiant>: Memory limit should be smaller than already set memoryswap limit, update the memoryswap at the same timerc=1Le refus s'applique parce que la nouvelle mémoire dépasserait le total mémoire plus swap en place. Il se corrige en changeant --memory-swap dans la même commande : docker update --memory 200m --memory-swap 200m pl-u réussit (memory.max=209715200, memory.swap.max=0). Après un refus, les limites restent inchangées.
Quelques cas voisins, mesurés sur ce même moteur :
- Sur un conteneur créé sans limite, où
MemoryetMemorySwapvalent 0,--memory 64m --memory-swap -1passe (memory.swap.max=max) et--memory 64m --memory-swap 128maussi (memory.swap.maxà 64 Mio). docker update --memory 96mseul, sur un conteneur créé avec--memory 48m, est accepté, maismemory.swap.maxpasse à 0, car le total mémoire plus swap reste à 96 Mio.docker update --memory-swap 32msans--memory, avec 64 Mio déjà posés, est refusé par le runtime avec un autre message :runc did not terminate successfully: exit status 1: memory+swap limit should be >= memory limit.
Un plafond posé par docker update ne survit pas à la recréation du conteneur : si la valeur doit durer, écrivez-la dans le fichier Compose, comme l'explique Encadrer ressources et redémarrage d'une stack.
Dernier point, qui demande de la prudence : abaisser un plafond sous l'usage courant n'est pas déterministe. Avec 40 Mio tenus, docker update --memory 24m --memory-swap 24m a échoué deux fois sur trois avec runc did not terminate successfully et a tué le conteneur entier (code 137, OOMKilled=true) ; la troisième fois, il a réussi et n'a tué que le processus. Nous n'avons pas établi la cause de cette variation. Relevez un plafond librement, et n'abaissez-le qu'au-dessus de l'usage mesuré. Dans notre essai, 40 Mio alloués donnaient environ 43,8 Mio mesurés, et un plafond de 44 Mio s'est passé sans incident ; ce n'est pas une recommandation : fixez le plafond au-dessus de memory.peak, avec une marge.
Comment trouver la cause quand un service ne répond plus ?
Section intitulée « Comment trouver la cause quand un service ne répond plus ? »On trouve la cause en lisant dans cet ordre l'état du conteneur, puis les compteurs : chaque lecture élimine une hypothèse. Le schéma suivant donne l'arbre de décision de la leçon.
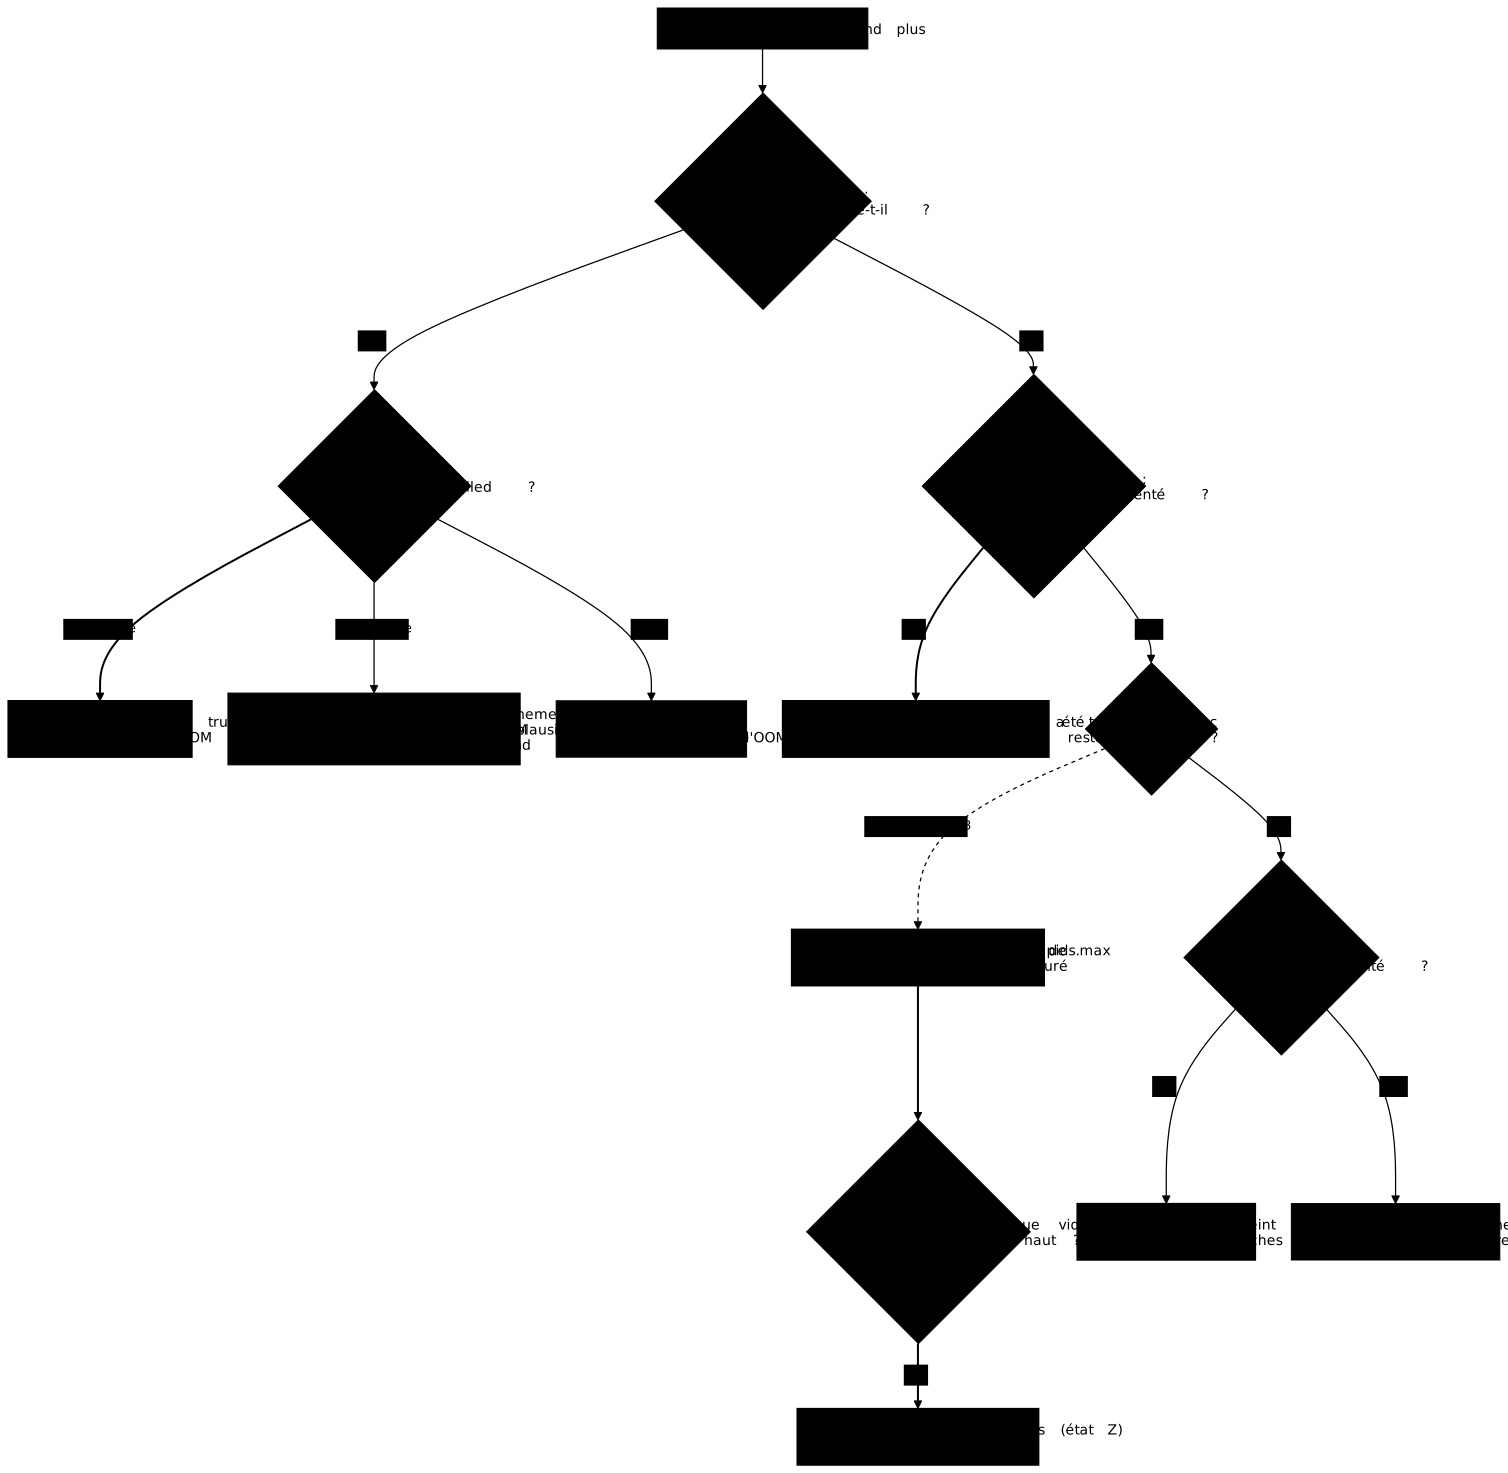
Suivez d'abord les traits épais, qui forment le chemin principal du diagnostic. Le trait pointillé signale le cas qui désoriente, celui où docker exec lui-même échoue. Sur la branche du conteneur arrêté, un 137 sans OOMKilled ni événement oom ne permet pas de conclure ; une consommation proche du plafond, relevée avant l'arrêt (memory.peak, docker stats), rend l'OOM plausible. Sur un conteneur qui répond, lisez pids.events avant de conclure à une autre cause. Le tableau donne les compteurs à lire pour chaque symptôme.
| Symptôme | Compteur ou champ à lire | Cause |
|---|---|---|
Conteneur exited, code 137, OOMKilled=true | docker events : oom puis die (plus de cgroup à lire) | OOM sur le PID 1 |
Conteneur exited, code 137, OOMKilled=false | docker events (dans l'exception mesurée, die seul, aucun oom), consommation relevée avant l'arrêt (memory.peak, docker stats) | on ne peut pas conclure ; OOM plausible si l'usage touchait le plafond |
Conteneur exited, autre code | ExitCode et journaux | autre cause que l'OOM |
Conteneur en marche, OOMKilled=true, un traitement a disparu | oom_kill en hausse, StartedAt inchangé | OOM sur un processus enfant |
can't fork, Resource temporarily unavailable | max de pids.events en hausse | plafond de tâches atteint |
docker exec en code 128, conteneur Running | pids.current proche de pids.max | plafond de tâches saturé |
Idem, avec cgroup.procs presque vide | ps montre des processus à l'état Z | zombies, corriger avec --init |
Sur un conteneur en marche, quand OOMKilled reste à false et que oom_kill ne bouge pas, écartez la mémoire : une saturation de tâches ne laisse pas cette trace. Sur un conteneur arrêté, il n'y a plus de cgroup à lire : seuls docker events et l'état du démon renseignent.
Comment nettoyer ce que la leçon a laissé ?
Section intitulée « Comment nettoyer ce que la leçon a laissé ? »Supprimez uniquement vos objets : les conteneurs pl-* et le dossier de travail. Ne lancez pas de nettoyage global (docker system prune, docker builder prune), qui toucherait les objets des autres utilisateurs d'une VM partagée.
docker rm -f pl-a pl-b pl-c pl-d pl-e pl-f pl-g pl-p pl-s pl-z pl-i pl-u 2>/dev/nullcd ~find ~/plafonds -mindepth 1 -delete && rmdir ~/plafondsdocker ps -a --format '{{.Names}}' | grep -c '^pl-'La dernière commande doit afficher 0. Si vous avez tiré l'image python:3.13-alpine uniquement pour cette leçon, retirez-la avec docker rmi "$IMG" ; sur une VM partagée, vérifiez d'abord que personne d'autre ne l'utilise.
Mettre en pratique
Section intitulée « Mettre en pratique »Le premier lab part d'un service Compose dont le plafond mémoire est trop large, et vous fait appliquer le budget mémoire de l'énoncé, sans swap. Il lance ensuite une sonde d'allocation bornée dans le conteneur. La validation lit les deux vues du plafond (Memory et MemorySwap dans HostConfig, puis memory.max et memory.swap.max dans le cgroup), exige que la sonde soit tuée (ni code 0 ni dépassement du délai) et que oom_kill de memory.events ait augmenté, puis vérifie que le service reste en marche, que son StartedAt n'a pas changé et qu'un reçu écrit avant l'incident est relu après. Elle ne vérifie pas le comportement d'un --memory seul, la mort du PID 1, la persistance d'OOMKilled, ni le dimensionnement sur la pointe : ces gestes restent à pratiquer avec les sondes de la leçon.
Le second lab porte sur les tâches. Il vous fait appliquer le budget de tâches de l'énoncé au service, en gardant le garde-fou mémoire déjà posé, puis il lance une rafale finie de processus éphémères. La validation vérifie PidsLimit dans HostConfig et pids.max dans le cgroup, ce qui refuse un ulimit posé à la place du plafond, le refus de la rafale par le noyau (le compteur max de pids.events augmente), puis la survie du service : en marche, StartedAt inchangé, reçu relu. Si le service est arrêté, le message donne son code de sortie, sans trancher la cause. Le message d'erreur vu par le processus, l'explication de ulimit, la distinction entre OOM et saturation, le diagnostic quand docker exec échoue, les zombies et docker update ne sont pas contrôlés : ils se pratiquent avec la leçon et se vérifient par les questions ci-dessous.
À retenir
Section intitulée « À retenir »- Un plafond se lit des deux côtés : ce que le démon a enregistré (
Memory,MemorySwap,PidsLimit) et ce que le noyau applique (memory.max,memory.swap.max,pids.max). Le cgroup fait foi. MemorySwapest un total mémoire plus swap.--memoryseul le pose au double (memory.swap.maxégal àmemory.max),--memory-swapégal à--memorydonne 0, et-1donnemax. Notre hôte n'a pas de swap : le débordement en swap n'a pas été mesuré.- Sur un conteneur en marche, un OOM se prouve par
oom_killdememory.events, lu avant et après : un code 137 seul peut avoir d'autres causes. Le noyau tue un processus, pas forcément le PID 1. Un enfant tué laisse le conteneur en marche, etOOMKilled=truey reste vrai : il ne veut pas dire « arrêté ». Un PID 1 tué arrête le conteneur (exited, 137) : il n'y a plus de cgroup à lire,OOMKilledetdocker eventsrenseignent mais peuvent manquer (une exception sur cinq essais mesurés). - Dimensionnez un plafond sur la pointe lue dans
memory.peak, pas sur la taille finale : 32 Mio de données doublées ont demandé environ 52 Mio. --oom-kill-disableest ignoré en cgroup v2 (avertissement, champ<nil>).--pids-limitfait refuser la création de tâches (Resource temporarily unavailable,maxdepids.eventsen hausse) sans OOM, sans 137 et sans arrêt du service. Un cgroup saturé refuse aussidocker exec(code 128) : lisezpids.current,pids.maxetpids.eventsdepuis l'hôte. Unpids.currenthaut avec uncgroup.procspresque vide trahit des zombies, que--initcorrige.ulimit -uet--ulimit nprocsont par utilisateur, absents depids.maxet sans effet sur root : ils ne remplacent pas--pids-limit.docker updatechange les plafonds à chaud et sans redémarrage. Passez--memory-swapavec--memorysi le démon refuse, et n'abaissez pas un plafond sous l'usage courant.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de cette leçon est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Épreuve : contenir un conteneur gourmand
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications