Un conteneur dont la racine est en lecture seule ne peut plus écrire nulle part
dans son image : un attaquant qui prend la main n'y dépose rien, et un
programme qui s'écrit des fichiers sans le dire échoue au démarrage. Cette
leçon vous fait figer l'image officielle postgres avec --read-only, trouver
ses écritures avec docker diff, leur donner des tmpfs bornés ou un volume,
puis l'arrêter proprement et constater ce que garantit un arrêt forcé.
Elle s'adresse à qui sait déjà lancer un conteneur et lire un code de sortie.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »Chaque point se vérifie par une commande de la leçon.
- Recenser les écritures d'un service avec
docker diffavant de figer sa racine. - Figer la racine avec
--read-onlyet borner chaque répertoire écrit par untmpfs(taille,noexec,nosuid) ou un volume, en ligne de commande comme dans un fichier Compose. - Séparer ce qui est temporaire de ce qui doit durer, et le prouver après une recréation.
- Préparer une seule fois un volume pour un UID non root, sans repasser le service en root.
- Lire le signal d'arrêt de l'image, régler le délai de grâce et comparer
docker stopàdocker kill.
Prérequis
Section intitulée « Prérequis »Vous devez avoir lu ces deux leçons : la leçon sur le cycle de vie suppose connus les signaux, le PID 1 et le code de sortie 137 ; la leçon sur les droits suppose connue la lecture du propriétaire et du mode d'un volume.
- Cycle de vie d'un conteneur, PID 1 et arrêt propre pour le signal d'arrêt, le délai de grâce et le code 137.
- Droits sur un volume Docker : trois causes courantes d'un accès refusé pour le propriétaire et le mode d'un volume.
Travaillez sur une VM jetable, avec Docker Engine 29.9.2 (magasin d'images containerd, cgroup v2) et Compose 5.6.1 du dépôt officiel. Toutes les mesures ont été faites le 4 novembre 2026 sur Debian 13, avec PostgreSQL 18.6, dans l'image ci-dessous. Une autre version d'image ou de moteur peut afficher d'autres messages.
Quelle démonstration sert de fil conducteur ?
Section intitulée « Quelle démonstration sert de fil conducteur ? »Le fil conducteur est un service PostgreSQL, parce qu'il écrit à plusieurs
endroits : un socket Unix (le fichier par lequel les clients locaux se
connectent), un fichier de verrou, ses données et son journal de transactions
(où il note chaque modification avant de l'appliquer aux données). Créez un
dossier dédié, un volume pour les données et un réseau pour les clients.
L'absence de -p fait échouer mkdir si le dossier existe déjà, au lieu de
mélanger l'essai avec des fichiers antérieurs.
mkdir ~/atelier-lecture-seulecd ~/atelier-lecture-seuleIMG=postgres:18@sha256:3a4264520e121176619f54ff867d12774bc81e95e7b84db58d63bccdb6144b81docker network create carnet-netdocker volume create carnet-donneesdocker pull "$IMG"L'image refuse de démarrer sans mot de passe. La démonstration emploie
POSTGRES_HOST_AUTH_METHOD=trust, qui accepte toute connexion sans mot de
passe, sur un réseau Docker isolé et sans port publié. Ce réglage est réservé
à la démonstration : un service réel passe un secret, comme l'explique la
leçon Secrets Docker : gérer les données sensibles.
Le passage d'un secret par fichier à une image figée n'a pas été mesuré ici.
L'image démarre en root, puis son script d'entrée corrige des propriétaires et
passe à l'utilisateur postgres (UID 999) avant de lancer le serveur. Son
signal d'arrêt se lit dans la configuration de l'image.
docker image inspect "$IMG" --format '{{.Config.StopSignal}} {{.Config.Entrypoint}} {{.Config.Cmd}}'La sortie attendue est SIGINT [docker-entrypoint.sh] [postgres]. Le signal
d'arrêt de cette image est donc SIGINT, et non le SIGTERM habituel.
Ce détail change la façon dont PostgreSQL s'arrête, comme le montre la
dernière partie de la leçon.
Que protège --read-only, et que laisse-t-il ouvert ?
Section intitulée « Que protège --read-only, et que laisse-t-il ouvert ? »La racine d'un conteneur est ce qu'il voit sous / : les couches de l'image,
toujours en lecture seule, plus une couche inscriptible propre au conteneur,
où Docker enregistre tout ce que le conteneur crée ou modifie. --read-only
(champ HostConfig.ReadonlyRootfs) rend cette couche non inscriptible : plus
rien ne s'écrit dans la racine, ni pour l'utilisateur du service, ni pour root.
Les volumes et les tmpfs (des répertoires conservés en mémoire) montés dans
le conteneur ne font pas partie de la racine : ils restent inscriptibles.
Le schéma montre en rouge la zone figée, et dessous les deux endroits qui restent ouverts.
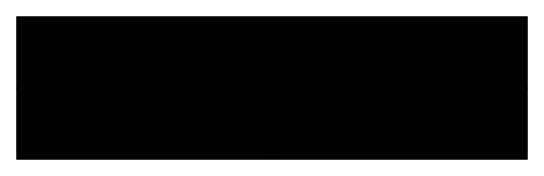
Cela borne ce qu'un processus compromis peut modifier : il ne peut pas remplacer un binaire ou une bibliothèque de l'image. En revanche, la lecture seule ne protège ni les données d'un volume, ni un tmpfs, ni le réseau. C'est donc une réduction de surface, à combiner avec un utilisateur non root et des capacités retirées, pas une garantie à elle seule. Les sections suivantes ajoutent l'utilisateur non root ; le retrait des capacités n'apparaît que pour ce qu'il casse.
Comment recenser les écritures d'un service avant de le figer ?
Section intitulée « Comment recenser les écritures d'un service avant de le figer ? »Lancez un conteneur témoin sans --read-only, faites-le travailler, puis
listez ce qu'il a écrit dans sa couche inscriptible avec docker diff. Chaque
ligne commence par A (ajouté), C (modifié) ou D (supprimé).
docker run -d --name carnet-temoin -e POSTGRES_HOST_AUTH_METHOD=trust "$IMG"until docker exec carnet-temoin pg_isready -q; do sleep 1; donedocker exec carnet-temoin psql -U postgres -c "create table t(id int); insert into t select generate_series(1,1000); checkpoint;"docker diff carnet-temoinLa requête crée une table, y insère 1000 lignes, puis checkpoint force la
base à écrire ses données sur disque. La sortie est identique avant et après
cette activité ; l'ordre des deux lignes A peut changer d'une exécution à
l'autre.
C /runC /run/postgresqlA /run/postgresql/.s.PGSQL.5432A /run/postgresql/.s.PGSQL.5432.lockSur un volume neuf, pg_isready répond d'abord no response, puis
rejecting connections, puis accepting connections. Le script d'entrée
démarre en effet un serveur temporaire pour initialiser la base, l'arrête, puis
lance le serveur définitif. Si une commande échoue avec
the database system is starting up ou shutting down juste après la boucle
until, attendez une seconde et relancez-la.
Regardez ce qui manque autant que ce qui est listé. La seule zone écrite est
/run/postgresql : le socket Unix et son fichier de verrou (/var/run est un
lien vers /run). Le fichier de PID (où le serveur note son numéro de
processus), le journal de transactions et les données sont absents de la liste,
parce qu'ils vivent dans le volume que l'image déclare sur
/var/lib/postgresql avec l'instruction VOLUME. Sans nom donné par vous,
Docker crée alors un volume anonyme, un volume sans nom lisible.
Ce volume échappe à docker diff. Le recensement dit donc ce qu'il faut
mettre en tmpfs, pas ce qui doit durer. Faites cette mesure avant de
figer, avec la charge réelle du service.
Retirez ensuite le témoin et son volume anonyme avec -v, faute de quoi ce
volume reste sur l'hôte.
docker rm -fv carnet-temoinQue se passe-t-il quand on fige la racine sans rien prévoir ?
Section intitulée « Que se passe-t-il quand on fige la racine sans rien prévoir ? »Le service échoue dès qu'il tente sa première écriture hors de son volume.
Lancez la racine figée avec le volume, mais sans tmpfs.
docker run -d --name carnet-pg --read-only -v carnet-donnees:/var/lib/postgresql -e POSTGRES_HOST_AUTH_METHOD=trust "$IMG"sleep 8docker ps -a --filter name=carnet-pg --format '{{.Names}} {{.Status}}'docker logs carnet-pg 2>&1 | grep -E 'FATAL|pg_ctl'Le conteneur sort avec le code 1 (Exited (1)), et le journal contient la
ligne suivante.
FATAL: could not create lock file "/var/run/postgresql/.s.PGSQL.5432.lock": Read-only file systempg_ctl: could not start serverL'initialisation de la base a pourtant réussi avant : elle écrit dans le
volume. L'échec vient du verrou du socket, exactement le chemin que
docker diff avait révélé. La parade consiste à déclarer ce répertoire en
tmpfs. Retirez ce conteneur et gardez le volume, qui contient maintenant une
base initialisée.
docker rm -f carnet-pgComment borner un tmpfs ?
Section intitulée « Comment borner un tmpfs ? »Un tmpfs est un système de fichiers en mémoire, monté à un chemin du
conteneur et vidé à l'arrêt. Sans option, Docker ajoute lui-même nosuid,
nodev et noexec, mais ne pose aucune taille. noexec interdit d'exécuter un
fichier du tmpfs ; nosuid neutralise les fichiers qui s'exécutent avec les
droits de leur propriétaire. Déclarez donc explicitement la taille, les options
et le propriétaire.
T=/run/postgresql:rw,noexec,nosuid,size=1m,uid=999,gid=999,mode=0750docker run -d --name carnet-pg --read-only --tmpfs "$T" \ -v carnet-donnees:/var/lib/postgresql \ -e POSTGRES_HOST_AUTH_METHOD=trust "$IMG"docker inspect carnet-pg --format '{{json .HostConfig.Tmpfs}}'docker exec carnet-pg mount | grep -E ' on (/|/run/postgresql) 'docker exec carnet-pg ls -ld /run/postgresqlHostConfig.Tmpfs reprend votre déclaration, et mount montre ce que le noyau
applique réellement.
{"/run/postgresql":"rw,noexec,nosuid,size=1m,uid=999,gid=999,mode=0750"}overlay on / type overlay (ro,relatime,...)tmpfs on /run/postgresql type tmpfs (rw,nosuid,nodev,noexec,relatime,size=1024k,mode=750,uid=999,gid=999,inode64)La racine est montée ro et le tmpfs porte la taille de 1024 kio demandée.
Un piège : le mode demandé n'est pas forcément le mode final. Ici, mount montre
le mode appliqué au montage, mode=750, mais ls -ld donne ensuite
drwxrwsr-t postgres postgres, soit 3775. Ce n'est ni le mode demandé ni celui
du répertoire dans l'image (3777) : le script d'entrée de l'image exécute
chmod 03775 /var/run/postgresql à chaque démarrage (ligne 45 de
/usr/local/bin/docker-entrypoint.sh dans cette version). Un processus du
conteneur peut donc retoucher le mode après le montage. Quand rien ne le
retouche, le mode demandé est respecté, comme le montre un conteneur jetable
lancé sans le script d'entrée, qui déclare deux tmpfs, l'un avec options et
l'autre sans.
docker run -d --name carnet-zone --read-only --tmpfs /zone-absente:rw,noexec,nosuid,size=1m,mode=0750 --tmpfs /zone-defaut --entrypoint sleep "$IMG" 120docker exec carnet-zone sh -c 'ls -ld /zone-absente /zone-defaut; mount | grep -E " on /zone-"; df -k /zone-defaut | tail -1; grep MemTotal /proc/meminfo'docker exec --user 999:999 carnet-zone sh -c 'touch /zone-absente/x; echo "rc=$?"'docker rm -fv carnet-zonedrwxr-x--- 2 root root 40 Nov 4 15:12 /zone-absentedrwxrwxrwt 2 root root 40 Nov 4 15:12 /zone-defauttmpfs on /zone-absente type tmpfs (rw,nosuid,nodev,noexec,relatime,size=1024k,mode=750,inode64)tmpfs on /zone-defaut type tmpfs (rw,nosuid,nodev,noexec,relatime,inode64)tmpfs 1488796 0 1488796 0% /zone-defautMemTotal: 2977592 kBrc=1touch: cannot touch '/zone-absente/x': Permission deniedTrois faits se lisent ici. Le mode 0750 est appliqué tel quel, et comme le
tmpfs appartient à root, l'utilisateur 999 ne peut pas y écrire : c'est pour
cela que le service du fil conducteur déclare aussi uid=999,gid=999. Sans
option, Docker ajoute quand même nosuid, nodev et noexec. Et sans
size, la taille vaut la moitié de la mémoire de la machine : 1 488 796 kio
sur une VM qui en affiche 2 977 592. Posez donc toujours la vôtre. Ces chiffres
dépendent de la VM de mesure.
Vérifiez maintenant les refus. Ces commandes passent par docker exec, donc en
root ; le refus est le même pour l'utilisateur postgres, car la lecture seule
ne dépend pas de l'UID.
docker exec carnet-pg touch /etc/essai; echo "rc=$?"docker exec carnet-pg sh -c 'echo x > /usr/local/essai'; echo "rc=$?"docker exec carnet-pg sh -c 'touch /run/postgresql/essai-ok'; echo "rc=$?"docker exec carnet-pg sh -c 'cp /bin/true /run/postgresql/t && chmod +x /run/postgresql/t && /run/postgresql/t'; echo "rc=$?"docker exec carnet-pg sh -c 'dd if=/dev/zero of=/run/postgresql/plein bs=1M count=3; echo "dd rc=$?"; rm -f /run/postgresql/plein'Le tableau reprend les cinq résultats, dans l'ordre des commandes.
| Écriture tentée | Résultat | Code |
|---|---|---|
touch dans /etc (racine) | touch: cannot touch '/etc/essai': Read-only file system | 1 |
echo vers /usr/local (racine) | sh: 1: cannot create /usr/local/essai: Read-only file system | 2 |
fichier créé dans le tmpfs | l'écriture réussit | 0 |
exécution d'un binaire copié dans le tmpfs | Permission denied : c'est noexec qui agit | 126 |
dd de 3 Mio dans le tmpfs de 1 Mio | No space left on device | 1 |
Le service, lui, travaille normalement sous cette configuration.
docker exec carnet-pg psql -U postgres -c "create table journal(id int primary key, note text); insert into journal select g, 'initial' from generate_series(-5,-1) g; checkpoint;"docker diff carnet-pgdocker diff ne renvoie aucune ligne : la couche inscriptible reste vide,
alors que la base vient de créer une table et d'écrire des données.
Un tmpfs consomme-t-il de la mémoire ?
Section intitulée « Un tmpfs consomme-t-il de la mémoire ? »Oui : un tmpfs vit en mémoire, donc ce qu'on y écrit compte dans la mémoire
du conteneur. Le cgroup, le mécanisme du noyau qui suit la consommation d'un
conteneur, le montre : la ligne shmem de son fichier memory.stat augmente de
la taille écrite. Le tmpfs de 1 Mio du service est trop petit pour la mesure.
Un conteneur jetable, avec un tmpfs de 16 Mio, lit shmem avant et après
l'écriture de 8 Mio.
docker run -d --name carnet-mem --read-only --tmpfs /scratch:rw,noexec,nosuid,size=16m --entrypoint sleep "$IMG" 120docker exec carnet-mem sh -c 'grep -E "^shmem " /sys/fs/cgroup/memory.stat'docker exec carnet-mem sh -c 'dd if=/dev/zero of=/scratch/remplissage bs=1M count=8'docker exec carnet-mem sh -c 'grep -E "^shmem " /sys/fs/cgroup/memory.stat'docker rm -fv carnet-memLes deux lectures valent shmem 0 puis shmem 8388608, soit exactement
8 Mio de plus. Sur le service PostgreSQL lui-même, la même ligne part d'une
valeur non nulle (16 707 584 lors de la mesure), dont la cause n'a pas été
vérifiée : ne l'attribuez pas au tmpfs, seule la différence compte.
Une conséquence importante : la taille d'un tmpfs ne protège pas la mémoire à
elle seule. Lancez un conteneur limité à 64 Mio de mémoire (--memory 64m,
avec --memory-swap 64m pour interdire le swap), muni d'un tmpfs de 128 Mio,
et écrivez-y 100 Mio.
docker run -d --name carnet-mem --memory 64m --memory-swap 64m --read-only --tmpfs /scratch:size=128m,noexec,nosuid "$IMG" sleep 60docker exec carnet-mem sh -c 'dd if=/dev/zero of=/scratch/f bs=1M count=100; echo "dd rc=$?"'docker inspect carnet-mem --format 'oom={{.State.OOMKilled}} running={{.State.Running}}'docker exec carnet-mem true; echo "exec rc=$?"docker rm -fv carnet-memLe noyau tue dd avant la fin : le code est 137 (Killed) et
OOMKilled=true, ce qui signifie que le conteneur a manqué de mémoire. Le
conteneur, lui, reste annoncé running=true, mais un docker exec suivant
échoue (procReady not received (possibly OOM-killed), code 128) : ce
conteneur-là reste en vie sans plus accepter de nouvelle commande. Le
plafond mémoire et la taille du tmpfs se dimensionnent donc ensemble ; la
leçon
Plafonner la mémoire et le nombre de tâches
détaille le plafond lui-même.
Que mettre dans un tmpfs, et que mettre dans un volume ?
Section intitulée « Que mettre dans un tmpfs, et que mettre dans un volume ? »Un tmpfs accueille ce qui peut disparaître sans conséquence : socket,
verrou, fichiers temporaires. Un volume accueille ce qui doit durer : il
survit à la recréation du conteneur. La preuve se fait en recréant le
conteneur sur le même volume, avec le même tmpfs. Le bloc suivant écrit une
ligne dans la base et un fichier dans le tmpfs, supprime le conteneur, le
recrée avec les mêmes options, puis relit les deux.
docker exec carnet-pg psql -U postgres -c "insert into journal values (-42, 'durable')"docker exec carnet-pg sh -c 'echo temporaire > /run/postgresql/note.txt; ls -A /run/postgresql'docker rm -f carnet-pgdocker run -d --name carnet-pg --read-only --tmpfs "$T" \ -v carnet-donnees:/var/lib/postgresql \ -e POSTGRES_HOST_AUTH_METHOD=trust "$IMG"until docker exec carnet-pg pg_isready -q; do sleep 1; donedocker exec carnet-pg psql -U postgres -tA -c "select id from journal where id in (-5, -42) order by id"docker exec carnet-pg ls -A /run/postgresqldocker exec carnet-pg cat /run/postgresql/note.txt; echo "rc=$?"Après la recréation, la requête relit les lignes -42 et -5 : les données
durables ont survécu. Le tmpfs recréé ne contient que .s.PGSQL.5432 et
.s.PGSQL.5432.lock, et cat répond No such file or directory avec le code 1 :
le fichier temporaire a disparu.
Pour une base, on monte le répertoire de données plutôt qu'un fichier.
PostgreSQL range tout son état dans un répertoire (PGDATA), mais d'autres
bases tiennent dans un seul fichier. SQLite en est l'exemple : selon la
documentation des fichiers temporaires de SQLite,
elle crée à côté du fichier de base des fichiers annexes, comme le journal de
retour arrière (-journal) ou le journal WAL (-wal), dans le même
répertoire. Monter seulement le fichier de base laisserait ces fichiers annexes
hors du volume : ils iraient dans la racine du conteneur, où l'écriture échoue
en lecture seule. On monte donc le répertoire qui les contient. Ici, PGDATA
vaut /var/lib/postgresql/18/docker, et l'image déclare
VOLUME /var/lib/postgresql, son parent.
Un piège se voit sur cette image. Sans option -v, l'instruction VOLUME crée
un volume anonyme, même avec --read-only : les données n'apparaissent pas
dans docker diff, et un docker rm -f sans -v laisse ce volume sur
l'hôte. Nommez toujours le volume des données, et retirez les orphelins avec
docker rm -v ou docker volume rm.
Comment déclarer la racine figée et le tmpfs dans un fichier Compose ?
Section intitulée « Comment déclarer la racine figée et le tmpfs dans un fichier Compose ? »Dans un fichier Compose, read_only: true correspond à --read-only, la liste
tmpfs: à --tmpfs, et stop_grace_period à --stop-timeout. Voici le même
service que plus haut, mesuré avec Compose 5.6.1. Enregistrez ce fichier sous
compose.yaml dans le dossier de travail. Le nom de projet carnet-compose
garde les objets séparés de ceux des sections précédentes.
name: carnet-composeservices: pg: image: postgres:18@sha256:3a4264520e121176619f54ff867d12774bc81e95e7b84db58d63bccdb6144b81 container_name: carnet-compose-pg user: "999:999" read_only: true tmpfs: - /run/postgresql:size=1m,noexec,nosuid,uid=999,gid=999,mode=0750 stop_grace_period: 20s environment: POSTGRES_HOST_AUTH_METHOD: trust volumes: - donnees:/var/lib/postgresqlvolumes: donnees: {}La forme courte de tmpfs: reprend la même chaîne d'options que --tmpfs.
Lancez le service et lisez ce que le moteur a retenu.
docker compose up -duntil docker exec carnet-compose-pg pg_isready -q; do sleep 1; donedocker inspect carnet-compose-pg --format 'ro={{.HostConfig.ReadonlyRootfs}} tmpfs={{json .HostConfig.Tmpfs}} stoptimeout={{.Config.StopTimeout}} mounts={{json .HostConfig.Mounts}}'docker exec carnet-compose-pg mount | grep ' on /run/postgresql 'docker compose stopdocker compose down -vLa sortie de docker inspect est la suivante, et le mount montre le même
tmpfs qu'avec docker run.
ro=true tmpfs={"/run/postgresql":"size=1m,noexec,nosuid,uid=999,gid=999,mode=0750"} stoptimeout=20 mounts=nulltmpfs on /run/postgresql type tmpfs (rw,nosuid,nodev,noexec,relatime,size=1024k,mode=750,uid=999,gid=999,inode64)stop_grace_period: 20s devient Config.StopTimeout=20. La leçon
Encadrer ressources et redémarrage d'une stack
détaille cette clé et les autres limites d'un service Compose.
Un piège attend celui qui écrit le tmpfs en forme longue, sous
volumes: avec type: tmpfs, target: et tmpfs: { size: 1048576, mode: 0750 }.
Le moteur obtient alors le même montage, avec la même taille, mais la
déclaration n'est plus au même endroit : HostConfig.Tmpfs vaut null et le
tmpfs apparaît dans HostConfig.Mounts, sous la forme
{"Type":"tmpfs","Target":"/run/postgresql","TmpfsOptions":{"SizeBytes":1048576,"Mode":488}}
(488 est 0750 en décimal). Un contrôle qui ne lit que HostConfig.Tmpfs ne le
voit donc pas. La forme longue pose aussi nosuid, nodev et noexec d'office,
comme la forme courte sans options. Dans notre mesure, elle n'a posé ni uid ni
gid : avec
user: "999:999", le tmpfs reste à root en mode 0750 et PostgreSQL s'arrête
sur FATAL: could not open lock file "/var/run/postgresql/.s.PGSQL.5432.lock": Permission denied.
Écrire malgré cela noexec,nosuid en forme courte reste utile : la déclaration
dit ce que vous voulez, sans dépendre d'un réglage par défaut.
Comment préparer un volume pour un service non root ?
Section intitulée « Comment préparer un volume pour un service non root ? »Pour retirer root du service, lancez-le avec --user 999:999. Le script
d'entrée de l'image ne tente alors plus de changer un propriétaire, et le
processus PID 1 est postgres, UID 999.
Retirer les capacités (les droits particuliers de root) sans passer --user
casse au contraire le démarrage. Avec --cap-drop ALL et
--security-opt no-new-privileges en root, le conteneur sort en code 1 sur
chown: changing ownership of '/var/lib/postgresql/18/docker': Operation not permitted.
Le piège est le volume, et il ne se voit pas toujours. Un volume nommé vierge
monté sur /var/lib/postgresql, un chemin qui existe dans l'image, hérite du
propriétaire de l'image au premier montage : le service non root y démarre sans
rien préparer, et l'essai ne montre aucun problème. Monté sur un chemin absent
de l'image, le volume appartient à root, et le service non root échoue. Voici
ce second cas, avec PGDATA placé sous /pgdata.
docker volume create carnet-neufdocker run -d --name carnet-u --user 999:999 --read-only --tmpfs "$T" \ -v carnet-neuf:/pgdata -e PGDATA=/pgdata/data \ -e POSTGRES_HOST_AUTH_METHOD=trust "$IMG"sleep 5docker inspect carnet-u --format 'exit={{.State.ExitCode}}'docker logs carnet-u 2>&1 | tail -1La sortie est exit=1, puis
mkdir: cannot create directory ‘/pgdata/data’: Permission denied. Le service
n'a pas le droit de créer son répertoire de données dans un volume qui
appartient à root. Corrigez le propriétaire une seule fois, avec un
conteneur root jetable : chown 999:999 donne le volume à l'UID du service, et
chmod 0700 le réserve à lui. Relancez ensuite le service sans root.
docker rm -fv carnet-udocker run --rm -v carnet-neuf:/v --entrypoint sh "$IMG" -c 'chown 999:999 /v && chmod 0700 /v && ls -ldn /v'docker run -d --name carnet-u --user 999:999 --read-only --tmpfs "$T" \ -v carnet-neuf:/pgdata -e PGDATA=/pgdata/data \ -e POSTGRES_HOST_AUTH_METHOD=trust "$IMG"until docker exec carnet-u pg_isready -q; do sleep 1; donedocker exec carnet-u ls -ldn /pgdata /pgdata/dataLa préparation affiche drwx------ 2 999 999 ... /v, puis le service démarre
et crée /pgdata/data en drwx------ 999 999. Le conteneur de préparation
est lancé avec --rm : il ne laisse aucune trace, et le service n'a jamais
été root. Le tmpfs appartient lui aussi à 999:999 (uid=999,gid=999), pour
que le service écrive son socket sans qu'un script root ait à corriger le
propriétaire. Retirez ces deux ressources avant de continuer.
docker rm -fv carnet-udocker volume rm carnet-neufQue change chown sur un volume qui contient déjà des fichiers ?
Section intitulée « Que change chown sur un volume qui contient déjà des fichiers ? »Le volume vierge ci-dessus ne contenait rien. Un volume qui sert déjà, avec un
autre propriétaire, demande une précaution de plus : chown sans -R ne
change que le répertoire visé, pas les fichiers qu'il contient. L'essai crée
un volume garni de fichiers appartenant à l'UID 1000, puis compare les deux
commandes avec ls -ln, qui affiche les propriétaires en numéros.
docker volume create carnet-garnidocker run --rm -v carnet-garni:/v --entrypoint sh "$IMG" -c 'mkdir /v/sous && echo a > /v/sous/a.txt && echo b > /v/b.txt && chown -R 1000:1000 /v && ls -ldn /v /v/b.txt /v/sous /v/sous/a.txt'docker run --rm -v carnet-garni:/v --entrypoint sh "$IMG" -c 'chown 999:999 /v && ls -ldn /v /v/b.txt /v/sous /v/sous/a.txt'docker run --rm -v carnet-garni:/v --entrypoint sh "$IMG" -c 'chown -R 999:999 /v && ls -ldn /v /v/b.txt /v/sous /v/sous/a.txt'docker volume rm carnet-garniLes trois commandes ls affichent respectivement ceci (dates retirées).
drwxr-xr-x 3 1000 1000 4096 /v-rw-r--r-- 1 1000 1000 2 /v/b.txtdrwxr-xr-x 2 1000 1000 4096 /v/sous-rw-r--r-- 1 1000 1000 2 /v/sous/a.txtdrwxr-xr-x 3 999 999 4096 /v-rw-r--r-- 1 1000 1000 2 /v/b.txtdrwxr-xr-x 2 1000 1000 4096 /v/sous-rw-r--r-- 1 1000 1000 2 /v/sous/a.txtdrwxr-xr-x 3 999 999 4096 /v-rw-r--r-- 1 999 999 2 /v/b.txtdrwxr-xr-x 2 999 999 4096 /v/sous-rw-r--r-- 1 999 999 2 /v/sous/a.txtAprès le chown simple, seul /v est passé à 999 : le service non root ne
pourrait pas lire b.txt ni écrire dans sous si leur mode l'interdisait. Avec
chown -R, tout l'arbre change. Sur un volume garni, utilisez donc -R, et
sauvegardez-le avant si les données comptent.
Le volume carnet-donnees reste en place : ses données appartiennent à
l'utilisateur postgres (UID 999), que le service non root de la section
suivante retrouve.
Comment arrêter ce service durci sans rien perdre ?
Section intitulée « Comment arrêter ce service durci sans rien perdre ? »Une base s'arrête proprement quand elle termine ses écritures validées, puis
écrit un point de contrôle : elle vide sur disque ce qui reste en mémoire.
Pour arrêter un conteneur, Docker envoie d'abord un signal à son processus
principal, celui de l'image (Config.StopSignal). Si le processus tient encore
à la fin du délai de grâce, Docker envoie SIGKILL. Ce délai se règle avec
--stop-timeout (la clé Compose équivalente, stop_grace_period, est vue plus
haut). Relancez le service durci avec un délai de 20 secondes, et lisez
ses réglages.
docker rm -f carnet-pgdocker run -d --name carnet-pg --network carnet-net --user 999:999 --read-only \ --tmpfs "$T" --stop-timeout 20 \ -v carnet-donnees:/var/lib/postgresql \ -e POSTGRES_HOST_AUTH_METHOD=trust "$IMG"until docker exec carnet-pg pg_isready -q; do sleep 1; donedocker inspect carnet-pg --format 'StopSignal={{json .Config.StopSignal}} StopTimeout={{json .Config.StopTimeout}} user={{.Config.User}} ro={{.HostConfig.ReadonlyRootfs}}'Le résultat est StopSignal="SIGINT" StopTimeout=20 user=999:999 ro=true.
Le signal vient de l'image, le délai de votre option.
Pour mesurer ce qu'un arrêt préserve, il faut des écritures en cours. Deux
petits clients PostgreSQL, chacun dans son conteneur, les fournissent. Le
premier insère une ligne à la fois : chaque INSERT est une transaction validée
(un groupe d'écritures que la base s'engage à conserver), et le client affiche
ack N après chaque validation. Il reçoit en argument le premier identifiant à
insérer. Le second ouvre une transaction qu'il ne valide jamais. Lancez-les,
laissez-les travailler quelques secondes, puis arrêtez le service.
docker run -d --name carnet-cli --network carnet-net --entrypoint bash "$IMG" -c \ 'i=$1; while psql -h carnet-pg -U postgres -qtA -c "insert into journal(id, note) values ($i, '"'"'valide'"'"')" >/dev/null 2>/tmp/err; do echo "ack $i"; i=$((i+1)); done; echo "fin client apres ack $((i-1)) : $(cat /tmp/err)"' _ 1docker run -d --name carnet-tx --network carnet-net --entrypoint bash "$IMG" -c \ 'psql -h carnet-pg -U postgres -qtA -c "begin; insert into journal(id, note) values (999999, '"'"'non validee'"'"'); select pg_sleep(600); commit;" ; echo "sortie client tx rc=$?"'sleep 4time docker stop carnet-pgdocker inspect carnet-pg --format 'exit={{.State.ExitCode}} oom={{.State.OOMKilled}}'docker logs carnet-pg 2>&1 | tail -11Lors de la mesure, time a affiché 0,232 s pour docker stop et le code de
sortie est 0, sans OOMKilled. Le journal montre un arrêt ordonné : les
sessions sont coupées, un point de contrôle d'arrêt s'écrit, puis le serveur
s'éteint (extrait sans horodatages ; le journal réel contient aussi les lignes
STATEMENT des requêtes coupées).
LOG: received fast shutdown requestLOG: aborting any active transactionsFATAL: terminating connection due to administrator commandLOG: background worker "logical replication launcher" (PID ...) exited with exit code 1LOG: shutting downLOG: checkpoint starting: shutdown immediateLOG: checkpoint complete: ...LOG: database system is shut downLa ligne logical replication launcher ... exited with exit code 1 est normale
à l'arrêt : elle apparaît à chaque arrêt rapide observé ici, quand ce
processus auxiliaire (la réplication logique) s'éteint avec le serveur, et le
conteneur sort pourtant avec le code 0. Ce n'est pas une erreur.
Le signal SIGINT déclenche donc l'arrêt rapide de PostgreSQL : il
interrompt les sessions, annule les transactions ouvertes et ne conserve que
ce qui est validé. « Terminer l'écriture en cours » est vrai pour l'INSERT en
cours de validation, faux pour la transaction que le client n'a pas validée.
Redémarrez le même conteneur et relisez les lignes.
AVANT=$(docker logs carnet-pg 2>&1 | wc -l)docker start carnet-pguntil docker exec carnet-pg pg_isready -q; do sleep 1; donedocker logs carnet-pg 2>&1 | tail -n +$((AVANT + 1)) | grep -ciE "not properly shut down|automatic recovery|redo starts"docker exec carnet-pg psql -U postgres -tA -c "select count(*), max(id), bool_and(note='valide') from journal where id>0"docker exec carnet-pg psql -U postgres -tA -c "select count(*) from journal where id=999999"docker logs carnet-cli 2>&1 | grep '^ack' | tail -1Le premier comptage vaut 0 : le redémarrage n'a demandé aucune récupération,
parce que le serveur s'était arrêté proprement. La commande ne lit que les lignes
écrites après docker start, car le journal du conteneur garde aussi son
premier démarrage, qui a suivi un docker rm -f des sections précédentes.
Lors de la mesure, la base contenait 216|216|t : les lignes 1 à 216, toutes
validées, et ack 216 était le dernier accusé du client. Ce nombre dépend de
l'instant de l'arrêt : le vôtre sera différent. La transaction 999999 a 0
ligne : elle a été annulée. Le client en boucle s'est arrêté sur une erreur de connexion (connection to server was lost,
ou the database system is shutting down selon l'instant), et le client de
transaction est sorti avec le code 2.
Que garantit un arrêt forcé, et que perd-on ?
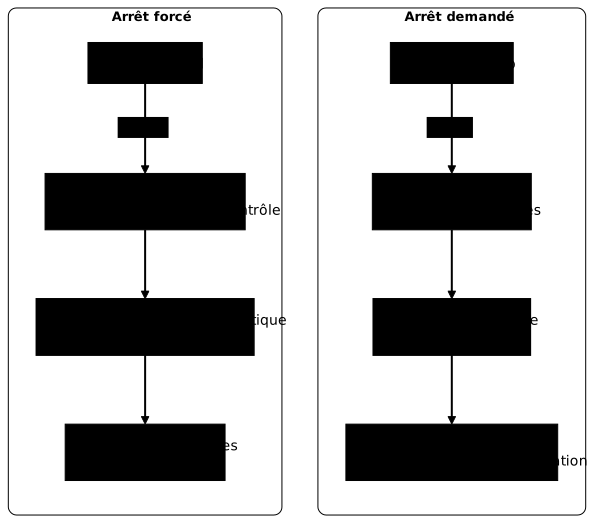
Section intitulée « Que garantit un arrêt forcé, et que perd-on ? »docker kill envoie SIGKILL sans attendre : le serveur n'a pas le temps
d'écrire un point de contrôle. Le schéma compare les deux arrêts. Dans chaque
colonne, la case rouge est ce qui les distingue : le point de contrôle écrit à
l'arrêt demandé, la récupération automatique qu'impose l'arrêt forcé.
Recréez le service, puis relancez les deux clients.
docker rm -fv carnet-pg carnet-cli carnet-txdocker run -d --name carnet-pg --network carnet-net --user 999:999 --read-only \ --tmpfs "$T" --stop-timeout 20 \ -v carnet-donnees:/var/lib/postgresql \ -e POSTGRES_HOST_AUTH_METHOD=trust "$IMG"until docker exec carnet-pg pg_isready -q; do sleep 1; doneLe premier client doit insérer à partir de l'identifiant qui suit le dernier déjà
présent, sinon il échouerait sur une clé en double. Calculez cet identifiant dans
NEXT, puis relancez les deux clients, le premier avec _ "$NEXT" à la place
de _ 1.
NEXT=$(( $(docker exec carnet-pg psql -U postgres -tA -c "select max(id) from journal") + 1 ))docker run -d --name carnet-cli --network carnet-net --entrypoint bash "$IMG" -c \ 'i=$1; while psql -h carnet-pg -U postgres -qtA -c "insert into journal(id, note) values ($i, '"'"'valide'"'"')" >/dev/null 2>/tmp/err; do echo "ack $i"; i=$((i+1)); done; echo "fin client apres ack $((i-1)) : $(cat /tmp/err)"' _ "$NEXT"docker run -d --name carnet-tx --network carnet-net --entrypoint bash "$IMG" -c \ 'psql -h carnet-pg -U postgres -qtA -c "begin; insert into journal(id, note) values (999999, '"'"'non validee'"'"'); select pg_sleep(600); commit;" ; echo "sortie client tx rc=$?"'Laissez les clients travailler quatre secondes, puis forcez l'arrêt, relancez le
service et relisez le journal. Les valeurs 422 de la sortie ci-dessous viennent
de la mesure : les vôtres diffèrent, seule compte l'égalité entre le dernier
ack et la base.
sleep 4time docker kill carnet-pgdocker inspect carnet-pg --format 'exit={{.State.ExitCode}} oom={{.State.OOMKilled}}'docker rm -f carnet-pgdocker run -d --name carnet-pg --network carnet-net --user 999:999 --read-only \ --tmpfs "$T" --stop-timeout 20 \ -v carnet-donnees:/var/lib/postgresql \ -e POSTGRES_HOST_AUTH_METHOD=trust "$IMG"until docker exec carnet-pg pg_isready -q; do sleep 1; donedocker logs carnet-pg 2>&1 | grep -E 'interrupted|not properly|redo|invalid record|checkpoint starting|ready'La commande a duré 0,183 s selon time et le code de sortie est 137, soit
128 plus le numéro 9 du signal SIGKILL. Le client en boucle s'arrête sur
Connection refused après son dernier ack. Au redémarrage sur le même volume,
PostgreSQL constate qu'il ne s'est pas arrêté proprement, relit son journal de
transactions et rejoue ce qu'il contient : c'est la récupération automatique.
Le journal du redémarrage ressemble à ceci, horodatages retirés.
LOG: database system was interrupted; last known up at ...LOG: database system was not properly shut down; automatic recovery in progressLOG: redo starts at 0/17B00C0LOG: invalid record length at 0/17BCBA0: expected at least 24, got 0LOG: redo done at 0/17BCB78 ...LOG: checkpoint starting: end-of-recovery immediate waitLOG: checkpoint complete: ...LOG: database system is ready to accept connectionsLa ligne invalid record length n'est pas une corruption. Elle marque la fin du
journal : le serveur a rejoué ce qu'il pouvait et s'est arrêté à la première
entrée vide, puis il a démarré. Relisez maintenant les données, essayez une
écriture et vérifiez que le durcissement n'a pas bougé.
docker exec carnet-pg psql -U postgres -tA -c "select count(*), max(id), bool_and(note='valide') from journal where id>0"docker exec carnet-pg psql -U postgres -tA -c "select count(*) from journal where id=999999"docker logs carnet-cli 2>&1 | grep '^ack' | tail -1docker exec carnet-pg psql -U postgres -tA -c "insert into journal values (7777777, 'apres'); select count(*) from journal where id=7777777"docker inspect carnet-pg --format 'user={{.Config.User}} ro={{.HostConfig.ReadonlyRootfs}}'docker diff carnet-pgLa base contenait alors 422|422|t, pour un dernier ack client de 422, et la
transaction 999999 est absente. L'écriture suivante réussit (la dernière requête
rend 1). Le service a repris avec user=999:999 ro=true : aucune étape n'a
rendu la racine inscriptible ni repassé le service en root, et docker diff
reste vide.
Retenez ce que cela garantit. Dans le cas mesuré, une transaction validée survit à l'arrêt forcé, parce que le journal est écrit avant la validation. Le guide Transactions : ce que promettent ACID et BASE détaille cette garantie de durabilité. Une transaction non validée est perdue, et son client reçoit une erreur de connexion.
Cette garantie a une limite : docker kill tue le processus, pas la machine. Le
noyau de l'hôte continue de tourner et garde les écritures déjà confiées à son
cache. Une coupure de courant est un autre cas, dont la garantie dépend des
réglages fsync et synchronous_commit de PostgreSQL, décrits dans
sa documentation.
Cette leçon ne l'a pas mesuré.
Cette garantie ne va pas jusqu'à un décompte exact : le client a pu ne pas recevoir l'accusé d'une transaction que le serveur avait déjà validée, donc la base contient au moins toutes les lignes acquittées, pas forcément exactement les mêmes. L'arrêt forcé garde les données, mais il impose une récupération et coupe les clients sans préavis ; l'arrêt propre évite les deux.
Quand le durcissement ou le signal empêche-t-il l'arrêt rapide ?
Section intitulée « Quand le durcissement ou le signal empêche-t-il l'arrêt rapide ? »Un mauvais signal d'arrêt rend le délai de grâce inutile. Avec
--stop-signal SIGTERM, PostgreSQL lance un arrêt « intelligent » : il refuse
les nouvelles connexions mais attend que les sessions ouvertes se terminent.
Le bloc suivant lance un second service avec ce signal, sur un volume neuf,
ouvre une session select pg_sleep(600) et chronomètre l'arrêt avec un délai de
10 secondes.
docker run -d --name carnet-smart --network carnet-net --user 999:999 --read-only \ --tmpfs "$T" --stop-signal SIGTERM --stop-timeout 10 \ -v carnet-smart:/var/lib/postgresql \ -e POSTGRES_HOST_AUTH_METHOD=trust "$IMG"until docker exec carnet-smart pg_isready -q; do sleep 1; donedocker run -d --name carnet-idle --network carnet-net --entrypoint bash "$IMG" -c \ 'psql -h carnet-smart -U postgres -qtA -c "select pg_sleep(600)"'sleep 2time docker stop carnet-smartdocker inspect carnet-smart --format 'exit={{.State.ExitCode}}'docker logs carnet-smart 2>&1 | tail -1docker rm -fv carnet-smart carnet-idledocker volume rm carnet-smartDans la même série de mesures, l'arrêt avec SIGINT a duré 0,232 s, alors que
celui-ci a duré 10,182 s et rendu le code 137 : à l'échéance du délai, Docker a
dû envoyer SIGKILL. Le journal s'arrête sur received smart shutdown request,
sans la moindre ligne d'arrêt.
Le signal d'arrêt compte donc plus que le délai : lisez Config.StopSignal
d'abord, puis ajustez --stop-timeout. Le durcissement peut aussi casser
l'arrêt autrement. Un service lancé en root avec les capacités retirées échoue au
démarrage (vu plus haut), et un tmpfs trop petit ou un volume non préparé fait
sortir le service en erreur avant tout arrêt. Dans les deux cas, le code de
sortie et le journal désignent la cause.
Nettoyage
Section intitulée « Nettoyage »Supprimez les conteneurs, le volume et le réseau de l'atelier. -fv retire
aussi d'éventuels volumes anonymes laissés par l'image.
docker rm -fv carnet-pg carnet-cli carnet-tx carnet-u carnet-temoin carnet-zone carnet-mem carnet-smart carnet-idledocker compose -f compose.yaml down -vdocker volume rm carnet-donnees carnet-neuf carnet-garni carnet-smartdocker network rm carnet-netrm -f compose.yamlcd ~ && rmdir ~/atelier-lecture-seuledocker rm -f ignore sans message un nom de conteneur inexistant, alors que
docker volume rm et docker network rm signalent une ressource absente :
les messages no such volume qui s'affichent concernent des volumes déjà
retirés par les sections précédentes, et ils sont sans conséquence. docker volume ls
ne doit plus montrer aucun volume, ni nommé ni anonyme, et docker ps -a aucun
conteneur carnet-*.
Mettre en pratique
Section intitulée « Mettre en pratique »Le premier lab vous fait figer la racine d'un service existant qui écrit dans
un répertoire d'exécution. Vous déclarez ce répertoire comme tmpfs avec une
taille, noexec et nosuid, sans casser le service. Le lab tente ensuite une
écriture à la racine pour y trouver Read-only file system, vérifie que le
répertoire d'exécution reste inscriptible et que le service continue de
travailler. Pour le tmpfs, il lit le système et non la déclaration : mount
et df dans le conteneur doivent montrer un tmpfs borné, monté noexec et
nosuid. La forme courte (--tmpfs ou tmpfs: de Compose) et la forme longue
de Compose passent donc toutes les deux.
Le second lab vous demande de réparer le lancement et l'arrêt d'un service qui enregistre des écritures, pour qu'il reçoive son signal d'arrêt et termine l'écriture en cours dans le délai de grâce avec le code 0. Vous relisez les données après recréation sur le même volume, puis comparez avec un arrêt forcé : le client échoue, les anciennes lignes restent lisibles et l'écriture suivante réussit, tandis que la ligne de l'écriture tuée n'apparaît pas. Le lab vérifie aussi que le service tourne en non root, racine en lecture seule, sur un volume privé préparé pour lui, que les fichiers existants ont le bon propriétaire, et qu'un autre utilisateur n'y accède pas. Il contrôle enfin la configuration : en changeant une seule variable d'environnement de la même image, le comportement du service change sans que les données déjà enregistrées disparaissent.
À retenir
Section intitulée « À retenir »--read-onlyne rend non inscriptible que la couche propre au conteneur : volumes ettmpfsrestent inscriptibles.- On recense les écritures avec
docker diffsur un témoin avant de figer ;docker diffne voit ni volume nitmpfs. - Chaque répertoire écrit hors volume devient un
tmpfsborné (size,noexec,nosuid) ; il consomme de la mémoire du conteneur et disparaît à l'arrêt. En Compose, la forme courte detmpfs:garde ces options ; la forme longue, telle que mesurée, ne pose niuidnigid. - Ce qui doit durer va dans un volume nommé ; un volume anonyme de l'image survit à
docker rm -fsi on oublie-v. - Un volume monté hors du chemin de l'image appartient à root : on le prépare une fois avec un conteneur root jetable, puis le service tourne avec
--user. - Le signal d'arrêt se lit dans
Config.StopSignalavant de régler--stop-timeout: un mauvais signal fait attendre tout le délai, puisSIGKILL(code 137). - Une transaction validée survit à
docker killgrâce à la récupération automatique ; une transaction non validée est perdue. trustn'est qu'un réglage de démonstration : un service réel passe un secret.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Les questions portent sur ce que la leçon a mesuré : ce que --read-only fige
et ce qu'il laisse inscriptible, le recensement des écritures avec
docker diff, le dimensionnement d'un tmpfs, la préparation d'un volume
pour un service non root et le choix du signal d'arrêt. Une réponse fausse
renvoie à la section qui l'explique.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Diagnostiquer réseau et pare-feu
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications