Une transaction regroupe plusieurs opérations en un tout que la base accepte en entier ou refuse en entier. Cette leçon s'adresse à qui administre ou choisit une base de données et veut savoir ce que ce tout ou rien promet réellement. Elle vaut pour tous les moteurs relationnels, PostgreSQL comme MySQL. Le fil rouge reste le suivi d'incidents sur un parc de serveurs de la leçon précédente. Vous verrez les quatre garanties d'ACID, dont une seule se règle, l'isolation, puis BASE, le contrat que choisissent certains systèmes répartis, et comment décider entre les deux.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Définir une transaction et expliquer pourquoi le tout ou rien fonde la confiance dans une base
- Associer chaque lettre d'ACID à l'incident qu'elle évite
- Nommer les anomalies d'isolation et dire pourquoi le niveau par défaut change d'un moteur à l'autre
- Expliquer BASE comme un contrat distinct d'ACID, avec ce qu'il gagne et ce qu'il perd
- Choisir entre ACID et BASE sur un cas réaliste
Qu'est-ce qu'une transaction, et pourquoi le tout ou rien ?
Section intitulée « Qu'est-ce qu'une transaction, et pourquoi le tout ou rien ? »Une transaction est une suite d'opérations que la base traite comme une seule unité : soit toutes réussissent et sont validées (on dit commit), soit aucune ne prend effet et tout est annulé (on dit rollback). Il n'existe pas d'entre-deux : la base ne garde jamais le résultat d'une transaction à moitié exécutée.
Dans notre parc, clôturer un incident n'est jamais une seule écriture. Il faut passer l'incident à l'état « résolu », décrémenter le compteur d'incidents ouverts du serveur (une valeur précalculée et recopiée, dite dénormalisée, que la base ne tient pas à jour toute seule : voir Modéliser des données) et ajouter une ligne à l'historique. Si une seule de ces trois écritures manque, les chiffres se contredisent. La transaction transforme cette liste de gestes en un seul geste fiable, et c'est ce qui permet de se fier à une base sans relire ses tables après chaque panne.
Les bases relationnelles tiennent cette promesse sous le nom d'ACID.
Que promet chaque lettre d'ACID ?
Section intitulée « Que promet chaque lettre d'ACID ? »ACID réunit quatre garanties : Atomicité, Cohérence, Isolation, Durabilité. Chacune évite un dégât précis.
Atomicité : que devient une opération coupée en deux ?
Section intitulée « Atomicité : que devient une opération coupée en deux ? »L'atomicité garantit le tout ou rien. Si le serveur s'arrête après l'écriture de l'état « résolu » et avant celle du compteur, la base annule l'incident au redémarrage : il reste ouvert, comme si rien ne s'était passé. Sans atomicité, vous auriez un incident clos et un compteur qui affiche encore trois alertes, sans aucun message d'erreur pour le signaler.
Cohérence : qui garde les règles du modèle ?
Section intitulée « Cohérence : qui garde les règles du modèle ? »La cohérence garantit qu'une transaction amène la base d'un état valide à un autre état valide, au sens des règles déclarées : clés étrangères, contraintes d'unicité, colonnes obligatoires, vérifications. Une transaction qui violerait une règle est refusée en entier. Deux nuances évitent un contresens fréquent. Cette cohérence ne vérifie que ce que le modèle a déclaré : une règle que personne n'a écrite à la base n'est pas protégée. Et elle n'a rien à voir avec la cohérence du théorème CAP, qui parle de copies d'une donnée sur plusieurs machines (voir la section sur BASE).
Durabilité : qu'est-ce qui survit à une panne ?
Section intitulée « Durabilité : qu'est-ce qui survit à une panne ? »La durabilité garantit qu'une fois la transaction confirmée à l'application, son résultat survit à un arrêt brutal : la base a écrit l'essentiel dans un journal sur disque avant de répondre. Elle promet de ne pas oublier ce qu'on a validé, pas de valider seulement ce qui est juste : une suppression erronée mais validée est parfaitement durable, et la perte du disque entier se traite par la sauvegarde et la réplication, pas par la transaction.
Pourquoi l'isolation est-elle la lettre qui se négocie ?
Section intitulée « Pourquoi l'isolation est-elle la lettre qui se négocie ? »Les trois autres lettres sont des garanties binaires : une transaction est atomique, ou elle ne l'est pas. L'isolation, elle, est un réglage à plusieurs niveaux. Elle décrit ce qu'une transaction voit des modifications que d'autres transactions font au même moment. Plus le niveau est strict, plus la base doit coordonner les sessions, c'est-à-dire les connexions qui travaillent en même temps (faire attendre, refuser, faire rejouer), et moins elle peut mener de travaux en parallèle, ce qu'on appelle la concurrence. Un niveau permissif va plus vite, mais autorise des lectures surprenantes.
Une idée répandue veut que l'isolation garantisse de ne rien voir des autres transactions. C'est faux, et même le niveau le plus strict, SERIALIZABLE, ne le promet pas : il garantit un résultat identique à une exécution l'une après l'autre, que le moteur obtient en faisant attendre ou échouer une transaction. Un moteur a le droit d'être plus strict que la promesse de son niveau, ce que fait PostgreSQL (voir sous le tableau des niveaux). Les anomalies ci-dessous disent ce qu'un niveau laisse voir des autres transactions.
Quelles anomalies l'isolation laisse-t-elle passer ?
Section intitulée « Quelles anomalies l'isolation laisse-t-elle passer ? »Le standard SQL nomme trois anomalies, c'est-à-dire trois façons dont une lecture peut surprendre.
- Une lecture sale lit une modification d'une autre transaction pas encore validée, qui sera peut-être annulée.
- Une lecture non répétable relit la même ligne dans la même transaction et obtient une autre valeur, parce qu'une autre transaction l'a modifiée et validée entre-temps.
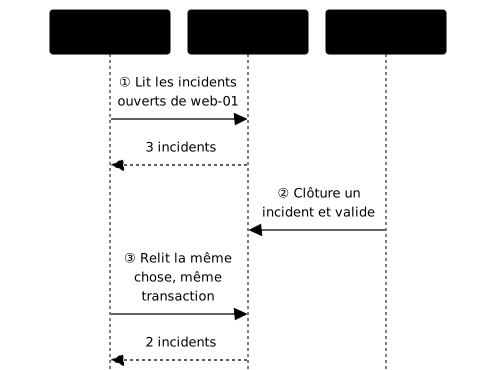
- Des lignes fantômes apparaissent quand la même requête de plage (« tous les incidents de web-01 ») rend un autre ensemble de lignes, parce qu'une autre transaction en a inséré ou supprimé : un nouvel incident surgit dans la liste.
Le schéma montre une lecture non répétable dans le temps. Regardez la technicienne A : elle pose la même question deux fois dans la même transaction et obtient 3 puis 2, alors que rien n'a changé de son côté. Entre les deux lectures, le technicien B a fait passer un des incidents déjà lus de « ouvert » à « résolu » et a validé : c'est lui qui a changé la réponse.
D'autres anomalies existent hors de ce standard, comme la mise à jour perdue, où deux sessions lisent une valeur puis écrivent chacune la leur : l'une écrase l'autre. Les trois anomalies ne servent qu'à situer les niveaux.
Quel niveau autorise quelle anomalie ?
Section intitulée « Quel niveau autorise quelle anomalie ? »Le standard définit quatre niveaux, du plus permissif au plus strict. Ce tableau donne ce que chacun peut laisser passer au maximum.
| Niveau | Lecture sale | Lecture non répétable | Lignes fantômes |
|---|---|---|---|
READ UNCOMMITTED | possible | possible | possible |
READ COMMITTED | impossible | possible | possible |
REPEATABLE READ | impossible | impossible | possible |
SERIALIZABLE | impossible | impossible | impossible |
Le piège pratique est que les moteurs ne partent pas du même niveau. PostgreSQL applique READ COMMITTED par défaut, MySQL avec InnoDB applique REPEATABLE READ. Un même code peut donc se comporter différemment d'un moteur à l'autre, et une migration de l'un vers l'autre déplace des bugs.
PostgreSQL profite en outre deux fois de la liberté d'être plus strict que le standard. D'abord, il traite READ UNCOMMITTED comme READ COMMITTED, si bien que le travail non validé d'autrui reste invisible à tous les niveaux : aucune lecture sale n'est possible. Ensuite, son REPEATABLE READ interdit aussi les lignes fantômes que le tableau autorise. Ce sont des comportements du moteur et non des promesses du niveau : un autre moteur n'est pas tenu de les offrir. Pour InnoDB, vérifiez le comportement réel dans la documentation du moteur plutôt que de le déduire du tableau.
La leçon sur les transactions et la concurrence rejoue ces niveaux sur deux sessions réellement concurrentes : l'attente sur verrou, la mise à jour perdue, l'interblocage et le délai maximal d'attente. Ici, on retient qu'il existe un niveau d'isolation à choisir, et qu'il arbitre cohérence de lecture contre débit.
Qu'est-ce que BASE, et pourquoi existe-t-il ?
Section intitulée « Qu'est-ce que BASE, et pourquoi existe-t-il ? »BASE est un acronyme qui signifie Basically Available, Soft state, Eventually consistent : « essentiellement disponible, état souple, cohérent à terme ». Le nom, un jeu de mots avec ACID (acide et base en chimie), vient d'un article de Dan Pritchett en 2008 (« BASE: An Acid Alternative », ACM Queue). Il décrit une manière de concevoir des systèmes répartis sur plusieurs machines, pas une norme.
- Basically Available : le système continue de répondre, quitte à répondre avec des données partielles ou un peu anciennes, même quand une partie des machines ou du réseau est en panne.
- Soft state : l'état visible peut changer sans nouvelle écriture, parce que les copies d'une donnée se rattrapent entre elles.
- Eventually consistent : si plus personne n'écrit, toutes les copies finissent par converger vers la même valeur, sans promettre quand.
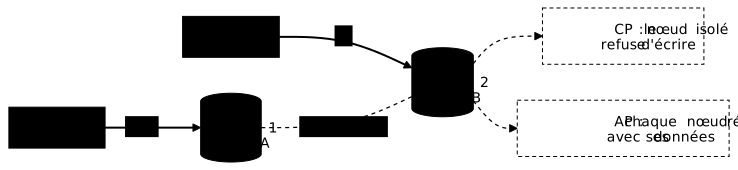
L'origine du choix est la coupure réseau. Dès que les données sont copiées sur plusieurs machines, le réseau finit par se couper entre elles, et le système doit trancher : refuser les requêtes pour rester cohérent, ou répondre avec des copies divergentes. C'est l'arbitrage du théorème CAP, détaillé dans Synchrone, asynchrone, eventual consistency. BASE choisit de répondre. Le schéma ci-dessous, repris de cette leçon, montre ce moment : regardez le nœud 2, isolé, qui doit soit refuser d'écrire, soit répondre avec ses propres données.
BASE est-il un ACID au rabais ?
Section intitulée « BASE est-il un ACID au rabais ? »Non : c'est un autre contrat, qui échange une garantie contre une autre. ACID protège la justesse de chaque transaction et la paie en coordination, donc en latence (le temps de réponse) et en disponibilité quand des machines se perdent. BASE protège la réponse rapide et permanente et la paie en lectures potentiellement périmées et en conflits d'écriture à résoudre. Le tableau compare les deux sur ce que l'on obtient et ce que l'on supporte.
| ACID | BASE | |
|---|---|---|
| Promesse centrale | chaque transaction est juste et durable | le système répond toujours |
| Lecture juste après une écriture | la nouvelle valeur | peut-être l'ancienne, un court instant |
| Pendant une coupure réseau | peut refuser des requêtes | répond avec des copies divergentes |
| Ce que l'application doit gérer | peu : la base garantit | conflits, doublons, compensations |
| Terrain d'origine | une base, un serveur principal | données réparties sur plusieurs machines |
Le coût passe donc de la base à l'application. Pour défaire une opération réussie à moitié sur plusieurs services, il n'y a plus d'annulation automatique : ce sont des compensations (le pattern Saga, une suite d'étapes dont chacune a son action inverse, traité dans la leçon CAP citée plus haut) qui prennent le relais.
ACID et BASE se répartissent-ils entre SQL et NoSQL ?
Section intitulée « ACID et BASE se répartissent-ils entre SQL et NoSQL ? »Pas aussi nettement que l'idée reçue le dit, et l'état de 2026 doit être lu à jour. MongoDB propose des transactions sur plusieurs documents depuis la version 4.0 (2018), étendues en 4.2 aux clusters partitionnés, c'est-à-dire aux données réparties sur plusieurs machines. DynamoDB offre des écritures transactionnelles depuis fin 2018. Ces transactions ont des limites propres (taille, nombre d'éléments, coût) et ne rendent pas ces bases « relationnelles », mais affirmer qu'une base NoSQL ne sait pas faire de transaction est périmé.
L'inverse est vrai aussi : une base relationnelle avec un réplica en lecture asynchrone (une copie du serveur principal, alimentée avec un léger retard) offre, sur ce réplica, une cohérence à terme, puisqu'elle peut montrer une valeur déjà modifiée sur le principal (voir la réplication PostgreSQL). Le contrat dépend de ce que vous lisez et où, pas du logo du moteur. Pour les quatre familles de bases NoSQL et leur choix CAP, voir Bases NoSQL.
ACID ou BASE : lequel convient à quel besoin ?
Section intitulée « ACID ou BASE : lequel convient à quel besoin ? »La question utile est : que coûte une donnée fausse, et que coûte une réponse refusée ? Il n'y a pas de bon contrat en soi, seulement un contrat adapté à chaque donnée, et un même système en utilise souvent deux.
| Besoin | Contrat | Raison |
|---|---|---|
| Clôturer un incident et mettre à jour compteur et historique | ACID | trois écritures qui doivent tenir ensemble |
| Virement entre deux comptes | ACID | un débit sans crédit est une perte d'argent |
| Compteur de consultations de la page de statut | BASE | un écart de quelques unités est sans conséquence |
| Stock d'un article quand la dernière unité part | ACID | deux ventes de la dernière unité sont inacceptables |
Dans notre parc, l'historique des incidents reste dans une base transactionnelle, tandis que le nombre de consultations de la page publique peut se rapprocher des autres copies sans que personne ne s'en aperçoive. Un compte bancaire et un compteur de vues n'ont pas les mêmes besoins, et ce n'est pas une affaire de goût : c'est le prix de l'erreur qui tranche.
À retenir
Section intitulée « À retenir »- Une transaction est un tout ou rien : toutes ses opérations sont validées ensemble, ou aucune.
- Atomicité (pas d'état à moitié écrit), cohérence (les règles déclarées tiennent), durabilité (le validé survit à la panne) sont des garanties binaires.
- La durabilité ne protège ni d'une erreur validée ni de la perte du disque : ce sont les rôles de la sauvegarde et de la réplication.
- La cohérence d'ACID n'est pas celle de CAP : l'une parle de règles du modèle, l'autre de copies sur plusieurs machines.
- L'isolation est un réglage : chaque niveau en autorise plus ou moins (lecture sale, lecture non répétable, lignes fantômes), et seul
SERIALIZABLEéquivaut à une exécution l'une après l'autre. - Le niveau par défaut change selon le moteur :
READ COMMITTEDpour PostgreSQL,REPEATABLE READpour MySQL avec InnoDB. PostgreSQL se montre en outre plus strict que ce que ses niveaux promettent, ce qui reste un comportement du moteur et non une garantie du niveau. - BASE (Basically Available, Soft state, Eventually consistent) est un autre contrat : disponibilité contre lectures périmées temporaires, et un travail de compensation côté application.
- ACID et BASE ne correspondent pas à SQL et NoSQL : MongoDB et DynamoDB ont des transactions, et un réplica asynchrone relationnel est cohérent à terme.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Huit questions sur le tout ou rien et ce que promettent l'atomicité et la durabilité, les anomalies et les niveaux de l'isolation, ce que BASE échange contre quoi, et pourquoi ACID et BASE ne se répartissent pas entre SQL et NoSQL.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Comment fonctionne un serveur de base de données ?
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications