Les bases de données actuelles portent la trace de corrections successives : chaque génération a répondu au défaut de la précédente. Cette leçon s'adresse à qui administre ou choisit une base et veut comprendre d'où viennent les tables, SQL et le NoSQL, pour juger un outil sans s'en tenir à la mode. Elle ne demande aucun prérequis et vaut pour tous les moteurs.
Un SGBD (système de gestion de base de données, aussi appelé « moteur ») est le logiciel qui stocke les données et répond aux programmes qui les interrogent ; SQL est le langage standard pour lui poser des questions. Vous verrez ce qui coinçait avant 1970, ce que Codd, chercheur chez IBM, propose réellement, comment le modèle est devenu un produit, puis ce que la vague NoSQL des années 2000 a gagné et perdu. Les dates et les attributions citent leur source ; là où l'histoire est contestée, la leçon le dit.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Expliquer ce qui coinçait dans les bases hiérarchiques et en réseau
- Décrire l'indépendance des données proposée par Codd en 1970
- Attribuer correctement le modèle relationnel et le langage SQL
- Dire pourquoi une requête SQL décrit un résultat et non un chemin
- Nommer le problème que le NoSQL résolvait et ce qu'il a échangé en retour
Comment rangeait-on les données avant le modèle relationnel ?
Section intitulée « Comment rangeait-on les données avant le modèle relationnel ? »Avant 1970, un programme devait connaître le chemin physique vers les données qu'il lisait, et tout changement de rangement cassait le code. Les premiers systèmes étaient hiérarchiques : IMS, d'IBM, organise les données en arbre de parents et d'enfants, comme des dossiers rangés dans d'autres dossiers. Livré à la fin des années 1960, il servait d'abord à suivre les pièces du programme spatial Apollo (source : page historique d'IBM sur IMS).
Le modèle en réseau, spécifié par le groupe DBTG du consortium CODASYL dans un rapport d'octobre 1969, autorisait des liens plus libres entre enregistrements (les lignes de données). Mais dans les deux cas, le programme naviguait d'enregistrement en enregistrement en suivant des pointeurs, c'est-à-dire des adresses qui désignent l'enregistrement suivant. Charles Bachman en fit le titre de sa conférence du prix Turing 1973, « The Programmer as Navigator ».
Prenons le suivi d'incidents sur un parc de serveurs, fil rouge de la formation. Si les incidents sont rangés sous leur serveur, la question « tous les incidents ouverts, tous serveurs confondus » exige un programme écrit exprès, qui parcourt tous les arbres. Et si l'on décide de les ranger sous leur équipe plutôt que sous leur serveur, chaque programme est à réécrire. Ce coût de réécriture est le problème auquel Codd s'attaque.
Que propose vraiment Codd en 1970 ?
Section intitulée « Que propose vraiment Codd en 1970 ? »Edgar F. Codd, chercheur au laboratoire d'IBM à San Jose, publie en 1970 dans les Communications of the ACM l'article « A Relational Model of Data for Large Shared Data Banks ». Sa thèse tient dans sa première phrase : les futurs utilisateurs de grandes banques de données doivent être protégés de la nécessité de savoir comment les données sont organisées dans la machine. Il décrit les données par leur structure naturelle, sous forme de relations (ce que l'on appelle aujourd'hui des tables, avec leurs lignes et leurs colonnes), sans y superposer d'organisation propre à la machine.
L'article est une théorie : Codd précise lui-même qu'il ne discute pas la réalisation de systèmes. Il identifie trois dépendances à supprimer : celle à l'ordre de stockage (le programme suppose les données rangées dans un certain ordre), celle aux index (il suppose qu'un certain index existe ; un index est un répertoire annexe qui accélère la recherche) et celle au chemin d'accès (il suppose un itinéraire précis jusqu'aux données). Ce sont celles qui faisaient casser les programmes.
Qu'est-ce que l'indépendance des données ?
Section intitulée « Qu'est-ce que l'indépendance des données ? »L'indépendance des données est la séparation entre la façon dont les données sont rangées et la façon dont on les interroge. Regardez le schéma : sur la première rangée, le programme d'avant 1970 écrit lui-même le chemin physique jusqu'aux données ; sur la seconde, le programme relationnel décrit le résultat voulu et laisse le système, la case mise en avant, choisir le chemin.
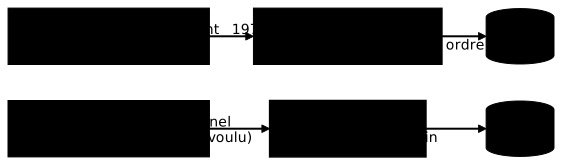
Cette séparation a une conséquence concrète : on peut ajouter un index, réorganiser les fichiers ou changer de serveur sans toucher aux requêtes. C'est elle que vous exploitez quand vous accélérez une recherche existante, sans réécrire l'application.
Comment le modèle est-il devenu un produit ?
Section intitulée « Comment le modèle est-il devenu un produit ? »Le modèle de Codd est resté un papier jusqu'à ce qu'un prototype complet le mette à l'épreuve. En 1973, une équipe d'IBM à San Jose lance le projet System R, avec notamment Donald Chamberlin, Raymond Boyce, Patricia Selinger (un optimiseur fondé sur le coût) et Raymond Lorie (source : page historique d'IBM sur la base relationnelle). À Berkeley, le projet Ingres suit une voie parallèle, avec son propre langage, QUEL.
IBM lance DB2 en 1983 sur mainframe (le gros système central des grandes entreprises). Côté standard, SQL est normalisé par l'ANSI en 1986, puis par l'ISO en 1987 : c'est ce qui rend les moteurs plus comparables et les compétences plus transférables.
Qui a inventé SQL, et Codd y a-t-il contribué ?
Section intitulée « Qui a inventé SQL, et Codd y a-t-il contribué ? »Non, Codd n'a pas conçu SQL. Le langage, d'abord nommé SEQUEL, est l'œuvre de Donald Chamberlin et Raymond Boyce chez IBM, présenté dans leur article de 1974 « SEQUEL: A Structured English Query Language ». Il a été renommé SQL parce que le nom SEQUEL appartenait déjà à une autre société, d'après Chamberlin lui-même.
Codd avait de son côté conçu son propre langage, Alpha, décrit dans un article de 1971. Chris Date, spécialiste du modèle relationnel, a publié en 1984 une critique de SQL qui relève plusieurs écarts entre le langage et le modèle. Écrire que Codd a conçu ou développé SQL est donc une confusion courante, à ne pas recopier.
Pourquoi SQL est-il déclaratif ?
Section intitulée « Pourquoi SQL est-il déclaratif ? »Un langage déclaratif décrit le résultat voulu, jamais la méthode pour l'obtenir. C'est l'indépendance des données devenue langage, et elle n'est tenable que parce que le système sait choisir seul. Le rôle de l'optimiseur de System R était précisément de comparer les chemins possibles et de retenir le moins coûteux. Le langage lui-même s'apprend dans la formation SQL ; le modèle en pratique, dans Modéliser des données.
Qui a vendu le premier SGBD relationnel commercial ?
Section intitulée « Qui a vendu le premier SGBD relationnel commercial ? »La question n'est pas tranchée, et il vaut mieux ne pas la trancher. Trois sources donnent trois réponses. Oracle est un nom souvent cité : IBM écrit que la société qui allait devenir Oracle a produit la première base relationnelle commercialisée en 1977, tandis que la fiche Wikipédia d'Oracle place la première version en 1979. Mais le Multics Relational Data Store de Honeywell est cité comme commercialisé dès 1976 (juin selon l'historien Paul McJones, qui s'appuie sur un article de Computerworld de septembre 1976). La réponse change selon que l'on exige SQL, un produit complet ou une vente avérée.
Ce qui est établi, c'est que plusieurs systèmes ont existé presque en même temps à la fin des années 1970. Retenez cela plutôt qu'un titre de « premier ».
Pourquoi le NoSQL est-il apparu dans les années 2000 ?
Section intitulée « Pourquoi le NoSQL est-il apparu dans les années 2000 ? »Le NoSQL répond à un problème d'échelle et de souplesse de schéma (le schéma décrit la structure des données ; être souple, c'est ne pas imposer la même à chaque enregistrement). Quand les services web ont dû servir des millions d'utilisateurs, une seule machine ne suffisait plus et il a fallu répartir les données sur plusieurs machines. Google décrit Bigtable en 2006 (conférence OSDI) et Amazon Dynamo en 2007 (conférence SOSP), un magasin clé-valeur (une valeur retrouvée par sa clé) conçu, écrit Werner Vogels, pour arbitrer coût, cohérence, durabilité et performance selon les besoins.
Le mot NoSQL a pris son sens actuel, selon Wikipédia, lors d'une rencontre organisée en 2009 par Johan Oskarsson pour discuter de bases distribuées non relationnelles ; Carlo Strozzi l'avait déjà employé en 1998 pour une base relationnelle sans interface SQL. Le terme regroupe des familles très différentes, décrites dans Bases NoSQL.
Ce que ces systèmes ont échangé : des garanties de cohérence plus faibles (tous les lecteurs ne voient pas tout de suite la même donnée) contre la disponibilité et la montée en charge (servir plus d'utilisateurs en ajoutant des machines). Ce contrat s'appelle BASE et se détaille dans Transactions : ce que promettent ACID et BASE. Cette opposition s'est depuis estompée : MongoDB et DynamoDB proposent des transactions, comme le détaille la même leçon.
Où en sont les bases de données aujourd'hui ?
Section intitulée « Où en sont les bases de données aujourd'hui ? »Cette section vieillit vite, lisez-la comme un instantané d'octobre 2026. La tendance est à la convergence : les moteurs relationnels stockent aussi du JSON, et des bases NoSQL ajoutent des transactions. Les fournisseurs cloud proposent des bases managées qui prennent en charge une partie de l'exploitation (sauvegardes, correctifs), voir Données managées, et des moteurs spécialisés, comme les bases vectorielles, répondent à des usages précis.
Les licences bougent aussi, et « open source » ne se présume plus. En mars 2024, Redis a annoncé un changement de licence : à partir de Redis 7.4, une double licence à source disponible (RSALv2 ou SSPLv1 au choix, ni l'une ni l'autre approuvée par l'OSI, l'organisme qui définit ce qu'est l'open source, selon Redis lui-même). La Linux Foundation a annoncé le 28 mars 2024 le fork Valkey, sous licence BSD, parti de Redis 7.2.4. Redis a ajouté l'AGPLv3 avec Redis 8, le 1er mai 2025. Vérifiez donc la licence d'un moteur à la date de votre choix.
À retenir
Section intitulée « À retenir »- Avant 1970, le programme connaissait le chemin physique vers les données : changer le rangement obligeait à réécrire le code.
- Codd propose en 1970 l'indépendance des données : le rangement et l'interrogation se séparent.
- Son article est une théorie ; le prototype complet est System R, chez IBM, à partir de 1973.
- SQL vient de Chamberlin et Boyce (SEQUEL, 1974), pas de Codd, qui avait son propre langage, Alpha.
- SQL est déclaratif parce qu'un optimiseur choisit le chemin à la place du programmeur.
- Le titre de « premier SGBD relationnel commercial » est contesté : ne le recopiez pas.
- Le NoSQL a échangé de la cohérence contre l'échelle et la souplesse, et la frontière avec le relationnel s'estompe.
- Une licence se vérifie à la date du choix : Redis a changé en 2024, Valkey en est issu.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Huit questions sur le problème que posaient les bases d'avant 1970, ce que change l'indépendance des données, l'attribution de SQL, le caractère déclaratif, et ce que le NoSQL a échangé.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Modéliser des données : du besoin au modèle relationnel
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications