Une base de données relationnelle n'est pas une bibliothèque que votre application charge : c'est un serveur, un programme qui tourne seul et que plusieurs clients interrogent en même temps. Cette leçon s'adresse à qui administre ou choisit une base et veut un modèle mental valable pour tous les moteurs. Vous suivrez le chemin d'une requête, puis les trois mécanismes qui rendent un serveur rapide et fiable : une mémoire qui évite de relire le disque (le cache de pages), un journal qui permet de survivre à une coupure (le journal d'écriture anticipée) et des versions de lignes qui évitent les attentes (le MVCC). Le fil rouge reste le suivi d'incidents d'un parc de serveurs.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Expliquer pourquoi une base est un serveur et ce que coûte l'ouverture d'une connexion
- Décrire le chemin d'une requête, de l'analyse à la réponse, et le rôle du planificateur
- Dire pourquoi une base lit rarement le disque
- Expliquer comment le journal d'écriture anticipée et le point de contrôle assurent la durabilité
- Expliquer pourquoi, avec le MVCC, un lecteur ne bloque pas un écrivain
Pourquoi une base de données est-elle un serveur ?
Section intitulée « Pourquoi une base de données est-elle un serveur ? »Une base est un serveur parce que plusieurs clients doivent partager un seul jeu de données sans en perdre les garanties. Dans le suivi d'incidents, la page de statut, l'outil de supervision qui crée des incidents et dix techniciens lisent et écrivent la même table au même moment. Un processus central, le serveur, reçoit leurs requêtes par le réseau ou par un canal local, les arbitre, et il est le seul à toucher aux fichiers de données. Aucun client ne les manipule directement.
Le contrepoint est la base embarquée, comme SQLite : une bibliothèque liée à l'application, qui lit et écrit un fichier sans rien à installer. Elle convient à un seul programme, car un seul écrivain à la fois peut modifier le fichier. Le serveur, lui, centralise la coordination, et c'est ce qui justifie qu'un exploitant l'installe, le surveille et le sauvegarde.
Pourquoi ouvrir une connexion coûte-t-il cher ?
Section intitulée « Pourquoi ouvrir une connexion coûte-t-il cher ? »Ouvrir une connexion n'est pas gratuit : le serveur authentifie le client, vérifie ses droits, prépare une session et réserve de la mémoire. Pour une requête de quelques millisecondes, cette ouverture peut coûter plus cher que le travail lui-même. Chaque connexion occupe aussi des ressources (selon le moteur, un processus ou un fil d'exécution dédié) : leur nombre est donc borné par un réglage, et au-delà le serveur refuse les nouvelles.
Un pool de connexions est un petit stock de connexions déjà ouvertes que les clients empruntent puis rendent. Si la page de statut ouvre une connexion à chaque visite, un pic de visiteurs atteint la limite alors que la base est peu chargée. Avec un pool de vingt connexions, des centaines de visiteurs se les partagent. Il se place dans l'application ou dans un intermédiaire devant la base.
Le piège classique est de dimensionner large « au cas où » : chaque instance de l'application a son propre pool, et leur somme peut dépasser la limite du serveur. L'angle cloud est traité dans Limiter les connexions et joindre une base en privé, le réglage exact dans les pages par moteur.
Que se passe-t-il entre une requête et sa réponse ?
Section intitulée « Que se passe-t-il entre une requête et sa réponse ? »Une requête traverse quatre étapes : analyse, planification, exécution, puis retour du résultat. Regardez le schéma de haut en bas : la flèche épaisse est le chemin de la requête, et le nœud en relief est la planification, l'étape où le serveur décide comment travailler. Les liaisons fines montrent ce que l'exécution sollicite en coulisses : le cache de pages, le journal pour une écriture, et les fichiers de données seulement quand une page manque.
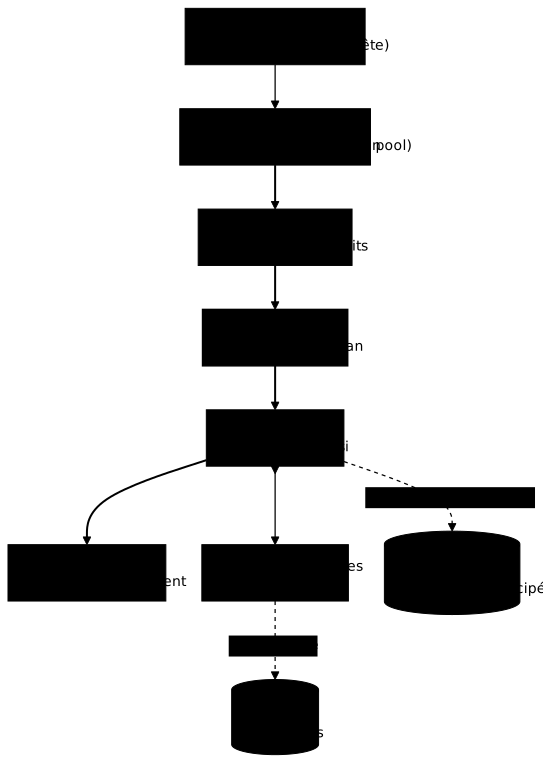
L'analyse vérifie que la requête est bien écrite et que l'utilisateur a le droit d'y toucher. La planification est l'étape qui surprend : le langage SQL, celui des bases relationnelles, est déclaratif, vous décrivez ce que vous voulez, pas la manière de l'obtenir. Le planificateur compare plusieurs stratégies possibles, s'appuie sur des statistiques (taille des tables, répartition des valeurs) et retient un plan d'exécution. La base n'exécute donc pas vos requêtes dans l'ordre où vous les avez écrites.
Pour « les incidents ouverts de web-01 », le planificateur choisit entre parcourir toute la table et passer par un index (un répertoire trié qui évite de tout lire), selon le nombre de lignes qu'il estime concernées. Le même texte de requête peut donc changer de plan quand les données grossissent, et des statistiques périmées conduisent à un mauvais plan. La lecture d'un plan est enseignée, avec mesures, dans Index et EXPLAIN.
Pourquoi une base lit-elle rarement le disque ?
Section intitulée « Pourquoi une base lit-elle rarement le disque ? »Le serveur découpe ses fichiers en pages de taille fixe et garde les pages récemment utilisées en mémoire, dans le cache de pages. Lire en mémoire est nettement plus rapide que lire sur disque. Quand la page voulue est déjà là, on parle de succès de cache ; sinon le serveur la charge depuis les fichiers de données, puis la conserve.
Cela explique le premier accès lent : après un redémarrage, le cache est froid, et les premières requêtes paient les lectures disque jusqu'à ce qu'il se remplisse. Une écriture, elle, modifie la page dans le cache sans la réécrire tout de suite : cette page est dite sale. Les données d'usage courant, le jeu de travail, tiennent idéalement dans ce cache, ce que la leçon Partitionner et sharder reprend comme symptôme.
Ne confondez pas ce cache avec un cache applicatif placé devant la base : le premier vit dans le serveur et travaille sur des pages, le second est un autre composant, que la leçon citée situe parmi les réponses à une base saturée.
Comment une base survit-elle à une coupure de courant ?
Section intitulée « Comment une base survit-elle à une coupure de courant ? »Le serveur confirme une écriture après l'avoir inscrite dans un journal, pas dans les fichiers de données. Écrire une page à un endroit quelconque du disque est lent et dispersé ; ajouter une ligne à la fin d'un journal est rapide et séquentiel. Le journal d'écriture anticipée (write-ahead log) obéit à une règle : tout changement y est inscrit avant d'être appliqué aux fichiers de données. Au commit, quand le client valide sa transaction (un groupe d'opérations confirmées ensemble), le serveur force l'écriture du journal sur le disque, puis répond « validé ». Les pages sales restent en mémoire.
Le point de contrôle (checkpoint) est le moment où le serveur écrit sur disque les pages sales et note jusqu'où le journal est reflété dans les fichiers de données. Après une coupure, le serveur repart du dernier point de contrôle et rejoue le journal : les transactions validées sont retrouvées, les autres sont ignorées. Vous obtenez une confirmation rapide et la survie à l'arrêt brutal.
Le piège est de croire que le commit écrit les données sur disque : il n'écrit que le journal. Les moteurs permettent d'assouplir l'attente de cette écriture pour gagner en vitesse, au prix des dernières transactions confirmées : après une coupure, elles sont perdues, sans que la base soit corrompue. Ce n'est pas un réglage anodin.
Le nom de ce journal et l'endroit où il vit dépendent du moteur : voir Découvrir PostgreSQL et Découvrir MySQL. La garantie de durabilité, elle, est celle d'ACID : Transactions : ce que promettent ACID et BASE.
Pourquoi un lecteur ne bloque-t-il pas un écrivain ?
Section intitulée « Pourquoi un lecteur ne bloque-t-il pas un écrivain ? »Un lecteur ne bloque pas un écrivain parce que le serveur conserve plusieurs versions d'une même ligne : c'est le MVCC (multi-version concurrency control, contrôle de concurrence par versions multiples). Quand un technicien clôture un incident, le serveur ne détruit pas aussitôt l'ancienne ligne : il enregistre une nouvelle version et garde l'ancienne tant qu'une transaction peut encore en avoir besoin. Chaque transaction lit la version valide au moment où elle a pris sa vue des données. La page de statut qui lit pendant la clôture voit l'ancienne version, sans attendre.
L'alternative est le verrouillage : le lecteur attend que l'écrivain ait fini. C'est simple, mais les lectures s'empilent derrière les écritures. Avec le MVCC, deux écrivains qui modifient la même ligne doivent encore s'attendre, et il y a un prix : les anciennes versions s'accumulent et un nettoyage de fond, propre à chaque moteur, doit les retirer, faute de quoi les fichiers gonflent.
Le MVCC est ici un mécanisme ; ce qu'il garantit, avec les niveaux d'isolation, est traité dans la leçon sur ACID citée plus haut. Pour voir deux sessions réellement concurrentes, passez par Transactions et concurrence.
À retenir
Section intitulée « À retenir »- Une base est un serveur parce que plusieurs clients partagent un seul jeu de données : il arbitre leurs accès, alors qu'une base embarquée sert un seul programme.
- Ouvrir une connexion coûte : authentification, session, mémoire. Le nombre de connexions est borné, d'où le pool de connexions.
- Le SQL est déclaratif : le planificateur choisit un plan, la base n'exécute pas vos requêtes dans l'ordre écrit.
- Le cache de pages garde en mémoire les pages utilisées : le premier accès, ou un cache froid après redémarrage, est plus lent. Il vit dans le serveur, à ne pas confondre avec un cache applicatif devant la base.
- Le commit n'écrit pas les données sur disque : il force l'écriture du journal d'écriture anticipée, et le point de contrôle rattrape les fichiers de données.
- Après une coupure, le serveur rejoue le journal depuis le dernier point de contrôle.
- Avec le MVCC, plusieurs versions d'une ligne coexistent : un lecteur ne bloque pas un écrivain, au prix d'un nettoyage des anciennes versions.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Huit questions sur ce qui distingue un serveur d'une bibliothèque, le coût d'une connexion, le rôle du planificateur, ce que le cache de pages évite, ce que le journal garantit au commit et ce que le MVCC épargne aux lecteurs.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Partitionner et sharder une base : quand et comment choisir
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications