Tester le contrat d'une image, c'est la lancer comme le ferait un utilisateur et lui poser des questions sans jamais la modifier : démarre-t-elle, répond-elle, accepte-t-elle sa configuration, tourne-t-elle sans privilège, s'arrête-t-elle sur docker stop, dit-elle la vérité sur son état ? Cette leçon écrit un script de test, tester-contrat.sh, qui rend le code 0 pour une image conforme et le code 1, avec un message qui nomme le contrôle, pour une image inutilisable.
Un build qui réussit ne prouve pas que l'image se laisse utiliser. Vous allez faire passer le même script à une image correcte, puis à six images volontairement cassées, et lire chaque refus. Toutes les mesures viennent de Docker Engine 29.9.2 et de Buildx 0.38.1, sur une VM Debian 13, avec l'image de base python:3.15.2-slim.
La leçon part du script de vérification de Séparer construction et exécution (set -e, une affectation puis un test) et le généralise en protocole. Vous avez déjà vu, dans Démarrage, disponibilité et santé, les trois états de santé, les réglages d'une sonde et le rôle de depends_on côté Compose. Ici, la sonde est déclarée par l'image elle-même, et c'est le script de test qui la juge.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Dresser la liste de ce qu'un utilisateur de l'image peut attendre, c'est-à-dire son contrat
- Écrire un script de test qui borne chaque attente au lieu de dormir un temps fixe
- Déclarer un
HEALTHCHECKdans l'image et lire.Config.Healthchecket.State.Health - Contrôler la configuration, l'uid, le mode
--read-onlyet l'arrêt sur SIGTERM - Faire refuser six images cassées par le même script
- Écrire les durées d'un
HEALTHCHECKdans une unité que hadolint accepte
Prérequis
Section intitulée « Prérequis »- Avoir lu Construire une image pour plusieurs architectures et Séparer construction et exécution, dont la section sur
verifier-image.sh - Avoir lu Démarrage, disponibilité et santé, qui explique les trois états de santé, les réglages d'une sonde et
depends_on - Savoir ce que change
USER(Docker USER : exécuter une image en non-root) et pourquoi un arrêt peut durer dix secondes (Cycle de vie d'un conteneur, PID 1 et arrêt propre) - Un Docker 29.9.2 fonctionnel (installation de Docker),
bash,curl,awkettimeout, dans leur version GNU de Linux : le script utilisedate +%s.%Nettimeout, qui ne fonctionnent pas tels quels sur macOS
Qu'est-ce que le contrat d'une image ?
Section intitulée « Qu'est-ce que le contrat d'une image ? »Le contrat d'une image est la liste de ce qu'une personne qui l'utilise peut attendre sans lire son Dockerfile. Elle n'a pas à savoir comment l'image est construite : elle lance docker run, puis docker stop, et elle suppose que tout se passe bien. Chaque attente devient un contrôle que le script exécute de l'extérieur.
| Attente de l'utilisateur | Contrôle du script | Ce que le script observe |
|---|---|---|
| L'image démarre | demarrage | la route /pret répond avant une limite de 15 s |
| Elle fait son travail | fonctionnement | /pret et /travail rendent la réponse prévue |
| Elle se configure | configuration | sans variable obligatoire, arrêt avec un code non nul et un message ; une variable optionnelle est prise en compte |
| Elle n'exige aucun privilège | permissions | uid différent de 0 ; service qui tourne sous --read-only |
| Elle s'arrête quand on le demande | arret | code de sortie 0 ou 143, en moins de 8 s |
| Elle dit son état | sante | un HEALTHCHECK existe et suit le travail réel |
Les noms de la colonne centrale servent d'étiquettes : chaque message du script commence par l'un d'eux, entre crochets, pour que le refus dise tout de suite de quoi il s'agit.
Un test extérieur évite un piège que les tests du code ne voient pas. Le test unitaire de l'application passe même si l'image oublie un fichier, tourne en root ou ignore SIGTERM. Seul le lancement de l'image finale expose ces défauts, comme la section sur verifier-image.sh l'a montré pour le chargeur, les fuseaux et les certificats. Des outils spécialisés existent pour décrire la structure d'une image, comme Container Structure Test ; ici, le script reste du shell, pour que chaque contrôle soit lisible.
Quel service sert de démonstration ?
Section intitulée « Quel service sert de démonstration ? »Le service releve-contrat est un petit programme Python qui joue le rôle de l'application à livrer. Il écoute sur le port 8080, répond sur deux routes et sait s'arrêter proprement. Créez un répertoire de travail, puis le fichier releve.py.
import os, sys, time, signal, threadingfrom http.server import ThreadingHTTPServer, BaseHTTPRequestHandler
canal = os.environ.get("CANAL")if not canal:    print("erreur: la variable CANAL est obligatoire", file=sys.stderr)    sys.exit(78)cadence = float(os.environ.get("CADENCE", "1"))data = os.environ.get("DATA_DIR", "/data")source = os.path.join(data, "source")journal = os.environ.get("JOURNAL")if journal:    with open(journal, "a") as f:        f.write("demarrage\n")open(source, "a").close()etat = {"dernier": 0.0}arret = threading.Event()
def travailler():    while not arret.is_set():        if os.path.exists(source):            with open(os.path.join(data, "dernier"), "w") as f:                f.write(str(time.time()))            etat["dernier"] = time.time()        arret.wait(cadence)
class H(BaseHTTPRequestHandler):    def reponse(self, code, texte):        corps = (texte + "\n").encode()        self.send_response(code)        self.send_header("Content-Length", str(len(corps)))        self.end_headers()        self.wfile.write(corps)    def do_GET(self):        if self.path == "/pret":            self.reponse(200, f"pret canal={canal} cadence={cadence:g}")        elif self.path == "/travail":            age = time.time() - etat["dernier"]            if age <= 5 * cadence:                self.reponse(200, f"travail ok age={age:.1f}")            else:                self.reponse(503, "travail trop ancien ou source absente")        else:            self.reponse(404, "inconnu")    def log_message(self, *a):        pass
srv = ThreadingHTTPServer(("0.0.0.0", 8080), H)def sigterm(signum, frame):    arret.set()    threading.Thread(target=srv.shutdown).start()signal.signal(signal.SIGTERM, sigterm)threading.Thread(target=travailler, daemon=True).start()print("service pret", flush=True)srv.serve_forever()print("arret propre", flush=True)sys.exit(0)
Le programme tient en trois comportements, qui sont autant de choses à tester.
- Il refuse de démarrer sans la variable
CANAL: message sur la sortie d'erreur, code de sortie 78 (la valeur que la conventionsysexitsréserve aux erreurs de configuration). La variableCADENCE, elle, est optionnelle. - Il travaille en continu : une boucle réécrit le fichier
/data/derniertant que le fichier/data/sourceexiste./pretrépond 200 dès que le serveur écoute./travailrépond 200 si le travail date de moins de cinq cadences, et 503 sinon, c'est-à-dire quand/data/sourcea disparu. - Il traite SIGTERM : le gestionnaire arrête le serveur, le programme affiche
arret propreet sort avec le code 0.
Une dernière variable, JOURNAL, est facultative : si elle est définie, le programme y écrit une ligne au démarrage. L'image correcte ne la définit pas ; une des images cassées s'en sert.
La différence entre /pret et /travail est le cœur de la leçon : /pret dit que le processus répond, /travail dit qu'il fait ce pour quoi il existe.
Comment l'image déclare-t-elle sa santé ?
Section intitulée « Comment l'image déclare-t-elle sa santé ? »Une image déclare sa santé avec l'instruction HEALTHCHECK du Dockerfile : quiconque lance l'image, avec docker run ou dans Compose, obtient la sonde sans rien écrire. Les états et les réglages sont ceux de la leçon sur la santé des services Compose : starting tant qu'aucune sonde n'a réussi, healthy après une sonde réussie, unhealthy après retries échecs de suite. Seul l'endroit où on les déclare change. L'option --start-interval, disponible depuis Docker Engine 25.0 d'après la documentation du Dockerfile, règle la fréquence des sondes pendant le délai de grâce. Voici le Dockerfile de l'image correcte.
FROM python:3.15.2-slim@sha256:8c13a3f37a6a5b71498228e902c4b9f51c1f7900d49fabf71f9a650c6120e0d0ENV PYTHONUNBUFFERED=1WORKDIR /appCOPY releve.py /app/releve.pyRUN mkdir /data && chown 10001:10001 /dataEXPOSE 8080USER 10001HEALTHCHECK --interval=2s --timeout=1s --start-period=3s --start-interval=0.5s --retries=2 CMD ["python", "-c", "import urllib.request; urllib.request.urlopen(\"http://127.0.0.1:8080/travail\", timeout=1)"]CMD ["python", "/app/releve.py"]Trois choix méritent d'être lus. /data appartient à l'uid 10001 et USER 10001 s'applique ensuite, donc le programme tourne sans privilège et écrit là où il en a le droit. La forme exec de CMD, avec des crochets, fait du programme Python le PID 1 du conteneur ; c'est ce qui lui permet de recevoir SIGTERM. Enfin, la sonde appelle /travail, pas /pret, avec Python, déjà présent dans l'image : une sonde ne doit pas exiger un outil que l'image n'installe pas.
La sonde est ici en forme exec, un tableau JSON après CMD. La forme shell, HEALTHCHECK CMD commande, est aussi permise : Docker l'exécute alors avec /bin/sh -c, ce qui suppose un shell dans l'image, et .Config.Healthcheck.Test affiche CMD-SHELL au lieu de CMD. Dans une image sans shell, seule la forme exec fonctionne.
Construisez l'image avec une version explicite, jamais latest, puis lisez ce que Docker a enregistré.
docker build -t releve-contrat:1.0 .docker inspect --format '{{json .Config.Healthcheck}}' releve-contrat:1.0{"Test":["CMD","python","-c","import urllib.request; urllib.request.urlopen(\"http://127.0.0.1:8080/travail\", timeout=1)"],"Interval":2000000000,"Timeout":1000000000,"StartPeriod":3000000000,"StartInterval":500000000,"Retries":2}Docker range les durées en nanosecondes : Interval vaut 2000000000, donc 2 s, et StartInterval 500000000, donc 0,5 s. Les options de l'instruction portent les noms des réglages Compose, avec deux tirets au lieu d'un tiret bas (--start-period pour start_period).
| Option | Valeur ici | Rôle |
|---|---|---|
--interval | 2 s | délai entre deux sondes |
--timeout | 1 s | durée maximale d'une sonde |
--retries | 2 | échecs consécutifs avant l'état unhealthy |
--start-period | 3 s | délai de grâce au démarrage |
--start-interval | 0,5 s | délai entre deux sondes pendant ce délai de grâce |
Tant qu'aucune sonde n'a réussi, l'état est starting. Lancez l'image avec une période de grâce longue et une première sonde à 10 s, puis relevez l'état tout de suite.
docker run -d --name m-st --health-start-period 30s --health-start-interval 10s -e CANAL=x releve-contrat:1.0docker inspect --format '{{json .State.Health}}' m-stdocker ps --filter name=m-st --format '{{.Status}}'sleep 12docker inspect --format '{{json .State.Health.Status}}' m-stdocker rm -f m-st{"Status":"starting","FailingStreak":0,"Log":[]}Up Less than a second (health: starting)"healthy"Les deux relevés diffèrent ainsi : juste après le lancement, aucune sonde n'a encore tourné (Log est vide) et l'état est starting. Douze secondes après le lancement, la première sonde a réussi et l'état est healthy, sans attendre la fin des 30 s de grâce : une sonde réussie pendant cette période suffit.
Comment choisir les bornes de la sonde ?
Section intitulée « Comment choisir les bornes de la sonde ? »Quatre bornes règlent la sonde, et chacune répond à un problème précis. Le moteur lance une sonde, attend qu'elle se termine, puis compte l'intervalle à partir de cette fin avant d'en lancer une autre : deux sondes ne se chevauchent jamais. Pour le vérifier, on construit une image dont la sonde dort 5 secondes, puis on la lance avec --health-interval 2s et --health-timeout 10s. Travaillez dans un répertoire à part, pour ne pas écraser le Dockerfile de la leçon. Le script de la sonde est le suivant.
#!/bin/shsleep 5exit 0Le Dockerfile copie ce script dans l'image et la laisse tourner 300 secondes, le temps des mesures.
FROM alpine:3.24.3@sha256:be2656061b536c1883c4034790e21d0a09c5aaaf51968b89368a3c0371ea2c9aCOPY sonde.sh /sonde.shRUN chmod +x /sonde.shCMD ["sleep", "300"]Construisez l'image, puis lancez le premier cas. Le journal de santé donne le début et la fin de chaque sonde.
docker build -t sonde-lente:1.0 .docker run -d --name hc-long --health-cmd /sonde.sh --health-interval 2s --health-timeout 10s --health-retries 10 --health-start-period 0s sonde-lente:1.0sleep 22docker inspect --format '{{range .State.Health.Log}}{{.Start}} {{.End}} rc={{.ExitCode}} out={{printf "%q" .Output}}{{"\n"}}{{end}}' hc-long2026-11-03 14:41:01.154901397 +0000 UTC 2026-11-03 14:41:06.193151098 +0000 UTC rc=0 out=""2026-11-03 14:41:08.193598519 +0000 UTC 2026-11-03 14:41:13.221457609 +0000 UTC rc=0 out=""2026-11-03 14:41:15.222217271 +0000 UTC 2026-11-03 14:41:20.251444286 +0000 UTC rc=0 out=""Comparez chaque Start au End de la ligne précédente : 14:41:06.19 puis 14:41:08.19, soit 2 secondes pile. La sonde suivante attend donc la fin de la précédente, même si celle-ci dure plus que l'intervalle, et le rythme réel est la durée de la sonde plus l'intervalle.
Supprimez ce conteneur, puis relancez avec --health-timeout 3s, toujours avec la sonde de 5 secondes. Le moteur tue l'essai à 3 secondes, et cet essai compte comme un échec.
docker rm -f hc-longdocker run -d --name hc-court --health-cmd /sonde.sh --health-interval 2s --health-timeout 3s --health-retries 10 --health-start-period 0s sonde-lente:1.0sleep 20docker inspect --format '{{range .State.Health.Log}}{{.Start}} {{.End}} rc={{.ExitCode}} out={{printf "%q" .Output}}{{"\n"}}{{end}}' hc-courtdocker rm -f hc-court2026-11-03 14:41:23.601239318 +0000 UTC 2026-11-03 14:41:26.647349491 +0000 UTC rc=-1 out="Health check exceeded timeout (3s)"2026-11-03 14:41:28.64799245 +0000 UTC 2026-11-03 14:41:31.675077976 +0000 UTC rc=-1 out="Health check exceeded timeout (3s)"2026-11-03 14:41:33.675922544 +0000 UTC 2026-11-03 14:41:36.706129849 +0000 UTC rc=-1 out="Health check exceeded timeout (3s)"Le code -1 et le message Health check exceeded timeout (3s) montrent ce que fait --timeout : une sonde bloquée ne dure pas indéfiniment, elle est interrompue et bascule du côté des échecs. Les trois autres bornes se lisent ainsi.
--retries: avec 2 au minimum, un échec isolé (un hoquet de la machine) ne déclare pas le service malade.--start-period: un service lent à démarrer n'est pas jugé trop tôt, les échecs de cette période ne comptent pas, jusqu'à la première sonde réussie.--interval: plus il est court, plus l'état réagit vite, et plus la sonde consomme.
Pour choisir, calculez le délai au bout duquel le conteneur est déclaré unhealthy. La leçon sur Compose le donne en ordre de grandeur : interval fois retries, plus la durée de chaque sonde. Voici la même formule prise au pire : après la période de démarrage, il faut retries échecs, et chaque échec dure au plus timeout, puisque l'intervalle se compte après la fin de l'essai. Cela donne retries × (timeout + interval). Avec le Dockerfile de la leçon (--interval=2s, --timeout=1s, --retries=2), cela fait 2 × (1 + 2) = 6 secondes, sans compter les 3 s de période de grâce. Le --timeout entre donc dans ce délai : choisissez-le juste au-dessus de la durée normale de la sonde.
Deux mesures vérifient la formule, et elles se lisent sans être rejouées. La première porte sur la sonde seule : l'image sonde-lente:1.0 a été lancée avec --health-cmd 'sleep 10' --health-interval 2s --health-timeout 1s --health-retries 2 --health-start-period 0s, de sorte que chaque essai est interrompu au bout d'une seconde. L'état relevé toutes les 3 s environ est starting à 3,27 s et à 6,29 s, puis unhealthy à 9,31 s. Le journal donne le moment exact du changement : le deuxième échec se termine 4,06 s après le début du premier essai, qui suit de 2 s le lancement, soit vers 6,1 s, au plus près des 6 s calculés. Le relevé de 6,29 s dit encore starting parce que le conteneur existe depuis un peu moins de 6,29 s à ce moment-là. Enfin, les fins de deux échecs consécutifs sont séparées de 3,03 s, soit 1 s de délai plus 2 s d'intervalle.
La formule ne compte pas le délai propre au service. Ici, /travail ne rend 503 que lorsque la dernière écriture date de plus de cinq cadences : entre 4 et 5 s après la coupure de /data/source (4,1 à 4,3 s sur quatre mesures). Ce délai s'ajoute à celui de la sonde.
La seconde mesure porte sur l'exemple de la leçon : après la coupure de /data/source, le premier 503 arrive environ 4,2 s après la coupure, puis l'état passe à unhealthy au bout de 2,5 à 4,4 s supplémentaires, selon le moment où tombe la sonde. Au total, il se passe de 6,6 à 8,6 s entre la coupure et le changement d'état (quatre mesures).
Qu'affiche .State.Health d'un conteneur en marche ?
Section intitulée « Qu'affiche .State.Health d'un conteneur en marche ? »Le conteneur porte un état de santé, que docker ps résume entre parenthèses et que docker inspect détaille. Pour le voir, il faut deux conteneurs : un avec sonde et un sans. Le second utilise releve-contrat:1.0-sans-healthcheck, la même image que la correcte sans la ligne HEALTHCHECK, que vous fabriquez d'abord. Revenez dans le répertoire de la leçon, celui du Dockerfile de l'image correcte, copiez ce Dockerfile dans Dockerfile.1.0-sans-healthcheck, supprimez-y la ligne HEALTHCHECK, puis construisez.
docker build -f Dockerfile.1.0-sans-healthcheck -t releve-contrat:1.0-sans-healthcheck .Lancez ensuite les deux conteneurs, attendez une seconde, puis listez-les.
docker run -d --name m-a -e CANAL=x releve-contrat:1.0docker run -d --name m-f -e CANAL=x releve-contrat:1.0-sans-healthchecksleep 1docker ps --format 'table {{.Names}}\t{{.Image}}\t{{.Status}}'NAMES IMAGE STATUSm-f releve-contrat:1.0-sans-healthcheck Up 1 secondm-a releve-contrat:1.0 Up 1 second (healthy)Le conteneur sans sonde n'affiche que Up : rien ne dit s'il travaille. Celui qui en a une affiche (healthy). Lisez maintenant le détail, six secondes après.
sleep 5docker inspect --format '{{json .State.Health}}' m-adocker inspect --format '{{json .State.Health}}' m-f{"Status":"healthy","FailingStreak":0,"Log":[{"Start":"2026-11-03T13:37:38.253516787Z","End":"2026-11-03T13:37:38.459444892Z","ExitCode":0,"Output":""},{"Start":"2026-11-03T13:37:40.460098575Z","End":"2026-11-03T13:37:40.679210969Z","ExitCode":0,"Output":""},{"Start":"2026-11-03T13:37:42.680100657Z","End":"2026-11-03T13:37:42.905873651Z","ExitCode":0,"Output":""}]}nullTrois champs sont à lire. Status donne l'état. FailingStreak compte les échecs consécutifs, ici 0. Log garde les derniers résultats de la sonde (cinq entrées au plus), avec leur code de sortie (ExitCode) et leur sortie. Les trois sondes réussies démarrent à un peu plus de 2 s d'écart, parce que l'intervalle se compte à partir de la fin de la sonde précédente. Pour l'image sans sonde, .State.Health vaut null : c'est ce que le script teste pour refuser une image sans HEALTHCHECK.
Que se passe-t-il quand le travail cesse ?
Section intitulée « Que se passe-t-il quand le travail cesse ? »Supprimez le fichier /data/source dans le conteneur m-a, ce qui arrête le travail, puis relisez l'état douze secondes après.
docker exec m-a python -c "import os; os.remove('/data/source')"sleep 12docker inspect --format '{{json .State.Health}}' m-adocker ps --format 'table {{.Names}}\t{{.Status}}'docker inspect --format 'running={{.State.Running}} restarts={{.RestartCount}} pid={{.State.Pid}}' m-aLa sortie de .State.Health est abrégée ici : le journal garde les deux dernières sondes réussies puis les trois sondes en échec, avec la trace Python de chacune.
{"Status":"unhealthy","FailingStreak":3,"Log":[{"Start":"2026-11-03T13:37:44.907568353Z","End":"2026-11-03T13:37:45.120684474Z","ExitCode":0,"Output":""},{"Start":"2026-11-03T13:37:47.121482637Z","End":"2026-11-03T13:37:47.338941123Z","ExitCode":0,"Output":""},{"Start":"2026-11-03T13:37:49.340973058Z","End":"2026-11-03T13:37:49.605037839Z","ExitCode":1,"Output":"Traceback (most recent call last):\n …\nurllib.error.HTTPError: HTTP Error 503: Service Unavailable\n"}, …]}NAMES STATUSm-f Up 18 secondsm-a Up 18 seconds (unhealthy)running=true restarts=0 pid=484411Lisez trois choses. Le journal explique pourquoi : la sonde a rendu le code 1, et sa sortie finit par HTTP Error 503: Service Unavailable, la réponse de /travail. L'état passe à unhealthy et FailingStreak vaut 3 au moment de la lecture. Surtout, le conteneur reste en marche : running=true, restarts=0. Docker signale le problème, mais il ne redémarre pas le conteneur. Ce sont l'orchestrateur ou le script de test qui lisent cet état et décident.
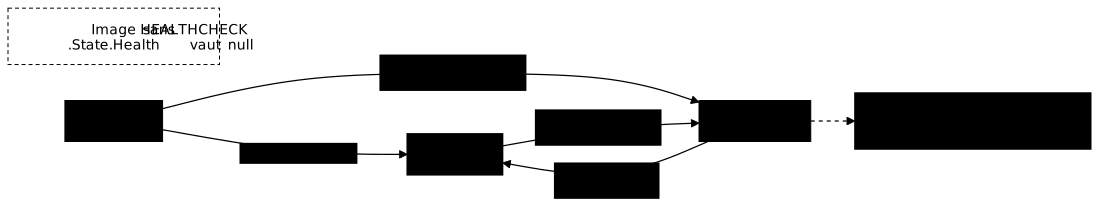
Le schéma suivant résume ces états et ce qui les fait changer. Suivez les flèches : une sonde qui réussit mène à healthy, retries échecs de suite mènent à unhealthy, et la flèche en pointillé rappelle qu'aucun redémarrage n'en découle. À l'écart, l'image sans sonde n'a aucun état : .State.Health vaut null.
Comment surcharger ou désactiver la sonde d'une image ?
Section intitulée « Comment surcharger ou désactiver la sonde d'une image ? »Au lancement, deux options remplacent la sonde de l'image : --health-cmd pour en fournir une autre, --no-healthcheck pour la supprimer. Elles servent à tester une image sans la reconstruire. Voici la surcharge qui échoue toujours, avec un intervalle d'une seconde et un seul échec toléré.
docker run -d --name m-s --health-cmd 'exit 1' --health-interval 1s --health-retries 1 -e CANAL=x releve-contrat:1.0sleep 4docker inspect --format '{{json .Config.Healthcheck}} {{.State.Health.Status}}' m-s{"Test":["CMD-SHELL","exit 1"],"Interval":1000000000,"Timeout":1000000000,"StartPeriod":3000000000,"StartInterval":500000000,"Retries":1} unhealthyLa commande et les options données remplacent celles de l'image (CMD-SHELL, Interval, Retries), mais les champs non redonnés, Timeout, StartPeriod et StartInterval, gardent la valeur du Dockerfile. Avec --no-healthcheck, le test devient ["NONE"] et l'état de santé disparaît.
docker run -d --name m-n --no-healthcheck -e CANAL=x releve-contrat:1.0docker inspect --format '{{json .Config.Healthcheck}} {{json .State.Health}}' m-n{"Test":["NONE"],"Interval":2000000000,"Timeout":1000000000,"StartPeriod":3000000000,"StartInterval":500000000,"Retries":2} nullUne dernière précision sur la sonde de l'image : elle est copiée dans le conteneur à sa création. Après avoir modifié le HEALTHCHECK et reconstruit l'image, un conteneur déjà créé garde l'ancienne sonde ; il faut le supprimer et le recréer avec docker run pour que la nouvelle s'applique. Avec Compose, docker compose up recrée de lui-même le service dont l'image a changé, sans qu'il faille ajouter --force-recreate.
Retirez les conteneurs de cette section avant de continuer.
docker rm -f m-a m-f m-s m-nComment le script lance-t-il l'image et attend-il sans durée fixe ?
Section intitulée « Comment le script lance-t-il l'image et attend-il sans durée fixe ? »Un test qui dort deux secondes puis interroge le service échoue sur une machine lente et fait perdre du temps sur une machine rapide. Le script remplace chaque pause fixe par une boucle bornée : elle interroge, sort dès que la condition est vraie, et s'arrête en échec à une limite. Le fichier commence par le protocole commun, puis deux fonctions d'attente.
#!/usr/bin/env bash# Usage : tester-contrat.sh <image>set -euo pipefailimage="${1:?usage: $0 <image>}"pref="tc-$$"refuser() { echo "REFUSE [$1] $2"; exit 1; }ok() { echo "ok     [$1] $2"; }nettoyer() { docker rm -f "$pref-a" "$pref-b" "$pref-c" "$pref-d" >/dev/null 2>&1 || true; }trap nettoyer EXIT
# --- Parties propres au service releve-contrat : à adapter à votre image ---donnees=/data                      # dossier de données inscriptiblefichier_travail="$donnees/source"  # fichier dont dépend le travail du service# L'image doit aussi fournir `id` et `python`, utilisés avec `docker exec` plus bas.# --- Fin des parties propres au service ---
port_de() {  local p  p=$(docker port "$1" 8080/tcp | head -n 1)  echo "${p##*:}"}# attendre_pret <conteneur> <limite en s> : affiche la durée, échoue sinonattendre_pret() {  local nom="$1" limite="$2" debut fin etat port  debut=$(date +%s.%N)  port=$(port_de "$nom")  while true; do    if curl -fs --max-time 1 "http://127.0.0.1:$port/pret" >/dev/null 2>&1; then      fin=$(date +%s.%N)      awk -v a="$debut" -v b="$fin" 'BEGIN{printf "%.2f", b-a}'      return 0    fi    etat=$(docker inspect --format '{{.State.Running}}' "$nom")    [ "$etat" = "true" ] || return 2    fin=$(date +%s.%N)    awk -v a="$debut" -v b="$fin" -v l="$limite" 'BEGIN{exit !(b-a>l)}' && return 1    sleep 0.2  done}# attendre_sante <conteneur> <attendu> <limite> : sonde l'état, sans durée fixeattendre_sante() {  local nom="$1" attendu="$2" limite="$3" debut fin etat  debut=$(date +%s.%N)  while true; do    etat=$(docker inspect --format '{{.State.Health.Status}}' "$nom")    [ "$etat" = "$attendu" ] && return 0    fin=$(date +%s.%N)    awk -v a="$debut" -v b="$fin" -v l="$limite" 'BEGIN{exit !(b-a>l)}' && return 1    sleep 0.5  done}
# --- sante (déclaration) ---hc=$(docker inspect --format '{{json .Config.Healthcheck}}' "$image")[ "$hc" != "null" ] || refuser sante "aucun HEALTHCHECK déclaré dans l'image"sonde=$(docker inspect --format '{{json .Config.Healthcheck.Test}}' "$image")[ "$sonde" != '["NONE"]' ] || refuser sante "HEALTHCHECK NONE : la sonde de l'image est désactivée"ok sante "HEALTHCHECK déclaré"
Enregistrez ce bloc dans tester-contrat.sh et lancez-le dès maintenant sur l'image correcte : le fichier ne contient encore que la déclaration de la sonde, donc une seule ligne s'affiche.
bash tester-contrat.sh releve-contrat:1.0ok [sante] HEALTHCHECK déclaréSur une image construite sans la ligne HEALTHCHECK, le même fichier écrit REFUSE [sante] aucun HEALTHCHECK déclaré dans l'image. Sur une image dont le Dockerfile porte HEALTHCHECK NONE à la place, il écrit REFUSE [sante] HEALTHCHECK NONE : la sonde de l'image est désactivée, et il rend le code 1 dans les deux cas.
Le début du fichier fixe le protocole. refuser écrit REFUSE [contrôle] message puis sort avec le code 1, ok écrit une ligne de succès, et l'instruction trap nettoyer EXIT supprime les conteneurs de test quel que soit le résultat, y compris après un refus. Les conteneurs portent le préfixe tc- suivi du PID du script ($$), pour que deux exécutions simultanées ne se heurtent pas.
Les conteneurs sont lancés avec -p 127.0.0.1::8080 : Docker choisit lui-même un port libre de l'hôte, et port_de le relit avec docker port. Aucun port n'est écrit en dur, donc aucune collision avec un autre service de la machine.
attendre_pret rend trois résultats distincts : 0 si /pret répond (et elle affiche alors la durée), 1 si la limite est atteinte, 2 si le conteneur s'est arrêté pendant l'attente. Le script appelle ces fonctions avec || rc=$? ou || refuser : l'affectation puis le test, le geste de la leçon sur le build multi-étapes, empêche set -e de couper le script avant que le message de refus soit écrit. attendre_sante fait la même chose pour l'état de santé, qu'elle lit avec docker inspect --format '{{.State.Health.Status}}'.
Les dernières lignes du bloc reprennent la section sur la santé : une image dont .Config.Healthcheck vaut null est refusée avant même d'être lancée, et une image dont le test vaut ["NONE"] (HEALTHCHECK NONE dans le Dockerfile, qui désactive la sonde) l'est aussi, avec un message qui le dit.
Le bloc de variables placé après le trap regroupe ce qui est propre au service de démonstration : le dossier de données, le fichier dont dépend le travail, et la présence de id et de python dans l'image. Tout le reste du script vaut pour n'importe quelle image qui expose /pret sur le port 8080. Le fichier tester-contrat.sh s'obtient en collant, dans l'ordre, les blocs de code des sections de configuration, de démarrage, de permissions, de santé et d'arrêt à la suite de celui-ci : cinq blocs à coller, un par section.
Comment tester la configuration ?
Section intitulée « Comment tester la configuration ? »Un conteneur dont la configuration est mal fournie doit s'arrêter vite et dire laquelle. Le script teste les deux cas : la variable obligatoire absente, puis une variable optionnelle donnée. Ajoutez ces deux contrôles à la suite du fichier.
# --- configuration : variable obligatoire absente ---docker run -d --name "$pref-c" "$image" >/dev/nullcode=$(timeout 20 docker wait "$pref-c" || echo timeout)[ "$code" != "0" ] || refuser configuration "sans CANAL, le conteneur s'est arrêté avec le code 0 (ou n'a pas vérifié)"[ "$code" != "timeout" ] || refuser configuration "sans CANAL, le conteneur tourne toujours : la variable obligatoire n'est pas vérifiée"journal=$(docker logs "$pref-c" 2>&1 | head -n 5)case "$journal" in *CANAL*) ;; *) refuser configuration "code $code mais aucun message ne nomme CANAL" ;; esacok configuration "CANAL absente : arrêt avec le code $code et un message clair"
# --- configuration : variable optionnelle ---docker run -d --name "$pref-d" -e CANAL=essai -e CADENCE=2 -p 127.0.0.1::8080 "$image" >/dev/nulld=$(attendre_pret "$pref-d" 15) || refuser configuration "le conteneur avec CADENCE=2 ne répond pas"rep=$(curl -s --max-time 2 "http://127.0.0.1:$(port_de "$pref-d")/pret")case "$rep" in *cadence=2*) ;; *) refuser configuration "CADENCE=2 ignorée (réponse : $rep)" ;; esacok configuration "CADENCE=2 prise en compte"
Le premier contrôle lance l'image sans CANAL et attend sa fin avec docker wait, bornée à 20 s par timeout. Trois défauts sont distingués : un code 0 (le conteneur s'est arrêté comme si tout allait bien), un dépassement des 20 s (il tourne alors qu'il n'a pas ce qu'il lui faut), et un arrêt en erreur dont les journaux ne nomment pas la variable. Le script accepte n'importe quel code non nul, pas seulement 78 : le contrat dit « échouer », pas « échouer avec ce chiffre ».
Le second contrôle donne CADENCE=2 et vérifie que /pret répond cadence=2. Une variable que le programme ignore se verrait ainsi, alors qu'elle ne fait échouer aucun démarrage.
Comment tester le démarrage et le fonctionnement ?
Section intitulée « Comment tester le démarrage et le fonctionnement ? »Le démarrage se mesure du lancement à la première réponse de /pret, avec une limite de 15 s. Le fonctionnement vérifie ensuite que les deux routes répondent ce qui est prévu, et pas seulement qu'elles répondent.
# --- demarrage ---docker run -d --name "$pref-a" -e CANAL=essai -p 127.0.0.1::8080 "$image" >/dev/nullrc=0duree=$(attendre_pret "$pref-a" 15) || rc=$?[ "$rc" -eq 0 ] || refuser demarrage "le service ne répond pas dans les 15 s (code $rc)"ok demarrage "répond en ${duree} s"
# --- fonctionnement ---port=$(port_de "$pref-a")rep=$(curl -s --max-time 2 "http://127.0.0.1:$port/pret")case "$rep" in "pret canal=essai"*) ;; *) refuser fonctionnement "réponse inattendue sur /pret : $rep" ;; esactrav=$(curl -s -o /dev/null -w '%{http_code}' --max-time 2 "http://127.0.0.1:$port/travail")[ "$trav" = "200" ] || refuser fonctionnement "/travail rend $trav au lieu de 200"ok fonctionnement "/pret et /travail répondent comme prévu"
Le conteneur tc-…-a lancé ici sert aux contrôles suivants : permissions, santé et arrêt. Le code de retour de attendre_pret est conservé dans rc et affiché dans le message, ce qui distingue une limite dépassée (1) d'un conteneur qui s'est arrêté (2). Pour l'image correcte, le script affiche une durée de l'ordre de 0,3 s, qui dépend de la machine : elle sert à repérer une dérive, pas à fixer un seuil.
Le contrôle de fonctionnement compare le contenu de la réponse. /pret doit annoncer canal=essai, preuve que la variable donnée au lancement est bien arrivée dans le programme. curl -w '%{http_code}' lit le code HTTP de /travail sans afficher le corps.
Comment tester les permissions ?
Section intitulée « Comment tester les permissions ? »Deux contrôles couvrent les droits : le processus n'est pas root, et l'image continue de fonctionner quand son système de fichiers est en lecture seule.
# --- permissions ---uid=$(docker exec "$pref-a" id -u)[ "$uid" != "0" ] || refuser permissions "le processus tourne avec l'uid 0 (root)"ok permissions "uid $uid, non root"docker run -d --name "$pref-b" --read-only --tmpfs "$donnees:uid=$uid,gid=$uid" -e CANAL=essai -p 127.0.0.1::8080 "$image" >/dev/nullrc=0attendre_pret "$pref-b" 15 >/dev/null || rc=$?[ "$rc" -eq 0 ] || refuser permissions "le service ne tourne pas sous --read-only avec un tmpfs sur /data (code $rc)"if docker exec "$pref-b" python -c "open('/tmp/intrus','w')" >/dev/null 2>&1; then refuser permissions "écriture possible dans /tmp sous --read-only : le système de fichiers n'est pas en lecture seule"fiok permissions "--read-only : le service tourne, l'écriture hors /data est refusée"Avec les blocs de configuration, de démarrage et de permissions collés à la suite du fichier, le script donne ceci sur l'image correcte. Les durées varient d'une exécution à l'autre.
bash tester-contrat.sh releve-contrat:1.0ok [sante] HEALTHCHECK déclaréok [configuration] CANAL absente : arrêt avec le code 78 et un message clairok [configuration] CADENCE=2 prise en compteok [demarrage] répond en 0.27 sok [fonctionnement] /pret et /travail répondent comme prévuok [permissions] uid 10001, non rootok [permissions] --read-only : le service tourne, l'écriture hors /data est refuséeLe premier contrôle lance id -u avec docker exec : il lit l'uid de l'utilisateur configuré pour un nouveau processus du conteneur (ici celui de USER), et non celui du PID 1. Il refuse l'uid 0. Le script teste « différent de 0 » plutôt que « égal à 10001 » : le contrat est de ne pas être root, pas de porter un numéro précis. Pour comprendre pourquoi USER doit passer après les instructions qui écrivent, lisez la leçon sur USER.
Le second contrôle relance l'image avec --read-only, qui rend tout le système de fichiers du conteneur non inscriptible, sauf /data, monté en tmpfs (un dossier gardé en mémoire) au nom de l'uid relevé par le premier contrôle (10001 ici). L'image doit démarrer quand même : elle n'écrit donc que dans le dossier qu'elle déclare. Le script tente ensuite d'écrire dans /tmp/intrus, un chemin que l'uid 10001 peut écrire quand --read-only est absent et qui n'est pas sous /data ; sous --read-only, le noyau répond Errno 30 (système de fichiers en lecture seule) et l'écriture échoue. Écrire dans /app ne prouverait rien : ce dossier appartient à root, donc l'écriture est déjà refusée à l'uid 10001 sans --read-only (Errno 13, permission refusée).
Ce contrôle évite une panne d'exploitation : une application qui écrit dans son propre dossier ne démarre plus dès que l'exploitant monte le conteneur en lecture seule. Un refus de ce contrôle suivi de (code 2) veut dire que le conteneur s'est arrêté pendant l'attente.
Comment tester l'état de santé ?
Section intitulée « Comment tester l'état de santé ? »Déclarer un HEALTHCHECK ne suffit pas : la sonde doit suivre le travail. Le script le vérifie par un cycle complet, sain, malade, sain, en agissant sur le conteneur de l'extérieur.
# --- sante (comportement) ---attendre_sante "$pref-a" healthy 20 || refuser sante "l'image n'est pas devenue healthy en 20 s"ok sante "healthy"docker exec "$pref-a" python -c "import os; os.remove('$fichier_travail')"attendre_sante "$pref-a" unhealthy 20 || refuser sante "le travail a cessé mais l'image reste healthy après 20 s (la sonde ne mesure pas le travail)"ok sante "unhealthy quand le travail cesse"docker exec "$pref-a" python -c "open('$fichier_travail','a').close()"attendre_sante "$pref-a" healthy 20 || refuser sante "le travail a repris mais l'image n'est pas redevenue healthy"ok sante "retour à healthy"Une fois ce bloc collé à son tour, trois lignes s'ajoutent, une par étape du cycle.
[...]ok [permissions] --read-only : le service tourne, l'écriture hors /data est refuséeok [sante] healthyok [sante] unhealthy quand le travail cesseok [sante] retour à healthyLe script attend d'abord healthy, puis supprime le fichier de travail (/data/source ici), le geste qui arrête le travail, et attend unhealthy pendant 20 s au plus. Il recrée ensuite le fichier et attend le retour à healthy. Une image dont la sonde regarde seulement si le processus répond ne passera jamais à unhealthy : le script la refuse alors avec le message qui dit que la sonde ne mesure pas le travail.
La limite de 20 s laisse une marge sur les valeurs de l'image (intervalle de 2 s, 2 échecs, cinq cadences d'une seconde pour que le travail soit jugé trop ancien). Si vous allongez l'intervalle de la sonde, allongez cette limite avec lui.
Comment tester l'arrêt ?
Section intitulée « Comment tester l'arrêt ? »L'arrêt se teste avec la commande que l'utilisateur tapera, docker stop, en mesurant le temps qu'elle prend et le code de sortie qui en résulte. Ajoutez le dernier contrôle, qui conclut le script.
# --- arret ---t0=$(date +%s.%N)docker stop "$pref-a" >/dev/nullt1=$(date +%s.%N)duree=$(awk -v a="$t0" -v b="$t1" 'BEGIN{printf "%.2f", b-a}')sortie=$(docker inspect --format '{{.State.ExitCode}}' "$pref-a")case "$sortie" in 0|143) ;; *) refuser arret "code de sortie $sortie après docker stop en ${duree} s (SIGTERM non traité ?)" ;; esacawk -v d="$duree" 'BEGIN{exit !(d<8)}' || refuser arret "arrêt en ${duree} s, trop proche du délai de grâce de 10 s"ok arret "code $sortie en ${duree} s"echo "ACCEPTE $image"docker stop envoie SIGTERM, attend dix secondes par défaut, puis envoie SIGKILL. Deux valeurs de code sont acceptées : 0, quand le programme traite le signal et sort proprement, et 143, soit 128 + 15, quand le programme n'est pas PID 1, par exemple derrière docker run --init, et qu'il est terminé par SIGTERM faute de gestionnaire. En forme exec et sans gestionnaire, c'est au contraire le PID 1 qui ignore SIGTERM : Docker le tue à la fin du délai et le conteneur finit en 137, soit 128 + 9 (SIGKILL). Les mécanismes sont expliqués dans Cycle de vie d'un conteneur, PID 1 et arrêt propre.
Le second test porte sur la durée : un arrêt qui dure presque dix secondes, même avec un code 0, signale une image qui attend le délai de grâce. Le seuil de 8 s est un choix du script, pas une règle de Docker ; ajustez-le à votre service. La dernière ligne, ACCEPTE, n'est atteinte que si tous les contrôles ont réussi.
Que donne le script sur l'image correcte ?
Section intitulée « Que donne le script sur l'image correcte ? »Lancez le script sur l'image releve-contrat:1.0, puis lisez le code de sortie.
bash tester-contrat.sh releve-contrat:1.0echo "code=$?"ok [sante] HEALTHCHECK déclaréok [configuration] CANAL absente : arrêt avec le code 78 et un message clairok [configuration] CADENCE=2 prise en compteok [demarrage] répond en 0.27 sok [fonctionnement] /pret et /travail répondent comme prévuok [permissions] uid 10001, non rootok [permissions] --read-only : le service tourne, l'écriture hors /data est refuséeok [sante] healthyok [sante] unhealthy quand le travail cesseok [sante] retour à healthyok [arret] code 0 en 0.52 sACCEPTE releve-contrat:1.0code=0Onze contrôles passent et le code de sortie est 0. Le passage complet a pris 14,4 s de bout en bout sur la machine de la leçon, une durée qui dépend de la machine. Les valeurs à regarder sont 78, le code que le programme rend sans CANAL, et 0 à l'arrêt : l'image traite SIGTERM en 0,52 s.
Comment fabriquer des images cassées, et que refuse le script ?
Section intitulée « Comment fabriquer des images cassées, et que refuse le script ? »Un test qui n'a jamais refusé aucune image ne prouve rien : on ne sait pas s'il voit les défauts ou s'il dit toujours oui. Six images ne diffèrent de la bonne que par un écart minime chacune. Pour chaque variante, copiez le Dockerfile de l'image correcte dans Dockerfile.<étiquette> et appliquez l'écart du tableau, puis construisez avec docker build -f Dockerfile.<étiquette> -t releve-contrat:<étiquette> ..
| Étiquette | Écart avec le Dockerfile correct | Défaut du contrat |
|---|---|---|
1.0-root | la ligne USER 10001 est supprimée | le programme tourne en root |
1.0-sigterm | CMD en forme shell : CMD python /app/releve.py; exit $? | SIGTERM n'atteint pas le programme |
1.0-sante-processus | la sonde appelle /pret au lieu de /travail | l'état de santé ne dépend pas du travail |
1.0-ecrit-hors | RUN touch /app/journal.log && chown 10001 /app/journal.log avant USER, et ENV JOURNAL=/app/journal.log après | le programme écrit hors de /data |
1.0-sans-controle | ENV CANAL=defaut ajouté après USER | la variable obligatoire a une valeur par défaut cachée |
1.0-sans-healthcheck | la ligne HEALTHCHECK est supprimée | aucune sonde |
L'ordre de 1.0-ecrit-hors compte : le RUN touch s'exécute en root, avant USER, sinon le build échoue (voir le dépannage). Lancez maintenant le même script sur chaque image et lisez le premier refus.
L'image qui tourne en root
Section intitulée « L'image qui tourne en root »bash tester-contrat.sh releve-contrat:1.0-rootok [sante] HEALTHCHECK déclaréok [configuration] CANAL absente : arrêt avec le code 78 et un message clairok [configuration] CADENCE=2 prise en compteok [demarrage] répond en 0.28 sok [fonctionnement] /pret et /travail répondent comme prévuREFUSE [permissions] le processus tourne avec l'uid 0 (root)Cinq contrôles passent et le sixième refuse. Cette image démarre, répond et se configure : un test du code applicatif la dirait bonne. Seul le contrat sur l'uid la bloque. Le script a rendu le code 1 après 2,1 s.
L'image qui ignore SIGTERM
Section intitulée « L'image qui ignore SIGTERM »bash tester-contrat.sh releve-contrat:1.0-sigtermok [sante] HEALTHCHECK déclaréok [configuration] CANAL absente : arrêt avec le code 78 et un message clairok [configuration] CADENCE=2 prise en compteok [demarrage] répond en 0.27 sok [fonctionnement] /pret et /travail répondent comme prévuok [permissions] uid 10001, non rootok [permissions] --read-only : le service tourne, l'écriture hors /data est refuséeok [sante] healthyok [sante] unhealthy quand le travail cesseok [sante] retour à healthyREFUSE [arret] code de sortie 137 après docker stop en 10.29 s (SIGTERM non traité ?)Tous les contrôles passent sauf le dernier, qui est le seul à pouvoir voir ce défaut. Avec une commande suivie de ; exit $?, la forme shell de CMD laisse un shell comme PID 1, et ce shell ne transmet pas SIGTERM au programme Python : Docker attend les dix secondes du délai de grâce avant de tuer le conteneur. Le script a mesuré 137 après 10,29 s, et il a rendu le code 1 après 22,1 s en tout. Ces durées sont une mesure sur la machine de la leçon (les mesures de l'arrêt forcé vont de 10,21 à 10,30 s) : retenez l'ordre de grandeur, le délai de grâce de dix secondes.
L'image n'a pas ps, mais le noyau expose la ligne de commande du PID 1 dans /proc. Lisez-la dans un conteneur lancé avec cette image.
docker run -d --name m-sig -e CANAL=x releve-contrat:1.0-sigterm >/dev/nulldocker exec m-sig cat /proc/1/cmdline | tr '\0' ' '; echodocker rm -f m-sig >/dev/null/bin/sh -c python /app/releve.py; exit $?Le PID 1 doit apparaître comme /bin/sh -c python /app/releve.py; exit $? : c'est le shell, et non python, qui reçoit SIGTERM. Avec l'image correcte, la même commande affiche python /app/releve.py.
L'image dont la sonde ne mesure pas le travail
Section intitulée « L'image dont la sonde ne mesure pas le travail »bash tester-contrat.sh releve-contrat:1.0-sante-processusok [sante] HEALTHCHECK déclaréok [configuration] CANAL absente : arrêt avec le code 78 et un message clairok [configuration] CADENCE=2 prise en compteok [demarrage] répond en 0.27 sok [fonctionnement] /pret et /travail répondent comme prévuok [permissions] uid 10001, non rootok [permissions] --read-only : le service tourne, l'écriture hors /data est refuséeok [sante] healthyREFUSE [sante] le travail a cessé mais l'image reste healthy après 20 s (la sonde ne mesure pas le travail)Cette image a bien un HEALTHCHECK, et le contrôle de déclaration l'a laissée passer. Sa sonde interroge /pret, qui répond tant que le processus tourne, donc elle reste healthy alors que le travail a cessé. Ce défaut est sournois : l'état de santé est vert et faux. Seul le cycle complet du contrôle de santé le démasque, en 23,2 s.
L'image qui écrit hors de son dossier
Section intitulée « L'image qui écrit hors de son dossier »bash tester-contrat.sh releve-contrat:1.0-ecrit-horsok [sante] HEALTHCHECK déclaréok [configuration] CANAL absente : arrêt avec le code 78 et un message clairok [configuration] CADENCE=2 prise en compteok [demarrage] répond en 0.28 sok [fonctionnement] /pret et /travail répondent comme prévuok [permissions] uid 10001, non rootREFUSE [permissions] le service ne tourne pas sous --read-only avec un tmpfs sur /data (code 2)Dans l'utilisation normale, cette image fonctionne : le fichier /app/journal.log appartient à l'uid 10001 et le programme y écrit. Sous --read-only, l'écriture échoue, le conteneur s'arrête, et attendre_pret rend le code 2. Le refus apparaît en 2,8 s. C'est la panne que l'exploitant découvre le jour où il durcit l'image, et que ce contrôle rend visible avant la livraison.
L'image qui ne contrôle pas sa configuration
Section intitulée « L'image qui ne contrôle pas sa configuration »bash tester-contrat.sh releve-contrat:1.0-sans-controleok [sante] HEALTHCHECK déclaréREFUSE [configuration] sans CANAL, le conteneur tourne toujours : la variable obligatoire n'est pas vérifiéeAvec ENV CANAL=defaut, la variable obligatoire n'est plus jamais absente : le programme démarre sans que l'utilisateur ait choisi un canal, et le conteneur ne s'arrête pas. Le script attend 20 s la fin du conteneur, puis refuse (20,5 s au total). Une valeur par défaut cachée dans l'image laisse la configuration sans contrôle, ce que le contrat interdit pour une variable déclarée obligatoire.
L'image sans sonde
Section intitulée « L'image sans sonde »bash tester-contrat.sh releve-contrat:1.0-sans-healthcheckREFUSE [sante] aucun HEALTHCHECK déclaré dans l'imageLe refus est immédiat : le script lit .Config.Healthcheck, trouve null et s'arrête avant de lancer le moindre conteneur, en moins de 0,1 s à la mesure.
Le protocole est le même pour les sept images : une commande, un code de sortie, une ligne qui nomme le contrôle. Ajouter un contrôle, c'est ajouter un bloc au script, sans rien changer à la manière de l'appeler.
Pourquoi hadolint refuse-t-il une durée en millisecondes ?
Section intitulée « Pourquoi hadolint refuse-t-il une durée en millisecondes ? »hadolint, l'analyseur statique de Dockerfile, n'accepte que les unités s, m et h dans les durées d'un HEALTHCHECK, alors que Docker Engine accepte aussi ms. Un Dockerfile écrit avec --start-interval=500ms se construit donc sans erreur, puis échoue à l'analyse avec missing whitespace. La parade est d'écrire la durée en secondes : 0.5s, comme dans le Dockerfile de la leçon.
Revenez dans le répertoire de la leçon, celui qui contient le Dockerfile de l'image correcte : la commande sed plus bas le lit par son nom. La commande ci-dessous épingle la version de hadolint par son digest et coupe le réseau : le résultat ne dépend ni d'une mise à jour ni d'un accès extérieur. Elle lit le Dockerfile de l'image correcte, qui porte 0.5s.
docker run --rm -i --network none hadolint/hadolint:v2.15.1@sha256:32dac94127fd60b7b7e3fbfc65e1383b9b5e25c9bfd7b8536de7a539fe68a12d hadolint - < Dockerfileecho "rc=$?"rc=0Le code 0 signifie que l'analyse passe. Pour voir le refus, donnez à hadolint le même Dockerfile avec la durée en millisecondes, dans un fichier temporaire.
sed 's/--start-interval=0.5s/--start-interval=500ms/' Dockerfile > Dockerfile.msdocker run --rm -i --network none hadolint/hadolint:v2.15.1@sha256:32dac94127fd60b7b7e3fbfc65e1383b9b5e25c9bfd7b8536de7a539fe68a12d hadolint - < Dockerfile.msecho "rc=$?"rm Dockerfile.ms/dev/stdin:8:79 missing whitespacerc=1Regardez la colonne 79 : elle désigne la fin de 500ms. L'analyseur lit 500m comme 500 minutes, puis le s restant ne correspond à aucun champ, d'où « missing whitespace ». C'est une erreur d'analyse, pas une règle de style que --ignore pourrait désactiver. Les versions 2.14.0 (image hadolint/hadolint:v2.14.0@sha256:27086352fd5e1907ea2b934eb1023f217c5ae087992eb59fde121dce9c9ff21e) et 2.15.1 de hadolint refusent toutes deux 500ms, avec le même message et les mêmes colonnes.
| Durée testée | Option | Code de sortie |
|---|---|---|
500ms | --start-interval | 1 (missing whitespace) |
1s | --start-interval | 0 |
0.5s | --start-interval | 0 |
2s | --start-interval | 0 |
500ms | --interval | 1 (missing whitespace, colonne 28) |
Le tableau montre que --start-interval est reconnu : seule l'unité ms pose problème, y compris sur --interval, qui n'a rien de récent. Écrivez donc toutes les durées de HEALTHCHECK en s, m ou h. Docker enregistre 0.5s comme "StartInterval":500000000, la même valeur que 500ms. La fiche hadolint décrit les règles et l'intégration en CI.
Que faire quand un contrôle refuse ou que le script échoue ?
Section intitulée « Que faire quand un contrôle refuse ou que le script échoue ? »Chaque ligne du tableau reprend un message que Docker, hadolint ou le script affichent réellement.
| Symptôme | Cause | Solution |
|---|---|---|
error: no such object: releve-contrat:1.0-ecrit-hors | l'image n'existe pas : le build a échoué ou l'étiquette est mal écrite | docker image ls releve-contrat ; relancer docker build et lire son erreur |
RUN touch … did not complete successfully: exit code: 1 pendant le build | le RUN est placé après USER 10001 : un utilisateur sans privilège ne peut pas créer un fichier dans /app | placer le RUN qui écrit avant USER, puis redonner le fichier à l'uid avec chown |
REFUSE [configuration] … le conteneur s'est arrêté avec le code 0 | le programme refuse de démarrer, mais un wrapper masque son code de sortie (par exemple un ; true avant exit $? en forme shell) | rendre le code du programme tel quel, en forme exec |
REFUSE [permissions] … (code 2) | le conteneur s'arrête sous --read-only : le programme écrit hors du dossier prévu | lire docker logs, déplacer l'écriture dans /data ou monter un tmpfs au bon endroit |
REFUSE [sante] … reste healthy après 20 s | la sonde interroge une route qui ne dépend pas du travail | pointer la sonde sur /travail, ou sur la vérification qui juge le résultat réel |
Up … (unhealthy) et le conteneur ne bouge pas | Docker ne redémarre pas un conteneur unhealthy | lire .State.Health.Log, corriger la cause, ou confier la décision à un orchestrateur |
REFUSE [arret] code de sortie 137 … en 10.29 s | SIGTERM n'atteint pas le programme | forme exec pour CMD, ou un gestionnaire de signal dans le programme |
/dev/stdin:8:79 missing whitespace avec hadolint | une durée du HEALTHCHECK est écrite en millisecondes (500ms), unité que hadolint n'accepte pas | écrire la durée en secondes (0.5s), voir la section sur les millisecondes |
Quand un refus ne suffit pas, relancez le conteneur en cause à la main, car le trap supprime les conteneurs de test à la sortie du script, puis lisez docker logs. La page Inspecter un conteneur en marche donne le détail des champs à regarder.
Comment tout nettoyer ?
Section intitulée « Comment tout nettoyer ? »Le script de test supprime déjà ses conteneurs avec trap. Il reste les images construites, l'image de hadolint et le cache de build, où BuildKit garde l'image de base python:3.15.2-slim : elle n'apparaît pas dans docker image ls, donc docker image rm ne peut pas la retirer. Retirez les images par leur nom exact, videz le cache avec docker builder prune --all --force (il efface le cache de tous vos builds, pas seulement celui de cette leçon), et supprimez les fichiers de la leçon par leur nom, sans suppression récursive.
docker rm -f m-a m-f m-s m-n hc-long hc-court 2>/dev/nulldocker image rm sonde-lente:1.0 releve-contrat:1.0 releve-contrat:1.0-root releve-contrat:1.0-sigterm \ releve-contrat:1.0-sante-processus releve-contrat:1.0-ecrit-hors \ releve-contrat:1.0-sans-controle releve-contrat:1.0-sans-healthcheckdocker builder prune --all --forcedocker image rm hadolint/hadolint:v2.15.1@sha256:32dac94127fd60b7b7e3fbfc65e1383b9b5e25c9bfd7b8536de7a539fe68a12ddocker ps -aPour les fichiers, rm releve.py Dockerfile tester-contrat.sh et chaque Dockerfile.<étiquette> que vous avez créé, puis rmdir sur le répertoire de travail. Dans le répertoire de la sonde lente, rm sonde.sh Dockerfile, puis rmdir. Vérifiez que docker ps -a ne liste plus aucun conteneur de la leçon.
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab fournit un Dockerfile et un service à construire : le conteneur obtenu affiche toujours « Up », même quand son travail est à l'arrêt. Vous y ajoutez une sonde de santé qui juge le travail réel plutôt que la présence du processus, puis vous provoquez les trois états : sain au départ, malade quand le travail cesse, sain de nouveau quand il reprend. Seul l'état du système est contrôlé, avec dsoxlab check, jamais les commandes tapées : la validation lit la sonde déclarée dans l'image et ses bornes de temps, puis observe l'état de santé du conteneur à chaque étape.
À retenir
Section intitulée « À retenir »-
Le contrat d'une image est ce qu'un utilisateur peut attendre sans lire son Dockerfile : démarrer, répondre, se configurer, tourner sans privilège, s'arrêter, dire son état. Chaque attente devient un contrôle, lancé de l'extérieur sur l'image finale.
-
Un script de test borne chaque attente : une boucle qui sort dès que la condition est vraie et échoue à une limite, jamais une pause fixe. Chaque refus écrit
REFUSE [contrôle] messageet rend le code 1. -
Pour une variable obligatoire absente, l'image doit s'arrêter avec un code non nul et un message qui nomme la variable. Une valeur par défaut cachée dans l'image le rend sans effet.
-
Contrôlez l'uid avec
docker exec … id -uet relancez l'image avec--read-onlyet untmpfssur le dossier de données : une image qui écrit ailleurs s'arrête sous--read-only. -
docker stopenvoie SIGTERM puis SIGKILL après dix secondes. Un code 137, rendu à la fin du délai de grâce (10 s par défaut ; 10,29 s mesurées ici), signale une image qui ignore SIGTERM ; 0 ou 143 est acceptable. -
HEALTHCHECKs'écrit dans le Dockerfile et se lit dans.Config.Healthcheck, en nanosecondes, puis.State.Healthet sonLog. Un conteneurunhealthyreste en marche ;--health-cmdsurcharge la sonde et--no-healthcheckla retire. -
Une sonde doit juger le travail, pas le processus. Le test qui coupe le travail et attend
unhealthy, puishealthyau retour, est le seul à démasquer une sonde toujours verte. -
hadolint n'accepte que les unités
s,methdans les durées d'unHEALTHCHECK, alors que Docker 29.9.2 accepte aussims: écrivez0.5splutôt que500mspour évitermissing whitespace.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de ce guide est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Optimiser la taille d'une image
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications