Un compte du groupe docker et un conteneur qui monte docker.sock ont le
même pouvoir : ils parlent au démon Docker, et le démon tourne en root. Cette
leçon vous apprend à dresser la liste de ces accès directs, à comprendre
pourquoi chacun vaut un accès root sur l'hôte, puis à les retirer et à vérifier
que la voie Docker est réellement fermée. Cette vérification a une limite : elle
ne dit pas ce qu'un compte a pu faire pendant qu'il était root par Docker, et la
leçon dit où elle s'arrête. Les mesures viennent d'une VM Debian 13 jetable avec
Docker Engine 29.9.2 : ne rejouez pas les retraits sur un hôte partagé.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »Chaque retrait se vérifie sur l'état réel, pas sur la configuration annoncée.
- Vous inventoriez les voies d'accès au démon : groupe, mode du socket, ACL,
écoute TCP et
sudo. - Vous démontrez qu'appartenir au groupe
dockeréquivaut à être root. - Vous retirez un compte du groupe, vous fermez ses processus encore ouverts et vous retirez une ACL qui rouvre l'accès sans le groupe.
- Vous auditez tous les conteneurs, arrêtés compris, qui montent le socket,
directement ou par un répertoire parent (
/runou/), et vous le prouvez par l'inode. - Vous constatez qu'un montage en lecture seule n'empêche pas d'arrêter un conteneur.
- Vous retirez un montage en recréant le conteneur sans perdre sa configuration.
- Vous savez ce que le retrait ne prouve pas.
Prérequis
Section intitulée « Prérequis »La leçon
Faire tourner les journaux, et reprendre du disque
(C35b) précède celle-ci. Vous devez savoir lancer un conteneur avec un montage
-v, lire un ls -l et utiliser sudo. Les droits Unix sur un fichier sont
détaillés dans la page
Affiner les permissions avec les ACL,
qui explique aussi getfacl et setfacl.
La démonstration utilise le compte stagiaire-ops et les conteneurs
c36-tableau, c36-racine, c36-renomme, c36-arrete et c36-sain. Les deux labs de fin de leçon
travaillent sur d'autres noms. Tous les conteneurs partent de la même image,
épinglée à son digest :
IMG='alpine:3.24.3@sha256:be2656061b536c1883c4034790e21d0a09c5aaaf51968b89368a3c0371ea2c9a'docker version --format 'client={{.Client.Version}} serveur={{.Server.Version}}'client=29.9.2 serveur=29.9.2Qui peut parler au démon, et comment le savoir ?
Section intitulée « Qui peut parler au démon, et comment le savoir ? »Le démon Docker écoute par défaut sur un socket Unix, un fichier spécial
/run/docker.sock : quiconque peut l'ouvrir peut envoyer des ordres au démon.
L'inventaire consiste donc à lister qui peut ouvrir ce fichier, ou joindre le
démon autrement.
ls -l /run/docker.sockreadlink -f /var/run/docker.sockgetent group dockersrw-rw---- 1 root docker 0 Nov 4 18:46 /run/docker.sock/run/docker.sockdocker:x:989:ansibleLe mode srw-rw---- donne la lecture et l'écriture à root et au groupe
docker, et rien aux autres. getent group docker liste les membres de ce
groupe, ici ansible, le compte d'exploitation de la VM.
readlink -f montre ensuite que /var/run/docker.sock, le chemin que les
outils utilisent, désigne le même fichier que /run/docker.sock, car
/var/run est un lien vers /run. Cette résolution servira pour les montages.
Un + à la fin du mode, comme dans srw-rw----+, signale une ACL, une
liste de droits supplémentaires attachée au fichier, que ls -l ne détaille
pas. Pour la lire, il faut getfacl, absent de la Debian 13 minimale de la VM :
le paquet acl l'apporte.
sudo apt-get install -y aclgetfacl -p /run/docker.sockSans ACL, getfacl -p ne rend que les trois entrées du mode classique
(propriétaire, groupe, autres). La sortie d'apt-get n'est pas reproduite :
# owner: root# group: dockeruser::rw-group::rw-other::---Le démon peut aussi écouter en TCP, ce qui donnerait son API à tout le réseau qui l'atteint. Cela se lit dans la ligne de démarrage du service et dans les ports en écoute :
systemctl cat docker | grep -E '^ExecStart='sudo ss -lntp | grep -E 'dockerd' || echo "aucune écoute TCP de dockerd"ExecStart=/usr/bin/dockerd -H fd:// --containerd=/run/containerd/containerd.sockaucune écoute TCP de dockerd-H fd:// signifie que le démon reçoit son socket de systemd, sans option
tcp://. Cherchez dockerd dans ss -lntp, pas le mot « docker » : le
processus docker-proxy écoute légitimement en TCP pour les ports publiés, et
il n'est pas l'API. Avec ce ExecStart, une clé hosts dans
/etc/docker/daemon.json n'ouvre pas de port : sur la VM, le démon refuse de
démarrer, avec le message the following directives are specified both as a flag and in the configuration file: hosts. Une écoute TCP vient donc d'un
-H tcp:// dans le service ou dans une surcharge systemd, que systemctl cat docker affiche en entier. Les deux contrôles se font ensemble, parce que ss
voit l'écoute réelle, quelle que soit son origine.
Dernière voie à contrôler, sudo. La commande sudo -l -U <compte> dit si un
compte peut passer root autrement : avec un sudo large, le groupe docker
est superflu, puisque le compte est déjà root. Une règle sudo limitée à
/usr/bin/docker donne aussi root : le compte peut lancer sudo docker run -v /:/hote … et obtenir la même racine montée que le groupe.
Pourquoi appartenir au groupe docker revient-il à être root ?
Section intitulée « Pourquoi appartenir au groupe docker revient-il à être root ? »Le démon exécute les ordres de n'importe quel client qui ouvre son socket, avec ses propres droits, ceux de root. Un membre du groupe peut donc lui demander de lancer un conteneur qui monte les fichiers de l'hôte, puis d'y lire ou d'y écrire comme root.
Pour le montrer, créez un compte de travail sans sudo et ajoutez-le au groupe :
sudo useradd -m -s /bin/bash stagiaire-opssudo usermod -aG docker stagiaire-opsid stagiaire-opsuid=1002(stagiaire-ops) gid=1002(stagiaire-ops) groups=1002(stagiaire-ops),989(docker)Avec ce compte, sans aucun sudo, lancez deux conteneurs. Le premier monte
/etc de l'hôte en lecture seule et lit la première ligne de shadow, le
fichier des empreintes de mots de passe. Le second monte toute la racine de
l'hôte et exécute id dans cette racine :
sudo -n -u stagiaire-ops docker run --rm -v /etc:/hote-etc:ro "$IMG" head -1 /hote-etc/shadowsudo -n -u stagiaire-ops docker run --rm -v /:/hote "$IMG" chroot /hote idroot:*:20760:0:99999:7:::uid=0(root) gid=0(root) groups=0(root),1(daemon),2(bin),3(sys),4(adm),6(disk),10(uucp),11,20(dialout),26(tape),27(sudo)La première sortie est la première ligne de /etc/shadow de l'hôte. La seconde
montre que chroot /hote, qui prend la racine de l'hôte comme racine, ouvre une
session uid=0 dans le système réel. Le même compte, sans Docker, n'obtient
rien :
sudo -n -u stagiaire-ops head -1 /etc/shadowhead: cannot open '/etc/shadow' for reading: Permission deniedLe groupe docker n'est donc pas un droit « de gérer des conteneurs » : c'est
un accès root sur l'hôte, qu'il faut accorder comme tel.
Comment retirer un compte du groupe docker, et que faire des sessions ouvertes ?
Section intitulée « Comment retirer un compte du groupe docker, et que faire des sessions ouvertes ? »Avant de retirer le compte, il faut une session de ce compte déjà ouverte, pour
voir ce qu'elle devient. Ouvrez un second terminal et lancez-y la commande
ci-dessous. Elle affiche les groupes du compte, attend 30 secondes, les
affiche de nouveau, puis lance docker ps. Dès qu'elle tourne, revenez au
premier terminal sans attendre : vous avez 30 secondes pour y lancer le
retrait. Si c'est trop court, remplacez sleep 30 par sleep 60.
# second terminal, à lancer en premiersudo -n -u stagiaire-ops bash -c 'id -nG; sleep 30; echo "--- après le retrait, dans la même session :"; id -nG; docker ps >/dev/null; echo "docker ps rc=$?"'Dans le premier terminal, retirez le compte avec gpasswd -d. Vérifiez ensuite
la liste du groupe, les groupes du compte et une nouvelle commande docker ps,
dont vous relevez le code de retour :
# premier terminal, juste après avoir lancé la commande du secondsudo gpasswd -d stagiaire-ops dockergetent group dockerid stagiaire-opssudo -n -u stagiaire-ops docker ps; echo "rc=$?"Removing user stagiaire-ops from group dockerdocker:x:989:ansibleuid=1002(stagiaire-ops) gid=1002(stagiaire-ops) groups=1002(stagiaire-ops)permission denied while trying to connect to the docker API at unix:///var/run/docker.sockrc=1Le groupe ne liste plus le compte et id non plus. La nouvelle commande est
refusée, avec le message permission denied while trying to connect to the docker API, et son code de retour vaut 1. Le retrait semble acquis.
Regardez pourtant le second terminal : une session ouverte avant le retrait garde son accès. Au bout de ses 30 secondes, il affiche :
stagiaire-ops docker--- après le retrait, dans la même session :stagiaire-ops dockerdocker ps rc=0Les deux premières lignes donnent les groupes avant et après le retrait : la
session voit encore docker, et son docker ps réussit (rc=0). Les groupes
d'un processus sont fixés à l'ouverture de la session, et le retrait ne les
modifie pas : cette session reste utilisable jusqu'à sa fermeture.
Un retrait ne vaut donc qu'une fois les sessions ouvertes fermées, sinon
l'accès retiré dans /etc/group reste ouvert en pratique. Contrôlez par un appel
réel, docker ps lancé depuis une nouvelle connexion du compte, plutôt que par
la ligne de /etc/group.
Comment fermer les processus encore ouverts du compte ?
Section intitulée « Comment fermer les processus encore ouverts du compte ? »Pour fermer ces sessions, listez d'abord les processus du compte avec pgrep -u.
Un processus lancé par sudo -u, qui joue ici le rôle d'une session oubliée,
apparaît dans la liste :
sudo -u stagiaire-ops bash -c 'sleep 600' &pgrep -u stagiaire-ops -a38840 sleep 600loginctl terminate-user ferme les sessions de connexion d'un compte (SSH,
console), mais il ne voit pas ce processus :
sudo loginctl terminate-user stagiaire-ops; echo "rc=$?"Could not terminate user: User ID 1002 is not logged in or lingeringrc=1Le message dit que loginctl ne connaît aucune session de ce compte : le
processus existe, mais il n'est rattaché à aucune connexion. pkill -KILL -u
termine tous les processus du compte, quelle que soit leur origine, et pgrep
confirme qu'il n'en reste aucun :
sudo pkill -KILL -u stagiaire-ops; echo "pkill rc=$?"pgrep -u stagiaire-ops -a || echo "aucun processus restant après pkill"pkill rc=0aucun processus restant après pkillUn multiplexeur de terminal, une tâche cron ou un service systemd --user
laissés par le compte sont aussi des processus de ce compte, donc couverts par
pgrep -u et pkill -u. Ces cas n'ont pas été mesurés ici : relancez pgrep
après coup pour vérifier qu'ils n'ont pas repris vie.
Quelles autres voies rouvrent l'accès sans le groupe ?
Section intitulée « Quelles autres voies rouvrent l'accès sans le groupe ? »Le groupe n'est qu'une façon d'ouvrir le socket. Une ACL peut donner le même
droit à un compte précis, sans passer par le groupe. Le compte est aujourd'hui
refusé ; après setfacl, il passe :
sudo setfacl -m u:stagiaire-ops:rw /run/docker.sockgetfacl -p /run/docker.sockls -l /run/docker.socksudo -n -u stagiaire-ops docker ps --format '{{.Names}}' >/dev/null; echo "rc=$?"# owner: root# group: dockeruser::rw-user:stagiaire-ops:rw-group::rw-mask::rw-other::---
srw-rw----+ 1 root docker 0 Nov 4 18:46 /run/docker.sockrc=0La ligne user:stagiaire-ops:rw- est l'ACL, et le + de ls -l la signale :
le compte appelle le démon alors qu'il n'est pas dans le groupe. Un inventaire
qui lit seulement getent group docker la manque. Lisez aussi ls -l et
getfacl.
Pour retirer cette ACL sans redémarrer le démon, supprimez l'entrée du compte,
puis relisez-la avec getfacl et appelez le démon depuis le compte :
sudo setfacl -x u:stagiaire-ops /run/docker.sockgetfacl -p /run/docker.sockls -l /run/docker.socksudo -n -u stagiaire-ops docker ps; echo "rc=$?"# owner: root# group: dockeruser::rw-group::rw-mask::rw-other::---
srw-rw----+ 1 root docker 0 Nov 4 18:46 /run/docker.sockpermission denied while trying to connect to the docker API at unix:///var/run/docker.sockrc=1La ligne user:stagiaire-ops:rw- a disparu de getfacl et l'appel est refusé
(rc=1). Remarquez que ls -l affiche encore le + : il reste après un
setfacl -x, parce que le masque subsiste. Le + seul ne permet donc pas de
conclure, c'est getfacl qui tranche.
Redémarrer le socket (systemctl restart docker.socket docker) efface aussi
l'ACL, mais il redémarre le démon : sans live-restore, les conteneurs sont
relancés. La leçon
Mettre à jour le moteur
détaille ce comportement ; sur un hôte en service, préférez setfacl -x.
Ce constat ne vaut que pour une ACL posée à la main. Une ACL posée par une unité systemd ou par une règle udev serait réappliquée à chaque création du socket ; ce cas n'a pas été mesuré, cherchez-le dans les unités et les règles de l'hôte.
Reste sudo. Sur la VM, sudo -l -U stagiaire-ops rend
User stagiaire-ops is not allowed to run sudo on c45-debian. (c45-debian est
le nom de la VM), donc aucune voie par là. Un compte autorisé à tout faire avec
sudo serait root sans passer par Docker.
Quels conteneurs montent le socket du démon ?
Section intitulée « Quels conteneurs montent le socket du démon ? »Un conteneur qui monte docker.sock donne à son processus le pouvoir de tout
compte du groupe docker. Le schéma résume les voies d'accès vues jusqu'ici :
les flèches épaisses sont des accès directs au socket, et les flèches en
pointillés passent par un répertoire qui le contient, /run ou la racine /.
Tout aboutit au même socket, donc au même démon root.
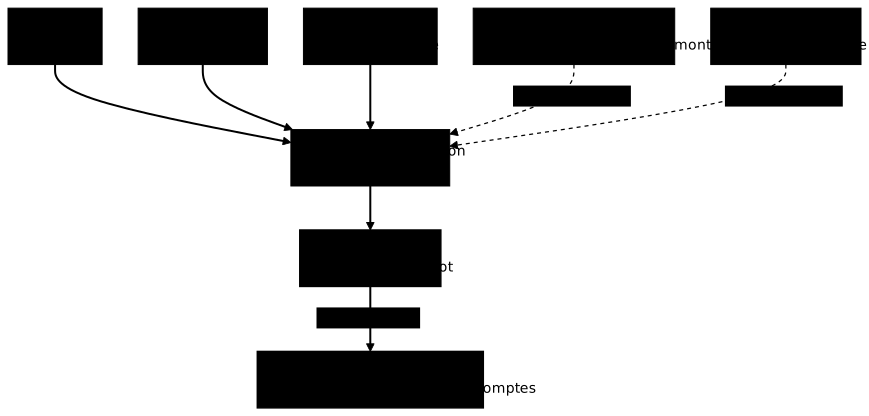
Cinq conteneurs de démonstration couvrent ces formes, et une absence. Le premier
monte le socket par son chemin et un volume nommé, avec les labels, la variable
d'environnement et la politique de redémarrage d'un petit tableau de bord. Les
trois suivants montent /, /run sous un autre nom, et /run dans un
conteneur arrêté créé avec --restart always. Le dernier ne monte rien :
docker run -d --name c36-tableau --label equipe=supervision --restart unless-stopped -e MODE=lecture \ -v /var/run/docker.sock:/var/run/docker.sock:ro -v c36-cache:/cache "$IMG" sleep 3600 >/dev/nulldocker run -d --name c36-racine -v /:/hote:ro "$IMG" sleep 3600 >/dev/nulldocker run -d --name c36-renomme -v /run:/data:ro "$IMG" sleep 3600 >/dev/nulldocker create --name c36-arrete --restart always -v /run:/r "$IMG" sleep 3600 >/dev/nulldocker run -d --name c36-sain "$IMG" sleep 3600 >/dev/nullPour les auditer, un script lit les montages de chaque conteneur avec
docker inspect, résout chaque source avec readlink -f, puis la compare au
socket résolu. Une source qui est le socket, ou un répertoire qui le contient,
l'expose. Comparer des chaînes de caractères laisserait passer
/var/run/docker.sock, qui est /run/docker.sock sous un autre nom, et /run.
SOCK=$(readlink -f /var/run/docker.sock)for c in $(docker ps -a --format '{{.Names}}'); do docker inspect -f '{{range .Mounts}}{{.Source}} {{.Destination}}{{"\n"}}{{end}}' "$c" | while read -r src dst; do [ -z "$src" ] && continue r=$(sudo readlink -f "$src") if [ "$SOCK" = "$r" ] || [ "${SOCK#"${r%/}/"}" != "$SOCK" ]; then echo "$c : $src -> $dst EXPOSE" else echo "$c : $src -> $dst" fi donedonec36-arrete : /run -> /r EXPOSEc36-renomme : /run -> /data EXPOSEc36-racine : / -> /hote EXPOSEc36-tableau : /var/lib/docker/volumes/c36-cache/_data -> /cachec36-tableau : /var/run/docker.sock -> /var/run/docker.sock EXPOSEChaque ligne donne la source du montage et sa destination ; EXPOSE marque une
source qui est le socket ou qui le contient. Quatre conteneurs sont signalés,
dont c36-racine (la racine contient /run/docker.sock) et c36-arrete, qui
est arrêté mais que --restart always relancera. Le volume nommé c36-cache
n'est pas signalé, et c36-sain n'apparaît pas faute de montage. Monter /run
ou / n'est donc pas plus sûr que monter le socket.
Deux détails du script évitent des pièges faciles à écrire. Le premier concerne
la racine. Pour r=/, un motif simple comme case "$SOCK" in "$r"/*) devient
//*, qui ne correspond à aucun chemin absolu : un conteneur qui monte /
passerait inaperçu. Le test du script retire la barre finale de la source,
${r%/}, puis cherche ce préfixe suivi de / au début du socket ; pour la
racine, il retire le / initial de /run/docker.sock et le signale.
Le second piège concerne readlink -f. Sans sudo, la commande échoue sur les
chemins de /var/lib/docker, que seul root peut traverser : la variable r
reste vide, et un test mal écrit déclarerait alors exposé un simple volume
nommé. Avec sudo readlink -f, le volume c36-cache est résolu et
correctement non signalé. La boucle porte enfin sur docker ps -a, pas
docker ps, pour ne pas oublier un conteneur arrêté.
Ce script se fie à la configuration des conteneurs. Pour une preuve vue de l'intérieur, comparez l'inode, le numéro qui identifie un fichier pour le noyau, accompagné du numéro de périphérique. Un chemin est ce qu'on a écrit, l'inode est ce que le noyau désigne : deux noms qui mènent au même couple sont le même fichier. La boucle suivante cherche tous les sockets visibles dans chaque conteneur actif, sans chemin écrit à l'avance, et ne garde que ceux dont le couple est celui du socket de l'hôte :
H=$(stat -c '%d:%i' "$SOCK"); echo "hôte : $H"for c in $(docker ps --format '{{.Names}}'); do docker exec "$c" find / -path /proc -prune -o -type s -print 2>/dev/null | while read -r s; do [ "$(docker exec "$c" stat -c '%d:%i' "$s")" = "$H" ] && echo "$c : $s" donedonehôte : 25:18226c36-renomme : /data/docker.sockc36-racine : /hote/run/docker.sockc36-tableau : /run/docker.sockLes trois conteneurs exposés montrent le même couple 25:18226 que l'hôte, sous
trois noms différents : le nom ne prouve rien, le couple oui. c36-sain
n'affiche rien. Le filtre cache pourtant un fait grave : un conteneur qui monte
/ ou /run voit aussi des dizaines d'autres sockets de l'hôte, ceux de
containerd, de dbus et de systemd, et l'agent SSH d'un utilisateur
(/run/user/1001/openssh_agent). Retirer l'accès à docker.sock ne suffit
donc pas à rendre ces montages inoffensifs : c'est le montage lui-même qu'il
faut retirer.
Pourquoi le montage en lecture seule ne protège-t-il pas ?
Section intitulée « Pourquoi le montage en lecture seule ne protège-t-il pas ? »Les deux premiers conteneurs portent :ro, et ce :ro ne protège de rien : il
s'applique au fichier du socket, pas aux requêtes qui y circulent. Depuis
c36-tableau, un POST d'arrêt visant c36-sain réussit. La commande installe
d'abord curl dans le conteneur depuis les dépôts d'Alpine : la VM doit donc
joindre Internet, sinon elle ne rend pas 204.
docker exec c36-tableau sh -c 'apk add -q --no-cache curl >/dev/null 2>&1; curl -s -o /dev/null -w "%{http_code}\n" --unix-socket /var/run/docker.sock -X POST http://x/containers/c36-sain/stop'docker ps -a --filter name=c36-sain --format '{{.Names}} {{.Status}}'204c36-sain Exited (137) Less than a second agoLe code 204 dit que le démon a exécuté l'arrêt, et c36-sain est sorti avec
le code 137. Si un outil a vraiment besoin de l'API, par exemple un tableau de
bord qui liste les conteneurs, la solution n'est ni le :ro ni le socket brut :
c'est un proxy qui filtre les requêtes. La leçon
Interposer un proxy devant l'API Docker
(C36b) enseigne ce filtrage et ses limites.
Comment retirer un montage du socket ?
Section intitulée « Comment retirer un montage du socket ? »Un montage se décide à la création du conteneur : on ne le retire pas d'un conteneur qui tourne. Il faut recréer le conteneur sans le montage du socket. Recréer, c'est supprimer l'ancien conteneur et en lancer un nouveau : tout ce qui n'est pas répété dans la nouvelle commande, labels, variables d'environnement, politique de redémarrage, autres montages, est perdu. Relevez donc la configuration avant de supprimer :
docker inspect -f 'labels={{json .Config.Labels}} env={{json .Config.Env}} restart={{.HostConfig.RestartPolicy.Name}} mounts={{range .Mounts}}{{.Source}}:{{.Destination}} {{end}}' c36-tableaulabels={"equipe":"supervision"} env=["MODE=lecture","PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin"] restart=unless-stopped mounts=/var/lib/docker/volumes/c36-cache/_data:/cache /var/run/docker.sock:/var/run/docker.sockLe conteneur porte un label, une variable MODE, la politique
unless-stopped et deux montages : le volume c36-cache et le socket (la
variable PATH vient de l'image). Recréez-le avec les mêmes options, sauf le
socket, puis relisez la configuration et cherchez le socket :
docker rm -f c36-tableau >/dev/nulldocker run -d --name c36-tableau --label equipe=supervision --restart unless-stopped -e MODE=lecture \ -v c36-cache:/cache "$IMG" sleep 3600 >/dev/nulldocker inspect -f 'labels={{json .Config.Labels}} env={{json .Config.Env}} restart={{.HostConfig.RestartPolicy.Name}} mounts={{range .Mounts}}{{.Source}}:{{.Destination}} {{end}}' c36-tableaudocker exec c36-tableau ls -l /var/run/docker.sock; echo "rc=$?"labels={"equipe":"supervision"} env=["MODE=lecture","PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin"] restart=unless-stopped mounts=/var/lib/docker/volumes/c36-cache/_data:/cachels: /var/run/docker.sock: No such file or directoryrc=1Les labels, la variable et la politique de redémarrage sont identiques, le volume nommé a survécu (il vit hors du conteneur) et seul le montage du socket a disparu. Le message d'erreur dit que le conteneur recréé ne voit plus le socket : c'est une preuve plus fiable que la relecture de la commande de lancement. La recréation interrompt pourtant le service pendant quelques secondes, puisqu'il s'agit d'un nouveau conteneur : prévenez les utilisateurs avant.
Quand le conteneur est décrit dans un fichier Compose, préférez-le : supprimez la
ligne de volumes qui monte le socket, puis lancez docker compose up -d.
Compose détecte le changement, reprend le reste de la configuration du fichier
et affiche Recreated pour le conteneur ; ls -l /var/run/docker.sock y rend
ensuite No such file or directory, comme ci-dessus.
Il reste à nettoyer la démonstration et le compte de travail :
docker rm -f c36-tableau c36-racine c36-renomme c36-arrete c36-sain >/dev/nulldocker volume rm c36-cache >/dev/nullsudo userdel -r stagiaire-opsdocker ps -a --filter name=c36- --format '{{.Names}}'; id stagiaire-opsuserdel signale que le compte n'avait pas de boîte aux lettres, ce qui est sans
conséquence. id confirme que le compte n'existe plus, et la liste des
conteneurs reste vide :
userdel: stagiaire-ops mail spool (/var/mail/stagiaire-ops) not foundid: ‘stagiaire-ops’: no such userQue prouve un docker ps refusé, et que reste-t-il à vérifier ?
Section intitulée « Que prouve un docker ps refusé, et que reste-t-il à vérifier ? »Un docker ps refusé prouve une seule chose : la voie Docker du compte est
fermée. Il ne prouve pas que le compte a perdu tout accès à l'hôte. Un compte qui
a été root par Docker a pu laisser un conteneur lancé avec --restart qui monte
/, une clé SSH dans /root/.ssh/authorized_keys ou un binaire setuid : aucun
de ces accès ne passe plus par le socket, et le retrait du groupe n'y change
rien.
Ce qui relève de la leçon, c'est l'audit des conteneurs : docker ps -a, ceux
créés pendant la période où le compte avait l'accès (docker inspect -f '{{.Created}}' <nom> rend une date comme 2026-11-04T18:47:34.250972599Z, en
UTC) et les montages de /, de /run ou du socket, par le
script d'audit de la section « Quels conteneurs montent le socket du démon ? ». La recherche d'une clé SSH ajoutée ou d'un
binaire setuid relève d'une revue d'incident, hors de cette leçon.
Mettre en pratique
Section intitulée « Mettre en pratique »Le premier lab demande de retirer l'accès Docker d'un compte d'audit
temporaire, sans le supprimer et sans toucher à l'accès de l'opérateur. Deux
contrôles mesurent l'état réel de l'hôte : le compte n'appartient plus au groupe
docker, et un appel réel au démon depuis ce compte échoue. Garder le compte et
l'accès de l'opérateur sont des interdictions du scénario, vérifiées avant les
mesures : elles ne rapportent aucun point.
Le second lab part d'un conteneur applicatif qui monte /var/run/docker.sock en
lecture seule. Vous constatez d'abord qu'un POST d'arrêt passe, ce qui n'est
pas noté. Vous retirez ensuite la capacité d'atteindre le socket par tout
chemin, en laissant le conteneur actif et son label en place. Deux contrôles le
mesurent. Le premier résout chaque source de montage avec readlink -f et
refuse celle qui est le socket ou qui le contient. Le second relève depuis le
conteneur le couple périphérique-inode de chaque socket visible et refuse celui
du démon.
À retenir
Section intitulée « À retenir »Un accès direct au démon est un accès root sur l'hôte, et l'inventaire doit chercher toutes ses formes.
- Vous inventoriez le groupe
docker, le mode du socket, le+d'une ACL dansls -lavecgetfacl, une écoute TCP dedockerdet les droitssudo. - Vous savez qu'un membre du groupe
dockerest root sur l'hôte : il lit/etc/shadowet obtientuid=0parchrootdans une racine montée. - Vous retirez un compte avec
gpasswd -d, puis vous fermez ses sessions ouvertes : elles gardent leur accès. - Vous contrôlez le retrait par un appel réel, pas par
/etc/group, car une ACL posée à la main rouvre l'accès sans le groupe ;setfacl -xla retire etgetfacltranche, pas le+dels -l. - Vous fermez les processus du compte avec
pgrep -uetpkill -KILL -u. - Vous résolvez chaque source de montage avec
sudo readlink -fet vous comparez au socket ou à ses répertoires parents,/runet/compris, sur tous les conteneurs, arrêtés inclus. - Vous prouvez l'exposition par l'inode, vu depuis le conteneur, et le retrait par l'absence du socket dans le conteneur recréé avec la même configuration.
- Vous savez qu'un
docker psrefusé ne ferme que la voie Docker : l'audit des conteneurs en fait partie, le reste relève d'une revue d'incident. - Vous savez que le
:ron'empêche pas unPOST(204) : un outil qui a besoin de l'API passe par un proxy.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel est acquis : ce que donne le groupe docker, ce qu'un
retrait laisse ouvert et la façon de prouver un montage du socket.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Interposer un proxy devant l'API Docker
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications