Un port publié ne répond pas, ou répond à certains clients seulement, et la tentation est de vider le pare-feu « pour voir ». Cette leçon vous apprend à faire l'inverse : localiser le saut fautif avec des sondes placées à chaque étape du chemin et des compteurs de règles, corriger une seule règle, puis prouver la correction par des tests qui réussissent et par des tests qui échouent encore. Les mesures viennent d'une VM Debian 13 jetable avec Docker Engine 29.9.2 et iptables 1.8.11 (nf_tables) : elles décrivent ce moteur et ce pare-feu, pas tous les hôtes.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »Chaque diagnostic se conclut par une mesure, jamais par une supposition.
- Vous suivez le chemin d'un paquet vers un port publié, du DNAT jusqu'au conteneur, et vous distinguez le trafic routé du trafic local de l'hôte.
- Vous lisez le pare-feu que Docker utilise vraiment avec
docker info, puis les tables nftables qui coexistent avec les siennes. - Vous sondez un flux à plusieurs sauts et vous lisez les compteurs d'une règle pour savoir si elle voit les paquets.
- Vous expliquez pourquoi une règle
DOCKER-USERécrite sur le port publié ne bloque rien, et vous la corrigez avec--ctorigdstport. - Vous repérez un pare-feu d'hôte placé dans une autre table nftables, vous
mesurez qu'un
ACCEPTdeDOCKER-USERne l'emporte pas sur son refus, vous insérez une règle ciblée au bon endroit et vous revenez en arrière. - Vous lisez la MTU à chaque saut et vous la sondez avec un
pingà bit DF.
Prérequis
Section intitulée « Prérequis »Cette leçon prolonge deux leçons : Publier un port sans exposer tout
l'hôte et Le
réseau par défaut, et un réseau à
soi. Vous devez savoir
publier un port avec -p, créer un réseau avec docker network create et lire
une adresse IP et un masque comme 172.31.10.0/24.
Il vous faut une machine jetable : une VM Linux avec Docker Engine installé
par le dépôt officiel, un accès sudo, curl, la commande nft (paquet
nftables) et le ping d'iputils, celui des Debian et Ubuntu courantes.
Vérifiez aussi iptables --version : il doit afficher nf_tables. Si la
version est legacy, les règles de Docker ne sont pas dans nftables et nft list tables ne les montre pas.
Ne rejouez pas ces commandes sur un hôte partagé ni en production : elles ajoutent des règles au pare-feu, et l'une d'elles coupe le trafic routé de l'hôte. La section « Comment revenir en arrière en urgence ? » donne les commandes qui retirent tout.
Tous les conteneurs de la démonstration partent de la même image Alpine,
épinglée à son digest. BusyBox y fournit nc, wget et nslookup, mais pas
de serveur HTTP : le conteneur c39-m-api répond donc avec nc, en boucle, la
chaîne api-c39. Les objets créés portent le préfixe c39-m- et des réseaux
172.31.x.0/24, ce qui permet de tout retirer sans toucher au reste.
Par où passe un paquet vers un conteneur ?
Section intitulée « Par où passe un paquet vers un conteneur ? »Un client qui joint hôte:8070 ne parle pas au conteneur directement : le
noyau réécrit d'abord la destination, puis fait passer le paquet par des
chaînes de règles. Netfilter est le cadre de filtrage du noyau Linux ;
iptables et nftables sont deux outils qui y écrivent des règles. Une chaîne de
base est une chaîne branchée à un point précis du trajet, appelé crochet
(hook) : c'est elle qui reçoit les paquets, les autres chaînes n'étant que des
sous-programmes qu'elle appelle.
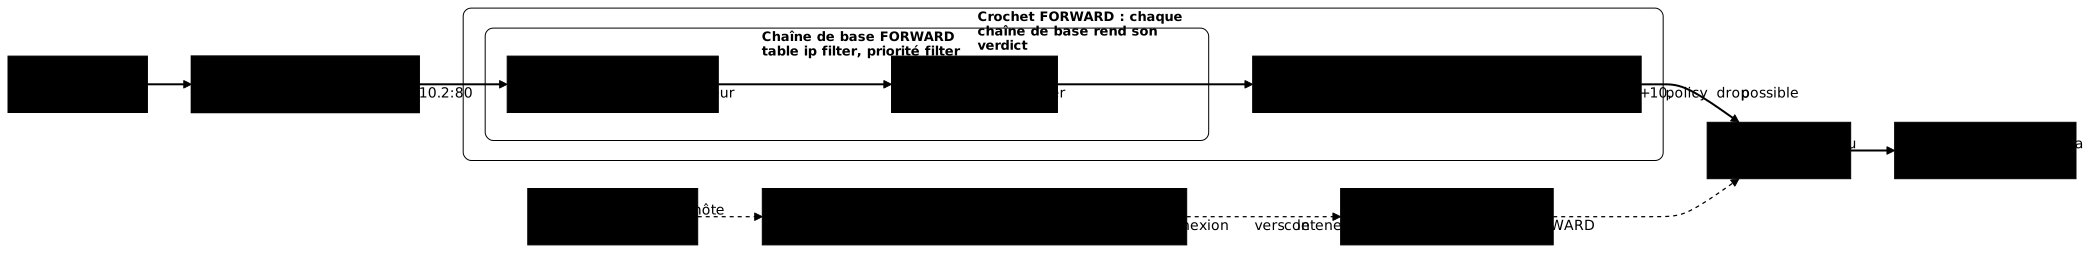
Le DNAT (Destination NAT) remplace l'adresse et le port de destination d'un
paquet entrant. Pour un port publié, Docker ajoute ce DNAT dans la table nat,
avant que le noyau décide de router le paquet vers le conteneur. Le paquet entre
alors dans le crochet FORWARD, celui du trafic qui traverse l'hôte sans lui
être destiné. Les règles que vous écrivez dans DOCKER-USER y sont lues en
premier, puis celles de DOCKER-FORWARD, que Docker gère. Une autre table
nftables de l'hôte, dont la priorité dépasse filter (par exemple
filter + 10), est évaluée après celles de Docker. filter est ici le nom de
la priorité de Docker, qui vaut 0, et non celui d'une chaîne.
Le trafic d'un processus de l'hôte vers 127.0.0.1 suit un autre chemin : le
DNAT ne s'applique pas à la boucle locale, et c'est docker-proxy, un processus
de l'hôte, qui reçoit la connexion et en ouvre une autre vers le conteneur. La
leçon Publier un port sans exposer tout
l'hôte enseigne ce
mécanisme. Dans le schéma ci-dessous, le trait épais suit un client externe et
le trait pointillé le processus de l'hôte qui vise 127.0.0.1.
La documentation de Docker sur les règles iptables décrit ces chaînes. Le guide sur le NAT détaille le DNAT et le suivi de connexions du noyau, le guide sur le pare-feu le filtrage en général, et celui sur nftables l'outil qui écrit dans les tables.
Quel pare-feu Docker utilise-t-il vraiment ?
Section intitulée « Quel pare-feu Docker utilise-t-il vraiment ? »Avant de lire des règles, il faut savoir où elles sont. Un hôte peut
exposer la commande iptables tout en écrivant dans nftables, et Docker choisit
son propre moteur de règles. Les commandes suivantes relèvent l'état de l'hôte
avant tout conteneur de la démonstration : la version du moteur, le
pare-feu que Docker annonce, la version d'iptables, toutes les tables
nftables (pas seulement celles de Docker), la chaîne FORWARD, la chaîne
DOCKER-USER, le NAT de Docker et le pont docker0.
docker version --format 'serveur={{.Server.Version}}'docker info --format 'Firewall={{.FirewallBackend.Driver}}'sudo iptables --versionsudo nft list tablessudo iptables -S FORWARDsudo iptables -S DOCKER-USERsudo iptables -t nat -S | grep -E 'DOCKER|MASQUERADE'ip -br addr show docker0docker ps -aq | wc -lserveur=29.9.2Firewall=iptablesiptables v1.8.11 (nf_tables)table ip nattable ip filtertable ip6 nattable ip6 filtertable ip raw-P FORWARD DROP-A FORWARD -j DOCKER-USER-A FORWARD -j DOCKER-FORWARD-N DOCKER-USER-N DOCKER-A PREROUTING -m addrtype --dst-type LOCAL -j DOCKER-A OUTPUT ! -d 127.0.0.0/8 -m addrtype --dst-type LOCAL -j DOCKER-A POSTROUTING -s 172.17.0.0/16 ! -o docker0 -j MASQUERADEdocker0 DOWN 172.17.0.1/160Lisez ces sorties ensemble. Docker annonce le backend iptables, et
iptables est en version nf_tables : les règles sont écrites avec la
syntaxe iptables mais stockées dans nftables, ce que confirment les tables
ip nat et ip filter dans nft list tables. La table ip raw existe déjà
ici, alors qu'aucun conteneur n'a été créé. Un pare-feu d'hôte écrit
directement avec nftables apparaîtrait comme une table supplémentaire dans cette
liste, ce que la section sur le pare-feu de l'hôte met en scène.
Regardez ensuite trois lignes. La politique DROP du crochet FORWARD refuse
tout ce que Docker n'accepte pas explicitement. FORWARD appelle DOCKER-USER
avant DOCKER-FORWARD, et DOCKER-USER, vide ici, est l'endroit prévu pour vos
règles. Dans la table nat, deux règles renvoient vers la chaîne DOCKER :
PREROUTING pour les paquets qui arrivent de l'extérieur, OUTPUT pour ceux
que l'hôte émet lui-même, mais pas ceux qui visent la boucle locale
(127.0.0.0/8). Les ports publiés ajoutent leurs règles DNAT dans cette chaîne
DOCKER.
Une dernière lecture situe Docker par rapport aux autres tables. La commande
suivante affiche les quatre premières lignes de la chaîne FORWARD telle que
nftables la stocke.
sudo nft list chain ip filter FORWARD | sed -n 1,4ptable ip filter { chain FORWARD { type filter hook forward priority filter; policy drop; counter packets 105 bytes 20126 jump DOCKER-USERLa chaîne est branchée au crochet forward avec la priorité filter. Ce mot
est un nom de priorité, qui vaut 0. Une autre table dont la chaîne porte
filter + 10 passe donc après celle de Docker, et filter - 10 passerait
avant. Le nombre de paquets du compteur est celui de la VM de mesure, relevé après
les autres mesures de la leçon, d'où ses 105 paquets : le vôtre sera
différent.
La valeur Firewall=iptables est celle de cet hôte. D'autres valeurs existent
selon la configuration : l'hôte peut utiliser firewalld, et Docker 29 propose un
backend nftables, présenté comme expérimental. Les chaînes et les noms de cette
leçon sont ceux du backend iptables mesuré ici. Si docker info annonce autre
chose chez vous, lisez d'abord la documentation de Docker sur le backend
iptables et sur le
backend nftables
avant de transposer.
Comment sonder un flux à plusieurs sauts ?
Section intitulée « Comment sonder un flux à plusieurs sauts ? »Une panne réseau se localise en testant chaque saut séparément, un saut
étant une étape du chemin entre le client et le service. On commence par le plus
proche de la cible et on remonte vers le plus lointain. Si le saut n répond et
que le saut n+1 échoue, la cause se trouve entre les deux. La démonstration
construit quatre conteneurs sur trois réseaux : c39-m-api et c39-m-voisin
partagent c39-m-front, c39-m-partenaire vit sur son propre réseau,
c39-m-intrus sur un troisième. Seul c39-m-api publie un port, le 8070 de
l'hôte vers son port 80.
La variable HOTE contient l'adresse IPv4 de l'hôte Docker, calculée par la
commande : elle prend la première adresse IPv4 globale de la machine. Si
votre machine en porte plusieurs, vérifiez que c'est la bonne avant de
continuer, sinon les sondes du partenaire et de l'intrus visent la mauvaise
interface.
ALP="alpine:3.24.3@sha256:be2656061b536c1883c4034790e21d0a09c5aaaf51968b89368a3c0371ea2c9a"HOTE=$(ip -4 -o addr show scope global | awk '{print $4}' | cut -d/ -f1 | head -1); echo "HOTE=$HOTE"SRV='while true; do printf "HTTP/1.0 200 OK\r\n\r\napi-c39\n" | nc -l -n -p 80; done'docker network create --subnet 172.31.10.0/24 c39-m-front >/dev/nulldocker network create --subnet 172.31.20.0/24 c39-m-partenaire >/dev/nulldocker network create --subnet 172.31.30.0/24 c39-m-intrus >/dev/nulldocker run -d --name c39-m-api --network c39-m-front -p 8070:80 "$ALP" sh -c "$SRV" >/dev/nulldocker run -d --name c39-m-voisin --network c39-m-front "$ALP" sleep 3600 >/dev/nulldocker run -d --name c39-m-partenaire --network c39-m-partenaire "$ALP" sleep 3600 >/dev/nulldocker run -d --name c39-m-intrus --network c39-m-intrus "$ALP" sleep 3600 >/dev/nulldocker port c39-m-apiLa première ligne affichée est l'adresse de la VM de mesure, la vôtre sera
différente. La commande docker port confirme la publication, sur IPv4 et
IPv6.
HOTE=10.10.130.1180/tcp -> 0.0.0.0:807080/tcp -> [::]:8070Deux questions se posent tout de suite : qui écoute sur le port 8070 de l'hôte, et les conteneurs ont-ils ajouté des tables nftables ? La première commande liste les sockets en écoute sur ce port avec le processus qui les tient, la seconde relit les tables du noyau.
sudo ss -ltnp 'sport = :8070' | tail -n +2 | awk '{print $4, $6}'sudo nft list tables0.0.0.0:8070 users:(("docker-proxy",pid=2407,fd=8))[::]:8070 users:(("docker-proxy",pid=2412,fd=8))table ip nattable ip filtertable ip6 nattable ip6 filtertable ip rawLe port est tenu par deux processus docker-proxy, un en IPv4 (0.0.0.0) et
un en IPv6 (::). Les tables sont les cinq de l'état de départ : aucune table
n'a été ajoutée par les conteneurs. Ce docker-proxy explique pourquoi un test
depuis l'hôte vers 127.0.0.1 ne prouve rien sur un client distant. Il reçoit
la connexion, puis en ouvre une autre vers le conteneur : cette connexion est
émise par l'hôte lui-même, elle ne traverse donc pas FORWARD. Une mesure
complémentaire, faite avec un service qui journalise l'adresse source, le
confirme : par 127.0.0.1, le service voit 172.31.10.1, une adresse du réseau
du conteneur ; par l'adresse de l'hôte, le DNAT s'applique et il voit l'adresse
de l'hôte (10.10.130.11 sur la VM de mesure).
Le premier saut à sonder est le DNS. Sur un réseau défini par
l'utilisateur, Docker fournit un résolveur intégré à l'adresse 127.0.0.11 dans
chaque conteneur. Il ne résout les noms de conteneurs que pour le même
réseau : un nom qui ne se résout pas depuis un autre réseau est le
comportement normal, pas une panne.
docker exec c39-m-voisin cat /etc/resolv.conf | grep nameserverdocker exec c39-m-voisin nslookup c39-m-api 2>&1 | grep -A1 'Name:'docker exec c39-m-partenaire nslookup c39-m-api 2>&1 | tail -2nameserver 127.0.0.11Name: c39-m-apiAddress: 172.31.10.2*** Can't find c39-m-api: No answerLe voisin trouve c39-m-api à l'adresse 172.31.10.2, le partenaire non, car
il est sur un autre réseau. Pour qu'il joigne l'API, il faudra donc passer par
l'adresse de l'hôte et le port publié, pas par le nom. Les sondes suivantes
testent six chemins. La fonction sonde affiche un libellé, le code de retour
(rc=0 si la commande a réussi) et ce que la commande a répondu. Gardez le
même terminal : les sections suivantes réutilisent cette fonction et les
variables ALP, HOTE et SRV.
sonde() { printf '%-30s ' "$1"; shift; out=$("$@" 2>&1); echo "rc=$? ${out}" | tr '\n' ' '; echo; }sonde "hote -> 127.0.0.1:8070" curl -s -m 3 http://127.0.0.1:8070/sonde "hote -> 172.31.10.2:80" curl -s -m 3 http://172.31.10.2/sonde "voisin -> c39-m-api:80" docker exec c39-m-voisin wget -q -T 3 -O - http://c39-m-api/sonde "partenaire -> hote:8070" docker exec c39-m-partenaire wget -q -T 3 -O - "http://$HOTE:8070/"sonde "intrus -> hote:8070" docker exec c39-m-intrus wget -q -T 3 -O - "http://$HOTE:8070/"sonde "partenaire -> internet" docker exec c39-m-partenaire wget -q -T 5 -O /dev/null http://deb.debian.org/debian/hote -> 127.0.0.1:8070 rc=0 api-c39hote -> 172.31.10.2:80 rc=0 api-c39voisin -> c39-m-api:80 rc=0 api-c39partenaire -> hote:8070 rc=0 api-c39intrus -> hote:8070 rc=0 api-c39partenaire -> internet rc=0Avant toute règle, les six sondes réussissent : c'est votre référence. La
dernière affiche rc=0 et rien d'autre, parce que wget écrit dans
/dev/null. Chaque sonde traverse un chemin différent. Le voisin reste sur son
réseau, sans passer par l'hôte. L'hôte vers 127.0.0.1 passe par
docker-proxy. L'hôte vers 172.31.10.2:80 joint directement l'adresse du
conteneur : c'est un saut de plus à tester. Le partenaire et l'intrus
jouent un client distant, parce que leurs paquets traversent le même
crochet FORWARD que ceux d'une machine extérieure. Si une panne apparaît
ensuite, la sonde qui change de résultat désigne le saut fautif.
Pourquoi une règle DOCKER-USER sur le port publié ne bloque-t-elle rien ?
Section intitulée « Pourquoi une règle DOCKER-USER sur le port publié ne bloque-t-elle rien ? »On veut empêcher le réseau c39-m-intrus d'atteindre l'API. La règle évidente
vise le port que l'intrus utilise : le 8070. Elle est écrite dans DOCKER-USER,
la chaîne prévue pour les règles de l'administrateur. L'option -I insère
une règle en tête de chaîne, -A l'ajoute en fin. Le compteur de la règle
(pkts et bytes) indique combien de paquets elle a reconnus : c'est lui qui
dit si elle voit le trafic.
sudo iptables -I DOCKER-USER -s 172.31.30.0/24 -p tcp --dport 8070 -j DROPsonde "intrus -> hote:8070" docker exec c39-m-intrus wget -q -T 3 -O - "http://$HOTE:8070/"sudo iptables -L DOCKER-USER -n -v --line-numbersintrus -> hote:8070 rc=0 api-c39Chain DOCKER-USER (1 references)num pkts bytes target prot opt in out source destination1 0 0 DROP tcp -- * * 172.31.30.0/24 0.0.0.0/0 tcp dpt:8070L'intrus passe toujours, et le compteur reste à 0 0 : la règle n'a jamais
vu un paquet. Un compteur à zéro veut dire que la règle n'a pas vu le paquet,
soit parce que ses critères ne correspondent pas, soit parce qu'une décision a
été prise avant elle. Ici, c'est le premier cas, et la cause se lit dans la
chaîne DOCKER de la table nat.
sudo iptables -t nat -S DOCKER | grep 8070-A DOCKER ! -i br-51693c333467 -p tcp -m tcp --dport 8070 -j DNAT --to-destination 172.31.10.2:80Le DNAT remplace hôte:8070 par 172.31.10.2:80 avant le crochet
FORWARD. Quand le paquet arrive dans DOCKER-USER, son port de destination
est déjà 80 et son adresse celle du conteneur : une règle qui cherche --dport 8070 ne reconnaît plus rien. Le noyau garde pourtant la destination d'origine
dans son suivi de connexions, le conntrack, et l'extension conntrack
d'iptables sait la lire avec --ctorigdstport. L'option --ctdir ORIGINAL
restreint la règle aux paquets qui vont dans le sens de la connexion d'origine,
du client vers le serveur, et non aux réponses. La règle corrigée remplace
l'ancienne, puis on rejoue les sondes.
sudo iptables -D DOCKER-USER -s 172.31.30.0/24 -p tcp --dport 8070 -j DROPsudo iptables -I DOCKER-USER -s 172.31.30.0/24 -p tcp -m conntrack --ctorigdstport 8070 --ctdir ORIGINAL -j DROPsonde "intrus -> hote:8070" docker exec c39-m-intrus wget -q -T 3 -O - "http://$HOTE:8070/"sonde "partenaire -> hote:8070" docker exec c39-m-partenaire wget -q -T 3 -O - "http://$HOTE:8070/"sonde "hote -> 127.0.0.1:8070" curl -s -m 3 http://127.0.0.1:8070/sudo iptables -L DOCKER-USER -n -v --line-numbersintrus -> hote:8070 rc=1 wget: download timed outpartenaire -> hote:8070 rc=0 api-c39hote -> 127.0.0.1:8070 rc=0 api-c39Chain DOCKER-USER (1 references)num pkts bytes target prot opt in out source destination1 3 180 DROP tcp -- * * 172.31.30.0/24 0.0.0.0/0 ctorigdstport 8070 ctdir ORIGINALLes trois sondes forment la preuve. Le test négatif (l'intrus échoue, avec
un download timed out car un DROP ne répond rien) montre que la règle
bloque : la même sonde réussissait avant la règle. Les tests positifs (le
partenaire et l'hôte réussissent) montrent qu'elle ne bloque pas ces deux flux.
Le compteur, passé à 3 paquets, prouve que c'est cette règle qui a refusé,
et non un autre saut. Les trois éléments sont nécessaires : un échec seul peut
venir d'ailleurs.
Le retrait de la règle laisse la chaîne vide. Les conteneurs restent en place pour la suite.
sudo iptables -D DOCKER-USER -s 172.31.30.0/24 -p tcp -m conntrack --ctorigdstport 8070 --ctdir ORIGINAL -j DROPsudo iptables -S DOCKER-USER-N DOCKER-USERQue faire quand le pare-feu de l'hôte bloque Docker ?
Section intitulée « Que faire quand le pare-feu de l'hôte bloque Docker ? »Une règle de DOCKER-USER ne pèse que dans les chaînes de Docker. Si l'hôte a
un pare-feu écrit en nftables, dans une autre table, sa chaîne de base au
crochet FORWARD est évaluée elle aussi, et Docker ne la voit pas. Pour le
reproduire, on pose une table c39_hote (la famille inet couvre IPv4 et IPv6)
dont la chaîne forward a une policy drop : elle refuse tout paquet
qu'aucune règle n'accepte, sauf les réponses aux connexions déjà établies. Une
dernière règle counter drop refuse de la même façon, avec un compteur qui
montre combien de paquets arrivent jusque-là. La priorité est le nombre qui
ordonne les chaînes de base d'un même crochet, les plus basses d'abord. Avec
filter + 10, la chaîne passe donc après celles de Docker, dont la priorité
est filter, comme l'a montré la lecture de nft list chain ip filter FORWARD.
La démonstration reprend la topologie de la section précédente. Posez la table de l'hôte, puis sondez l'hôte lui-même, le partenaire vers l'API et le partenaire vers internet.
cat > c39-hote.nft <<'EOF'table inet c39_hote { chain forward { type filter hook forward priority filter + 10; policy drop; ct state established,related accept counter drop }}EOFsudo nft -f c39-hote.nft; echo "nft_rc=$?"sonde "hote -> 127.0.0.1:8070" curl -s -m 3 http://127.0.0.1:8070/sonde "partenaire -> hote:8070" docker exec c39-m-partenaire wget -q -T 3 -O - "http://$HOTE:8070/"sonde "partenaire -> internet" docker exec c39-m-partenaire wget -q -T 5 -O /dev/null http://deb.debian.org/debian/nft_rc=0hote -> 127.0.0.1:8070 rc=0 api-c39partenaire -> hote:8070 rc=1 wget: download timed outpartenaire -> internet rc=1 wget: download timed outC'est le piège : l'hôte répond à lui-même, le partenaire n'obtient rien, et le
test local masque la panne parce que le trafic de 127.0.0.1 ne traverse pas
FORWARD. Le partenaire n'atteint plus non plus internet, alors que la sonde de
référence réussissait. Demandez maintenant à Docker s'il signale un problème, et
relisez toutes les tables.
docker info --format 'Firewall={{.FirewallBackend.Driver}}'sudo iptables -S DOCKER-USERsudo nft list tablesFirewall=iptables-N DOCKER-USERtable ip nattable ip filtertable ip6 nattable ip6 filtertable ip rawtable inet c39_hoteDocker annonce son backend habituel, et DOCKER-USER ne contient aucune règle :
rien côté Docker ne signale le refus. Le refus vient d'une table que Docker
ne gère pas, et seule la lecture de toutes les tables la révèle : la table
inet c39_hote apparaît à côté de celles de Docker.
Reste l'idée de contourner le problème depuis le côté de Docker, en acceptant le
flux dans DOCKER-USER. Elle échoue : chaque chaîne de base du crochet rend son
propre verdict. Un accept ne termine que la chaîne qui le prononce, un
drop arrête le paquet : celui d'une autre table l'emporte donc sur un
ACCEPT de DOCKER-USER. Une mesure, à la fin de cette section, le vérifie. La
correction se fait donc dans la table de l'hôte, par une règle qui n'accepte que
ce flux : la destination après DNAT (172.31.10.2, port 80), restreinte au port
d'origine 8070 par ct original proto-dst, l'équivalent nftables de
--ctorigdstport. Le mot-clé counter ajoute un compteur à la règle.
Où la poser ? nft add rule ajoute en fin de chaîne, donc après le
counter drop. L'option -a de nft list affiche le handle de chaque
règle, son identifiant dans la chaîne.
sudo nft add rule inet c39_hote forward ip daddr 172.31.10.2 tcp dport 80 ct original proto-dst 8070 counter acceptsonde "partenaire -> hote:8070" docker exec c39-m-partenaire wget -q -T 3 -O - "http://$HOTE:8070/"sudo nft -a list chain inet c39_hote forwardpartenaire -> hote:8070 rc=1 wget: download timed outtable inet c39_hote { chain forward { # handle 1 type filter hook forward priority filter + 10; policy drop; ct state established,related accept # handle 2 counter packets 11 bytes 660 drop # handle 3 ip daddr 172.31.10.2 tcp dport 80 ct original proto-dst 8070 counter packets 0 bytes 0 accept # handle 4 }}Le flux reste coupé et la règle ciblée (handle 4) compte 0 packets : elle n'a
pas vu le paquet, non parce que ses critères sont faux, mais parce que le
counter drop (handle 3), placé avant elle, a déjà décidé. Son compteur
(11 packets) le confirme. L'ordre des règles compte autant que leur contenu.
nft insert rule … position <handle> insère avant la règle visée. La
commande suivante supprime la règle par son handle (lu dans le listing), puis la
réinsère avant le counter drop, dont elle lit aussi le handle.
H=$(sudo nft -a list chain inet c39_hote forward | awk '/proto-dst 8070/{print $NF}')sudo nft delete rule inet c39_hote forward handle "$H"sudo nft insert rule inet c39_hote forward position "$(sudo nft -a list chain inet c39_hote forward | awk '/counter packets .* drop/{print $NF}')" ip daddr 172.31.10.2 tcp dport 80 ct original proto-dst 8070 counter acceptsudo nft -a list chain inet c39_hote forwardsonde "partenaire -> hote:8070" docker exec c39-m-partenaire wget -q -T 3 -O - "http://$HOTE:8070/"sonde "partenaire -> internet" docker exec c39-m-partenaire wget -q -T 5 -O /dev/null http://deb.debian.org/debian/sudo nft list chain inet c39_hote forward | grep countertable inet c39_hote { chain forward { # handle 1 type filter hook forward priority filter + 10; policy drop; ct state established,related accept # handle 2 ip daddr 172.31.10.2 tcp dport 80 ct original proto-dst 8070 counter packets 0 bytes 0 accept # handle 5 counter packets 11 bytes 660 drop # handle 3 }}partenaire -> hote:8070 rc=0 api-c39partenaire -> internet rc=1 wget: download timed out ip daddr 172.31.10.2 tcp dport 80 ct original proto-dst 8070 counter packets 1 bytes 60 accept counter packets 16 bytes 960 dropLa règle (handle 5) se trouve maintenant avant le refus. Le partenaire joint
l'API (test positif), et le compteur de la règle est passé de zéro à 1 paquet,
le premier de la connexion : les suivants relèvent de la règle
established,related. C'est donc cette règle qui a rétabli le flux.
Le test négatif compte autant : le partenaire n'atteint toujours pas internet,
et le compteur du refus est passé de 11 à 16 paquets, ce qui indique que ce flux
voisin reste fermé. Il prouve quelque chose parce que cette sonde avait une
référence : elle réussissait avant la pose de la table (rc=0 dans les sondes
de référence) et elle réussit de nouveau après son retrait. Sans cette
référence, un échec ne prouve rien, et avec un pare-feu désactivé pour tester,
la sonde ne dirait plus si le reste est resté fermé.
On supprime ensuite la table de test, et la sonde vers internet confirme que le flux est rétabli.
sudo nft delete table inet c39_hote; echo "delete_rc=$?"rm -f c39-hote.nftsonde "partenaire -> internet" docker exec c39-m-partenaire wget -q -T 5 -O /dev/null http://deb.debian.org/debian/sudo nft list tablesdelete_rc=0partenaire -> internet rc=0table ip nattable ip filtertable ip6 nattable ip6 filtertable ip rawReste à mesurer l'idée écartée plus haut : un ACCEPT dans DOCKER-USER,
face à un drop d'une autre table. Cette vérification complémentaire refait en
miniature la topologie et la table de la démonstration, sous les mêmes
noms : elle ne se joue donc pas par-dessus ces objets. Retirez d'abord la
topologie, puis jouez les trois blocs suivants, qui se terminent par leur propre
retrait.
docker rm -f c39-m-api c39-m-voisin c39-m-partenaire c39-m-intrus >/dev/nulldocker network rm c39-m-front c39-m-partenaire c39-m-intrus >/dev/nullLe bloc suivant recrée deux réseaux et deux conteneurs, puis charge la même table de l'hôte, avec sa policy drop. Il n'affiche rien.
docker network create --subnet 172.31.10.0/24 c39-m-front >/dev/nulldocker network create --subnet 172.31.20.0/24 c39-m-partenaire >/dev/nulldocker run -d --name c39-m-api --network c39-m-front -p 8070:80 "$ALP" sh -c "$SRV" >/dev/nulldocker run -d --name c39-m-partenaire --network c39-m-partenaire "$ALP" sleep 600 >/dev/nullsleep 1cat > c39-hote.nft <<'EOF'table inet c39_hote { chain forward { type filter hook forward priority filter + 10; policy drop; ct state established,related accept counter drop }}EOFsudo nft -f c39-hote.nftLa règle ACCEPT ci-dessous vise le flux du port 8070 d'origine, sans
restriction de source : c'est un essai. Quatre commandes suivent. La première
l'insère, la deuxième sonde l'API depuis le partenaire, les deux dernières
relèvent le compteur de la règle (sed -n 3p garde la ligne de la règle) et
celui du counter drop de l'hôte.
sudo iptables -I DOCKER-USER -p tcp -m conntrack --ctorigdstport 8070 --ctdir ORIGINAL -j ACCEPTsonde "partenaire -> hote:8070" docker exec c39-m-partenaire wget -q -T 3 -O - "http://$HOTE:8070/"sudo iptables -L DOCKER-USER -n -v | sed -n 3psudo nft list chain inet c39_hote forward | grep counterpartenaire -> hote:8070 rc=1 wget: download timed out 3 180 ACCEPT tcp -- * * 0.0.0.0/0 0.0.0.0/0 ctorigdstport 8070 ctdir ORIGINAL counter packets 3 bytes 180 dropLisez les deux compteurs ensemble. Le ACCEPT de DOCKER-USER a vu 3 paquets
(180 octets) et les a acceptés : la règle fonctionne. Le counter drop de la
table de l'hôte compte lui aussi 3 paquets (180 octets), et le partenaire
échoue (rc=1). L'acceptation de DOCKER-USER n'arrête pas les autres
chaînes de base du crochet FORWARD : la table de l'hôte juge ensuite le
trafic et le refuse. Corriger côté Docker ne change donc rien, et le compteur du refus
indique où le flux s'arrête.
Le dernier bloc retire la règle, la table, le fichier, les deux conteneurs et
les deux réseaux. Il affiche la chaîne DOCKER-USER, vide, puis le nombre de
tables dont le nom contient c39.
sudo iptables -D DOCKER-USER -p tcp -m conntrack --ctorigdstport 8070 --ctdir ORIGINAL -j ACCEPTsudo nft delete table inet c39_hoterm -f c39-hote.nftdocker rm -f c39-m-api c39-m-partenaire >/dev/nulldocker network rm c39-m-front c39-m-partenaire >/dev/nullsudo iptables -S DOCKER-USER; sudo nft list tables | grep -c c39 || true-N DOCKER-USER0Pourquoi un paquet direct vers le conteneur laisse-t-il DOCKER-USER à zéro ?
Section intitulée « Pourquoi un paquet direct vers le conteneur laisse-t-il DOCKER-USER à zéro ? »Un compteur à zéro dans DOCKER-USER ne prouve pas toujours que la règle est
mal écrite : le paquet peut avoir été jeté avant d'arriver à FORWARD.
Docker tient en effet une table ip raw, dont la chaîne PREROUTING est
évaluée avant le suivi de connexions (priorité raw). La commande suivante la
lit avant tout conteneur, puis après la publication d'un port. Le bloc crée
deux objets sous les mêmes noms que la démonstration, qui est déjà retirée à ce
stade, et se termine par leur retrait.
sudo nft list table ip rawdocker network create --subnet 172.31.10.0/24 c39-m-front >/dev/nulldocker run -d --name c39-m-api --network c39-m-front -p 8070:80 "$ALP" sleep 300 >/dev/nullsudo nft list table ip rawdocker rm -f c39-m-api >/dev/nulldocker network rm c39-m-front >/dev/nulltable ip raw { chain PREROUTING { type filter hook prerouting priority raw; policy accept; }}table ip raw { chain PREROUTING { type filter hook prerouting priority raw; policy accept; ip daddr 172.31.10.2 iifname != "br-9a32a59791d5" counter packets 0 bytes 0 drop }}Avant tout conteneur, la chaîne est vide. Avec un conteneur, Docker y ajoute
une règle qui jette tout paquet destiné à l'adresse du conteneur (172.31.10.2)
et qui n'arrive pas par le pont de son réseau (br-…, dont le nom change à
chaque réseau). Sur la VM de mesure, un conteneur sans port publié en a reçu
une aussi. Un client qui vise directement l'adresse du conteneur sans
passer par le pont est donc refusé au crochet prerouting. Mesuré avec le
conteneur partenaire, sur un autre réseau, qui vise 172.31.10.2 au lieu du
port publié : la requête expire, le compteur de cette règle passe à 3 paquets
et DOCKER-USER, vide, n'a rien vu. Pour diagnostiquer un tel flux, lisez le
compteur de la règle de la table ip raw.
Ces règles survivent-elles à un redémarrage ?
Section intitulée « Ces règles survivent-elles à un redémarrage ? »Non. Les règles posées avec iptables -I et avec nft add ou nft insert
vivent en mémoire : elles disparaissent au redémarrage de la machine. C'est
pratique pour un essai, et insuffisant pour une correction durable. Pour écrire
une règle qui persiste, voir le guide Configurer un pare-feu avec
nftables et, pour choisir l'outil,
Pare-feu Linux : comprendre avant de
configurer.
Comment revenir en arrière en urgence ?
Section intitulée « Comment revenir en arrière en urgence ? »Si une sonde se fige ou si vous perdez l'accès à internet depuis un conteneur,
retirez tout ce que la leçon a posé : les deux règles de DOCKER-USER (celle
de la section sur le port publié et l'ACCEPT de la vérification
complémentaire), la table de l'hôte et son fichier, la topologie, puis les
objets de la mesure de MTU.
sudo iptables -D DOCKER-USER -s 172.31.30.0/24 -p tcp -m conntrack --ctorigdstport 8070 --ctdir ORIGINAL -j DROPsudo iptables -D DOCKER-USER -p tcp -m conntrack --ctorigdstport 8070 --ctdir ORIGINAL -j ACCEPTsudo nft delete table inet c39_hoterm -f c39-hote.nftdocker rm -f c39-m-api c39-m-voisin c39-m-partenaire c39-m-intrus >/dev/nulldocker network rm c39-m-front c39-m-partenaire c39-m-intrus >/dev/nulldocker rm -f c39-m-a c39-m-b >/dev/nulldocker network rm c39-m-std c39-m-reduit >/dev/nullUne commande qui vise un objet déjà retiré répond par une erreur (règle, table, conteneur ou réseau introuvable) sans conséquence : passez à la suivante. Ces règles ne survivent pas à un redémarrage, mais attendre un redémarrage pour les effacer laisse la panne en place jusque-là. La table en policy drop coupe le trafic routé de l'hôte que ses règles n'acceptent pas, tant qu'elle est en place : la mesure l'a montré pour l'accès à internet depuis un conteneur.
Comment repérer un problème de MTU ?
Section intitulée « Comment repérer un problème de MTU ? »La MTU (Maximum Transmission Unit) est la taille maximale d'un paquet qu'une interface accepte d'envoyer. Chaque saut a la sienne : l'interface de l'hôte, le pont du réseau Docker, l'interface du conteneur. L'écart pose problème dans un sens précis : quand la MTU d'un conteneur est plus grande que celle d'un saut du chemin et que l'ICMP est filtré, la découverte de la MTU du chemin (PMTUD) ne fonctionne plus. Le symptôme typique est une connexion qui s'établit, puis des gros transferts qui se figent. Le guide sur MTU, MSS et PMTUD détaille ce mécanisme.
La démonstration ne reproduit pas ce symptôme : elle apprend à lire la MTU
à chaque saut et à la sonder. L'option com.docker.network.driver.mtu fixe la
MTU d'un réseau Docker : on en crée un à 1400 pour la mesure, à côté d'un réseau
standard. La topologie des sections précédentes est déjà retirée : la
vérification complémentaire s'est terminée par son retrait. Les deux commandes
suivantes le contrôlent.
docker ps -aq --filter name=c39-m- | wc -lsudo nft list tables0table ip nattable ip filtertable ip6 nattable ip6 filtertable ip rawAucun conteneur ne reste, et les tables sont celles de l'état de départ. La
commande suivante calcule l'interface de l'hôte (IFACE, celle de la route par
défaut), lit sa MTU, crée les deux réseaux et deux conteneurs, puis lit la MTU
de leur interface eth0.
IFACE=$(ip -4 route show default | awk '{print $5}' | head -1); echo "IFACE=$IFACE"ip -o link show "$IFACE" | grep -o 'mtu [0-9]*'docker network create --subnet 172.31.40.0/24 c39-m-std >/dev/nulldocker network create --subnet 172.31.50.0/24 -o com.docker.network.driver.mtu=1400 c39-m-reduit >/dev/nulldocker run -d --name c39-m-a --network c39-m-std "$ALP" sleep 300 >/dev/nulldocker run -d --name c39-m-b --network c39-m-reduit "$ALP" sleep 300 >/dev/nullfor c in c39-m-a c39-m-b; do printf '%s eth0 : ' "$c"; docker exec "$c" ip -o link show eth0 | grep -o 'mtu [0-9]*'; doneIFACE=enp1s0mtu 1500c39-m-a eth0 : mtu 1500c39-m-b eth0 : mtu 1400Lisez la MTU à chaque saut : l'interface de l'hôte est à 1500, le conteneur
du réseau standard aussi, et celui du réseau c39-m-reduit à 1400, valeur de
l'option. Un écart entre deux sauts d'un même chemin est le premier indice. Pour
le confirmer, on envoie depuis l'hôte un ping dont le bit DF (Don't
Fragment) est activé par -M do : le paquet ne doit pas être fragmenté, donc il
échoue s'il dépasse la MTU d'un saut. Avec -s, on fixe la taille des données ;
l'en-tête IP et l'en-tête ICMP ajoutent 28 octets, et 1472 octets de données
font donc un paquet de 1500. Ce ping est celui d'iputils, installé sur
l'hôte : celui de BusyBox, dans l'image Alpine, n'a pas l'option -M.
ping -c1 -W2 -M do -s 1472 172.31.40.2 | grep -E 'bytes from|transmitted'ping -c1 -W2 -M do -s 1472 172.31.50.2 2>&1 | grep -E 'too long|transmitted'ping -c1 -W2 -M do -s 1372 172.31.50.2 | grep -E 'bytes from|transmitted'1480 bytes from 172.31.40.2: icmp_seq=1 ttl=64 time=0.047 ms1 packets transmitted, 1 received, 0% packet loss, time 0msping: sendmsg: Message too long1 packets transmitted, 0 received, +1 errors, 100% packet loss, time 0ms1380 bytes from 172.31.50.2: icmp_seq=1 ttl=64 time=0.043 ms1 packets transmitted, 1 received, 0% packet loss, time 0msLe réseau à 1500 laisse passer le paquet de 1500 octets. Le réseau à 1400 refuse
le même paquet avec Message too long, et accepte un paquet de 1400 octets
(1372 de données). La taille affichée par ping, 1480, compte les données et
les 8 octets de l'en-tête ICMP, sans l'en-tête IP. En cherchant la plus grande
taille qui passe, on obtient la MTU effective du chemin. Cette mesure sonde le
chemin entre l'hôte et le conteneur, par le pont. Un tunnel ou un VPN situé plus
loin se sonde de la même manière, avec une cible au-delà du tunnel, mais cette
leçon ne l'a pas mesuré. Le guide sur ICMP,
le protocole qui porte le ping, détaille cette notion.
Le nettoyage retire les deux conteneurs et les deux réseaux de cette section.
docker rm -f c39-m-a c39-m-b >/dev/nulldocker network rm c39-m-std c39-m-reduit >/dev/nulldocker network ls --format '{{.Name}}' | grep -c '^c39-m-' || true0Dépannage
Section intitulée « Dépannage »Chaque ligne relie un symptôme que vous observez à sa cause probable, à la vérification qui la confirme et à la correction la plus ciblée. Quand un symptôme ne correspond à aucune ligne, revenez à la méthode : une sonde par saut, un compteur par règle.
| Symptôme | Cause | Vérification | Correction |
|---|---|---|---|
Une règle DOCKER-USER sur --dport d'un port publié ne bloque rien | Le DNAT a déjà remplacé le port : la chaîne voit le port du conteneur | Compteur de la règle à 0 0 après un test | Filtrer avec -m conntrack --ctorigdstport et rejouer les sondes |
| L'hôte joint le port publié, un client distant non | Une autre table nftables, avec une policy drop au crochet forward, refuse le trafic routé | sudo nft list tables, puis sudo nft list chain de chaque table inconnue | Ajouter une règle ciblée dans cette table, puis tester un flux voisin qui doit rester fermé |
Une règle nft add est en place, son compteur reste à zéro et le flux est coupé | Un refus placé avant elle dans la chaîne a déjà décidé | sudo nft -a list chain : l'ordre et les handles | sudo nft insert rule … position <handle> avant la règle de refus |
Un paquet vers l'adresse du conteneur est refusé et les compteurs de DOCKER-USER restent à zéro | Docker jette au crochet prerouting, dans la table ip raw, les paquets destinés au conteneur qui n'arrivent pas par son pont | sudo nft list table ip raw : la règle drop avec iifname != et son compteur | Passer par le port publié ou par le réseau du conteneur, pas par son adresse depuis l'extérieur du pont |
ACCEPT dans DOCKER-USER sans effet | Une chaîne de base d'une autre table décide aussi | Le client échoue malgré l'ACCEPT, et sudo nft list tables montre une autre table | Corriger dans la table qui refuse, pas dans DOCKER-USER |
| Un nom de conteneur ne se résout pas | Le client est sur un autre réseau que la cible | nslookup depuis un conteneur du même réseau, puis depuis l'autre | Utiliser l'adresse de l'hôte et le port publié, ou rejoindre le même réseau |
| La connexion s'établit, mais les gros transferts se figent | La MTU du conteneur est plus grande que celle d'un saut du chemin, et l'ICMP filtré empêche la découverte | ip -o link show à chaque saut, puis ping -M do | Aligner la MTU du réseau avec com.docker.network.driver.mtu |
failed to create endpoint […] on network bridge: adding interface […] to bridge docker0 failed: Device does not exist | Le module bridge a été retiré, par exemple par modprobe -r br_netfilter, qui retire aussi ses dépendances inutilisées : docker0 a disparu | Le message cite docker0 | sudo systemctl restart docker, qui recrée docker0 |
La dernière ligne ne concerne pas le pare-feu. Elle apparaît quand on
décharge un module du noyau à la main pendant des essais : modprobe -r br_netfilter, le module qui soumet le trafic des ponts aux règles netfilter, a
aussi retiré le module bridge, dont dépendait docker0. Le réseau bridge
par défaut restait cassé, jusqu'au redémarrage de Docker.
Mettre en pratique
Section intitulée « Mettre en pratique »Le lab fait réparer un flux routé dans l'espace de noms réseau d'un conteneur routeur : une règle de son pare-feu interne bloque le flux métier, et vous la localisez par des sondes à chaque saut avant de conclure à une panne de routage ou de service. Vous corrigez seulement ce flux, en conservant les exclusions qui doivent rester en place. Les tests mesurent l'état réel : la réponse du service arrive, les sondes négatives échouent toujours et font monter les compteurs de refus, et le résultat tient quand l'ensemble est recréé depuis sa déclaration. Retirer tout le pare-feu fait échouer ces tests.
Un indice pour la localisation : les tables d'un conteneur doté de NET_ADMIN
vivent dans son propre espace de noms réseau, donc sudo nft list tables sur
l'hôte ne les montre pas, alors que docker exec <conteneur> nft list ruleset
les lit.
À retenir
Section intitulée « À retenir »On localise le saut fautif avec des sondes et des compteurs, on corrige une règle, et on le prouve par des tests positifs et négatifs.
- Vous savez qu'un paquet vers un port publié est réécrit par le DNAT, puis
traverse
FORWARD:DOCKER-USERd'abord,DOCKER-FORWARDensuite, puis les autres tables nftables de l'hôte, dont la priorité dépassefilter. - Vous savez qu'un test depuis l'hôte vers
127.0.0.1passe pardocker-proxy, ne traverse pasFORWARDet ne prouve pas qu'un client distant passe. - Vous lisez
docker infopour le backend de pare-feu etsudo nft list tablespour toutes les tables, pas seulement celles de Docker. - Vous sondez un flux saut par saut : un nom ne se résout que sur le réseau
commun avec la cible, et la MTU se lit à chaque saut avec
ping -M do. - Vous lisez le compteur d'une règle : à zéro après un test, elle n'a pas vu le paquet, parce que ses critères ne correspondent pas ou parce qu'une décision a été prise avant elle.
- Vous filtrez un port publié avec
--ctorigdstport, parce que la chaîne voit la destination après DNAT. - Vous savez qu'un
ACCEPTdansDOCKER-USERn'annule pas undropd'une autre table, qu'une règlenftse place avecinsert … positionavant le refus, et que ces règles ne survivent pas à un redémarrage. - Vous ne désactivez jamais le pare-feu pour tester : un test négatif qui échoue encore, avec une référence mesurée avant, montre que le reste est resté fermé.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que vous savez prédire ce que voit une règle, localiser le pare-feu qui refuse et prouver une correction.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Retrouver des données orphelines sans tout effacer
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications