Une startup avec trois développeurs et un seul service n'a pas besoin de la même architecture de pipeline qu'une banque avec 200 équipes et des centaines de microservices. Le premier cas se pilote avec une pipeline unique qui construit, teste et déploie ; le second exige de découper les dépôts, de détecter les changements et de coordonner des dizaines de pipelines. Il n'existe pas de « meilleure » pipeline, seulement celle qui correspond à votre contexte.
Ce guide présente les grandes familles d'architectures de pipelines et leurs compromis : stratégies de branches, monorepo vs polyrepo, promotion vs rebuild et séparation application/infrastructure. L'objectif est de vous donner les critères pour choisir la vôtre ou la faire évoluer.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Choisir entre pipeline par branche (GitFlow) et trunk-based selon votre cadence
- Comparer monorepo, polyrepo et stratégie hybride
- Appliquer la promotion d'artefact plutôt que la reconstruction
- Séparer pipeline applicative et pipeline infrastructure, puis les coordonner
- Reconnaître les formes avancées : diamant, matrice, conditions
Avant de commencer : de quoi parle-t-on ?
Section intitulée « Avant de commencer : de quoi parle-t-on ? »Quand on parle d'« architecture de pipeline », on parle de comment organiser l'ensemble de vos pipelines, pas du contenu d'une seule pipeline. Les questions clés sont :
- Combien de pipelines avez-vous ? Une seule pour tout ? Une par service ? Une par branche ?
- Comment se déclenchent-elles ? À chaque commit ? Seulement sur certaines branches ?
- Comment les artefacts circulent-ils ? Reconstruits à chaque étape ? Promus d'un environnement à l'autre ?
Ces choix dépendent de trois facteurs principaux :
| Facteur | Questions à se poser |
|---|---|
| Structure d'équipe | Combien de développeurs ? Combien d'équipes ? Travaillent-elles sur le même code ? |
| Stratégie de branches | Utilisez-vous GitFlow avec plusieurs branches longues ? Ou tout le monde travaille sur main ? |
| Modèle de déploiement | Déployez-vous une fois par mois ou 50 fois par jour ? Avez-vous plusieurs versions en production ? |
Stratégies de branches : comment organiser votre code
Section intitulée « Stratégies de branches : comment organiser votre code »La façon dont vous organisez vos branches Git influence directement la structure de vos pipelines. Deux grandes philosophies s'opposent.
Pipeline par branche (approche GitFlow)
Section intitulée « Pipeline par branche (approche GitFlow) »Le principe : vous maintenez plusieurs branches « longues » qui vivent en parallèle pendant des semaines ou des mois. Chaque branche a un rôle précis et sa propre pipeline.

Comment ça fonctionne concrètement :
- Les développeurs travaillent sur des branches
feature/*(nouvelles fonctionnalités) - Ces branches sont mergées dans
develop, une branche d'intégration - Quand on prépare une release, on crée une branche
release/X.Y - Après validation, la release est mergée dans
main(production) - Chaque branche longue a sa propre pipeline avec des comportements différents
Exemple de configuration :
| Branche | Ce que fait la pipeline |
|---|---|
feature/* | Tests unitaires, lint, analyse statique |
develop | Tests + déploiement en environnement de développement |
release/* | Tests complets + déploiement en staging + tests d'acceptance |
main | Déploiement en production (souvent avec approbation manuelle) |
Avantages :
- Séparation claire : chaque environnement correspond à une branche, c'est facile à comprendre
- Contrôle fin : vous décidez exactement ce qui va en production et quand
- Versions parallèles : vous pouvez maintenir plusieurs versions en production (1.0, 1.1, 2.0)
Inconvénients :
- Complexité : plusieurs pipelines à maintenir, qui peuvent diverger
- Merges douloureux : plus les branches vivent longtemps, plus les conflits sont nombreux
- Délai : entre l'écriture du code et sa mise en production, il peut se passer des semaines
Contexte idéal : équipes avec des cycles de release planifiés (tous les mois, tous les trimestres), produits avec plusieurs versions supportées en parallèle (logiciels installés chez les clients, applications mobiles).
Trunk-based development : tout sur une seule branche
Section intitulée « Trunk-based development : tout sur une seule branche »Le principe : tout le monde travaille directement sur la branche principale
(main ou trunk). Les branches de fonctionnalité existent, mais elles sont
très courtes, quelques heures, pas quelques jours.
Comment ça fonctionne concrètement :
- Un développeur crée une branche
feature/xxxdepuismain - Il travaille quelques heures (rarement plus d'une journée)
- Il ouvre une pull request, qui est revue rapidement
- Dès que c'est mergé dans
main, la pipeline se déclenche - Si tous les tests passent, le code peut partir en production automatiquement
La clé : les feature flags
Comment déployer du code en production s'il n'est pas terminé ? Grâce aux feature flags (ou « feature toggles »), des interrupteurs dans le code qui activent ou désactivent une fonctionnalité.
# Exemple simplifié de feature flagif feature_flags.is_enabled("nouvelle_interface_paiement"): afficher_nouvelle_interface()else: afficher_ancienne_interface()Le code est en production, mais la fonctionnalité est « éteinte ». Quand elle est prête, on l'active pour quelques utilisateurs (canary), puis pour tout le monde.
Avantages :
- Intégration continue vraie : le code est intégré plusieurs fois par jour, pas une fois par semaine
- Pas de « merge hell » : les branches courtes = peu de conflits
- Feedback rapide : vous savez en quelques heures si votre code fonctionne avec celui des autres
Inconvénients :
- Discipline stricte : chaque commit sur
maindoit être de qualité production - Feature flags obligatoires : infrastructure supplémentaire à gérer
- Couverture de tests excellente requise : sans tests fiables, c'est le chaos
Contexte idéal : équipes matures pratiquant le continuous deployment, produits SaaS où une seule version est en production.
Comparaison : quelle approche choisir ?
Section intitulée « Comparaison : quelle approche choisir ? »Le tableau confronte les deux modèles ligne par ligne. La ligne décisive est la fréquence de merge : c'est elle qui détermine tout le reste. Des merges espacés de plusieurs jours entraînent mécaniquement des branches longues, donc des conflits, donc un besoin de tests moins pressant ; des merges pluriquotidiens imposent les feature flags et une couverture de tests solide. Lisez d'abord cette ligne, puis descendez.
| Aspect | Pipeline par branche (GitFlow) | Trunk-based |
|---|---|---|
| Fréquence de merge | Jours ou semaines | Heures |
| Nombre de pipelines | Multiple (une par type de branche) | Une seule |
| Feature flags | Optionnels | Obligatoires |
| Risque de conflit Git | Élevé (branches longues) | Faible (branches courtes) |
| Temps jusqu'à la production | Jours ou semaines | Minutes ou heures |
| Complexité de la pipeline | Moyenne à élevée | Simple |
| Besoin en tests | Important | Critique |
Comment choisir ?
- Vous livrez une fois par mois ou moins → GitFlow est acceptable
- Vous livrez plusieurs fois par semaine → considérez trunk-based
- Vous avez plusieurs versions en production → GitFlow est souvent nécessaire
- Vous faites du SaaS avec une seule version → trunk-based est plus adapté
Monorepo vs polyrepo : où mettre votre code
Section intitulée « Monorepo vs polyrepo : où mettre votre code »Au-delà des branches, une autre question structure vos pipelines : combien de dépôts Git avez-vous ?
Monorepo : tout dans un seul dépôt
Section intitulée « Monorepo : tout dans un seul dépôt »Le principe : tous vos services, bibliothèques et outils partagent le même dépôt Git. Google, Meta et Microsoft utilisent cette approche pour une grande partie de leur code.
monorepo/├── services/│ ├── api/ # Service backend│ ├── frontend/ # Application web│ └── worker/ # Traitement asynchrone├── libs/│ ├── auth/ # Bibliothèque d'authentification│ └── utils/ # Utilitaires partagés└── infra/ ├── terraform/ # Infrastructure as Code └── k8s/ # Manifests KubernetesLe défi : ne pas tout reconstruire à chaque commit
Si quelqu'un modifie le README du frontend, inutile de reconstruire l'API. La pipeline doit être « intelligente » et détecter ce qui a changé.
Commit modifie : services/api/src/users.py
Pipeline analyse les dépendances :  ✓ services/api        → rebuild (fichier modifié)  ✓ libs/auth           → vérifier (l'API l'utilise peut-être)  ✗ services/frontend   → skip (pas impacté)  ✗ services/worker     → skip (pas impacté)
Avantages :
- Refactoring atomique : une seule PR peut modifier l'API, le frontend et les libs, tout reste cohérent
- Partage de code naturel : les bibliothèques communes sont dans le même repo, pas besoin de les publier
- Cohérence des versions : tous les services utilisent la même version des libs
Inconvénients :
- Pipeline complexe : détecter ce qui a changé demande de l'outillage (Nx, Turborepo, Bazel)
- Temps de clone élevé : le repo peut devenir très gros
- Permissions compliquées : difficile de restreindre l'accès à certaines parties
Outils courants pour monorepo :
| Outil | Langage/Écosystème | Point fort |
|---|---|---|
| Nx | JavaScript/TypeScript | Excellent pour les projets frontend |
| Turborepo | JavaScript/TypeScript | Simple, rapide, cache distribué |
| Bazel | Polyglotte | Très puissant, mais courbe d'apprentissage raide |
| Pants | Python, Go, Java | Bonne alternative à Bazel |
Polyrepo : un dépôt par service
Section intitulée « Polyrepo : un dépôt par service »Le principe : chaque service, chaque bibliothèque a son propre dépôt Git et sa propre pipeline.
github.com/acme/api # Son propre repo, sa propre pipelinegithub.com/acme/frontend # Idemgithub.com/acme/worker # Idemgithub.com/acme/libs-auth # Publié comme package (npm, PyPI...)github.com/acme/infra # Terraform séparéAvantages :
- Pipeline simple : chaque repo a une pipeline qui fait toujours la même chose
- Équipes autonomes : l'équipe API peut déployer sans attendre l'équipe frontend
- Permissions claires : facile de donner accès à un repo sans exposer le reste
Inconvénients :
- Coordination des versions : l'API v2.3 est-elle compatible avec le frontend v1.8 ?
- Duplication : la configuration de pipeline est souvent copiée-collée entre repos
- Refactoring pénible : modifier une interface partagée = plusieurs PRs dans plusieurs repos
Le problème du « dependency hell » :
En polyrepo, les bibliothèques partagées sont publiées comme des packages (npm, PyPI, Maven...). Cela crée des questions :
- Quand
libs-authpublie une nouvelle version, qui la met à jour dans chaque service ? - Comment s'assurer que tous les services sont compatibles ?
- Que faire si un service est bloqué sur une vieille version ?
Stratégie hybride : le meilleur des deux mondes ?
Section intitulée « Stratégie hybride : le meilleur des deux mondes ? »Peu d'organisations sont 100 % monorepo ou 100 % polyrepo. La plupart tranchent type de code par type de code : les services métier gagnent au regroupement, tandis que l'infrastructure et les bibliothèques diffusées largement suivent des cycles de vie assez différents pour justifier leur propre dépôt. Le tableau suivant résume ce découpage courant.
| Type de code | Stratégie | Pourquoi |
|---|---|---|
| Services métier | Monorepo | Refactoring atomique, cohérence |
| Infrastructure | Repo séparé | Cycle de vie différent, permissions distinctes |
| Libs très partagées | Repos séparés + versioning | Réutilisation hors de l'organisation |
Exemple concret :
github.com/acme/platform # Monorepo : API + frontend + workersgithub.com/acme/infra # Séparé : Terraform, secretsgithub.com/acme/design-system # Séparé : composants UI réutilisables, versionnésPromotion vs rebuild : que déployer exactement ?
Section intitulée « Promotion vs rebuild : que déployer exactement ? »Une question cruciale que beaucoup d'équipes négligent : l'artefact que vous déployez en production est-il le même que celui que vous avez testé ?
Le problème du rebuild
Section intitulée « Le problème du rebuild »Situation courante (et risquée) :
# ❌ Reconstruire à chaque environnement : à éviter# Pipeline stagingstaging:  script:    - npm install    - npm run build    - docker build -t app:staging .    - docker push registry/app:staging    - kubectl apply -f k8s/staging/
# Pipeline production (quelques jours plus tard)production:  script:    - npm install          # Attention : versions des dépendances peuvent avoir changé    - npm run build        # Attention : résultat potentiellement différent    - docker build -t app:production .    - docker push registry/app:production    - kubectl apply -f k8s/production/
Pourquoi c'est un problème ?
Entre le test en staging et le déploiement en production, trois choses ont pu changer :
- Une dépendance npm a peut-être été mise à jour (même en patch)
- L'image de base Docker a peut-être changé
- Un outil de build a peut-être évolué
Résultat : ce que vous déployez en production n'est pas exactement ce que vous avez testé. Et quand ça casse, impossible de savoir pourquoi.
La solution : promotion d'artefact (build once, deploy many)
Section intitulée « La solution : promotion d'artefact (build once, deploy many) »Le principe : construire l'artefact une seule fois, puis le promouvoir d'environnement en environnement sans le reconstruire.
Comment ça fonctionne :
- Build : l'artefact est construit avec un tag unique (ex:
app:abc123) - Test en dev : on déploie
app:abc123en développement - Test en staging : on déploie le même
app:abc123en staging - Production : on déploie toujours le même
app:abc123en production
La seule chose qui change entre environnements : la configuration (variables d'environnement, secrets).
Exemple concret :
# Étape 1 : Build uniquebuild:  script:    - docker build -t app:$CI_COMMIT_SHA .    - docker push registry/app:$CI_COMMIT_SHA
# Étape 2 : Déploiement en staging (même image)staging:  script:    - helm upgrade app ./chart \        --set image.tag=$CI_COMMIT_SHA \        --set env=staging \        -f values-staging.yaml
# Étape 3 : Déploiement en production (toujours la même image)production:  script:    - helm upgrade app ./chart \        --set image.tag=$CI_COMMIT_SHA \        --set env=production \        -f values-production.yaml  when: manual  # Approbation requise
Avantages de la promotion :
| Aspect | Rebuild | Promotion |
|---|---|---|
| Reproductibilité | Incertaine | Garantie |
| Temps de déploiement | Long (rebuild) | Rapide (juste déployer) |
| Rollback | Rebuild l'ancienne version | Redéployer l'ancien tag |
| Confiance | « Ça marchait en staging... » | « C'est le même artefact » |
Prérequis pour la promotion :
Pour que ça fonctionne, votre application doit :
- Séparer le build de la config : pas de valeurs en dur (URLs, credentials)
- Accepter la configuration au runtime : variables d'environnement, fichiers de config montés
- Avoir un registre d'artefacts fiable : où stocker les images entre les étapes
Pipeline applicative vs pipeline infrastructure
Section intitulée « Pipeline applicative vs pipeline infrastructure »Jusqu'ici, on a surtout parlé des pipelines qui déploient du code applicatif (API, frontend). Mais l'infrastructure aussi peut, et devrait, être gérée par des pipelines.
Pipeline applicative
Section intitulée « Pipeline applicative »C'est celle que la plupart des équipes ont déjà : elle transforme un commit de code en version déployée. Ses caractéristiques découlent toutes du fait qu'elle tourne souvent et n'affecte qu'un périmètre limité, ce qui autorise un feedback rapide et un risque contenu à chaque exécution.
Ce qu'elle déploie : le code de votre application, API, frontend, workers, jobs.
Caractéristiques :
- Déclenchée par des commits sur le code applicatif
- Fréquence élevée (plusieurs fois par jour possible)
- Impact limité (un service à la fois, généralement)
Pipeline infrastructure
Section intitulée « Pipeline infrastructure »Elle applique les changements décrits en Infrastructure as Code et se distingue par l'inverse de la précédente : elle tourne rarement mais son rayon d'impact est large, puisqu'une seule modification peut toucher tous les services hébergés. C'est cette asymétrie qui justifie de la traiter à part, avec ses propres garde-fous et ses propres approbations.
Ce qu'elle déploie : les ressources sur lesquelles tourne votre application, réseaux, bases de données, clusters, DNS.
Caractéristiques :
- Déclenchée par des modifications d'Infrastructure as Code (Terraform, Pulumi)
- Fréquence plus faible (quelques fois par semaine)
- Impact potentiellement large (peut affecter plusieurs services)
Faut-il séparer ou intégrer ?
Section intitulée « Faut-il séparer ou intégrer ? »Le tableau met les deux options en balance. La séparation limite le rayon d'impact et garde des permissions distinctes ; une pipeline unique gagne l'atomicité, au prix de la complexité et d'un risque élevé en cas d'échec.
| Approche | Avantages | Inconvénients |
|---|---|---|
| Pipelines séparées | Cycles indépendants, permissions distinctes, blast radius limité | Coordination manuelle parfois nécessaire |
| Pipeline unique | Déploiement atomique (infra + app ensemble), cohérence garantie | Complexité, risque élevé si échec |
Recommandation : séparez les pipelines, mais coordonnez-les.
L'infrastructure change moins souvent que le code. Mélanger les deux crée des pipelines lourdes où un changement de couleur de bouton déclenche une vérification Terraform.
Comment coordonner ?
- Triggers : la pipeline infra déclenche la pipeline app après succès
- GitOps : des outils comme ArgoCD ou Flux détectent les changements et déploient
- Dépendances explicites : la pipeline app vérifie que l'infra est à jour avant de déployer
Architectures avancées
Section intitulée « Architectures avancées »Une fois les bases maîtrisées, certaines équipes adoptent des patterns plus sophistiqués.
Pipeline en diamant : parallélisation maximale
Section intitulée « Pipeline en diamant : parallélisation maximale »Le principe : exécuter un maximum de jobs en parallèle, puis reconverger avant l'étape suivante.
Pourquoi « diamant » ? La forme du graphe ressemble à un diamant : un point de départ, une divergence (parallélisation), une convergence, puis à nouveau divergence/convergence.
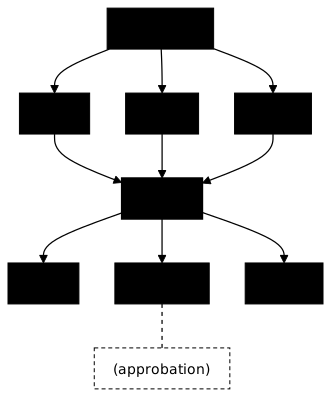
Avantages :
- Temps total réduit : lint, tests et scan s'exécutent en même temps
- Feedback rapide : si le lint échoue, on le sait sans attendre la fin des tests
- Ressources optimisées : les runners travaillent en parallèle
Attention : tous les jobs parallèles doivent réussir pour passer à l'étape suivante. Un échec = pipeline bloquée.
Pipeline avec matrix : tester toutes les combinaisons
Section intitulée « Pipeline avec matrix : tester toutes les combinaisons »Le problème : votre bibliothèque doit fonctionner avec Python 3.11, 3.12, 3.13 et 3.14, sur Ubuntu, macOS et Windows. Ça fait 12 combinaisons à tester.
La solution : la matrix génère automatiquement tous les jobs.
test:  strategy:    matrix:      # Versions quotées : sans guillemets, YAML lit 3.10 comme le nombre 3.1      python: ["3.11", "3.12", "3.13", "3.14"]      os: [ubuntu-24.04, macos-26, windows-2025]
# Résultat : 4 versions × 3 OS = 12 jobs parallèles
Deux détails de cet extrait évitent des pannes discrètes. Les versions
sont entre guillemets, parce que YAML lit 3.10 comme le nombre 3.1, et la
matrice testerait alors une version qui n'existe pas. Les systèmes sont
nommés par leur version (macos-26, windows-2025) plutôt que par une
étiquette -latest, qui change de cible sans prévenir et rend un échec
difficile à reproduire.
Cas d'usage :
- Bibliothèques open source (compatibilité multi-versions)
- Applications desktop (multi-OS)
- Validation de compatibilité avant une mise à jour de dépendance
Pipeline conditionnelle : adapter selon le contexte
Section intitulée « Pipeline conditionnelle : adapter selon le contexte »Le principe : certains jobs ne s'exécutent que si certaines conditions sont remplies.
Exemples courants :
| Condition | Comportement |
|---|---|
Branche = main | Déployer en staging, puis production (avec approbation) |
Branche = feature/* | Déployer en environnement éphémère, détruire après 24h |
Fichiers modifiés dans docs/ | Skipper les tests, rebuilder uniquement la documentation |
Tag créé (v*) | Créer une release, publier les packages |
Pourquoi c'est utile ?
- Économie de ressources : pas besoin de tout tester si seule la doc a changé
- Feedback adapté : une feature branch n'a pas besoin de déployer en production
- Flexibilité : comportements différents selon le contexte sans multiplier les pipelines
Choisir son architecture : guide de décision
Section intitulée « Choisir son architecture : guide de décision »Face à toutes ces options, comment choisir ? Voici un guide basé sur des questions concrètes.
Question 1 : Combien d'équipes travaillent sur le code ?
Section intitulée « Question 1 : Combien d'équipes travaillent sur le code ? »Le nombre d'équipes qui partagent le code détermine surtout le choix monorepo ou polyrepo. Tant qu'une seule équipe touche l'ensemble, un monorepo reste simple à outiller. Au-delà de quelques équipes, soit vous investissez dans un outil de build incrémental, soit vous découpez en dépôts autonomes pour rendre les équipes indépendantes.
| Situation | Recommandation |
|---|---|
| 1 équipe (< 10 personnes) | Monorepo simple, trunk-based possible |
| 2-5 équipes | Monorepo avec outillage (Nx, Turborepo) ou polyrepo léger |
| 10+ équipes | Polyrepo probable, ou monorepo avec infrastructure dédiée |
Question 2 : Quelle fréquence de déploiement ?
Section intitulée « Question 2 : Quelle fréquence de déploiement ? »La cadence de déploiement tranche entre GitFlow et trunk-based. Plus vous livrez souvent, moins les branches longues sont tenables : le coût des merges finit par dépasser le bénéfice du contrôle qu'elles apportent. À partir du rythme hebdomadaire, la promotion d'artefact cesse d'être un confort pour devenir une nécessité, sous peine de déployer un binaire différent de celui qui a été testé.
| Fréquence | Recommandation |
|---|---|
| Mensuelle ou moins | GitFlow acceptable, promotion d'artefact recommandée |
| Hebdomadaire | Trunk-based à considérer, promotion obligatoire |
| Quotidienne ou plus | Trunk-based + feature flags + continuous deployment |
Question 3 : Avez-vous plusieurs versions en production ?
Section intitulée « Question 3 : Avez-vous plusieurs versions en production ? »Cette question est souvent la plus contraignante, car elle ne dépend pas de vos préférences mais de votre produit. Un logiciel installé chez le client ou une application mobile impose de maintenir plusieurs versions en parallèle, donc des branches de release et des pipelines par branche. Un SaaS où tous les utilisateurs sont sur la même version lève cette contrainte et ouvre la voie au trunk-based.
| Situation | Recommandation |
|---|---|
| Non (SaaS, une seule version) | Trunk-based, pipeline unique |
| Oui (logiciel installé, app mobile) | Branches de release, pipelines par branche |
Question 4 : Quelle est votre maturité en tests ?
Section intitulée « Question 4 : Quelle est votre maturité en tests ? »La maturité des tests agit comme un garde-fou sur tout ce qui précède. Le trunk-based et le déploiement continu ne fonctionnent que si vos tests automatisés attrapent réellement les régressions ; sinon, chaque merge sur
main devient un pari. Soyez honnête sur ce point : investir dans la couverture
de tests avant d'accélérer les déploiements évite de transformer une pipeline
rapide en distributeur d'incidents.
| Niveau | Recommandation |
|---|---|
| Peu ou pas de tests automatisés | Restez sur des pipelines simples, investissez dans les tests d'abord |
| Chemins critiques couverts | Trunk-based envisageable avec prudence |
| Excellente couverture + tests d'intégration | Continuous deployment possible |
L'anti-pattern : copier sans comprendre
Section intitulée « L'anti-pattern : copier sans comprendre »« Netflix fait du trunk-based avec continuous deployment, on devrait faire pareil ! »
Non. Une entreprise de cette taille réunit quatre conditions qui rendent ce modèle soutenable : des équipes entières dédiées à l'outillage, des années d'itération sur ses pratiques, une infrastructure de tests et de feature flags mature, et un contexte SaaS avec une seule version en production.
Copier son architecture sans reproduire ces quatre conditions, c'est hériter de la complexité sans le socle qui la rend soutenable : des pipelines fragiles, des déploiements ratés et une équipe qui passe son temps à réparer l'outillage au lieu de livrer.
La bonne approche :
- Commencez simple : une pipeline linéaire qui build, teste, déploie
- Identifiez les douleurs : qu'est-ce qui vous ralentit vraiment ?
- Évoluez progressivement : ajoutez de la complexité quand vous en avez besoin
- Mesurez : temps de pipeline, fréquence de déploiement, taux d'échec
À retenir
Section intitulée « À retenir »-
L'architecture de pipeline reflète votre contexte : structure d'équipe, stratégie de branches, modèle de déploiement. Il n'y a pas de solution universelle.
-
Trunk-based vs GitFlow : branches courtes = moins de conflits et feedback rapide, mais demande discipline et feature flags. Branches longues = plus de contrôle, mais merges douloureux.
-
Monorepo vs polyrepo : monorepo facilite le refactoring et la cohérence, mais demande de l'outillage. Polyrepo donne de l'autonomie, mais complique la coordination.
-
Promotion > rebuild : construisez l'artefact une fois, déployez-le partout. Ce que vous testez doit être exactement ce que vous déployez.
-
Séparez app et infra : des cycles différents, des permissions différentes, des risques différents. Coordonnez, mais ne mélangez pas.
-
Commencez simple, complexifiez quand nécessaire : la pipeline parfaite n'existe pas au jour 1. Itérez en fonction des problèmes réels.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de cette leçon est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Trunk-Based Development et modèles de branches Git
Continuer le cours : Bonnes pratiques CI/CD
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications