Prenons une équipe e-commerce, cas fictif mais typique, qui déploie une fois par mois avec un taux d'échec de 35 %. Six mois de mesure et d'amélioration guidées par les métriques DORA peuvent l'amener à plusieurs déploiements quotidiens avec quelques pour cent d'échecs. Ces indicateurs, validés par plus d'une décennie de recherche DORA, restent le standard incontournable pour mesurer la performance de livraison logicielle : ce guide vous montre comment les collecter automatiquement, les corréler aux incidents et les afficher dans un dashboard actionnable, sans monter une infrastructure disproportionnée.
Les métriques DORA (DevOps Research and Assessment) ne sont pas de simples chiffres à afficher sur un tableau de bord. Prises isolément, chacune se manipule facilement : on peut gonfler la Deployment Frequency en découpant artificiellement les livraisons, ou écraser le Change Failure Rate en ne déclarant plus les incidents mineurs. C'est leur lecture conjointe qui a une valeur de diagnostic, parce que ces quatre indicateurs se contraignent mutuellement : livrer plus vite (Deployment Frequency, Lead Time) sans dégrader la fiabilité (Change Failure Rate, MTTR) suppose des tests et une automatisation qui tiennent réellement.
Ce guide s'adresse aux équipes qui disposent déjà d'un pipeline CI/CD en production et veulent passer d'une intuition (« on livre plus vite qu'avant ») à une mesure objective. Il couvre la collecte des données brutes, le calcul de chaque métrique, la construction d'un dashboard Grafana, et un tour d'horizon des évolutions récentes du référentiel DORA.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Instrumenter vos pipelines CI/CD (GitHub Actions, GitLab CI, ArgoCD) pour émettre des évènements de déploiement exploitables.
- Calculer les 4 métriques DORA historiques, Deployment Frequency, Lead Time, Change Failure Rate et MTTR, à partir de données réelles.
- Corréler déploiements et incidents pour fiabiliser le Change Failure Rate sans faux positifs.
- Construire un dashboard Grafana actionnable avec des seuils de performance alignés sur les niveaux DORA.
- Situer votre équipe face aux évolutions récentes du référentiel : la 5e métrique Rework Rate (2024) et l'abandon des catégories Elite/High/Medium/Low (2025).
- Choisir entre solution maison, outil SaaS ou fonctionnalité native de votre plateforme CI/CD selon votre contexte.
Prérequis
Section intitulée « Prérequis »Il vous faut un pipeline CI/CD dont les déploiements laissent une trace, une base d'observabilité pour dater les incidents, les fondamentaux DORA pour savoir ce que chaque métrique mesure, et un processus de gestion des incidents qui enregistre début et fin de chaque panne.
Pourquoi mesurer avec DORA ?
Section intitulée « Pourquoi mesurer avec DORA ? »Avant de plonger dans l'implémentation technique, voyons pourquoi ces métriques ont été retenues parmi des centaines de mesures possibles, et ce qui a changé dans le référentiel ces dernières années.
Le programme DORA, initié par Gene Kim, Jez Humble et Nicole Forsgren, analyse les pratiques de livraison logicielle depuis plus de dix ans. Les chiffres les plus cités, une équipe Elite qui déploie 208 fois plus fréquemment qu'une équipe Low, avec un temps de récupération 2 604 fois plus rapide, viennent du rapport 2019 et continuent de circuler dans l'industrie. Le rapport 2024, dixième de la série, s'appuie sur près de 3 000 répondants (environ 39 000 en dix ans de recherche) et donne des écarts proches : face aux équipes Low, les équipes Elite déploient 182 fois plus souvent, avec un délai de livraison 127 fois plus court, un taux d'échec 8 fois plus bas et un rétablissement 2 293 fois plus rapide. Les ordres de grandeur bougent d'une édition à l'autre, mais la conclusion reste constante depuis plus de dix ans : l'écart de performance entre les équipes les mieux et les moins bien outillées se compte en centaines, voire en milliers de fois.
En 2025, la méthodologie a changé de nature : le rapport State of AI-assisted Software Development s'appuie sur près de 5 000 répondants, complétés par plus de 100 heures d'entretiens qualitatifs, pour étudier l'impact de l'IA générative sur la livraison. Résultat concret pour ce guide : DORA a abandonné les catégories fixes Low/Medium/High/Elite au profit de la distribution des réponses de chaque métrique et de sept profils d'équipe (par exemple les « Pragmatic Performers » ou les « Harmonious High-Achievers »). Le tableau des niveaux plus bas dans ce guide reste toutefois un repère pratique, celui du dernier rapport qui publiait des niveaux.
Historiquement, ces métriques fonctionnent en binôme selon deux dimensions. Les deux premières (Deployment Frequency et Lead Time) mesurent votre throughput, c'est-à-dire votre vélocité de livraison de valeur. Les deux dernières (Change Failure Rate et MTTR) mesurent votre stability, c'est-à-dire la fiabilité de ce que vous livrez. Depuis 2024, le référentiel DORA nomme cette seconde dimension instability (un taux d'échec élevé signale un problème, mais un taux bas ne garantit pas la santé du système), y ajoute une cinquième métrique, le Deployment Rework Rate, et range désormais le temps de rétablissement côté throughput, comme détaillé plus bas. L'objectif reste inchangé : améliorer vitesse et fiabilité simultanément, jamais l'une au détriment de l'autre.

Les 4 métriques DORA
Section intitulée « Les 4 métriques DORA »Le tableau suivant résume chaque métrique historique, ce qu'elle mesure et sa dimension dans le modèle actuel publié sur dora.dev. Ce sont les indicateurs sur lesquels s'appuie l'essentiel de ce guide, car ils restent les plus largement outillés et compris par les équipes.
| Métrique | Ce qu'elle mesure | Dimension |
|---|---|---|
| Deployment Frequency (DF) | Nombre de déploiements réussis en production | Throughput |
| Lead Time for Changes (LT) | Temps entre le premier commit et la mise en production | Throughput |
| Change Failure Rate (CFR) | Pourcentage de déploiements causant des incidents | Instability |
| Failed Deployment Recovery Time (ex-MTTR) | Temps pour rétablir le service après un déploiement en échec | Throughput |
Le temps de rétablissement a changé deux fois. En 2023, le MTTR a été redéfini en Failed Deployment Recovery Time, qui ne compte que les pannes causées par un déploiement. En 2024, il est passé du côté throughput, car une équipe capable de livrer vite peut aussi corriger vite sans procédure d'urgence dérogatoire. Les supports plus anciens le classent encore en stabilité : la référence à jour reste le guide officiel sur dora.dev. Ce guide garde l'acronyme MTTR, toujours le plus répandu dans les outils.
Niveaux de performance
Section intitulée « Niveaux de performance »Comment savoir si vos métriques sont bonnes ? Le tableau ci-dessous reprend les quatre niveaux du rapport DORA 2024 (figure 1). Ces niveaux ne sont pas fixés à l'avance : ils émergent chaque année d'une analyse par grappes des réponses, et leurs bornes bougent donc d'une édition à l'autre.
| Métrique | Low | Medium | High | Elite |
|---|---|---|---|---|
| Deployment Frequency | Entre 1/mois et 1/6 mois | Entre 1/semaine et 1/mois | Entre 1/jour et 1/semaine | À la demande (plusieurs/jour) |
| Lead Time | Entre 1 et 6 mois | Entre 1 semaine et 1 mois | Entre 1 jour et 1 semaine | Moins d'un jour |
| Change Failure Rate | 40 % | 10 % | 20 % | 5 % |
| Temps de rétablissement | Entre 1 semaine et 1 mois | Moins d'un jour | Moins d'un jour | Moins d'une heure |
| Part des répondants | 25 % | 35 % | 22 % | 19 % |
La ligne du Change Failure Rate surprend : en 2024, le niveau Medium échoue moins souvent (10 %) que le niveau High (20 %). DORA a choisi d'appeler « High » les équipes plus rapides et « Medium » les équipes plus lentes mais plus stables : un rappel que la vitesse seule ne fait pas la performance.
Gardez toutefois à l'esprit que ce découpage en quatre niveaux ne correspond plus exactement à la manière dont DORA présente ses résultats depuis 2025. L'organisation publie désormais la distribution des réponses de chaque métrique (où se situe une équipe parmi l'ensemble des répondants) plutôt que des seuils figés, et croise ces chiffres avec des profils d'équipe qui intègrent aussi l'engagement humain et la charge cognitive. Pour un usage pratique au quotidien, le tableau ci-dessus reste néanmoins un excellent point de repère : les outils de collecte (Sleuth, LinearB, GitLab) continuent de raisonner en niveaux de ce type dans leurs dashboards.
1. Deployment Frequency (DF)
Section intitulée « 1. Deployment Frequency (DF) »C'est la métrique par laquelle commencer, pour une raison pratique : elle ne demande qu'une seule donnée, l'horodatage d'un déploiement réussi en production. Aucune corrélation, aucun rapprochement avec un autre système. Si votre instrumentation ne va pas plus loin que ce point, vous disposez déjà d'un indicateur exploitable.
Comprendre cette métrique
Section intitulée « Comprendre cette métrique »La Deployment Frequency mesure combien de fois vous déployez en production sur une période donnée. C'est la métrique la plus simple à collecter, mais aussi la plus révélatrice de votre maturité DevOps.
Une fréquence basse, de l'ordre d'un déploiement par mois, s'explique presque toujours par un coût unitaire de mise en production élevé : validations manuelles, fenêtre de maintenance négociée, procédure de retour arrière longue ou incertaine. Comme chaque livraison coûte cher, on regroupe les changements, ce qui augmente encore le risque et renforce la prudence. À l'inverse, une fréquence élevée traduit un coût unitaire faible, donc des tests automatisés suffisamment fiables pour se passer d'une validation humaine et un rollback assez rapide pour que l'erreur reste supportable.
Collecte automatisée
Section intitulée « Collecte automatisée »La clé d'une bonne mesure est l'automatisation. Chaque déploiement doit envoyer un évènement vers votre système de métriques. Voici comment l'implémenter selon votre plateforme CI/CD :
name: Deploy to Production
on:  push:    branches: [main]
# Aucun droit par defaut : chaque job demande ce dont il a besoinpermissions: {}
jobs:  deploy:    runs-on: ubuntu-latest    permissions:      contents: read    steps:      - uses: actions/checkout@3d3c42e5aac5ba805825da76410c181273ba90b1 # v7.0.1        with:          persist-credentials: false
      - name: Deploy application        run: ./deploy.sh
      - name: Track deployment metric        if: success()        env:          METRICS_ENDPOINT: ${{ secrets.METRICS_ENDPOINT }}          SERVICE: ${{ github.repository }}          COMMIT_SHA: ${{ github.sha }}        run: |          curl -X POST "${METRICS_ENDPOINT}/deployments" \            -H "Content-Type: application/json" \            -d "{              \"timestamp\": \"$(date -u +%Y-%m-%dT%H:%M:%SZ)\",              \"environment\": \"production\",              \"service\": \"${SERVICE}\",              \"commit_sha\": \"${COMMIT_SHA}\",              \"status\": \"success\"            }"
Trois détails de cet exemple ne concernent pas les métriques mais la sécurité du workflow, et méritent d'être repris tels quels. Le permissions: {} global retire tous les droits au GITHUB_TOKEN, que chaque job redemande ensuite au minimum. L'action de checkout est épinglée par empreinte SHA plutôt que par tag, un tag pouvant être redirigé vers un autre contenu, et persist-credentials: false évite de laisser le jeton dans la configuration Git du runner. Enfin, les valeurs dynamiques passent par le bloc env au lieu d'être interpolées dans le script, ce qui empêche qu'une valeur inattendue soit exécutée comme du shell.
deploy_production: stage: deploy script: - ./deploy.sh after_script: - | if [ "$CI_JOB_STATUS" == "success" ]; then curl -X POST "$METRICS_ENDPOINT/deployments" \ -H "Content-Type: application/json" \ -d "{ \"timestamp\": \"$(date -u +%Y-%m-%dT%H:%M:%SZ)\", \"environment\": \"production\", \"service\": \"$CI_PROJECT_PATH\", \"commit_sha\": \"$CI_COMMIT_SHA\", \"status\": \"success\" }" fi environment: name: production# ArgoCD notification avec webhookapiVersion: argoproj.io/v1alpha1kind: Applicationmetadata: annotations: notifications.argoproj.io/subscribe.on-sync-succeeded.webhook: deployment-tracker---# ConfigMap pour les notificationsapiVersion: v1kind: ConfigMapmetadata: name: argocd-notifications-cmdata: trigger.on-sync-succeeded: | - when: app.status.sync.status == 'Synced' send: [deployment-event] template.deployment-event: | webhook: deployment-tracker: method: POST body: | { "timestamp": "{{.app.status.operationState.finishedAt}}", "environment": "production", "service": "{{.app.metadata.name}}", "commit_sha": "{{.app.status.sync.revision}}", "status": "success" }Améliorer la fréquence de déploiement
Section intitulée « Améliorer la fréquence de déploiement »Si votre fréquence est trop basse, identifiez le goulot d'étranglement principal :
| Symptôme | Cause probable | Solution |
|---|---|---|
| Déploiements groupés le vendredi | Peur du changement | Feature flags, rollback automatique |
| Batches de 50+ commits | Revues de code trop longues | Limiter la taille des PRs à 400 lignes |
| Tests qui durent 2+ heures | Suite de tests non optimisée | Parallélisation, tests par impact |
| Approbations manuelles multiples | Processus bureaucratique | Trunk-based development, confiance automatisée |
2. Lead Time for Changes (LT)
Section intitulée « 2. Lead Time for Changes (LT) »Cette deuxième métrique est nettement plus coûteuse à instrumenter que la première, car elle exige de relier un déploiement à l'historique Git qui l'a produit. C'est aussi la plus riche en enseignements : sa décomposition en phases désigne précisément l'étape qui ralentit votre chaîne de livraison.
Comprendre cette métrique
Section intitulée « Comprendre cette métrique »Le Lead Time mesure le temps écoulé entre le premier commit d'un changement et son déploiement en production. Cette métrique révèle la fluidité de votre pipeline de bout en bout.
Le Lead Time additionne des temps d'attente et des temps de traitement : revue de code, exécution des tests, approbations, déploiement effectif. En pratique, l'attente domine largement le traitement, une revue de code de dix minutes pouvant rester deux jours dans une file. La conséquence est directe pour vos utilisateurs : un Lead Time de six mois signifie qu'une correction de bug identifiée aujourd'hui ne les atteindra qu'au prochain semestre, quelle que soit la rapidité avec laquelle le correctif a été écrit.
Méthode de calcul
Section intitulée « Méthode de calcul »Le calcul du Lead Time nécessite de corréler les commits aux déploiements. Voici la logique :
# Exemple de calcul Lead Timecalcul_lead_time:  # 1. Identifier le déploiement  deployment:    id: "deploy-123"    commit_sha: "abc123"    deploy_time: "2026-03-15T14:00:00Z"
  # 2. Trouver le premier commit de la PR/branche associée  first_commit:    sha: "def456"    time: "2026-03-14T10:00:00Z"
  # 3. Calculer la différence  lead_time: "28 heures"
Collecte via API
Section intitulée « Collecte via API »Deux voies sont possibles : écrire vous-même la reconstitution du lien commit/déploiement, ou déléguer ce travail à un outil qui s'abonne aux évènements de votre forge. Le code ci-dessous montre la première, avec un point d'attention : il retourne None pour un commit poussé directement sur la branche principale, sans passer par une pull request.
import requestsfrom datetime import datetime
def calculate_lead_time(owner: str, repo: str, deployment_sha: str) -> float:    """    Calcule le Lead Time en heures pour un déploiement donné.
    Le Lead Time est mesuré du premier commit de la PR    jusqu'au timestamp du déploiement en production.    """    headers = {"Authorization": f"token {GITHUB_TOKEN}"}
    # Étape 1 : Trouver la PR associée au commit déployé    pr_response = requests.get(        f"https://api.github.com/repos/{owner}/{repo}/commits/{deployment_sha}/pulls",        headers=headers    )
    if not pr_response.json():        return None  # Commit direct sans PR
    pr = pr_response.json()[0]
    # Étape 2 : Récupérer tous les commits de cette PR    commits_response = requests.get(        pr['commits_url'],        headers=headers    )    commits = commits_response.json()
    # Le premier commit est le plus ancien    first_commit_date = commits[0]['commit']['committer']['date']
    # Étape 3 : Récupérer le timestamp du déploiement    deploy_time = get_deployment_timestamp(deployment_sha)
    # Étape 4 : Calculer la différence    first_commit = datetime.fromisoformat(first_commit_date.replace('Z', '+00:00'))    deployed = datetime.fromisoformat(deploy_time.replace('Z', '+00:00'))
lead_time_hours = (deployed - first_commit).total_seconds() / 3600 return lead_time_hours# Configuration Sleuth pour collecte automatiqueversion: 1projects: - name: my-application code_deployments: - name: production provider: github_actions environment: production
# Sleuth calcule automatiquement : # - Lead Time (premier commit → deploy) # - Deployment Frequency # - Change Failure Rate # - MTTR # # Intégrations supportées : # - GitHub, GitLab, Bitbucket # - Jenkins, CircleCI, GitHub Actions # - PagerDuty, Opsgenie, Incident.ioAméliorer le Lead Time
Section intitulée « Améliorer le Lead Time »Le Lead Time se décompose en plusieurs phases. Identifiez laquelle consomme le plus de temps :
| Phase | Durée typique problématique | Optimisation |
|---|---|---|
| Code | PRs de 1000+ lignes | Trunk-based development, PRs < 400 lignes |
| Review | > 48h en attente | Limiter le WIP, reviews < 24h, pair programming |
| Build | > 30 minutes | Cache des dépendances, builds incrémentaux |
| Tests | > 1 heure | Parallélisation, tests par impact, shift-left |
| Deploy | Manuel, > 1 jour | Automatisation complète, GitOps |
3. Change Failure Rate (CFR)
Section intitulée « 3. Change Failure Rate (CFR) »C'est la métrique la plus délicate des quatre, non pas à calculer mais à définir. Sa formule tient en une division ; sa fiabilité dépend entièrement de la convention que vous adoptez pour décider qu'un déploiement a échoué. Fixez cette convention par écrit avant de collecter quoi que ce soit, sinon les comparaisons dans le temps ne voudront rien dire.
Comprendre cette métrique
Section intitulée « Comprendre cette métrique »Le Change Failure Rate mesure le pourcentage de déploiements qui causent un incident en production ou nécessitent un rollback. C'est l'indicateur de la qualité de ce que vous livrez.
Un CFR de 30% signifie qu'un déploiement sur trois a dû être corrigé ou annulé après coup. Le chiffre pointe une défaillance des contrôles antérieurs à la mise en production : ce qui aurait dû être détecté par les tests, la revue ou la validation de configuration ne l'est qu'une fois les utilisateurs exposés. Attention à l'interprétation inverse, car un CFR très bas n'est pas nécessairement bon signe : il peut simplement révéler que les incidents ne sont pas déclarés, ou que l'équipe déploie si rarement que l'échantillon n'a aucune valeur statistique.
Méthode de calcul
Section intitulée « Méthode de calcul »Le dénominateur est le nombre total de déploiements en production sur la période, le numérateur la somme des déploiements considérés comme échoués. Un même déploiement suivi d'un rollback et d'un hotfix ne doit être compté qu'une fois, sous peine de dépasser artificiellement les 100%.
# Calcul du Change Failure Rateperiode: "2026-03"
statistiques:  deployments_total: 100  deployments_failed:    rollbacks: 3    incidents_lies: 2    hotfixes: 1  total_failures: 6
# CFR = (failures / total) × 100change_failure_rate: "6%"
Collecte et corrélation
Section intitulée « Collecte et corrélation »La difficulté du CFR réside dans la corrélation entre déploiements et incidents. Voici deux approches :
# Annotations sur les Deployments KubernetesapiVersion: apps/v1kind: Deploymentmetadata: annotations: # Identifiant unique du déploiement metrics.dora/deployment-id: "deploy-2026-03-15-001" # Statut mis à jour en cas de problème metrics.dora/status: "success" # ou "rolled-back", "failed" # Timestamp pour corrélation metrics.dora/deployed-at: "2026-03-15T14:00:00Z"from datetime import datetime, timedelta
def calculate_cfr(start_date: str, end_date: str) -> float: """ Calcule le Change Failure Rate sur une période donnée.
Un déploiement est marqué comme 'failed' si dans les 24h : - Un rollback a été effectué - Un incident a été lié au déploiement - Un hotfix a été déployé """ deployments = get_deployments(start_date, end_date) incidents = get_incidents(start_date, end_date)
failed_count = 0 window = timedelta(hours=24)
for deploy in deployments: deploy_time = datetime.fromisoformat(deploy['timestamp'])
# Vérifier si rollback dans les 24h if has_rollback_within(deploy, window): failed_count += 1 continue
# Vérifier si incident lié for incident in incidents: incident_time = datetime.fromisoformat(incident['created_at'])
# L'incident doit être dans la fenêtre de 24h if deploy_time <= incident_time <= deploy_time + window: # Vérifier le lien explicite ou par service if is_deployment_related(incident, deploy): failed_count += 1 break
cfr = (failed_count / len(deployments)) * 100 return round(cfr, 2)Améliorer le Change Failure Rate
Section intitulée « Améliorer le Change Failure Rate »Un CFR élevé révèle des problèmes dans votre chaîne de qualité :
| Cause fréquente | Diagnostic | Solution |
|---|---|---|
| Tests insuffisants | Coverage < 60% | Augmenter les tests E2E, tests de contrat |
| Erreurs de configuration | Configs différentes dev/prod | Infrastructure as Code, validation pre-deploy |
| Changements trop gros | PRs > 1000 lignes | Smaller batches, feature flags |
| Environnements différents | "Ça marche sur ma machine" | Parité dev/staging/prod, containers |
| Données de test irréalistes | Tests passent, prod échoue | Anonymisation de données prod, chaos engineering |
4. Mean Time to Recover (MTTR)
Section intitulée « 4. Mean Time to Recover (MTTR) »Cette dernière métrique ne se collecte pas dans la chaîne CI/CD mais dans l'outil de gestion des incidents. Elle repose donc sur une hypothèse forte : que tout incident soit déclaré, et que ses horodatages de détection et de résolution soient renseignés honnêtement. Si vos incidents se règlent dans une conversation informelle sans jamais être ouverts, cette mesure restera vide de sens.
Comprendre cette métrique
Section intitulée « Comprendre cette métrique »Le MTTR mesure le temps moyen pour restaurer le service après un incident. C'est l'indicateur de votre résilience, votre capacité à rebondir quand les choses tournent mal.
Le postulat derrière cette métrique est qu'une panne finira par arriver, et que sa durée est la seule variable réellement sous votre contrôle. Le MTTR mesure le rétablissement du service, pas la correction définitive de la cause : un rollback qui remet l'application en état arrête le décompte, même si le bug reste à traiter. C'est précisément ce qui explique l'écart entre les équipes, celles qui restaurent en moins d'une heure disposent d'un chemin de retour arrière automatisé, les autres doivent produire un correctif sous pression avant de pouvoir redéployer.
Méthode de calcul
Section intitulée « Méthode de calcul »Le MTTR est une moyenne arithmétique, ce qui la rend très sensible aux valeurs extrêmes : un seul incident de plusieurs jours suffit à faire dérailler le chiffre du mois. Beaucoup d'équipes suivent en parallèle la médiane pour lire la tendance de fond, et gardent la moyenne pour repérer ces cas isolés.
# Calcul du MTTR mensuelperiode: "2026-03"
incidents:  - id: "INC-001"    detected_at: "2026-03-05T10:00:00Z"    resolved_at: "2026-03-05T10:45:00Z"    recovery_time: "45 minutes"
  - id: "INC-002"    detected_at: "2026-03-12T14:30:00Z"    resolved_at: "2026-03-12T16:00:00Z"    recovery_time: "90 minutes"
  - id: "INC-003"    detected_at: "2026-03-20T03:00:00Z"    resolved_at: "2026-03-20T03:20:00Z"    recovery_time: "20 minutes"
# MTTR = moyenne des temps de recoverymttr: "(45 + 90 + 20) / 3 = 51.67 minutes"
Collecte depuis les outils d'incident
Section intitulée « Collecte depuis les outils d'incident »Les plateformes d'astreinte exposent déjà les horodatages nécessaires, il reste à filtrer ce que vous comptez. Deux filtres sont indispensables : ne retenir que les incidents résolus, sans quoi un incident encore ouvert fausse le calcul, et ne retenir que les services de production, pour ne pas mélanger les alertes de préproduction.
import pdpyrasfrom datetime import datetimefrom statistics import mean
def get_mttr_from_pagerduty(start_date: str, end_date: str) -> float:    """    Récupère les incidents PagerDuty résolus et calcule le MTTR.
    Ne prend en compte que les incidents de production résolus.    Retourne le MTTR en minutes.    """    session = pdpyras.APISession(PAGERDUTY_TOKEN)
    # Récupérer uniquement les incidents résolus    incidents = session.iter_all(        'incidents',        params={            'since': start_date,            'until': end_date,            'statuses[]': ['resolved'],            # Filtrer par service de production            'service_ids[]': PRODUCTION_SERVICE_IDS        }    )
    recovery_times = []
    for incident in incidents:        created = datetime.fromisoformat(incident['created_at'])        resolved = datetime.fromisoformat(incident['resolved_at'])
        # Temps de recovery en minutes        recovery_minutes = (resolved - created).total_seconds() / 60        recovery_times.append(recovery_minutes)
    if not recovery_times:        return 0.0
    mttr = mean(recovery_times)    return round(mttr, 2)
# Incident.io calcule automatiquement plusieurs métriques# accessibles via leur API ou leur dashboard
metriques_disponibles: - time_to_acknowledge # Temps avant première réponse - time_to_mitigate # Temps avant mitigation - time_to_resolve # MTTR - temps total de résolution
# Export des métriques via APIapi_query: | GET /v2/metrics/incidents ?created_at[gte]=2026-03-01 &created_at[lt]=2026-04-01 &metrics[]=time_to_resolve
# Ou via leur langage de requêteanalytics_query: | incidents | where created_at >= ago(30d) | where severity in ("critical", "major") | summarize mttr_minutes = avg(resolve_duration_minutes), incident_count = count()Améliorer le MTTR
Section intitulée « Améliorer le MTTR »Le MTTR se décompose en plusieurs phases. Chacune peut être optimisée :
| Phase | Ce qu'elle couvre | Leviers d'amélioration |
|---|---|---|
| Détection | Temps avant de savoir qu'il y a un problème | Alerting proactif, SLOs bien définis, monitoring synthétique |
| Diagnostic | Temps pour comprendre la cause | Observabilité complète (logs, traces, metrics), dashboards clairs |
| Mitigation | Temps pour rétablir le service pour les utilisateurs | Rollback automatique en 1 clic, feature flags, circuit breakers |
| Résolution | Temps pour corriger définitivement | Runbooks à jour, escalation claire, post-mortems |
La 5e métrique DORA : Deployment Rework Rate
Section intitulée « La 5e métrique DORA : Deployment Rework Rate »Depuis le rapport 2024, DORA ajoute une cinquième métrique aux quatre historiques : le Deployment Rework Rate, ou taux de retravail des déploiements. Elle mesure le pourcentage de déploiements non planifiés qui découlent directement d'un incident en production, par opposition aux déploiements planifiés qui font avancer la roadmap.
La différence avec le Change Failure Rate est subtile mais utile : le CFR compte tout déploiement qui a causé un incident, tandis que le Rework Rate compte les déploiements qui ont été déclenchés pour réagir à un incident, qu'il ait été causé par ce même service ou par une dépendance. Une équipe peut avoir un CFR bas (ses propres changements cassent rarement la production) mais un Rework Rate élevé si elle passe beaucoup de temps à corriger des régressions issues d'autres équipes ou de dépendances externes.
Le calcul reprend la même logique que le CFR : diviser le nombre de déploiements non planifiés liés à un incident par le nombre total de déploiements sur la période. Si vous avez déjà mis en place la corrélation déploiements/incidents décrite plus haut, vous disposez de la majorité des données nécessaires : il suffit d'ajouter un champ planned: true/false à chaque évènement de déploiement pour distinguer une livraison de fonctionnalité d'un correctif d'urgence.
Architecture de collecte
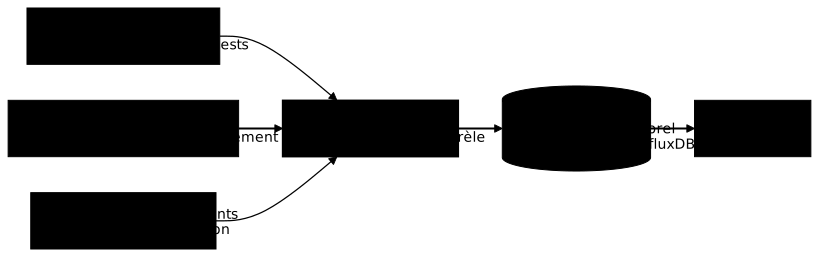
Section intitulée « Architecture de collecte »Les quatre métriques reposent sur la même chaîne technique : des sources qui émettent des évènements, un point de collecte qui les normalise, un stockage temporel et une couche d'affichage. Poser cette structure avant de coder évite de refaire l'instrumentation à chaque nouvelle métrique. Vérifiez d'abord ce que votre plateforme fournit déjà, une partie de ce travail est parfois inutile.
Vue d'ensemble du flux de données
Section intitulée « Vue d'ensemble du flux de données »Pour que vos métriques DORA soient fiables, vous devez mettre en place une architecture de collecte automatisée. Les données proviennent de sources diverses, votre gestionnaire de code, votre pipeline CI/CD, votre système d'incidents, et convergent vers un dashboard centralisé.
Composants de l'architecture
Section intitulée « Composants de l'architecture »L'architecture de collecte DORA comprend quatre couches distinctes. Selon votre plateforme, une partie de cette architecture existe déjà nativement : GitLab Ultimate calcule par exemple Deployment Frequency, Lead Time, Change Failure Rate et MTTR directement depuis ses données de pipeline via le Value Streams Dashboard, sans nécessiter d'outil externe.
| Couche | Rôle | Exemples d'outils |
|---|---|---|
| Sources | Émettent les événements bruts | GitHub, GitLab, ArgoCD, PagerDuty, Opsgenie |
| Collecteur | Agrège et normalise les données | Scripts Python, OpenTelemetry, webhooks |
| Stockage | Conserve les séries temporelles | Prometheus, InfluxDB, TimescaleDB |
| Visualisation | Affiche les dashboards | Grafana, Datadog, custom |
Dashboard Grafana
Section intitulée « Dashboard Grafana »Voici une configuration Grafana pour afficher les 4 métriques DORA. Chaque panel utilise des seuils colorés à adapter à vos objectifs : les valeurs ci-dessous sont des exemples, pas les bornes officielles du tableau des niveaux.
{ "dashboard": { "title": "DORA Metrics Dashboard", "description": "Vue d'ensemble des 4 métriques DORA", "panels": [ { "title": "Deployment Frequency (7 jours)", "type": "stat", "description": "Nombre de déploiements réussis cette semaine", "targets": [{ "expr": "sum(increase(deployments_total{env=\"production\", status=\"success\"}[7d]))" }], "thresholds": { "steps": [ {"color": "red", "value": 0}, {"color": "orange", "value": 1}, {"color": "yellow", "value": 4}, {"color": "green", "value": 7} ] } }, { "title": "Lead Time (heures)", "type": "stat", "description": "Temps moyen commit → production", "targets": [{ "expr": "avg(deployment_lead_time_hours{env=\"production\"})" }], "thresholds": { "steps": [ {"color": "green", "value": 0}, {"color": "yellow", "value": 24}, {"color": "orange", "value": 168}, {"color": "red", "value": 720} ] } }, { "title": "Change Failure Rate (%)", "type": "gauge", "description": "Pourcentage de déploiements causant des incidents", "targets": [{ "expr": "sum(deployments_failed_total) / sum(deployments_total) * 100" }], "thresholds": { "steps": [ {"color": "green", "value": 0}, {"color": "yellow", "value": 15}, {"color": "orange", "value": 30}, {"color": "red", "value": 45} ] } }, { "title": "MTTR (minutes)", "type": "stat", "description": "Temps moyen de restauration du service", "targets": [{ "expr": "avg(incident_recovery_time_minutes)" }], "thresholds": { "steps": [ {"color": "green", "value": 0}, {"color": "yellow", "value": 60}, {"color": "orange", "value": 1440}, {"color": "red", "value": 10080} ] } } ] }}Outils spécialisés DORA
Section intitulée « Outils spécialisés DORA »Plutôt que de construire votre propre solution de collecte, vous pouvez utiliser des outils spécialisés. Le marché a bougé : fin 2025, Atlassian a racheté DX (plateforme de mesure de productivité d'ingénierie) pour environ un milliard de dollars, signe de l'intérêt croissant des grands éditeurs pour ces outils. Voici une comparaison des principales options :
| Outil | Type | Points forts | Idéal pour |
|---|---|---|---|
| Sleuth | SaaS | Auto-découverte, setup en 10 min | Équipes qui veulent démarrer vite |
| LinearB | SaaS | Métriques engineering complètes | Équipes cherchant des insights dev |
| Apache DevLake | Open source | Projet de la fondation Apache, 20+ connecteurs (GitHub, GitLab, Jenkins, Jira) | Organisations qui veulent héberger leurs propres données |
| Port | SaaS | Developer portal + DORA intégré | Platform engineering mature |
| GitLab Ultimate | Natif plateforme | Value Streams Dashboard intégré | Équipes déjà sur GitLab Ultimate |
| Four Keys | Open source (archivé) | Créé par Google, GCP-native | Référence pédagogique, plus maintenu |
Four Keys : l'outil de référence, désormais archivé
Section intitulée « Four Keys : l'outil de référence, désormais archivé »Four Keys, l'outil open source créé par l'équipe DORA chez Google, a longtemps servi de référence pour outiller les 4 métriques sur Google Cloud Platform. Le dépôt a été archivé en janvier 2024 : il est toujours consultable et forkable, mais n'est plus maintenu par Google, et son README recommande explicitement de l'utiliser « comme source d'inspiration » plutôt que comme dépendance de production.
# Cloner le repository Four Keys (archivé, non maintenu depuis 2024)git clone https://github.com/GoogleCloudPlatform/fourkeys.gitcd fourkeys
# Configurer le projet GCPexport PROJECT_ID="mon-projet-dora"export REGION="europe-west1"
# Lancer le script de déploiement# Crée : BigQuery, Cloud Run, Pub/Sub, Cloud Build triggers./setup/setup.sh
# Vérifier le déploiementgcloud run services list --project=$PROJECT_IDCycle d'amélioration continue
Section intitulée « Cycle d'amélioration continue »L'implémentation des métriques DORA n'est pas une fin en soi. L'objectif est d'utiliser ces données pour améliorer continuellement vos pratiques, selon le cycle recommandé ci-dessous.

Ce cycle prend une importance renouvelée avec l'essor des assistants de code IA. Le rapport DORA 2025 montre que l'adoption de l'IA générative augmente le débit de code produit, mais dégrade souvent la stabilité (plus de rework, plus d'incidents) lorsque les pratiques de test, de revue et de déploiement ne suivent pas. Mesurer vos 4 métriques avant et après l'introduction massive d'assistants IA dans vos équipes est devenu un des cas d'usage les plus concrets de ce cycle, et rejoint les enjeux couverts par notre guide sur le Platform Engineering, qui vise justement à absorber cette charge supplémentaire par de meilleurs outils internes.
Les 4 phases du cycle
Section intitulée « Les 4 phases du cycle »Ces quatre phases se déroulent dans l'ordre et chacune conditionne la suivante. La première, la mesure de référence, est celle que les équipes sautent le plus souvent, et c'est aussi celle sans laquelle les trois autres n'apportent aucune preuve.
-
Mesurer le baseline
Collectez 2 à 4 semaines de données avant de tenter toute amélioration. Ce baseline vous permettra de mesurer l'impact réel de vos actions. Sans baseline, vous ne saurez jamais si vos changements ont eu un effet positif.
-
Analyser les goulots
Identifiez quelle métrique est la plus faible et pourquoi. Utilisez les données pour trouver les causes racines. Par exemple, si votre Lead Time est élevé, décomposez-le : est-ce le temps de review ? Le build ? Les tests ?
-
Améliorer un processus
Concentrez-vous sur une seule métrique à la fois. Implémentez un changement ciblé (par exemple limiter la taille des PRs, paralléliser les tests) et donnez-lui le temps de produire des effets (2 à 4 semaines minimum).
-
Valider les résultats
Comparez les nouvelles mesures au baseline. Le changement a-t-il eu l'effet escompté ? Y a-t-il eu des effets secondaires sur les autres métriques ? Documentez les apprentissages.
Plan d'implémentation
Section intitulée « Plan d'implémentation »Voici un plan réaliste pour implémenter les métriques DORA dans votre organisation. Il est volontairement étalé sur trois mois, car les deux premières semaines ne produisent aucun chiffre exploitable : il faut d'abord accumuler assez d'évènements pour que les moyennes aient un sens. Ne partagez pas de dashboard avant d'avoir vérifié que les données qui l'alimentent sont complètes, un chiffre faux détruit durablement la confiance dans la démarche.
-
Semaine 1-2 : Instrumentation
- Ajouter les webhooks de tracking dans vos pipelines CI/CD
- Configurer la corrélation entre déploiements et incidents
- Valider que les données arrivent correctement
-
Semaine 3-4 : Baseline et Dashboard
- Déployer un dashboard Grafana basique
- Collecter le baseline sur 2 semaines complètes
- Partager le dashboard avec les équipes (lecture seule)
-
Mois 2 : Première amélioration
- Identifier la métrique la plus faible
- Choisir une action d'amélioration ciblée
- Implémenter et mesurer l'impact
-
Mois 3+ : Culture de l'amélioration
- Instaurer une revue mensuelle des métriques
- Définir des objectifs par équipe (réalistes)
- Célébrer les améliorations, sans blâmer les régressions
Guides des outils de collecte
Section intitulée « Guides des outils de collecte »La collecte se branche là où les événements naissent : les formations GitHub Actions et GitLab CI montrent où lire les déploiements, Prometheus stocke les séries temporelles et Grafana construit le tableau de bord des quatre métriques.
Ressources complémentaires
Section intitulée « Ressources complémentaires »Pour approfondir la théorie derrière ces métriques ou suivre l'évolution du référentiel DORA, ces ressources externes font autorité sur le sujet. Elles sont maintenues directement par le programme DORA ou par les auteurs du livre fondateur Accelerate.
| Ressource | Description |
|---|---|
| DORA.dev | Site officiel du programme DORA avec outils et recherche |
| Guide des métriques DORA | Référence officielle des 5 métriques actuelles (throughput + instability) |
| Rapport DORA 2025 | State of AI-assisted Software Development, impact de l'IA sur la livraison |
| Four Keys | Outil open source de collecte DORA par Google (archivé depuis 2024) |
| Accelerate | Le livre fondateur par Nicole Forsgren, Jez Humble et Gene Kim |
À retenir
Section intitulée « À retenir »Les métriques DORA constituent le standard de mesure de la performance DevOps. Voici les points clés de ce guide :
- 4 métriques historiques mesurent votre performance : Deployment Frequency, Lead Time, Change Failure Rate, MTTR
- Une 5e métrique, le Deployment Rework Rate, a été ajoutée en 2024 pour distinguer les déploiements planifiés des correctifs d'urgence
- 2 dimensions complémentaires : throughput (vélocité) et instability (fiabilité), avec le MTTR reclassé côté throughput dans la version la plus récente
- Le rapport 2024 mesure des équipes Elite qui déploient 182× plus souvent que les équipes Low et se rétablissent 2 293× plus vite ; depuis 2025, DORA préfère la distribution des réponses et 7 profils d'équipe aux catégories fixes
- Collectez automatiquement via webhooks CI/CD et corrélation avec les incidents, ou appuyez-vous sur les métriques natives de votre plateforme (GitLab Ultimate)
- Four Keys est archivé depuis 2024 : utilisez-le comme référence pédagogique, pas comme dépendance de production
- Améliorez une métrique à la fois pour voir l'impact réel, en gardant un œil sur l'effet de l'IA générative sur votre stabilité
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de cette leçon est acquis : la collecte de chaque métrique, les pièges de calcul et les évolutions récentes du référentiel. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Lancer un programme Security Champions
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications
FAQ : questions fréquentes
Section intitulée « FAQ : questions fréquentes »Ces questions reviennent systématiquement au moment de la mise en place, en particulier celles qui portent sur le périmètre à mesurer et sur l'usage managérial des chiffres obtenus.