Imaginez une équipe de développement qui travaille sur une nouvelle fonctionnalité. Le développeur termine son code en 2 jours. Mais entre ce moment et la mise en production, il se passe 6 semaines. Où est passé le temps ? Le code attend une revue (3 jours), puis un environnement de test (1 semaine), puis une validation métier (2 semaines), puis un créneau de déploiement (2 semaines). Le travail réel représente moins de 10% du temps total. C'est exactement le problème que résolvent le Value Stream, le Flow et la Value Stream Mapping, la technique qui cartographie ce flux pour rendre visibles ces semaines perdues.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Cartographier votre flux de valeur pour visualiser où le temps se perd entre l'idée et la production.
- Identifier le goulot d'étranglement qui limite le débit de toute votre chaîne de livraison.
- Réduire la taille des lots pour livrer plus souvent, avec moins de risque par déploiement.
- Limiter le Work In Progress (WIP) pour révéler les blocages qui restent invisibles quand tout semble « en cours ».
- Mesurer le flow avec des indicateurs concrets : Cycle Time, Throughput et Flow Efficiency.
Comment ce concept s'inscrit dans le DevOps
Section intitulée « Comment ce concept s'inscrit dans le DevOps »Le concept de Flow est le premier des Three Ways de Gene Kim, qui structurent la philosophie DevOps :
- First Way, Flow : accélérer le flux de valeur de l'idée à la production ← c'est l'objet de cette leçon
- Second Way, Feedback : raccourcir les boucles de retour d'information
- Third Way, Learning : créer une culture d'apprentissage continu
Le Value Stream Mapping (VSM) est un outil issu du Lean Manufacturing (Toyota Production System) que le DevOps a adapté au développement logiciel. Comprendre le flow est essentiel car toutes les autres pratiques DevOps (CI/CD, automatisation, monitoring) visent à l'améliorer.
Ce n'est pas qu'une théorie datée : la cartographie de flux de valeur reste d'actualité, notamment dans les démarches de Platform Engineering. L'idée est la même que dans les usines Toyota des années 1980, mais elle sert désormais de langage commun entre produit, plateforme et exploitation pour repérer où la valeur stagne dans des chaînes de livraison de plus en plus automatisées.
Qu'est-ce que le Value Stream ?
Section intitulée « Qu'est-ce que le Value Stream ? »Le Value Stream (flux de valeur en français) représente l'ensemble des étapes nécessaires pour transformer une idée en valeur livrée au client. C'est comme une chaîne de production dans une usine, mais appliquée au développement logiciel.
En développement logiciel, le flux de valeur inclut généralement :
| Étape | Ce qui se passe | Valeur pour le client |
|---|---|---|
| Idéation | Une idée ou un besoin est identifié | Aucune (l'idée n'existe que dans les esprits) |
| Spécification | Le besoin est formalisé | Aucune (du papier) |
| Développement | Le code est écrit | Aucune (le code n'est pas déployé) |
| Tests | Le code est validé | Aucune (toujours pas en production) |
| Déploiement | Le code arrive en production | Enfin de la valeur ! |
| Exploitation | Le code est utilisé | Valeur continue |
Qu'est-ce que la Value Stream Mapping (VSM) ?
Section intitulée « Qu'est-ce que la Value Stream Mapping (VSM) ? »La Value Stream Mapping (VSM, cartographie du flux de valeur en français) consiste à dessiner chaque étape du parcours d'une fonctionnalité, de l'idée jusqu'à la production, en notant à chaque étape le temps de travail réel et le temps d'attente. Sans cette vision claire du flux, une équipe ne peut pas savoir où elle perd réellement du temps : elle constate juste que « ça prend longtemps » sans pouvoir désigner l'étape responsable. La VSM révèle trois informations que la gestion de projet classique ignore souvent :
- Le temps de travail réel : combien de temps quelqu'un travaille activement sur la tâche
- Le temps d'attente : combien de temps la tâche attend (revue, validation, environnement...)
- Les transferts : combien de fois la tâche change de mains
Les retours d'expérience Lean citent couramment un temps d'attente de 80 à 90 % du temps total : c'est un ordre de grandeur, que seule votre propre cartographie confirmera, mais c'est presque toujours là que se trouve le gisement d'amélioration.
Le Flow : faire circuler la valeur
Section intitulée « Le Flow : faire circuler la valeur »Le Flow (flux en français) mesure la vitesse à laquelle la valeur traverse votre système. Un bon flow signifie que les idées se transforment rapidement en fonctionnalités utilisables, sans s'accumuler à un point précis de la chaîne.
Les métriques du flow
Section intitulée « Les métriques du flow »Pour mesurer le flow au quotidien, deux indicateurs suffisent pour démarrer :
Le Cycle Time (temps de cycle) mesure la durée entre le début du travail sur une tâche et sa livraison en production. Plus il est court, plus vous livrez vite.
| Cycle Time | Interprétation |
|---|---|
| < 1 jour | Excellent : livraison quasi continue |
| 1-7 jours | Bon : livraison fréquente |
| 1-4 semaines | Moyen : cycles de sprint classiques |
| > 1 mois | Problématique : délais significatifs |
Le Throughput (débit) mesure le nombre de tâches livrées par unité de temps (par jour, par semaine). Il indique la capacité de production de votre équipe.
Pour aller plus loin, le Flow Framework de Mik Kersten (popularisé par son livre Project to Product) formalise cinq métriques complémentaires : Flow Velocity (nombre de tâches terminées), Flow Time (équivalent du Cycle Time), Flow Efficiency (part du temps passé en travail réel versus attente), Flow Load (volume de WIP) et Flow Distribution (répartition entre fonctionnalités, défauts, dette technique et risque). Le repère le plus cité de la littérature Lean reste la Flow Efficiency : on lit souvent qu'elle tourne entre 15 et 25 %, soit 75 à 85 % d'attente pure, un ordre de grandeur cohérent avec celui de la cartographie.
Le flow vu par les métriques DORA
Section intitulée « Le flow vu par les métriques DORA »Les métriques DORA mesurent le flow au niveau organisationnel : la fréquence de déploiement et le lead time sont directement des indicateurs de flow appliqués à l'échelle de l'entreprise. Le rapport State of DevOps 2024 a ajouté un cinquième indicateur officiel, le Deployment Rework Rate (taux de retravail des déploiements), qui mesure la part des déploiements correspondant en réalité à un travail non planifié pour corriger un bug introduit précédemment plutôt qu'à de nouvelles fonctionnalités. Un Deployment Rework Rate élevé est un symptôme direct d'un flow dégradé : du travail est produit, mais il ne progresse pas vers la production, ce qui rejoint exactement le paradoxe de l'activité sans valeur décrit dans les pièges courants.
Les goulots d'étranglement
Section intitulée « Les goulots d'étranglement »Un goulot d'étranglement (bottleneck en anglais) est une étape du flux qui limite le débit global du système. C'est le point le plus lent, celui qui fait attendre tout le reste.
Identifier vos goulots
Section intitulée « Identifier vos goulots »Les goulots courants dans le développement logiciel se repèrent souvent aux mêmes symptômes récurrents, avant même de sortir un outil de mesure :
| Symptôme | Goulot probable | Impact |
|---|---|---|
| Files d'attente longues pour les revues de code | Pas assez de reviewers disponibles | Les développeurs attendent, changent de contexte |
| Environnements de test indisponibles | Infrastructure partagée sous-dimensionnée | Les tests sont retardés ou bâclés |
| Approbations manuelles qui traînent | Processus de validation bureaucratique | Des semaines perdues en attente de signatures |
| Déploiements risqués et rares | Peur de casser la production | Gros lots, gros risques, gros délais |
| Une personne indispensable | Connaissances concentrées sur un expert | Tout s'arrête quand cette personne est absente |
La théorie des contraintes
Section intitulée « La théorie des contraintes »Eliyahu Goldratt, dans son livre The Goal, a formalisé une idée contre-intuitive mais fondamentale :
Optimiser une étape qui n'est pas le goulot n'améliore pas le débit global du système.
Cela signifie que si votre goulot est la revue de code, améliorer la vitesse de vos déploiements ne changera rien. Les tâches continueront de s'empiler devant la revue de code.
La taille des lots (Batch Size)
Section intitulée « La taille des lots (Batch Size) »La taille des lots désigne la quantité de travail regroupée avant d'être livrée. Dans le développement logiciel, c'est le nombre de fonctionnalités ou de modifications incluses dans une release.
Pourquoi les petits lots sont-ils meilleurs ?
Section intitulée « Pourquoi les petits lots sont-ils meilleurs ? »Réduire la taille des lots ne change rien au volume total de travail à livrer sur l'année, mais cela change radicalement la façon dont ce travail se comporte à chaque étape du flux. Le tableau suivant compare les deux stratégies sur cinq critères concrets, du risque au niveau de stress de l'équipe :
| Aspect | Gros lots (release trimestrielle) | Petits lots (release quotidienne) |
|---|---|---|
| Risque | Élevé : beaucoup de changements = beaucoup de bugs potentiels | Faible : peu de changements = problèmes faciles à isoler |
| Feedback | Lent : 3 mois avant de savoir si ça plaît aux utilisateurs | Rapide : retour utilisateur en quelques heures |
| Correction | Coûteuse : le développeur a oublié le contexte | Peu coûteuse : le contexte est frais |
| Coordination | Complexe : nombreux conflits, merges difficiles | Simple : modifications isolées |
| Stress | Intense : la release est un événement critique | Minimal : la release est un non-événement |
Le paradoxe du risque
Section intitulée « Le paradoxe du risque »Intuitivement, on pourrait penser que faire moins de releases réduit le risque (« moins on touche, moins on casse »). C'est l'inverse qui est vrai :
- Gros lots = gros risques : des centaines de changements, des dizaines de développeurs impliqués, des semaines de travail en jeu. Si ça casse, c'est la panique.
- Petits lots = petits risques : quelques lignes modifiées, un développeur concerné, quelques heures de travail. Si ça casse, on revient en arrière et on corrige tranquillement.
Work In Progress (WIP)
Section intitulée « Work In Progress (WIP) »Le Work In Progress (travail en cours) désigne le nombre de tâches commencées mais pas encore terminées. C'est une métrique souvent négligée mais cruciale pour le flow.
Les effets d'un WIP élevé
Section intitulée « Les effets d'un WIP élevé »Un WIP élevé ne se contente pas de ralentir une tâche isolée : il dégrade le fonctionnement de toute l'équipe, souvent sans que personne ne s'en rende compte parce que chacun a l'impression d'être occupé. Voici les cinq effets les plus fréquents observés quand trop de tâches sont ouvertes en même temps :
| WIP élevé cause... | Parce que... |
|---|---|
| Changements de contexte | Vous passez d'une tâche à l'autre sans cesse, perdant du temps à chaque switch |
| Rallongement du Cycle Time | Chaque tâche attend son tour plus longtemps |
| Baisse de qualité | L'attention est dispersée, les erreurs se multiplient |
| Stress et surcharge | La liste des choses « en cours » est écrasante |
| Masquage des problèmes | Les goulots sont invisibles car tout est « en cours » |
Limiter le WIP pour révéler les problèmes
Section intitulée « Limiter le WIP pour révéler les problèmes »Limiter le WIP signifie fixer un nombre maximum de tâches pouvant être en cours simultanément à chaque étape du flux.
Exemple concret : Une équipe limite le nombre de tâches « En revue de code » à 3. Si 3 tâches sont déjà en revue, les développeurs qui terminent leur code ne peuvent pas en ajouter une 4ᵉ. Ils doivent d'abord aider à vider la file de revue.
Cet effet est bénéfique :
- Force à finir avant de commencer : plus d'accumulation de travail inachevé
- Révèle les goulots : si une colonne est toujours pleine, c'est le goulot
- Encourage la collaboration : on aide les autres pour débloquer le flux
Scénario concret : une équipe qui améliore son flow
Section intitulée « Scénario concret : une équipe qui améliore son flow »Situation initiale : L'équipe Produit A déploie une fois par mois. Le Cycle Time moyen dépasse 5 semaines. Les développeurs sont frustrés car leurs fonctionnalités mettent « une éternité » à arriver en production.
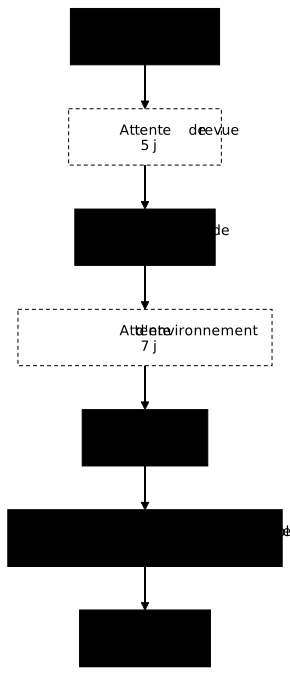
Étape 1, Cartographier le flux : L'équipe dessine son flux de valeur et mesure les temps à chaque étape :
- Développement : 3 jours (travail)
- Attente revue : 5 jours (attente)
- Revue : 1 jour (travail)
- Attente test : 7 jours (attente)
- Test : 2 jours (travail)
- Attente déploiement : 18 jours (attente)
- Déploiement : 1 jour (travail)
Constat : 7 jours de travail, 30 jours d'attente, soit une Flow Efficiency d'environ 19 %. Le goulot est l'attente du créneau de déploiement mensuel. Le schéma met la cartographie à plat :
Étape 2, Attaquer le goulot : L'équipe automatise ses déploiements dans un pipeline CI/CD et passe à des releases hebdomadaires. L'attente déploiement passe de 18 à 4 jours en moyenne.
Étape 3, Nouveau goulot révélé : Maintenant, c'est l'attente test qui devient le goulot (7 jours). L'équipe investit dans l'automatisation des tests et la parallélisation des environnements.
Résultat après 6 mois :
- Déploiements quotidiens
- Cycle Time moyen : 5 jours
- L'équipe livre 10x plus de fonctionnalités par trimestre
Pièges courants
Section intitulée « Pièges courants »Ces cinq erreurs reviennent chez la plupart des équipes qui découvrent le flow : toutes consistent à agir là où l'effort se voit, plutôt que là où le débit se joue.
À retenir
Section intitulée « À retenir »-
Le Value Stream est le chemin complet de l'idée à la production. Seule la production génère de la valeur pour le client.
-
Le temps d'attente domine : l'ordre de grandeur couramment cité est de 80 à 90 % du Cycle Time en attente, pas en travail, et une Flow Efficiency autour de 15 à 25 %. Mesurez le vôtre.
-
Un seul goulot limite tout : identifiez-le et concentrez vos efforts dessus. Améliorer ailleurs ne sert à rien.
-
Petits lots = moins de risques : contrairement à l'intuition, les releases fréquentes de petites modifications sont plus sûres que les grosses releases rares.
-
Limiter le WIP révèle les problèmes : moins de tâches en cours = meilleur focus, plus de visibilité sur les goulots.
-
Mesurez pour progresser : Cycle Time, Throughput et Flow Efficiency sont vos indicateurs clés. Ce que vous ne mesurez pas, vous ne pouvez pas l'améliorer.
-
Le Deployment Rework Rate est un signal de flow dégradé : un taux de retravail élevé (cinquième métrique DORA depuis le rapport State of DevOps 2024) trahit un travail qui recule au lieu d'avancer vers la production.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de ce guide est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Team Topologies : structurer ses équipes DevOps
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications
Checklist
Section intitulée « Checklist »Avant de considérer votre démarche Value Stream et Flow comme lancée, vérifiez que ces six points sont bien couverts. Cette liste sert de point de passage : si l'une des cases reste vide, c'est probablement là que se cache votre prochain gain de vitesse.
- Value stream cartographié avec temps de travail ET temps d'attente
- Goulot principal identifié (étape avec la plus longue file d'attente)
- Limite de WIP définie pour chaque étape du flux
- Taille de lot cible définie (viser des releases quotidiennes ou hebdomadaires)
- Métriques de flow en place (Cycle Time, Throughput, Flow Efficiency)
- Plan d'action pour réduire le goulot principal
FAQ : questions fréquentes
Section intitulée « FAQ : questions fréquentes »Les questions ci-dessous reprennent les doutes les plus fréquents sur le Value Stream et le Flow : leur différence, la cartographie et la mesure du flux.