Un nœud NotReady est un nœud dont le kubelet ne donne plus de nouvelles au
plan de contrôle, et la cause se lit sur le nœud, pas depuis kubectl. Le
kubelet est l'agent qui tourne sur chaque nœud : il lance les conteneurs et
signale régulièrement l'état de sa machine à l'API server. Quand il s'arrête,
ne démarre plus ou n'est pas relancé au démarrage, le nœud devient
NotReady, ses Pods se dégradent et les applications qui lui sont réservées
tombent. Cette leçon vous apprend à lire les conditions du nœud, à interroger
son service et son journal, à réparer sans casser, et à vérifier que tout est
revenu pour de bon. Elle suppose que l'API server répond : pour un cluster dont
kubectl est lui-même muet, voir
Diagnostiquer une panne du plan de contrôle.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Lire les conditions d'un nœud
NotReadyaveckubectl describe node, et l'heure de son dernier signe de vie - Se connecter au nœud et lire l'état du service avec
systemctl status kubelet, puis son journal avecjournalctl -u kubelet - Réparer une configuration du kubelet invalide, dans
/var/lib/kubelet/config.yaml, sans la supprimer - Rendre un kubelet durable avec
systemctl enable --nowet vérifier qu'il survivra à un redémarrage - Vérifier que les Pods du nœud reviennent
- Réparer plusieurs pannes à la fois, sans procédure, dans un challenge noté sur l'état du cluster
Prérequis
Section intitulée « Prérequis »- Un cluster kubeadm avec un accès SSH aux workers et des droits
sudosur eux : les commandes lancées sur un nœud (systemctl,journalctl, fichiers sous/var/lib/kubelet) demandent les droits root - La leçon Diagnostiquer une panne du plan de contrôle, qui présente
crictl,journalctlet la notion de Pod statique - Le rôle du kubelet, vu dans Fonctionnement des Worker Nodes
- La méthode de diagnostic d'un incident, qui vous aide à décider si le problème est bien au niveau du nœud
Le kubelet est un service systemd : systemd est le gestionnaire de
services de la machine, et systemctl en est la commande de pilotage. Le guide
Un service ne démarre pas
en détaille la lecture. Un
service y a deux états indépendants, qui servent dans toute la leçon : il peut
tourner maintenant ou non (active), et il peut être lancé automatiquement au
démarrage ou non (enabled).
Que signifie NotReady ?
Section intitulée « Que signifie NotReady ? »NotReady veut dire que le plan de contrôle n'a plus reçu de signal du kubelet du nœud. Le kubelet envoie un signe de vie régulier à l'API server, appelé heartbeat. Quand ce signe de vie manque trop longtemps, le plan de contrôle
passe la condition Ready du nœud à Unknown, et kubectl get nodes affiche
NotReady. Le nœud est alors marqué comme injoignable, et les Pods qui s'y
trouvent finissent par être évincés. Le détail du fonctionnement des nœuds est
dans Fonctionnement des Worker Nodes.
Le délai avant éviction n'est pas un réglage du contrôleur : c'est une tolérance posée automatiquement sur chaque Pod à sa création. Vous la lisez sur n'importe quel Pod, par exemple un Pod CoreDNS : la première commande donne son nom, que vous recopiez dans la seconde.
kubectl get pod -n kube-system -l k8s-app=kube-dns -o namekubectl get pod -n kube-system <nom-du-pod-coredns> -o jsonpath='{.spec.tolerations}'[{"key":"CriticalAddonsOnly","operator":"Exists"},{"effect":"NoSchedule","key":"node-role.kubernetes.io/control-plane"},{"effect":"NoExecute","key":"node.kubernetes.io/not-ready","operator":"Exists","tolerationSeconds":300},{"effect":"NoExecute","key":"node.kubernetes.io/unreachable","operator":"Exists","tolerationSeconds":300}]Les deux premières tolérances sont propres à CoreDNS, qui doit pouvoir tourner
sur le plan de contrôle. Les deux dernières, not-ready et unreachable,
sont posées automatiquement sur tous les Pods. Regardez tolerationSeconds sur ces deux entrées : il donne le nombre de secondes pendant lesquelles
le Pod accepte de rester sur un nœud NotReady ou injoignable, avant d'être
évincé. Comme c'est une tolérance, elle se règle par charge de travail : un
service qui doit basculer vite abaisse ses tolerationSeconds, un traitement
long les allonge.
Une application réservée à un nœud par un nodeSelector n'a nulle part
ailleurs où aller. Quand ce nœud tombe, ses Pods sont évincés puis restent
Pending : l'application est dégradée tant que le nœud n'est pas revenu.
Comment lire les conditions d'un nœud NotReady ?
Section intitulée « Comment lire les conditions d'un nœud NotReady ? »kubectl get nodes signale le symptôme, mais kubectl describe node contient
la réponse. Les conditions listées dans la section Conditions distinguent
deux situations très différentes : un nœud à court de ressources, où
MemoryPressure, DiskPressure ou PIDPressure valent True, et un nœud qui ne communique plus du tout, où toutes les conditions passent à Unknown.
kubectl describe node k8s-w1.labName: k8s-w1.lab[...]Taints: node.kubernetes.io/unreachable:NoExecute node.kubernetes.io/unreachable:NoSchedule[...]Conditions: Type Status LastHeartbeatTime LastTransitionTime Reason Message ---- ------ ----------------- ------------------ ------ ------- NetworkUnavailable False Tue, 10 Nov 2026 22:38:46 +0000 Tue, 10 Nov 2026 22:38:46 +0000 CalicoIsUp Calico is running on this node MemoryPressure Unknown Tue, 10 Nov 2026 22:38:54 +0000 Tue, 10 Nov 2026 22:39:44 +0000 NodeStatusUnknown Kubelet stopped posting node status. DiskPressure Unknown Tue, 10 Nov 2026 22:38:54 +0000 Tue, 10 Nov 2026 22:39:44 +0000 NodeStatusUnknown Kubelet stopped posting node status. PIDPressure Unknown Tue, 10 Nov 2026 22:38:54 +0000 Tue, 10 Nov 2026 22:39:44 +0000 NodeStatusUnknown Kubelet stopped posting node status. Ready Unknown Tue, 10 Nov 2026 22:38:54 +0000 Tue, 10 Nov 2026 22:39:44 +0000 NodeStatusUnknown Kubelet stopped posting node status.[...]Regardez trois choses dans cette sortie :
- Le statut
UnknownsurMemoryPressure,DiskPressure,PIDPressureetReady, avec le messageKubelet stopped posting node status. Aucune pression de ressources n'est signalée : c'est le kubelet qui s'est tu, et il faut aller voir le nœud. LastHeartbeatTime, qui donne l'heure du dernier signe de vie (22:38:54 ici). Elle dit depuis quand le nœud est silencieux, donc quel changement a pu le provoquer. Dans cette capture, le plan de contrôle a passé les conditions àUnknown50 secondes plus tard (LastTransitionTime, 22:39:44).NetworkUnavailable, qui reste àFalse. Cette condition est posée par le plugin réseau (ici Calico), pas par le kubelet : sa valeur est figée et ne dit rien de la panne.
Les deux marques node.kubernetes.io/unreachable des Taints confirment que le
nœud est considéré comme injoignable.
Si au contraire une condition de pression vaut True, le nœud manque de
ressources et ses Pods peuvent être évincés : voyez la section « Le nœud
manque-t-il de ressources ? ».
Comment retrouver la cause sur le nœud ?
Section intitulée « Comment retrouver la cause sur le nœud ? »Connectez-vous au nœud, puis posez deux questions dans cet ordre : le service tient-il, et que dit son journal ? Le schéma suivant résume le chemin depuis le symptôme. Regardez d'abord le losange du haut, qui sépare un nœud à court de ressources d'un kubelet silencieux, puis l'état du service, qui oriente vers la bonne lecture du journal.
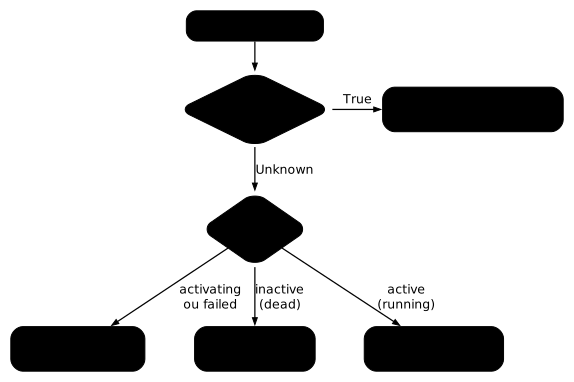
Les sorties de cette section viennent de pannes différentes, provoquées l'une après l'autre sur le même worker : leurs heures ne se suivent donc pas d'une capture à l'autre.
ssh k8s-w1.labsudo systemctl status kubelet● kubelet.service - kubelet: The Kubernetes Node Agent Loaded: loaded (/usr/lib/systemd/system/kubelet.service; enabled; preset: enabled) Drop-In: /usr/lib/systemd/system/kubelet.service.d └─10-kubeadm.conf Active: activating (auto-restart) (Result: exit-code) since Tue 2026-11-10 22:38:48 UTC; 5s ago Docs: https://kubernetes.io/docs/ Process: 66192 ExecStart=/usr/bin/kubelet $KUBELET_KUBECONFIG_ARGS $KUBELET_CONFIG_ARGS $KUBELET_KUBEADM_ARGS $KUBELET_EXTRA_ARGS (code=exited, status=1/FAILURE) Main PID: 66192 (code=exited, status=1/FAILURE) CPU: 30msDeux lignes comptent. Active dit si le service tourne : inactive (dead)
veut dire arrêté, activating (auto-restart) veut dire qu'il démarre, plante
et que systemd le relance en boucle. Loaded dit si le service démarrera au
prochain démarrage de la machine : enabled ou disabled. Ce sont deux informations distinctes, expliquées dans la section « Un service arrêté ou
désactivé : quelle différence ? ».
Ensuite, le journal. Il donne l'erreur exacte quand le service plante :
sudo journalctl -u kubelet --no-pager -n 20Ne redémarrez pas le service avant d'avoir lu cette sortie : un kubelet qui repart sans que sa cause soit corrigée retombe aussitôt.
Un service arrêté ou désactivé : quelle différence ?
Section intitulée « Un service arrêté ou désactivé : quelle différence ? »Un service systemd a deux états indépendants, et un incident peut toucher l'un,
l'autre, ou les deux. Arrêté (systemctl stop), le service ne tourne plus mais
repartira au prochain démarrage de la machine. Désactivé (systemctl disable),
il ne sera plus lancé au démarrage. Un service arrêté et désactivé reste donc
absent après un redémarrage, et un systemctl start seul n'y change rien :
il règle le premier état et laisse le second. La commande systemctl enable --now <service> règle les deux : enable crée l'activation au démarrage,
--now lance aussi le service tout de suite.
Voici le cas sur containerd, le runtime du nœud, que le kubelet utilise pour
lancer les conteneurs. Après sudo systemctl disable --now containerd, qui
arrête et désactive le service d'un coup, les deux états se lisent séparément.
sudo systemctl status containerd --no-pagersystemctl is-enabled containerd○ containerd.service - containerd container runtime Loaded: loaded (/usr/lib/systemd/system/containerd.service; disabled; preset: enabled) Active: inactive (dead) since Tue 2026-11-10 22:40:48 UTC; 225ms ago[...]disabledActive: inactive (dead) répond à « tourne-t-il maintenant ? », et Loaded: ... disabled avec la sortie disabled de systemctl is-enabled répond à
« repartira-t-il seul ? ». La commande qui règle les deux est sudo systemctl enable --now containerd : elle crée le lien d'activation
(Created symlink /etc/systemd/system/multi-user.target.wants/containerd.service)
et lance le service. Lire enabled revient ensuite à dire que le service survivra à un redémarrage de la machine. Sans cette lecture, une réparation ne
tient que jusqu'au prochain redémarrage. La même vérification s'applique au
kubelet.
Le kubelet refuse de démarrer : que lit-on dans son journal ?
Section intitulée « Le kubelet refuse de démarrer : que lit-on dans son journal ? »Si systemctl status montre activating (auto-restart) ou failed, le
service démarre puis s'arrête aussitôt. Le journal nomme le fichier qu'il
n'arrive pas à lire et, selon l'erreur, la ligne ou le champ en cause. Voici un
exemple où un champ de la configuration du kubelet porte une valeur d'un
mauvais type. Pour le reproduire sur un worker de test, gardez d'abord une
copie du fichier (l'encadré « Pour reproduire sans risque », en fin de leçon,
donne aussi le retour arrière), ajoutez une ligne maxPods: "cent" à la fin de
la configuration et redémarrez le kubelet :
sudo cp /var/lib/kubelet/config.yaml /var/lib/kubelet/config.yaml.origecho 'maxPods: "cent"' | sudo tee -a /var/lib/kubelet/config.yamlsudo systemctl restart kubeletPuis lisez le journal :
sudo journalctl -u kubelet -n 20 --no-pager[...]Nov 10 22:38:38 k8s-w1.lab kubelet[66168]: E1110 22:38:38.630405 66168 run.go:72] "command failed" err="failed to load kubelet config file, path: /var/lib/kubelet/config.yaml, error: failed to load Kubelet config file /var/lib/kubelet/config.yaml, error failed to decode: json: cannot unmarshal string into Go struct field KubeletConfiguration.maxPods of type int32"Nov 10 22:38:38 k8s-w1.lab systemd[1]: kubelet.service: Main process exited, code=exited, status=1/FAILURENov 10 22:38:38 k8s-w1.lab systemd[1]: kubelet.service: Failed with result 'exit-code'.Nov 10 22:38:48 k8s-w1.lab systemd[1]: kubelet.service: Scheduled restart job, restart counter is at 1.[...]La première ligne contient tout ce qu'il faut : le fichier
(/var/lib/kubelet/config.yaml), le champ fautif (maxPods) et la nature du
problème (une chaîne là où un entier est attendu). Les lignes suivantes disent
seulement que systemd a vu le processus sortir en erreur, puis qu'il le
relance dix secondes après (Scheduled restart job) : c'est la première ligne qui explique.
Réparer signifie corriger ce champ, pas supprimer le fichier : sans lui, le kubelet perd les réglages que kubeadm y a écrits à la jointure du nœud. Ouvrez le fichier, corrigez la valeur, puis relancez le service.
sudo grep -n maxPods /var/lib/kubelet/config.yamlsudo sed -i 's/^maxPods:.*/maxPods: 110/' /var/lib/kubelet/config.yamlsudo grep -n maxPods /var/lib/kubelet/config.yamlsudo systemctl restart kubeletsystemctl is-active kubeletLa valeur de maxPods doit être un entier, par exemple 110. Le sed
remplace la ligne maxPods: que vous avez ajoutée plus haut : sur un fichier
qui n'en contient pas, le premier grep ne rend rien et le sed ne change
rien. Une fois la ligne corrigée, systemctl is-active kubelet doit répondre
active, et le nœud repasse Ready en quelques secondes.
Quand une valeur est à réécrire plutôt qu'à corriger, ne la devinez pas : reprenez-la dans une copie saine du fichier, ou dans la ressource du cluster dont elle provient.
Le tableau suivant regroupe d'autres causes courantes, avec le message qui les signe. Les deux premières lignes s'appuient sur des sorties de cette leçon (configuration illisible ci-dessus, runtime arrêté dans la section suivante). Les trois dernières donnent des messages typiques, comme indices : le texte exact change avec la version et la configuration, cherchez donc le mot-clé plutôt que la phrase entière.
| Cause | Message dans journalctl (ou describe node) | Que faire |
|---|---|---|
| Configuration illisible | failed to load kubelet config file | Corriger la ligne indiquée dans /var/lib/kubelet/config.yaml |
| Runtime arrêté | dial unix /var/run/containerd/containerd.sock: connect: no such file or directory | systemctl status containerd, puis le relancer |
| Certificat expiré | certificate has expired | Voir le guide kubeadm pour les certificats |
| Mauvais serveur d'API | dial tcp <ip>:6443: connect: connection refused | Contrôler le champ server de /etc/kubernetes/kubelet.conf |
| Réseau des Pods absent | NetworkReady=false reason:NetworkPluginNotReady, et la condition Ready à False dans describe node avec le message container runtime network not ready | Vérifier les Pods du plugin réseau, voir CNI, CSI et CRI |
Les pannes typiques d'un kubelet sont subtiles : un chemin modifié d'un caractère, un drapeau inconnu, un runtime arrêté. Aucune ne se devine, toutes se lisent dans le journal.
Le runtime de conteneurs est-il en cause ?
Section intitulée « Le runtime de conteneurs est-il en cause ? »Le kubelet dépend d'un runtime de conteneurs, containerd sur un cluster kubeadm. Si le runtime est arrêté, le kubelet ne peut plus créer de conteneur, et il se plaint dans son journal. La vérification suit la même logique que pour le kubelet : état, puis journal.
Quand containerd est arrêté, le journal du kubelet se remplit d'erreurs qui nomment le socket du runtime.
sudo journalctl -u kubelet -n 20 --no-pager[...]Nov 10 22:40:44 k8s-w1.lab kubelet[66697]: E1110 22:40:44.749011 66697 remote_runtime.go:435] "ListPodSandbox with filter from runtime service failed" err="rpc error: code = Unavailable desc = connection error: desc = \"transport: Error while dialing: dial unix /var/run/containerd/containerd.sock: connect: no such file or directory\"" filter=""[...]Nov 10 22:40:46 k8s-w1.lab kubelet[66697]: E1110 22:40:46.747942 66697 kubelet.go:3328] "Container runtime sanity check failed" err="rpc error: code = Unavailable desc = connection error: desc = \"transport: Error while dialing: dial unix /var/run/containerd/containerd.sock: connect: no such file or directory\""[...]Le motif à reconnaître est dial unix /var/run/containerd/containerd.sock: connect: no such file or directory : le kubelet ne trouve plus le runtime.
Lisez alors systemctl status containerd et systemctl is-enabled containerd,
comme décrit plus haut, pour savoir si le service est arrêté, désactivé, ou les
deux. Relancer le kubelet ne sert à rien tant que containerd est à l'arrêt :
réparez d'abord le runtime.
Le nœud manque-t-il de ressources ?
Section intitulée « Le nœud manque-t-il de ressources ? »Quand le nœud manque de mémoire, de disque ou de processus, le kubelet pose les
conditions MemoryPressure, DiskPressure ou PIDPressure à True et
commence à évincer des Pods. Le kubelet calcule ces conditions à partir de ses
propres seuils d'éviction, qui dépendent de sa configuration. Par défaut sur
Linux, Kubernetes applique notamment memory.available<100Mi,
nodefs.available<10% et imagefs.available<15%. Le calcul ne se limite pas
à free -m ni à /var/lib/kubelet.
df -h /var/lib/kubeletfree -msudo crictl rmi --pruneSur un nœud en DiskPressure, crictl rmi --prune supprime les images
inutilisées : cela libère de la place sans toucher aux Pods qui tournent.
Le kubelet réévalue ses signaux d'éviction environ toutes les dix secondes,
mais il garde la condition à True pendant cinq minutes après le retour sous
le seuil (evictionPressureTransitionPeriod, 5 minutes par défaut) : la
condition ne retombe donc pas aussitôt après le nettoyage.
Comment vérifier que le nœud est revenu pour de bon ?
Section intitulée « Comment vérifier que le nœud est revenu pour de bon ? »Un nœud Ready ne suffit pas à clore l'incident : il faut vérifier le nœud, le
service et les Pods qui lui étaient réservés. Commencez depuis le plan de
contrôle.
kubectl get nodeskubectl get deploy -n <namespace> <deployment>kubectl get pods -n <namespace> -l <label> -o wideNAME STATUS ROLES AGE VERSIONk8s-cp.lab Ready control-plane 56m v1.37.2k8s-w1.lab Ready <none> 55m v1.37.2La sortie ci-dessus est celle de kubectl get nodes ; les deux autres
commandes dépendent de votre application. Regardez trois éléments : le nœud est Ready, les colonnes READY et
AVAILABLE du Deployment affichent le nombre de replicas voulus (par exemple
3/3 dans READY), et la colonne NODE des Pods montre le nœud que vous
venez de réparer. Un READY de 0/3, ou un Pod placé sur un autre nœud que
celui attendu, signale que la réparation n'est pas terminée. Le nœud peut mettre
quelques secondes à repasser Ready : relancez kubectl get nodes avant de
conclure à un échec.
Terminez par la vérification de la durée de vie du correctif, cette fois sur le worker (ssh k8s-w1.lab) :
systemctl is-active kubelet && systemctl is-enabled kubeletLes deux réponses active et enabled assurent que le kubelet tourne et
qu'il repartira seul. Une réparation qui ne passe pas ce dernier contrôle ne tient que jusqu'au
prochain redémarrage.
Mettre en pratique
Section intitulée « Mettre en pratique »Deux labs reprennent ces pannes sur un cluster kubeadm réel, un control plane et
un worker en machines virtuelles. Dans le premier, le kubelet d'un worker
s'arrête aussitôt lancé et le nœud est NotReady : vous lisez dans le journal ce
qu'il reproche à sa configuration, vous corrigez le fichier sans rien casser
d'autre, et la validation vérifie que le nœud est Ready, que l'adresse
légitime du DNS du cluster est restée dans la configuration, et que
l'application revient avec ses trois replicas. Lancez-le avec
dsoxlab start cka-troubleshoot-kubelet.
Dans le second, un worker est passé NotReady et l'application qui lui est
réservée est dégradée. Vous trouvez sur le nœud pourquoi il ne parle plus au
control plane, vous remettez son agent en service de façon durable, et la
validation lit l'état du nœud, l'état du service sur le worker lui-même, et celui
du Deployment. Lancez-le avec dsoxlab start cka-troubleshoot-node-notready.
Challenge : remettre en service une application en panne et son cluster
Section intitulée « Challenge : remettre en service une application en panne et son cluster »Le challenge est la preuve sans aide du module « Opérer Kubernetes », et il est noté sur l'état du cluster que vous laissez, pas sur les commandes tapées. Sur un cluster kubeadm, quatre pannes sont en cours en même temps : un Deployment qui redémarre en boucle, un Pod dont l'image ne se télécharge pas, un API server qui ne démarre plus et un worker dont le kubelet est tombé. Vous les réparez sans procédure, et vous consignez la cause de chacune dans un fichier avant de la réparer.
La validation lit dix états, sans solution ni valeur à recopier. Le Deployment api a ses deux réplicas disponibles, aucun de ses Pods ne redémarre en boucle, et il lit sa configuration à l'endroit demandé. Le Pod vitrine tourne sur une image réellement tirée par le nœud et répond en HTTP. L'API server répond de nouveau, son Pod statique est stable et son manifeste ne porte plus le flag fautif. Le worker est Ready avec une configuration de kubelet valide, ce kubelet survivra à un redémarrage de la machine, et l'application entrepot retrouve ses trois réplicas sur lui.
La réussite demande 70 points sur 100. Deux exigences sont bloquantes et doivent réussir quel que soit le total : les causes consignées avant chaque réparation, et l'API server rétabli. Pendant que vous travaillez, dsoxlab check liste ce qui échoue encore. Un état qui échoue vous dit ce qui manque, sans dire comment le corriger : la leçon à reprendre est celle qui enseigne cet état. Le challenge s'appuie sur cette leçon, sur Méthode de diagnostic d'un incident Kubernetes, Analyser les événements Kubernetes, Diagnostiquer un CrashLoopBackOff, Diagnostiquer un ImagePullBackOff, Diagnostiquer une panne du plan de contrôle et Observer la santé d'un cluster.
À retenir
Section intitulée « À retenir »- Un nœud
NotReadyest un nœud dont le kubelet ne signale plus son état.kubectl describe nodedonne l'heure du dernier signe de vie dansLastHeartbeatTime. - Des conditions
UnknownavecKubelet stopped posting node statusdésignent un kubelet silencieux. Une condition de pression àTruedésigne un nœud à court de ressources. - La cause se lit sur le nœud :
systemctl status kubeletpour l'état du service,journalctl -u kubeletpour l'erreur exacte. - Un service peut être arrêté ou désactivé.
systemctl is-activeetsystemctl is-enabledles distinguent. systemctl enable --now <service>lance un service et l'active au démarrage. Lireenabledprouve qu'il survivra à un redémarrage, kubelet compris.- Quand le kubelet refuse de démarrer à cause de
/var/lib/kubelet/config.yaml, on corrige la ligne signalée par le journal et on garde le fichier, avec les réglages de kubeadm. - Les Pods d'un nœud
NotReadysont évincés après le délai de la tolérance posée sur chaque Pod, lisible danstolerationSeconds. - Un incident est clos quand le nœud est
Ready, que le Deployment retrouve ses replicas disponibles et que le kubelet estactiveetenabled.
Testez vos connaissances
Section intitulée « Testez vos connaissances »Huit questions pour trancher entre un nœud arrêté, un nœud désactivé et un kubelet qui ne sait plus lire sa configuration, puis vérifier que la réparation tient.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Maintenance et changements
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications