Pour rendre une application conforme au 12-factor sur Kubernetes, on ne coche pas une liste : on mesure, facteur par facteur, ce que le cluster garantit et ce qu'il laisse à l'application. Cette leçon déploie podinfo et Redis sur un cluster kind, puis audite chaque facteur avec une commande et une sortie réelle : configuration injectée, Redis remplaçable par une variable, historique des révisions, Pod supprimé sans perte, arrêt propre, logs, Job d'administration. Elle montre aussi quatre contre-exemples mesurés et nomme les facteurs qu'aucun objet Kubernetes ne vérifie à votre place.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Associer chaque facteur à l'objet ou au réglage Kubernetes qui le porte, dans une grille d'audit.
- Prouver qu'une configuration change sans toucher à l'image, et que Redis se remplace par une variable.
- Lire l'historique d'un Deployment comme la trace des releases.
- Supprimer un Pod pour vérifier que l'état vit ailleurs, et voir ce qui casse quand il vit sur le disque du Pod.
- Mesurer l'effet de SIGTERM et de
preStopsur un rolling restart. - Repérer les facteurs que Kubernetes ne vérifie pas seul.
Prérequis
Section intitulée « Prérequis »La théorie des douze facteurs est dans la leçon Les principes du cloud native : ici, on ne la refait pas, on l'audite. Le principe sans état et le couplage faible sont aussi traités dans Loose coupling et stateless design.
Les objets Kubernetes utilisés sont supposés connus : Deployment, Service, ConfigMap, Secret, sondes, Job et rolling update. Il vous faut Docker, kind et kubectl en local (plus jq pour un seul filtre de logs). Toutes les durées et tous les compteurs de la leçon viennent d'exécutions réelles sur un poste de travail : ils montrent un ordre de grandeur, pas une valeur garantie. Les mesures viennent de kind v0.33.0, d'un nœud kindest/node:v1.37.0 et de kubectl v1.36.0, qui embarque kustomize v5.8.1.
Quels facteurs Kubernetes vérifie-t-il, et lesquels non ?
Section intitulée « Quels facteurs Kubernetes vérifie-t-il, et lesquels non ? »Kubernetes porte la plupart des facteurs par un objet précis, mais il n'en vérifie aucun à votre place. Il applique ce que vous déclarez : si le disque du Pod contient l'état de l'application, il ne le détecte pas. La grille ci-dessous sert de plan d'audit. Chaque ligne donne l'objet ou le réglage, le geste qui prouve le facteur et le résultat mesuré dans le lab.
| Facteur | Objet ou réglage Kubernetes | Preuve observable | Résultat mesuré |
|---|---|---|---|
| I. Base de code | aucun (dépôt Git) | hors cluster | non vérifié par Kubernetes |
| II. Dépendances | image autonome | dépendances embarquées dans l'image, aucune installation au démarrage | podcli et curl viennent de l'image |
| III. Configuration | ConfigMap, Secret, envFrom | patch puis rollout restart | message changé en 2,95 s, image inchangée |
| IV. Services externes | Service redis, variable PODINFO_CACHE_SERVER | pointer vers un second Redis | 404 sur l'autre Redis, 200 au retour |
| V. Build, release, run | image par digest, révisions du Deployment | rollout history, undo | 5 révisions, undo renumérote |
| VI. Processus | Pod sans volume, état dans Redis | kubectl delete pod | donnée intacte |
| VII. Associations de ports | port nommé http, Service | wget http://podinfo/ depuis un Pod | l'application écoute elle-même sur 9898 |
| VIII. Concurrence | replicas | kubectl scale | 4 Pods Ready en moins de 2 s |
| IX. Jetable | sondes, SIGTERM, preStop | suppression et rolling restart | 0 erreur avec preStop, 309 sans |
| X. Parité dev/prod | kustomize base et overlays | diff des deux rendus | 4 différences, toutes déclarées |
| XI. Logs | stdout du conteneur | kubectl logs | une ligne JSON par événement |
| XII. Administration | Job, même image, même config | kubectl wait | Job terminé en 4,1 s |
Trois facteurs échappent au cluster. Le I (un dépôt par application) et le II (dépendances déclarées explicitement et isolées) se jugent dans le dépôt et le Dockerfile, pas dans kubectl. Le X est à moitié vérifiable : on compare ce qui est déployé, mais Kubernetes ne dit pas si votre Redis de production ressemble à celui du développement. Les sections suivantes montrent ces limites.
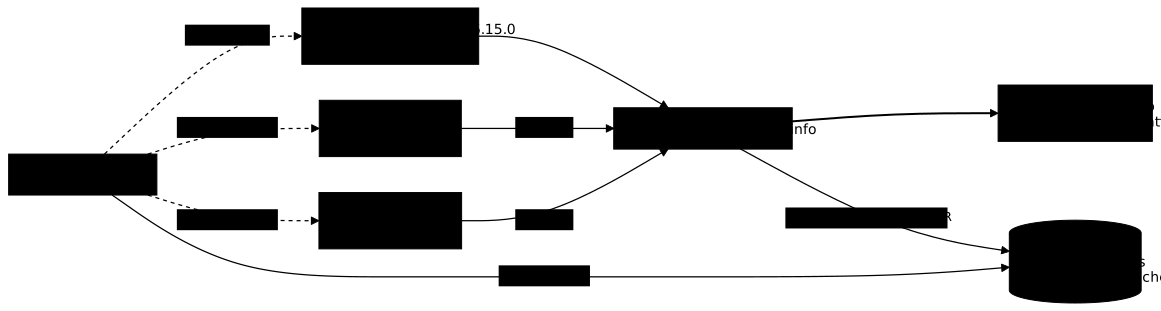
Le schéma montre l'application auditée. Regardez les deux sources de configuration qui entrent dans le Deployment, Redis qui reste en dehors comme ressource attachée, et le Job d'administration qui réutilise la même image et la même configuration.
Comment monter l'application à auditer ?
Section intitulée « Comment monter l'application à auditer ? »Le lab tient en un cluster kind et un répertoire de manifestes kustomize. La base contient un ConfigMap, un Secret, un Deployment podinfo, un Service, et un Deployment Redis avec son Service. Un overlay dev fixe le namespace twelve-factor et le message affiché. Les images sont épinglées par digest (l'empreinte SHA-256 du contenu de l'image, qui ne peut pas changer sous le même nom), comme sur tout le site.
Tous les fichiers de la leçon s'enregistrent dans un dossier de travail vide, rangé selon la convention kustomize (une base commune et des overlays qui la modifient) : créez-le avec mkdir -p base overlays/dev overlays/prod. Chaque bloc ci-dessous porte le chemin du fichier à créer.
Le ConfigMap porte les réglages non sensibles, dont l'adresse du cache. Le Secret porte une valeur de lab : un Secret est encodé en base64, pas chiffré. Par défaut, Kubernetes le stocke même sans chiffrement dans etcd (le chiffrement au repos s'active à part). Jamais de vraie valeur dans un exemple.
apiVersion: v1kind: ConfigMapmetadata: name: podinfo-configdata: PODINFO_UI_MESSAGE: "config v1 (base)" PODINFO_UI_COLOR: "#34577c" PODINFO_LEVEL: "info" PODINFO_CACHE_SERVER: "tcp://redis:6379"apiVersion: v1kind: Secretmetadata: name: podinfo-secrettype: OpaquestringData: APP_API_TOKEN: "lab-token-non-secret-0001"Le Deployment référence l'image par digest, injecte les deux objets avec envFrom, nomme son port, déclare deux sondes et prévoit une pause avant l'arrêt. Chaque champ sert un facteur, détaillé plus bas. Le preStop n'a été ajouté qu'au moment de mesurer le facteur IX : les mesures précédentes ne dépendent pas de lui.
apiVersion: apps/v1kind: Deploymentmetadata: name: podinfospec: replicas: 1 selector: matchLabels: app: podinfo template: metadata: labels: app: podinfo spec: terminationGracePeriodSeconds: 30 containers: - name: podinfo image: ghcr.io/stefanprodan/podinfo:6.15.0@sha256:ec73780a8425f59ea49f5bc8cdff0d598805a224fbaa1f86c67a244f250fa9da command: ["./podinfo"] ports: - name: http containerPort: 9898 envFrom: - configMapRef: name: podinfo-config - secretRef: name: podinfo-secret lifecycle: preStop: exec: command: ["sleep", "5"] readinessProbe: httpGet: path: /readyz port: http initialDelaySeconds: 1 periodSeconds: 2 livenessProbe: httpGet: path: /healthz port: http periodSeconds: 10 # resources: requests et limits, omis iciLe Service podinfo route le port 80 vers le port nommé http du Deployment.
apiVersion: v1kind: Servicemetadata: name: podinfospec: selector: app: podinfo ports: - name: http port: 80 targetPort: httpLe Deployment Redis (image redis:7.4.11-alpine@sha256:858f009f9709ce576febc734aa78b8f6d624b82571f9ddb6bda4377c833b3499) est exposé par un Service redis sur le port 6379. Sa sonde de disponibilité exécute redis-cli ping.
apiVersion: apps/v1kind: Deploymentmetadata: name: redisspec: replicas: 1 selector: matchLabels: app: redis template: metadata: labels: app: redis spec: containers: - name: redis image: redis:7.4.11-alpine@sha256:858f009f9709ce576febc734aa78b8f6d624b82571f9ddb6bda4377c833b3499 ports: - name: redis containerPort: 6379 readinessProbe: exec: command: ["redis-cli", "ping"] periodSeconds: 2---apiVersion: v1kind: Servicemetadata: name: redisspec: selector: app: redis ports: - name: redis port: 6379 targetPort: redisDeux fichiers kustomization.yaml assemblent le tout. La base liste les cinq fichiers ci-dessus. L'overlay dev reprend la base, fixe le namespace twelve-factor et remplace le message du ConfigMap par un patch JSON (une liste d'opérations replace sur un chemin précis).
resources: - configmap.yaml - secret.yaml - deployment.yaml - service.yaml - redis.yamlnamespace: twelve-factorresources: - ../../basepatches: - target: kind: ConfigMap name: podinfo-config patch: |- - op: replace path: /data/PODINFO_UI_MESSAGE value: "config v1 (dev)"-
Créer le cluster avec l'image de nœud épinglée.
Fenêtre de terminal kind create cluster --name cn-12f --image kindest/node:v1.37.0@sha256:a1ed56cfb0e7b93589bdf97c8cd566405a265939e3620fc4f5de89adff580ae5Résultat attendu :
Set kubectl context to "kind-cn-12f", en 9 à 11 s avec l'image du nœud déjà en cache local. -
Déployer l'overlay dev, après avoir créé le namespace
twelve-factor(kustomize ne le crée pas) et positionné le contexte dessus.Fenêtre de terminal kubectl create namespace twelve-factorkubectl config set-context --current --namespace twelve-factorkubectl apply -k overlays/dev && kubectl rollout status deploy/redis deploy/podinfoconfigmap/podinfo-config createdsecret/podinfo-secret createdservice/podinfo createdservice/redis createddeployment.apps/podinfo createddeployment.apps/redis createddeployment "redis" successfully rolled outdeployment "podinfo" successfully rolled outEntre les lignes
createdetsuccessfully rolled out,kubectl rollout statusaffiche des lignes d'attente (Waiting for deployment ...) tant que les Pods ne sont pas prêts. Images tirées comprises, l'ensemble a pris de 13 s à 27 s selon le débit de votre connexion. -
Interroger l'application par
kubectl port-forward svc/podinfo 18080:80dans un autre terminal.$ curl localhost:18080/readyz{"status": "OK"}$ curl localhost:18080/ | grep -E 'hostname|version|message'"hostname": "podinfo-75f75b6644-5gzjj","version": "6.15.0","message": "config v1 (dev)",
Le kubelet a bien tiré l'image par digest : le champ imageID du Pod vaut ghcr.io/stefanprodan/podinfo@sha256:ec73780a...fa9da. Un port-forward sur un Service reste lié à un seul Pod : relancez-le après chaque rollout, sinon curl vise un Pod disparu.
Comment gérer la configuration et les secrets ?
Section intitulée « Comment gérer la configuration et les secrets ? »Le facteur III demande que la configuration vive dans l'environnement, pas dans l'image : sur Kubernetes, c'est le rôle du ConfigMap et du Secret injectés en variables. Le test qui prouve le facteur est de changer une valeur sans reconstruire quoi que ce soit. L'application lit ses réglages dans les variables d'environnement PODINFO_*, fournies par envFrom. Changez la valeur dans le ConfigMap, puis relisez le message servi par l'application.
kubectl patch cm podinfo-config --type merge -p '{"data":{"PODINFO_UI_MESSAGE":"config v2 (dev)"}}'curl localhost:18080/ | grep -E 'message|hostname'configmap/podinfo-config patched "hostname": "podinfo-75f75b6644-5gzjj", "message": "config v1 (dev)",Le message n'a pas bougé. Une variable d'environnement injectée par envFrom est figée à la création du conteneur : modifier le ConfigMap ne change pas un Pod déjà lancé. Il faut un nouveau Pod, que rollout restart produit.
kubectl rollout restart deploy/podinfo && kubectl rollout status deploy/podinfocurl localhost:18080/ | grep -E 'message|hostname'deployment.apps/podinfo restarteddeployment "podinfo" successfully rolled out "hostname": "podinfo-665c8c5946-d59wf", "message": "config v2 (dev)",Le rollout a pris 2,95 s, et ni l'image ni le code n'ont changé : c'est ce que le facteur III attend. Le Secret s'injecte de la même façon, et sa valeur apparaît dans le /env de podinfo : un Secret ne se commit jamais dans le dépôt avec une vraie valeur.
Comment déclencher le rollout seul quand la configuration change ?
Section intitulée « Comment déclencher le rollout seul quand la configuration change ? »Un configMapGenerator de kustomize suffixe le nom du ConfigMap d'un hash de son contenu, ce qui relie la configuration à la révision du Deployment. Changer une valeur crée un nouveau ConfigMap, donc modifie le template du Deployment, donc déclenche un rollout sans autre geste. La variante testée vit dans un répertoire qui ne contient pas le ConfigMap de la base : elle reprend le Deployment, le Service et le Secret, et génère elle-même le ConfigMap. Elle s'installe dans son propre namespace, twelve-factor-gen. Ce détail compte : avec behavior: replace sur un ConfigMap hérité de la base, kustomize ne suffixe pas le nom d'un hash.
mkdir -p variants/generatorcp base/deployment.yaml base/service.yaml base/secret.yaml variants/generator/namespace: twelve-factor-genresources: - deployment.yaml - service.yaml - secret.yamlconfigMapGenerator: - name: podinfo-config literals: - PODINFO_UI_MESSAGE=config hash v1 - PODINFO_UI_COLOR=#34577c - PODINFO_LEVEL=infoOn applique une première fois, puis on change config hash v1 en config hash v2 dans le fichier (avec sed ou un éditeur) et on applique de nouveau. Les noms suffixés viennent du hash du contenu : vous obtiendrez les mêmes si vous reprenez ces valeurs à l'identique.
$ kubectl create namespace twelve-factor-gen$ kubectl apply -k variants/generator ; kubectl get cm -n twelve-factor-genconfigmap/podinfo-config-64hg4ffmkh created...podinfo-config-64hg4ffmkh 3 1s$ sed -i 's/config hash v1/config hash v2/' variants/generator/kustomization.yaml$ kubectl apply -k variants/generatorconfigmap/podinfo-config-hbfbhm4t2f createdsecret/podinfo-secret configuredservice/podinfo unchangeddeployment.apps/podinfo configured$ kubectl get cm -n twelve-factor-genpodinfo-config-64hg4ffmkh 3 2spodinfo-config-hbfbhm4t2f 3 1sL'ancien ConfigMap est conservé, et c'est utile : kubectl rollout undo deploy/podinfo rétablit aussi l'ancienne configuration, puisque chaque révision pointe vers son ConfigMap. Pour le voir, lancez kubectl rollout undo deploy/podinfo -n twelve-factor-gen, puis listez le ConfigMap de chaque Pod avec kubectl get pod -n twelve-factor-gen -o jsonpath='{range .items[*]}{.metadata.name} {.spec.containers[0].envFrom[0].configMapRef.name}{"\n"}{end}' : pendant le retour arrière, un Pod encore sur le nouveau ConfigMap côtoie ceux de l'ancien, et une fois le retour terminé il ne reste qu'un Pod, sur l'ancien (podinfo-config-64hg4ffmkh).
Comment traiter Redis comme une ressource attachée ?
Section intitulée « Comment traiter Redis comme une ressource attachée ? »Le facteur IV veut qu'un service externe soit une ressource que l'on remplace par un changement de configuration, jamais de code. Ici, l'application ne connaît de Redis que PODINFO_CACHE_SERVER=tcp://redis:6379, c'est-à-dire le nom DNS du Service redis. Le test : déployer un second Redis (redis-b, avec son Service), pointer l'application dessus par le ConfigMap, et observer.
Le second Redis reprend le manifeste du premier sous le nom redis-b. Enregistrez-le dans redis-b.yaml et déployez-le dans le namespace de la leçon.
apiVersion: apps/v1kind: Deploymentmetadata: name: redis-bspec: replicas: 1 selector: matchLabels: app: redis-b template: metadata: labels: app: redis-b spec: containers: - name: redis-b image: redis:7.4.11-alpine@sha256:858f009f9709ce576febc734aa78b8f6d624b82571f9ddb6bda4377c833b3499 ports: - name: redis-b containerPort: 6379 readinessProbe: exec: command: ["redis-cli", "ping"] periodSeconds: 2---apiVersion: v1kind: Servicemetadata: name: redis-bspec: selector: app: redis-b ports: - name: redis-b port: 6379 targetPort: redis-bAvant de changer de Redis, il faut une valeur à retrouver : on écrit ma-cle dans le premier Redis (le port-forward de l'étape 3 doit tourner). Puis on bascule le ConfigMap, on relance le port-forward (un rollout a remplacé le Pod) et on relit la clé.
kubectl apply -f redis-b.yaml && kubectl rollout status deploy/redis-bcurl -X POST -d 'valeur-en-redis' localhost:18080/cache/ma-clecurl localhost:18080/cache/ma-clekubectl patch cm podinfo-config --type merge -p '{"data":{"PODINFO_CACHE_SERVER":"tcp://redis-b:6379"}}'kubectl rollout restart deploy/podinfo && kubectl rollout status deploy/podinfo# relancez le port-forward : kubectl port-forward svc/podinfo 18080:80curl -i localhost:18080/cache/ma-cleLa clé ma-cle rend valeur-en-redis avant le changement, puis répond 404 : l'application parle maintenant à un autre service, vide. Une écriture curl -X POST -d 'valeur-b' localhost:18080/cache/cle-b atterrit dans le second Redis : kubectl exec deploy/redis-b -- redis-cli keys '*' liste cle-b, alors que deploy/redis contient ma-cle. Dans les deux cas apparaît aussi une clé nommée d'après le Pod, que podinfo enregistre lui-même au démarrage : ignorez-la.
Après un retour à tcp://redis:6379 (même patch, même rollout restart), /cache/ma-cle rend de nouveau valeur-en-redis en 200, et /cache/cle-b rend 404. Aucun changement de code, d'image ni de Deployment : seulement une variable. Non testés ici : l'authentification, la persistance et la haute disponibilité de Redis.
Que montre l'historique du Deployment pour build, release et run ?
Section intitulée « Que montre l'historique du Deployment pour build, release et run ? »Le facteur V sépare construire (l'image), publier une release (image plus configuration) et exécuter (les Pods). Sur Kubernetes, l'image est référencée par digest, et la release est le template du Deployment : chaque changement de template crée une révision. L'historique est donc la trace des releases, à condition de le documenter.
Pour tester, on change l'image pour la version précédente de podinfo (6.14.1, par digest) et on annote la cause du changement.
kubectl set image deploy/podinfo podinfo=ghcr.io/stefanprodan/podinfo:6.14.1@sha256:f9537f729129d339aaef049b76ab2cd4ff06a424f99e5f6a5923c10621018fb1kubectl annotate deploy/podinfo kubernetes.io/change-cause="release: podinfo 6.14.1 par digest" --overwritekubectl rollout history deploy/podinfoREVISION CHANGE-CAUSE1 <none>2 <none>3 <none>4 <none>5 release: podinfo 6.14.1 par digestLes révisions 2, 3 et 4 sont des rollout restart (annotation restartedAt), pas des releases d'image : l'historique mélange tout, d'où l'intérêt de l'annotation kubernetes.io/change-cause. Après la bascule, curl localhost:18080/ donne "version": "6.14.1" et le message config v2 (dev) : la configuration a suivi, l'image a changé.
kubectl rollout undo deploy/podinfokubectl get deploy podinfo -o jsonpath='{.spec.template.spec.containers[0].image}'Warning: resource deployments/podinfo was previously managed with 'kubectl apply'. Rolling back will not update the kubectl.kubernetes.io/last-applied-configuration annotation...deployment.apps/podinfo rolled backghcr.io/stefanprodan/podinfo:6.15.0@sha256:ec73780a8425...fa9daL'avertissement dit que le Deployment a été créé par kubectl apply, qui garde sa dernière configuration dans une annotation ; le retour arrière la laisse périmée. Deux autres faits : undo renumérote (l'ancienne révision 4 devient la 6, sa cause est vide), et il n'annule pas un ConfigMap modifié par patch, puisque ce dernier n'est pas dans le template. Seul le ConfigMap nommé par hash revient avec l'undo.
# ❌ à éviter : changer la configuration par patch en croyant que rollout undo la restaure$ kubectl patch cm podinfo-config --type merge -p '{"data":{"PODINFO_UI_MESSAGE":"config v2 (dev)"}}'$ kubectl rollout undo deploy/podinfo # l'image revient, le message reste "config v2 (dev)"Dernier piège : un kubectl apply -k overlays/dev ultérieur remet replicas à 1, la valeur de la base, et écrase un kubectl scale. Il ramène aussi le message du ConfigMap à config v1 (dev) : si vous le rejouez, refaites le patch vers config v2 (dev) avant les sections suivantes. Le dépôt reste la source de vérité de la release.
Comment prouver qu'un processus est sans état ?
Section intitulée « Comment prouver qu'un processus est sans état ? »Les facteurs VI, VII et VIII se vérifient ensemble : un processus sans état, qui écoute lui-même sur un port, se multiplie par simple augmentation du nombre de Pods. Le test central est le plus brutal, supprimer un Pod et regarder si quelque chose se perd.
Que devient la donnée quand on supprime le Pod ?
Section intitulée « Que devient la donnée quand on supprime le Pod ? »Si l'état vit dans un service attaché, supprimer le Pod ne perd rien. On écrit une valeur dans le cache, on la relit, puis on supprime le Pod qui l'a servie.
$ curl -X POST -d 'valeur-en-redis' localhost:18080/cache/ma-cle # [202]$ kubectl delete pod -l app=podinfo # environ 9 s avec le preStop$ kubectl get pods -l app=podinfopodinfo-665c8c5946-2mspq 1/1 Running 0 5s$ curl localhost:18080/cache/ma-clevaleur-en-redis # [200]Le Deployment a recréé un Pod de nom différent, et la valeur est toujours là, puisqu'elle vit dans Redis. Relancez le port-forward avant la dernière commande : celui d'avant visait le Pod supprimé. Limite : le Redis du lab n'a ni volume ni persistance, supprimer son Pod perdrait la donnée (non testé). C'est un cache, pas une source de vérité.
Quel est l'effet d'un état gardé sur le disque du Pod ?
Section intitulée « Quel est l'effet d'un état gardé sur le disque du Pod ? »Un état écrit dans le système de fichiers du Pod disparaît avec lui. Le contre-exemple est volontairement fautif : configuration en dur dans les arguments, et un volume emptyDir monté sur /data (un volume vide créé avec le Pod et détruit avec lui).
# ❌ à éviter : configuration en dur et état sur le disque local du PodapiVersion: apps/v1kind: Deploymentmetadata: name: podinfo-localspec: replicas: 1 selector: matchLabels: app: podinfo-local template: metadata: labels: app: podinfo-local spec: containers: - name: podinfo image: ghcr.io/stefanprodan/podinfo:6.15.0@sha256:ec73780a8425f59ea49f5bc8cdff0d598805a224fbaa1f86c67a244f250fa9da command: ["./podinfo", "--ui-message=en dur dans args", "--data-path=/data"] ports: - name: http containerPort: 9898 volumeMounts: - name: data mountPath: /data volumes: - name: data emptyDir: {}---apiVersion: v1kind: Servicemetadata: name: podinfo-localspec: selector: app: podinfo-local ports: - name: http port: 80 targetPort: httpCe volume est indispensable : l'image 6.15.0 n'a pas de /data, et sans lui POST /store répond {"code":500,"message":"writing file failed"} (avec un code HTTP 200). Avec lui, l'écriture réussit, puis on supprime le Pod. Appliquez le fichier, attendez le déploiement, puis ouvrez un port-forward sur le port 18081 pour ne pas gêner celui de podinfo.
kubectl apply -f etat-local.yaml && kubectl rollout status deploy/podinfo-localkubectl port-forward svc/podinfo-local 18081:80 # dans un autre terminal$ curl -w ' [%{http_code}]\n' -X POST -d 'etat-sur-disque-local' localhost:18081/store{ "hash": "b0f16459feb69318ca4c6dca5ded6ab0c5d5c073"} [202]$ kubectl delete pod -l app=podinfo-local$ kubectl port-forward svc/podinfo-local 18081:80 # relancé : le Pod a changé$ curl -w ' [%{http_code}]\n' localhost:18081/store/b0f16459feb69318ca4c6dca5ded6ab0c5d5c073{ "code": 500, "message": "reading file failed"} [200]Le nombre entre crochets est le code HTTP affiché par curl -w : le 500 de la fin n'est que dans le corps de la réponse. Retirez ensuite le contre-exemple avec kubectl delete -f etat-local.yaml, avant de continuer.
La donnée a disparu avec le Pod. Deux erreurs se cumulent : l'état n'est pas dans un service attaché (facteur VI) et le message vient des arguments, si bien que modifier le ConfigMap ne l'atteindrait pas (facteur III). Piège de lecture : podinfo répond avec un code HTTP 200 ou 202 et un JSON qui porte "code": 500 : lisez le corps de la réponse, pas le code de curl -w.
Comment vérifier la liaison de port et la concurrence ?
Section intitulée « Comment vérifier la liaison de port et la concurrence ? »Le facteur VII veut que l'application écoute elle-même sur son port, sans serveur web injecté ; le facteur VIII, qu'on la multiplie par le nombre de processus. Le port est nommé dans le Deployment, et le Service traduit le port 80 vers ce nom. Depuis un Pod client, l'accès se fait par le nom du Service.
Le Pod client est un busybox (busybox:1.37.0@sha256:bdf57e528e45e4433820e045b29b4597825a1c9e38353532d90a01445013f82e) lancé avec sleep 3600. On le crée d'abord, puis on attend qu'il soit prêt.
kubectl run client --image=busybox:1.37.0@sha256:bdf57e528e45e4433820e045b29b4597825a1c9e38353532d90a01445013f82e -- sleep 3600kubectl wait --for=condition=Ready pod/client --timeout=60skubectl get deploy podinfo -o jsonpath='{.spec.template.spec.containers[0].ports}'kubectl exec client -- wget -qO- http://podinfo.twelve-factor.svc.cluster.local/readyz[{"containerPort":9898,"name":"http","protocol":"TCP"}]{ "status": "OK"}Pour lister les adresses derrière le Service, préférez kubectl get endpointslice : kubectl get endpoints affiche Warning: v1 Endpoints is deprecated in v1.33+.
Pour la concurrence, on passe à 4 réplicas et on envoie 20 requêtes.
kubectl scale deploy/podinfo --replicas=4 && kubectl rollout status deploy/podinfofor i in $(seq 1 20); do kubectl exec client -- wget -qO- http://podinfo/ | grep -oE 'podinfo-[a-z0-9]+-[a-z0-9]+'; done | sort | uniq -c 10 podinfo-66647cfb45-9dx87 1 podinfo-66647cfb45-bgcj6 4 podinfo-66647cfb45-zgz42 5 podinfo-66647cfb45-zrd4sLes 4 Pods étaient Ready en moins de 2 s avec l'image déjà sur le nœud (la sonde de disponibilité attend 1 s), et les 4 reçoivent du trafic. La répartition n'est pas égale sur 20 requêtes, ce qui est normal. Lancée une seconde après le scale, la même boucle a envoyé 8 requêtes sur 8 au même Pod, le temps que le routage se propage : attendez quelques secondes. L'ajustement automatique du nombre de Pods n'est pas testé ici, il relève de l'autoscaling horizontal.
Kubernetes injecte aussi pour chaque Service des variables comme PODINFO_SERVICE_HOST. Comme le Service s'appelle podinfo et que podinfo lit le préfixe PODINFO_, les noms se croisent : rien n'a cassé ici (le port est resté 9898), mais c'est un piège de nommage. Le champ enableServiceLinks: false de la spec du Pod supprime ces variables (non testé ici).
Un Pod est-il vraiment jetable ?
Section intitulée « Un Pod est-il vraiment jetable ? »Le facteur IX demande un démarrage rapide et un arrêt propre : Kubernetes détruit et recrée des Pods en permanence, l'application doit y survivre sans perdre de requête. Trois mesures le montrent : le démarrage, la réaction à SIGTERM, puis un rolling restart sous charge.
Le démarrage est mesuré par les horodatages Kubernetes : le Pod de remplacement, créé à 12:48:47Z au moment où l'ancien recevait SIGTERM, était Ready à 12:48:48Z, soit environ 1 s (image déjà sur le nœud, résolution à la seconde). À l'arrêt, kubectl delete pod envoie SIGTERM au processus principal ; podinfo ferme alors son serveur HTTP. Cette mesure a été faite avant l'ajout du preStop : avec le Deployment ci-dessus, la suppression dure 5 s de plus (rejouée : environ 4 s sans preStop, 9 à 11 s avec). Pour lire la ligne d'arrêt, suivez les logs du Pod dans un second terminal (kubectl logs -f <pod>) pendant que vous le supprimez.
SIGTERM envoyé vers 12:48:47.112{"level":"info","ts":"2026-10-13T12:48:47.147Z","caller":"signals/shutdown.go:55","msg":"Shutting down HTTP/HTTPS server","timeout":5}pod "podinfo-66647cfb45-zrd4s" deleted from twelve-factor namespacedurée suppression : 3275 msUne sonde posée toutes les 0,45 s sur l'IP du Pod pendant l'arrêt donne 503 sur /readyz dès la première sonde et pendant 3,3 s, puis la connexion est refusée : podinfo se déclare non prêt dès SIGTERM, patiente environ 3 s, puis ferme. Le contre-exemple est un processus qui ignore SIGTERM.
# ❌ à éviter : PID 1 qui ignore SIGTERM (sleep), délai de grâce de 10 sapiVersion: v1kind: Podmetadata: name: ignore-sigtermspec: terminationGracePeriodSeconds: 10 containers: - name: sleeper image: busybox:1.37.0@sha256:bdf57e528e45e4433820e045b29b4597825a1c9e38353532d90a01445013f82e command: ["sleep", "3600"]Enregistrez ce Pod dans ignore-sigterm.yaml, appliquez-le, attendez qu'il soit prêt, puis mesurez sa suppression avec time.
$ kubectl apply -f ignore-sigterm.yaml && kubectl wait --for=condition=Ready pod/ignore-sigterm$ time kubectl delete pod ignore-sigtermpod "ignore-sigterm" deleted from twelve-factor namespace(durée relevée par time : 11,4 s)La suppression a duré 11,4 s : le kubelet attend la fin du terminationGracePeriodSeconds (10 s), puis envoie SIGKILL. Un processus sourd à SIGTERM rend chaque rollout aussi long que le délai de grâce, et coupe les requêtes en cours.
Pourquoi ajouter un preStop pendant un rolling restart ?
Section intitulée « Pourquoi ajouter un preStop pendant un rolling restart ? »À la fin de vie d'un Pod, le retrait de ses adresses du Service et l'envoi de SIGTERM partent en parallèle : des requêtes peuvent encore arriver sur un Pod qui répond déjà 503. Le crochet preStop s'exécute avant SIGTERM et le retarde de quelques secondes, le temps que le retrait se propage. Le délai de grâce (terminationGracePeriodSeconds: 30) court dès le début du preStop et l'inclut : preStop plus arrêt normal doivent tenir dans ces 30 s. Pour le mesurer, une boucle wget /healthz tourne 25 s depuis le Pod client, sur 3 réplicas, avec un rollout restart lancé à t+2 s. Pour la ligne « sans preStop », il suffit de retirer le bloc lifecycle du Deployment.
kubectl scale deploy/podinfo --replicas=3 && kubectl rollout status deploy/podinfo(sleep 2; kubectl rollout restart deploy/podinfo) &kubectl exec client -- sh -c 'ok=0; ko=0; end=$(( $(date +%s) + 25 )); while [ $(date +%s) -lt $end ]; do if wget -qO- -T 2 http://podinfo/healthz >/dev/null 2>&1; then ok=$((ok+1)); else ko=$((ko+1)); fi; done; echo "ok=$ok erreurs=$ko"'La boucle tourne dans le Pod client pendant 25 s et affiche le nombre de réponses réussies et d'erreurs. Pour retirer le preStop, kubectl patch deploy podinfo --type json -p '[{"op":"remove","path":"/spec/template/spec/containers/0/lifecycle"}]' suffit ; kubectl apply -k overlays/dev le remet. Rejoué ici, le même scénario a donné erreurs=0 avec le preStop (deux essais) et de 300 à 352 erreurs sans (deux essais) : les totaux de requêtes dépendent de la machine, l'ordre de grandeur reste le même.
| Configuration | Requêtes OK | Erreurs |
|---|---|---|
sans preStop | 8 738 | 309 (3,4 %) |
avec lifecycle.preStop: sleep 5 | 9 412 | 0 |
Sans pause, 3,4 % des requêtes ont échoué pendant le rollout ; avec cinq secondes de sleep, aucune. C'est une exécution par ligne, sans statistique : le résultat montre le mécanisme et un ordre de grandeur, pas un taux garanti. Autre piège : kubectl logs deploy/podinfo pendant un rollout peut tomber sur le Pod qui s'arrête (Found 2 pods, using pod/...), préférez -l app=podinfo.
Où vont les logs ?
Section intitulée « Où vont les logs ? »Le facteur XI veut que l'application écrive ses événements sur la sortie standard, et laisse la plateforme les collecter. Podinfo écrit une ligne JSON par événement sur stdout, aucun fichier. kubectl logs les lit directement.
kubectl logs -l app=podinfo --tail=20{"level":"info","ts":"2026-10-13T12:53:02.747Z","caller":"podinfo/main.go:170","msg":"Starting podinfo","version":"6.15.0","revision":"dd507173...","port":"9898"}{"level":"info","ts":"...","caller":"http/server.go:273","msg":"Starting HTTP Server.","addr":":9898"}Pour diagnostiquer un Pod au-delà de ces lignes, voir Débugger une application Kubernetes. Au niveau info, les requêtes ne sont pas journalisées. Passer à PODINFO_LEVEL=debug demande un changement de configuration et un rollout, ce qui rejoue le facteur III : une ligne JSON par requête apparaît, avec par exemple "uri":"/readyz" et l'agent kube-probe/1.37. Un filtre suffit : kubectl logs -l app=podinfo --tail=50 | jq -r .level | sort | uniq -c a donné 15 debug et 2 info. L'acheminement vers un système de collecte n'est pas testé : l'application ne s'en occupe pas, c'est le contrat du facteur.
Comment lancer une tâche d'administration ?
Section intitulée « Comment lancer une tâche d'administration ? »Le facteur XII veut que les tâches ponctuelles (migration, graine de données) tournent comme des processus à part, avec le même code et la même configuration que l'application. Sur Kubernetes, c'est un Job. Celui du lab réutilise l'image par digest, le même envFrom, et les outils podcli et curl fournis par l'image. Il écrit une valeur dans le cache. Enregistrez-le dans job-admin.yaml.
apiVersion: batch/v1kind: Jobmetadata: name: admin-seedspec: backoffLimit: 0 ttlSecondsAfterFinished: 600 template: spec: restartPolicy: Never containers: - name: admin image: ghcr.io/stefanprodan/podinfo:6.15.0@sha256:ec73780a8425f59ea49f5bc8cdff0d598805a224fbaa1f86c67a244f250fa9da envFrom: - configMapRef: name: podinfo-config - secretRef: name: podinfo-secret command: - sh - -c - | set -e echo "config vue par le Job: message=$PODINFO_UI_MESSAGE cache=$PODINFO_CACHE_SERVER token=${#APP_API_TOKEN} caracteres" podcli check tcp "${PODINFO_CACHE_SERVER#tcp://}" curl -fsS -X POST -d "graine-par-le-job" http://podinfo/cache/seed echo "graine ecrite"Le script affiche la longueur du secret, jamais sa valeur. ttlSecondsAfterFinished: 600 fait nettoyer le Job dix minutes après sa fin. Il n'appartient pas à la base kustomize, parce qu'un Job est immuable.
$ kubectl apply -f job-admin.yaml && kubectl wait --for=condition=complete job/admin-seed --timeout=90sjob.batch/admin-seed createdjob.batch/admin-seed condition met$ kubectl logs job/admin-seedconfig vue par le Job: message=config v2 (dev) cache=tcp://redis:6379 token=25 caracteres... check succeed {"address": "redis:6379"}graine ecrite$ kubectl exec client -- wget -qO- http://podinfo/cache/seedgraine-par-le-jobLe Job a vu la même configuration que le Deployment, atteint le même Redis et écrit une valeur que l'application relit : kubectl get job admin-seed indique Complete 1/1 en 4 s. À éviter, sans l'avoir mesuré ici : lancer la même tâche à la main avec kubectl exec dans un Pod en cours d'exécution, car elle n'est ni tracée, ni rejouable, et dépend de l'état de ce Pod.
Dev et prod sont-ils vraiment identiques ?
Section intitulée « Dev et prod sont-ils vraiment identiques ? »Le facteur X demande de garder développement et production aussi proches que possible : même artefact, configuration différente. Ici, une base commune et deux overlays kustomize produisent deux namespaces. Le contrôle est un diff des deux rendus. L'overlay prod ressemble à dev : même base, autre namespace, et trois valeurs changées (niveau de log, message, nombre de réplicas).
namespace: twelve-factor-prodresources: - ../../basepatches: - target: kind: ConfigMap name: podinfo-config patch: |- - op: replace path: /data/PODINFO_UI_MESSAGE value: "config v1 (prod)" - op: replace path: /data/PODINFO_LEVEL value: "warn" - target: kind: Deployment name: podinfo patch: |- - op: replace path: /spec/replicas value: 2Avant de comparer, déployez prod (il faut créer son namespace comme pour dev) : kubectl create namespace twelve-factor-prod && kubectl apply -k overlays/prod. Le diff rend un code de sortie 1 quand les rendus diffèrent : c'est le résultat attendu ici.
diff <(kubectl kustomize overlays/dev) <(kubectl kustomize overlays/prod)kubectl get deploy -A -o 'custom-columns=NS:.metadata.namespace,NAME:.metadata.name,IMAGE:.spec.template.spec.containers[0].image'Le diff ne montre que le niveau de log, le message, le namespace et replicas: 1 contre 2. Les deux Deployments podinfo portent la même image par digest (ghcr.io/stefanprodan/podinfo:6.15.0@sha256:ec73780a...fa9da), et Redis est identique. Dans twelve-factor-prod, kubectl get pods liste 2 Pods podinfo et 1 Redis.
Ce test compare des manifestes, pas des environnements réels. Kubernetes ne dit pas si le Redis de production a la même version, la même persistance ou la même charge que celui de développement. Le facteur X reste une discipline d'équipe, que l'outil ne rend vérifiable que sur les objets déclarés.
Dépannage
Section intitulée « Dépannage »Ces symptômes sont ceux rencontrés pendant le lab.
| Symptôme | Cause | Solution |
|---|---|---|
Le message de l'application ne change pas après kubectl patch cm | Les variables injectées par envFrom sont figées à la création du conteneur | kubectl rollout restart deploy/podinfo, ou un ConfigMap nommé par hash |
curl ne répond plus après un rollout | Un port-forward svc/... est lié à un seul Pod, disparu | Relancer le port-forward |
rollout undo laisse la nouvelle configuration | Le ConfigMap modifié par patch n'est pas dans le template | Utiliser un configMapGenerator |
kubectl apply -k ramène le nombre de réplicas à 1 | La valeur de la base écrase le kubectl scale | Déclarer replicas dans l'overlay |
8 requêtes sur 8 vont au même Pod juste après scale | La table de routage n'est pas encore propagée | Attendre quelques secondes avant de mesurer |
| Des erreurs 503 apparaissent pendant un rolling restart | Retrait des adresses et SIGTERM partent en parallèle | Ajouter lifecycle.preStop (sleep 5 dans le lab) |
| La suppression d'un Pod dure exactement le délai de grâce | Le processus principal ignore SIGTERM, le kubelet attend puis envoie SIGKILL | Faire gérer SIGTERM par le processus 1 |
/store répond 200 avec un corps "code": 500 | podinfo renvoie l'erreur dans le JSON | Lire le corps de la réponse, pas le code HTTP |
| Un générateur kustomize ne suffixe pas le ConfigMap | behavior: replace sur un ConfigMap de la base ne produit pas de hash | Un répertoire qui ne contient pas le ConfigMap de la base |
kubectl logs deploy/podinfo donne les logs d'un Pod qui s'arrête | Le Deployment a plusieurs Pods pendant le rollout | kubectl logs -l app=podinfo ou nommer le Pod |
Nettoyer le lab
Section intitulée « Nettoyer le lab »Le cluster kind est jetable : le supprimer retire tous les objets du lab.
kind delete cluster --name cn-12fDeleting cluster "cn-12f" ...Deleted nodes: ["cn-12f-control-plane"]À retenir
Section intitulée « À retenir »- Kubernetes porte les facteurs par des objets (ConfigMap, Secret, Service, Job, sondes) mais ne vérifie rien : c'est à vous de prouver chaque facteur par une commande.
- Les facteurs I et II se jugent dans le dépôt et l'image, pas dans le cluster ; le X ne se vérifie que sur les manifestes.
- Une variable injectée par
envFromest figée à la création du conteneur : changer le ConfigMap demande un nouveau Pod, et un nom de ConfigMap suffixé d'un hash relie configuration et révision. - Un service externe est une ressource attachée quand un changement de variable suffit à le remplacer.
- Un Pod doit pouvoir être supprimé sans perte : l'état vit dans un service attaché, jamais sur le disque du Pod.
- Un processus qui ignore SIGTERM rend la suppression aussi longue que le délai de grâce ; un
preStopévite des erreurs pendant le retrait du Pod du Service (309 erreurs sur 9 047 requêtes sans, 0 avec, une exécution par cas). - Un Job qui réutilise l'image et la configuration de l'application est la forme Kubernetes d'une tâche d'administration.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Autoscaling des nœuds : Cluster Autoscaler ou Karpenter
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications