Un maillage de services (service mesh) permet d'imposer un délai maximal,
des reprises et une autorisation par identité entre deux services, sans
modifier leur code. Cette leçon le montre avec Istio 1.31.1 en mode
sidecar, sur un cluster kind : un VirtualService coupe un appel lent en
2 secondes, un second règle les reprises (avec le piège des valeurs par
défaut), et une AuthorizationPolicy ne laisse passer qu'un appelant, reconnu
à son identité. Chaque règle est prouvée par une mesure : code HTTP, durée,
compteurs du proxy. Elle s'adresse à qui a déjà déployé des Services sur
Kubernetes.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Installer Istio en profil
minimalet injecter des sidecars dans un namespace. - Vérifier l'identité SPIFFE d'un appelant dans l'en-tête
X-Forwarded-Client-Cert. - Imposer un délai avec
timeoutet reconnaître le 504 produit par le proxy. - Configurer des reprises avec
retries, et prouver leur nombre. - Autoriser un seul appelant avec une
AuthorizationPolicy, restreindre méthode et chemin. - Diagnostiquer les pièges : compteurs filtrés, politique non propagée, Pod hors maillage.
Prérequis
Section intitulée « Prérequis »Cette leçon prolonge Le service mesh,
qui explique ce qu'est un maillage, ses deux plans et le proxy sidecar : elle
n'en redit pas les concepts. Elle suppose les niveaux 1 et 2 de la formation
Kubernetes, décrits dans le parcours
(Deployment, Service, ServiceAccount, kubectl exec).
Côté poste, il faut Docker, kind (voir Créer votre premier cluster
local),
kubectl, curl et sha256sum. Prévoyez de la mémoire : le profil minimal
réserve 2 Gio pour istiod, et chaque sidecar occupe environ 106 Mo (mesures
en fin de leçon). Versions de référence : kind v0.33.0,
kindest/node:v1.37.0 et Istio 1.31.1.
Où chaque règle s'applique-t-elle dans le maillage ?
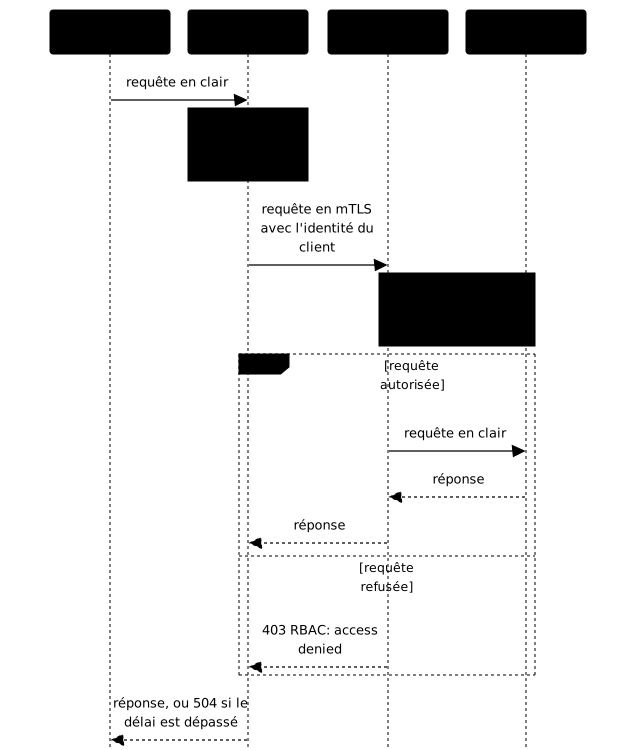
Section intitulée « Où chaque règle s'applique-t-elle dans le maillage ? »Le délai et les reprises s'appliquent dans le sidecar de l'appelant, et
l'autorisation dans le sidecar de l'appelé. C'est le point à comprendre avant
de toucher un manifeste : une règle posée du mauvais côté n'a aucun effet. Le
sidecar du client décide combien de temps attendre et s'il rejoue la requête ;
le sidecar du serveur reçoit la requête en mTLS (TLS mutuel, où chaque côté
présente un certificat) et connaît donc l'identité du client. Chaque sidecar
est un conteneur istio-proxy qui fait tourner Envoy, le proxy qui
exécute ces règles ; istiod, le plan de contrôle, lui pousse la
configuration mais ne voit jamais le trafic.
Regardez sur le schéma où se placent les deux notes : la règle de délai et de reprises au niveau du premier proxy, l'autorisation au niveau du second. Un refus est renvoyé par le sidecar du serveur : l'application ne voit jamais la requête.
Comment installer Istio et injecter les sidecars ?
Section intitulée « Comment installer Istio et injecter les sidecars ? »Trois gestes suffisent : un cluster, istioctl install avec le profil
minimal, puis un namespace étiqueté istio-injection=enabled. Le profil
minimal installe seulement istiod, le plan de contrôle : le trafic
est-ouest (de service à service, à l'intérieur du cluster) n'a pas besoin de
passerelle d'entrée, que le profil default ajouterait pour rien.
Le binaire istioctl se télécharge depuis la release GitHub, avec son
fichier de somme sha256, sans curl | sh. Cette somme est publiée au même
endroit que l'archive : elle protège d'une corruption, pas d'un dépôt
compromis.
-
Créer le cluster avec le nœud épinglé par digest.
Fenêtre de terminal kind create cluster --name cn-mesh \--image kindest/node:v1.37.0@sha256:a1ed56cfb0e7b93589bdf97c8cd566405a265939e3620fc4f5de89adff580ae5La sortie annonce
Set kubectl context to "kind-cn-mesh", suivie de l'invitekubectl cluster-info. -
Télécharger et vérifier istioctl.
Fenêtre de terminal curl -fsSLO https://github.com/istio/istio/releases/download/1.31.1/istioctl-1.31.1-linux-amd64.tar.gzcurl -fsSLO https://github.com/istio/istio/releases/download/1.31.1/istioctl-1.31.1-linux-amd64.tar.gz.sha256sha256sum -c istioctl-1.31.1-linux-amd64.tar.gz.sha256mkdir istioctl-bin && tar -xzf istioctl-1.31.1-linux-amd64.tar.gz -C istioctl-binexport PATH="$PWD/istioctl-bin:$PATH"istioctl version --remote=falseLa vérification doit afficher
istioctl-1.31.1-linux-amd64.tar.gz: OK, et la dernière commandeclient version: 1.31.1. -
Installer le plan de contrôle.
Fenêtre de terminal istioctl install --set profile=minimal -yLa sortie affiche
✔ Istiod installed, puis se termine par✔ Installation complete. -
Déployer les applications dans un namespace injecté.
Fenêtre de terminal kubectl apply -f 00-namespaces.yaml -f 10-apps.yamlkubectl -n mesh-lab rollout status deploy --timeout=300skubectl -n mesh-lab get podsLes trois Pods doivent afficher
2/2: l'application et le sidecar.
Enregistrez chaque manifeste de cette leçon sous le nom donné en titre de
son bloc. Le namespace mesh-lab porte l'étiquette d'injection ; legacy
n'en a pas. Il héberge un Pod outsider, hors maillage, qui servira à
tester le refus.
apiVersion: v1kind: Namespacemetadata: name: mesh-lab labels: istio-injection: enabled---apiVersion: v1kind: Namespacemetadata: name: legacyLe backend est go-httpbin, un serveur de test qui sait répondre
lentement (/delay/5), échouer (/status/503, /unstable) et
afficher les en-têtes reçus. Deux clients curl (frontend et batch)
tournent sous deux ServiceAccounts distincts : c'est ce qui leur donnera
deux identités.
apiVersion: v1kind: ServiceAccountmetadata: name: httpbin namespace: mesh-lab---apiVersion: v1kind: ServiceAccountmetadata: name: frontend namespace: mesh-lab---apiVersion: v1kind: ServiceAccountmetadata: name: batch namespace: mesh-lab---apiVersion: v1kind: Servicemetadata: name: httpbin namespace: mesh-lab labels: app: httpbinspec: selector: app: httpbin ports: - name: http port: 8080 targetPort: 8080---apiVersion: apps/v1kind: Deploymentmetadata: name: httpbin namespace: mesh-labspec: replicas: 1 selector: matchLabels: app: httpbin template: metadata: labels: app: httpbin spec: serviceAccountName: httpbin containers: - name: httpbin image: mccutchen/go-httpbin:v2.15.0@sha256:24528cf5229d0b70065ac27e6c9e4d96f5452a84a3ce4433e56573c18d96827a ports: - containerPort: 8080---apiVersion: apps/v1kind: Deploymentmetadata: name: frontend namespace: mesh-labspec: replicas: 1 selector: matchLabels: app: frontend template: metadata: labels: app: frontend spec: serviceAccountName: frontend containers: - name: curl image: curlimages/curl:8.21.0@sha256:7c12af72ceb38b7432ab85e1a265cff6ae58e06f95539d539b654f2cfa64bb13 command: ["sleep", "infinity"]---apiVersion: apps/v1kind: Deploymentmetadata: name: batch namespace: mesh-labspec: replicas: 1 selector: matchLabels: app: batch template: metadata: labels: app: batch spec: serviceAccountName: batch containers: - name: curl image: curlimages/curl:8.21.0@sha256:7c12af72ceb38b7432ab85e1a265cff6ae58e06f95539d539b654f2cfa64bb13 command: ["sleep", "infinity"]---apiVersion: v1kind: Podmetadata: name: outsider namespace: legacyspec: containers: - name: curl image: curlimages/curl:8.21.0@sha256:7c12af72ceb38b7432ab85e1a265cff6ae58e06f95539d539b654f2cfa64bb13 command: ["sleep", "infinity"]Avec Istio 1.31.1, le sidecar istio-proxy est un conteneur
d'initialisation natif (init: istio-init istio-proxy) : d'où les 2/2.
Trois fonctions shell raccourcissent les commandes des sections qui
suivent : elles lancent curl depuis l'un des trois Pods clients.
fe() { kubectl -n mesh-lab exec deploy/frontend -c curl -- "$@"; }ba() { kubectl -n mesh-lab exec deploy/batch -c curl -- "$@"; }out() { kubectl -n legacy exec outsider -- "$@"; }Comment vérifier l'identité de l'appelant ?
Section intitulée « Comment vérifier l'identité de l'appelant ? »L'en-tête X-Forwarded-Client-Cert que reçoit httpbin porte l'identité
SPIFFE de l'appelant : c'est la preuve que l'appel est authentifié en mTLS.
Une identité SPIFFE est une URI de la forme
spiffe://cluster.local/ns/<namespace>/sa/<serviceaccount>, tirée du
ServiceAccount du Pod ; la leçon mTLS
pod-to-pod
détaille cette identité et le handshake. Ici, on se contente de la lire.
fe curl -s http://httpbin.mesh-lab:8080/headers"X-Forwarded-Client-Cert": [ "By=spiffe://cluster.local/ns/mesh-lab/sa/httpbin;Hash=fee84672444f1a304e0f1236ff9e60b040bd53c43bda44e27d695bf752456cc8;Subject=\"\";URI=spiffe://cluster.local/ns/mesh-lab/sa/frontend"]Le champ URI= nomme l'appelant (sa/frontend), le champ By= le
destinataire. Ce résultat arrive alors qu'aucune PeerAuthentication
n'existe (kubectl get peerauthentication -A répond No resources found) :
le mode par défaut est PERMISSIVE, qui établit le mTLS automatiquement entre
sidecars et tolère aussi le clair. istioctl x describe affiche ce mode
(Workload mTLS mode: PERMISSIVE), mais il décrit la configuration, pas ce
trafic précis : la preuve, c'est l'en-tête.
Comment imposer un délai entre deux services ?
Section intitulée « Comment imposer un délai entre deux services ? »Un VirtualService avec timeout: 2s fait renvoyer un 504 par le sidecar du
client dès que la réponse dépasse 2 secondes. Un VirtualService est une
ressource Istio qui décrit comment router les requêtes adressées à un hôte,
ici le Service httpbin. Sans lui, un appel lent bloque l'appelant aussi
longtemps que le backend le veut.
apiVersion: networking.istio.io/v1kind: VirtualServicemetadata: name: httpbin namespace: mesh-labspec: hosts: - httpbin http: - timeout: 2s route: - destination: host: httpbin port: number: 8080Mesurez d'abord l'appel sans règle, puis avec. L'option -w de curl
affiche le code HTTP et la durée totale. Attendez trois secondes
après kubectl apply : la configuration doit atteindre le sidecar.
W='code=%{http_code} total=%{time_total}s\n'fe curl -s -o /dev/null -w "$W" http://httpbin.mesh-lab:8080/delay/5kubectl apply -f 20-timeout.yamlsleep 3fe curl -s -w "\n$W" http://httpbin.mesh-lab:8080/delay/5fe curl -s -o /dev/null -w "$W" http://httpbin.mesh-lab:8080/delay/1code=200 total=5.005470svirtualservice.networking.istio.io/httpbin createdupstream request timeoutcode=504 total=2.002792scode=200 total=1.005369sSans règle, /delay/5 répond 200 en 5,005 s. Avec timeout: 2s, il répond
504 en 2,003 s, avec le corps upstream request timeout : ce texte vient
d'Envoy, pas de l'application. /delay/1, sous le seuil, reste à 200.
La règle vaut pour tous les clients du maillage : batch obtient aussi un
504.
Comment imposer des reprises entre deux services ?
Section intitulée « Comment imposer des reprises entre deux services ? »Les reprises (retries) rejouent une requête échouée avant de renoncer, mais Istio en applique déjà par défaut, et elles ne couvrent pas le cas qui vous intéresse. Cette section prouve le comportement par défaut, puis celui d'une règle explicite. Rejouer une requête n'est sûr que si elle est idempotente, c'est-à-dire si la répéter donne le même résultat que la jouer une fois.
Que rejoue Istio sans rien configurer ?
Section intitulée « Que rejoue Istio sans rien configurer ? »Par défaut, le sidecar du client rejoue 2 fois, mais seulement sur des
échecs de connexion ou de transport, pas sur une réponse 5xx de
l'application. La
configuration de la route le montre, lue dans le sidecar de frontend :
istioctl proxy-config route deploy/frontend.mesh-lab --name 8080 -o json | grep -A12 retryPolicy"retryPolicy": { "retryOn": "connect-failure,refused-stream,unavailable,cancelled,retriable-status-codes", "numRetries": 2, ...}numRetries: 2 est donc actif partout, mais retryOn ne cite pas le 5xx
applicatif : retriable-status-codes, sans liste de codes associée, ne
rejoue rien (la référence du VirtualService ne cite que les quatre premières
valeurs de retryOn ; retriable-status-codes apparaît dans la configuration
lue). La mesure le confirme plus bas : un appel à /status/503
n'atteint le serveur qu'une seule fois. Les reprises sur connect-failure
n'ont pas été reproduites : seule leur configuration a été lue.
Comment rendre les reprises observables ?
Section intitulée « Comment rendre les reprises observables ? »Deux réglages sont nécessaires pour compter les tentatives : les journaux d'accès, et les compteurs filtrés du proxy. Aucun n'est actif par défaut, et sans eux vous ne pouvez que deviner le nombre de reprises à partir de la durée.
Les journaux d'accès d'Envoy s'activent avec une ressource Telemetry.
Les compteurs upstream_rq_retry, eux, sont filtrés par la
configuration statistique par défaut du sidecar : il faut les inclure avec
l'annotation de Pod proxy.istio.io/config, ce qui redémarre les Pods.
apiVersion: telemetry.istio.io/v1kind: Telemetrymetadata: name: access-logs namespace: mesh-labspec: accessLogging: - providers: - name: envoyspec: template: metadata: annotations: proxy.istio.io/config: | proxyStatsMatcher: inclusionRegexps: - ".*upstream_rq_retry.*" - ".*upstream_rq_total.*" - ".*upstream_rq_[0-9]xx.*" - ".*upstream_rq_[0-9][0-9][0-9].*"kubectl apply -f 15-telemetry-accesslog.yamlfor d in httpbin frontend batch; do kubectl -n mesh-lab patch deploy $d --patch-file 12-stats-patch.yamldonekubectl -n mesh-lab rollout status deploy --timeout=300sAttendez la fin de rollout status avant de mesurer : juste après le
patch, d'anciens Pods peuvent rester un moment en 0/2 Error ou
Terminating, et kubectl logs deploy/... peut tomber sur l'un d'eux
(message Found 2 pods, using pod/…). Les journaux d'accès ont aussi un
léger retard : une ligne n'apparaît qu'1 à 2 secondes après la requête.
Une fonction lit les compteurs d'un sidecar, une autre les remet à zéro avant
chaque mesure (reset_counters écrit un message d'information sur la sortie
d'erreur, d'où la redirection). Les noms côté client portent un
point-virgule avant le point final, produit par l'extraction des tags
d'Envoy : un grep qui l'oublie ne trouve rien.
stats() { kubectl -n mesh-lab exec deploy/$1 -c istio-proxy -- pilot-agent request GET stats; }reset() { kubectl -n mesh-lab exec deploy/$1 -c istio-proxy -- pilot-agent request POST reset_counters >/dev/null 2>&1; }Combien de requêtes une reprise ajoute-t-elle ?
Section intitulée « Combien de requêtes une reprise ajoute-t-elle ? »Avec attempts: 3, le serveur reçoit 4 requêtes : attempts compte les
reprises, pas les tentatives. Ce VirtualService active retryOn: 5xx, borne
chaque tentative à 2 s avec perTryTimeout et le total à 10 s avec timeout.
apiVersion: networking.istio.io/v1kind: VirtualServicemetadata: name: httpbin namespace: mesh-labspec: hosts: - httpbin http: - timeout: 10s retries: attempts: 3 perTryTimeout: 2s retryOn: 5xx route: - destination: host: httpbin port: number: 8080Les chiffres de cette leçon sont ceux d'une exécution : les durées, et
surtout les résultats de /unstable, changent d'un tirage à l'autre. Retenez
l'ordre de grandeur et la logique, pas la valeur exacte. On appelle
/status/503, qui répond toujours 503, d'abord sans VirtualService
(état initial, après suppression de celui du délai) puis avec celui-ci :
kubectl -n mesh-lab delete virtualservice httpbin --ignore-not-foundreset frontend; reset httpbinfe curl -s -o /dev/null -w "$W" http://httpbin.mesh-lab:8080/status/503stats httpbin | grep -E "inbound.*upstream_rq_(total|503):"
kubectl apply -f 30-retries.yaml; sleep 4reset frontend; reset httpbinfe curl -s -o /dev/null -w "$W" http://httpbin.mesh-lab:8080/status/503stats frontend | grep -E "httpbin.*upstream_rq_(total|retry|retry_success|retry_limit_exceeded|[0-9]{3}):"stats httpbin  | grep -E "inbound.*upstream_rq_(total|503):"
code=503 total=0.013083scluster.inbound|8080||;.upstream_rq_503: 1cluster.inbound|8080||;.upstream_rq_total: 1...code=503 total=0.079555scluster.outbound|8080||httpbin.mesh-lab.svc.cluster.local;.upstream_rq_503: 1cluster.outbound|8080||httpbin.mesh-lab.svc.cluster.local;.upstream_rq_retry: 3cluster.outbound|8080||httpbin.mesh-lab.svc.cluster.local;.upstream_rq_retry_limit_exceeded: 1cluster.outbound|8080||httpbin.mesh-lab.svc.cluster.local;.upstream_rq_retry_success: 0cluster.outbound|8080||httpbin.mesh-lab.svc.cluster.local;.upstream_rq_total: 4cluster.inbound|8080||;.upstream_rq_503: 4cluster.inbound|8080||;.upstream_rq_total: 4Ces deux extraits proviennent de deux exécutions du scénario, séparées
par ... : le premier, d'un appel sans règle (13 ms) ; le second, de
l'appel avec la règle (80 ms). Ils sont comparables, pas simultanés. Les
grep renvoient en réalité quelques lignes de plus, que l'extrait a retirées :
des variantes préfixées (.external.upstream_rq_503,
.retry.upstream_rq_503) et une ligne d'information GOMEMLIMIT écrite par
pilot-agent.
Sans règle, le serveur reçoit 1 requête : aucune reprise malgré
numRetries: 2. Avec la règle, il en reçoit 4 (1 initiale et 3 reprises),
le client compte upstream_rq_retry: 3 et retry_limit_exceeded: 1, et le
client final reçoit quand même le 503. Le journal d'accès du serveur
(kubectl -n mesh-lab logs deploy/httpbin -c istio-proxy --tail=4, après 1 à
2 secondes de délai d'écriture) montre les 4 lignes GET /status/503 avec le même identifiant de requête x-request-id, espacées de 20, 45
puis 9 ms (des intervalles irréguliers : Envoy espace les reprises par un
recul exponentiel avec gigue). La ligne cliente porte le
drapeau URX, « limite de reprises atteinte ».
Pour le scénario attempts: 0 du tableau ci-dessous, la seule forme acceptée
par Istio désactive explicitement les reprises, sans perTryTimeout ni
retryOn :
apiVersion: networking.istio.io/v1kind: VirtualServicemetadata: name: httpbin namespace: mesh-labspec: hosts: - httpbin http: - retries: attempts: 0 route: - destination: host: httpbin port: number: 8080Sur une défaillance intermittente, /unstable?failure_rate=0.5, 40 appels par
scénario depuis frontend ont donné, lors de l'exécution de référence :
| Scénario | Codes sur 40 appels | Requêtes reçues par le serveur | Reprises |
|---|---|---|---|
attempts: 0 | 23 x 200, 17 x 500 | 40 | 0 |
| Défaut Istio (aucun VirtualService) | 17 x 200, 23 x 500 | 40 | 0 |
attempts: 3, retryOn: 5xx | 35 x 200, 5 x 500 | 85 | 45 (16 sauvées) |
Le défaut Istio ne réduit donc pas les erreurs 500. Avec retryOn: 5xx,
le taux d'échec passe d'environ 50 % à 12,5 % (5 sur 40), mais la
charge du backend augmente de 112 % : 85 requêtes pour 40 appels. Ces
chiffres sont ceux d'une seule exécution : /unstable est aléatoire. Un
rejeu a donné 20 x 200 et 20 x 500 sans règle, puis 37 x 200 et 3 x 500 avec
attempts: 3. Seule la tendance se reproduit. Ne rejouez que des appels idempotents, et gardez attempts bas.
À quoi sert perTryTimeout ?
Section intitulée « À quoi sert perTryTimeout ? »perTryTimeout borne chaque tentative, et un dépassement déclenche une
reprise si retryOn le permet. Avec attempts: 2, perTryTimeout: 1s,
retryOn: 5xx et timeout: 10s, un appel à /delay/3 donne :
upstream request timeoutcode=504 total=3.059319scluster.outbound|8080||httpbin.mesh-lab.svc.cluster.local;.upstream_rq_retry: 2cluster.outbound|8080||httpbin.mesh-lab.svc.cluster.local;.upstream_rq_total: 3[...] "GET /delay/3 HTTP/1.1" 504 URX,UT upstream_per_try_timeout - ...Le résultat est un 504 en 3,06 s : trois tentatives d'une seconde
(1 initiale et 2 reprises), que confirment le drapeau URX,UT (UT : délai dépassé) et le détail
upstream_per_try_timeout. Côté serveur, les trois requêtes sont journalisées
avec le code 0 et le drapeau DC (downstream_remote_disconnect) : le
backend a travaillé trois fois pour rien. Le total reste borné par
timeout, ici jamais atteint.
Peut-on tester les reprises avec une panne injectée ?
Section intitulée « Peut-on tester les reprises avec une panne injectée ? »Non : une panne injectée par fault.abort n'est jamais rejouée. Istio sait
simuler une erreur sans toucher au backend, et l'on pourrait croire tester ainsi
une politique de reprises. Mais cette erreur est produite par un filtre du
sidecar client, avant le routeur qui applique les reprises.
apiVersion: networking.istio.io/v1kind: VirtualServicemetadata: name: httpbin namespace: mesh-labspec: hosts: - httpbin http: - fault: abort: httpStatus: 503 percentage: value: 50 timeout: 10s retries: attempts: 3 perTryTimeout: 2s retryOn: 5xx route: - destination: host: httpbin port: number: 8080Mesuré sur 40 appels à /get avec cette règle : 20 x 200 et 20 x 503,
0 reprise et seulement 20 requêtes reçues par le serveur (les 20 autres
n'y sont jamais arrivées). Pour tester des reprises, il faut un vrai backend
défaillant : /status/503 ou /unstable.
Comment n'autoriser que certains services ?
Section intitulée « Comment n'autoriser que certains services ? »Une AuthorizationPolicy de type ALLOW sur un principal ne laisse passer
que l'identité nommée ; tout autre appelant reçoit un 403. Un principal est
l'identité d'un appelant, ici dérivée de son ServiceAccount :
cluster.local/ns/mesh-lab/sa/frontend (l'URI SPIFFE vue plus haut, sans le
préfixe spiffe://). La politique est évaluée par le sidecar du serveur.
Comment autoriser un seul appelant ?
Section intitulée « Comment autoriser un seul appelant ? »Cette politique cible les Pods app: httpbin et n'autorise que frontend :
apiVersion: security.istio.io/v1kind: AuthorizationPolicymetadata: name: httpbin-allow-frontend namespace: mesh-labspec: selector: matchLabels: app: httpbin action: ALLOW rules: - from: - source: principals: - cluster.local/ns/mesh-lab/sa/frontendUne politique ne s'applique pas instantanément. Pendant quelques secondes
après kubectl apply, les réponses peuvent varier d'un appel à l'autre :
un frontend autorisé reçoit parfois un 403, un batch refusé passe parfois.
La cause de ces états transitoires n'a pas été établie. La règle de
mesure en découle : sondez en boucle jusqu'à obtenir une série
stable (cinq lignes identiques d'affilée), et ne concluez jamais sur une seule requête.
line() { echo "$(fe curl -s -o /dev/null -w '%{http_code}' http://httpbin.mesh-lab:8080/get)" \ "$(ba curl -s -o /dev/null -w '%{http_code}' http://httpbin.mesh-lab:8080/get)" \ "$(fe curl -s -o /dev/null -w '%{http_code}' -X POST http://httpbin.mesh-lab:8080/post)" \ "$(out curl -s -o /dev/null -w '%{http_code}' http://httpbin.mesh-lab.svc.cluster.local:8080/get)"}kubectl apply -f 40-authz-allow-frontend.yamlfor i in $(seq 1 15); do line; sleep 1; doneLes quatre colonnes sont : frontend GET /get, batch GET /get,
frontend POST /post, outsider GET /get. Lors de la mesure, les
résultats se sont stabilisés au bout de 11 s (un rejeu : 2 à 5 s) :
t=0s 200 200 200 403 t=1s 200 403 200 403 t=3s 200 200 200 403 t=4s 200 403 200 403 ... STABLE apres 11s : 200 403 200 403À l'état stable : frontend passe (200), batch est refusé (403), et
outsider, qui n'a pas de sidecar donc pas de principal, est refusé aussi,
même en mode PERMISSIVE. Le corps du refus est exactement
RBAC: access denied : il vient du sidecar du serveur, httpbin ne voit
jamais la requête. Le journal d'accès ajoute la cause,
rbac_access_denied_matched_policy[none] : aucune règle ALLOW n'a correspondu.
Comment restreindre méthode et chemin ?
Section intitulée « Comment restreindre méthode et chemin ? »Le bloc to.operation ajoute des conditions sur la méthode et le chemin :
l'appelant autorisé ne peut alors faire que cela. Remplacez la politique par
cette version, qui garde le même nom :
apiVersion: security.istio.io/v1kind: AuthorizationPolicymetadata: name: httpbin-allow-frontend namespace: mesh-labspec: selector: matchLabels: app: httpbin action: ALLOW rules: - from: - source: principals: - cluster.local/ns/mesh-lab/sa/frontend to: - operation: methods: ["GET"] paths: ["/get", "/headers"]Une fois la série stabilisée, les colonnes valent 200 403 403 403 : le
POST de frontend est maintenant refusé, tout comme un GET /anything
(chemin non listé). La commande
istioctl x authz check deploy/httpbin.mesh-lab liste les politiques
effectives du proxy, avec une ligne _anonymous_match_nothing_ que cette
leçon n'a pas explorée.
Que valent la politique vide et DENY ?
Section intitulée « Que valent la politique vide et DENY ? »Une politique sans action ni règle refuse tout, mais seulement si elle est
seule ; un DENY seul laisse passer tout ce qu'il ne nomme pas, y compris
l'appelant anonyme. La documentation d'Istio donne spec: {} pour viser tout
un namespace ; le manifeste testé ici ne porte qu'un selector sur httpbin.
Deux idées reçues tombent ici, mesurées sur les mêmes quatre colonnes :
| Politiques actives | frontend GET | batch GET | frontend POST | outsider |
|---|---|---|---|---|
| Aucune | 200 | 200 | 200 | 200 |
ALLOW principal frontend | 200 | 403 | 200 | 403 |
ALLOW frontend limité à GET /get, /headers | 200 | 403 | 403 | 403 |
| Politique vide (sans règle) seule | 403 | 403 | 403 | 403 |
Politique vide (sans règle) et ALLOW frontend | 200 | 403 | 200 | 403 |
DENY principal batch seule | 200 | 403 | 200 | 200 |
Les politiques ALLOW s'additionnent : dès qu'une autre ALLOW autorise
frontend, la politique vide ne bloque plus rien (ligne 5). Seule une
action DENY est prioritaire. Et un DENY de batch laisse passer
l'anonyme outsider (ligne 6). Pour n'autoriser que frontend, écrivez
donc un ALLOW, pas un DENY des autres. Voici les manifestes des lignes 4
et 6 :
apiVersion: security.istio.io/v1kind: AuthorizationPolicymetadata: name: httpbin-deny-all namespace: mesh-labspec: selector: matchLabels: app: httpbinapiVersion: security.istio.io/v1kind: AuthorizationPolicymetadata: name: httpbin-deny-batch namespace: mesh-labspec: selector: matchLabels: app: httpbin action: DENY rules: - from: - source: principals: - cluster.local/ns/mesh-lab/sa/batchAvec un DENY, le journal d'accès nomme la politique et la règle :
rbac_access_denied_matched_policy[ns[mesh-lab]-policy[httpbin-deny-batch]-rule[0]].
Avant le test suivant, supprimez les politiques :
kubectl -n mesh-lab delete authorizationpolicy --all.
Que devient un Pod hors maillage en mTLS STRICT ?
Section intitulée « Que devient un Pod hors maillage en mTLS STRICT ? »En mode STRICT, un Pod sans sidecar ne reçoit plus de réponse : sa connexion
est coupée avant tout échange HTTP. Une PeerAuthentication fixe le mode
mTLS d'un namespace ; l'activer et la migrer pas à pas relève de la leçon mTLS
pod-to-pod.
Ici, on constate seulement l'effet sur outsider.
apiVersion: security.istio.io/v1kind: PeerAuthenticationmetadata: name: default namespace: mesh-labspec: mtls: mode: STRICTout curl -sS -o /dev/null -w "$W" http://httpbin.mesh-lab.svc.cluster.local:8080/getkubectl apply -f 50-peerauth-strict.yamlsleep 10out curl -sS -o /dev/null -w "$W" http://httpbin.mesh-lab.svc.cluster.local:8080/getfe curl -s -o /dev/null -w "$W" http://httpbin.mesh-lab:8080/getcode=200 total=0.009783speerauthentication.security.istio.io/default createdcurl: (56) Recv failure: Connection reset by peercode=000 total=0.019588scode=200 total=0.002077sEn PERMISSIVE, outsider obtient 200. En STRICT, il reçoit
Connection reset by peer, code de sortie 56, pas de code HTTP
(code=000) ; frontend, dans le maillage, passe toujours. Le sidecar du
serveur n'écrit aucune requête HTTP dans son journal pour cette connexion
refusée, seulement une ligne sans méthode ni chemin
("- - -" 0 NR filter_chain_not_found). Cela
distingue deux refus : un reset sans HTTP est un refus de la couche
mTLS, alors que le 403 RBAC: access denied est une réponse HTTP, donc un
TLS abouti et une identité connue.
Quelle mémoire prévoir pour le maillage ?
Section intitulée « Quelle mémoire prévoir pour le maillage ? »Prévoyez environ 130 Mo pour istiod et 106 Mo par Pod maillé, mais le
profil minimal réserve bien davantage. kubectl top n'est pas disponible
sur kind (pas de metrics-server) : les valeurs ont été lues dans /proc du
conteneur, en fin de lab (trois Pods maillés plus istiod).
| Composant | Consommation relevée | Requests déclarées |
|---|---|---|
istiod | VmRSS 123 Mo au repos, 137 Mo en fin de lab (pic 141 Mo) | 500m CPU, 2 Gi |
| Sidecar (par Pod) | pilot-agent 36 Mo + envoy 70 Mo, soit environ 106 Mo | 100m CPU, 128 Mi (limites 2 CPU, 1 Gi) |
Le nœud kind complet (Kubernetes, Istio et les Pods du lab) occupait 1,42 Gio
selon docker stats. C'est la réservation de 2 Gi d'istiod, pas sa
consommation, qui pèse sur un petit nœud : prévoyez au moins 4 Go de
RAM libres pour ce lab.
Que ce lab ne montre-t-il pas ?
Section intitulée « Que ce lab ne montre-t-il pas ? »Ce lab ne couvre que le mode sidecar, un seul replica de backend et des requêtes HTTP. Honnêtement, voici ce qui n'a pas été éprouvé, à ne pas déduire des mesures ci-dessus :
- le mode ambient d'Istio (sans sidecar), mentionné dans la leçon Le service mesh ;
- le circuit breaking et la détection d'instances défaillantes ;
- le gRPC, et
retriable-status-codesavec des codes explicites ; - la reprise vers un autre replica : avec un seul Pod
httpbin, le prédicat qui évite de retenter le même hôte n'est pas observable ; - les reprises sur
connect-failure, seulement lues dans la configuration ; - la vérification d'attestation de l'archive
istioctl: seule la somme sha256 a été contrôlée.
Une réserve de compatibilité : la documentation d'Istio 1.31 liste
Kubernetes 1.37 comme supporté, mais pas parmi les versions testées en
CI amont. Le lab a tourné sans accroc, ce qui ne prouve que ce comportement-là.
Les résultats sur /unstable sont aléatoires, ceux sur /status/503 et
/delay/N déterministes.
Dépannage
Section intitulée « Dépannage »Les pièges de cette leçon sont presque tous des signaux absents, pas des erreurs affichées. Le tableau part du symptôme que vous voyez.
| Symptôme | Cause | Solution |
|---|---|---|
grep upstream_rq_retry ne renvoie rien côté client | Compteurs de cluster filtrés par la configuration statistique du sidecar | Annoter les Pods avec proxy.istio.io/config et proxyStatsMatcher, redémarrer les Pods |
Le grep des compteurs côté client ne trouve toujours rien | Le nom contient un ; avant le point final : ...svc.cluster.local;.upstream_rq_retry | Chercher httpbin.*upstream_rq_retry sans ancrer sur le point |
kubectl logs -c istio-proxy n'affiche que des lignes de démarrage | Journaux d'accès désactivés par défaut | Créer une ressource Telemetry avec le fournisseur envoy |
istioctl ou kubectl apply rejette attempts: 0 avec http retry policy configured when attempts are set to 0 (disabled) | attempts: 0 est refusé dès qu'on y ajoute perTryTimeout ou retryOn | Écrire retries: {attempts: 0} seul (voir 31-retries-off.yaml) |
Anciens Pods en 0/2 Error, ou kubectl logs deploy/... sur un ancien Pod (Found 2 pods, using pod/…) | Rollout du patch pas terminé | Attendre kubectl rollout status deploy --timeout=300s avant de lire journaux ou compteurs |
| Le journal d'accès n'affiche pas encore la requête | Écriture différée d'1 à 2 secondes | Relancer kubectl logs après une courte attente |
1 seule requête atteint le serveur malgré numRetries: 2 | Les reprises par défaut ne portent pas sur le 5xx applicatif | Ajouter retries avec retryOn: 5xx |
fault.abort ne déclenche aucune reprise | La panne est produite avant le routeur, jamais rejouée | Tester avec un vrai backend défaillant (/status/503) |
Résultats 200 et 403 mélangés après kubectl apply | Politique en cours de propagation | Sonder en boucle jusqu'à 5 lignes identiques d'affilée |
outsider reçoit un 403 sous ALLOW sur principals | Sans sidecar, pas de certificat, donc pas d'identité | Comportement attendu ; placer le Pod dans le maillage |
Connection reset by peer, code=000 | mTLS STRICT : le sidecar coupe la connexion d'un client sans sidecar | Injecter le client, ou repasser en PERMISSIVE le temps de migrer |
Pods Pending ou nœud saturé après installation | Requests de 2 Gi pour istiod, 128 Mi par sidecar | Libérer de la mémoire, ou donner plus de RAM à Docker |
Nettoyer le cluster
Section intitulée « Nettoyer le cluster »Supprimer le cluster libère toute la mémoire réservée. Il n'y a rien d'autre à défaire : aucun port-forward n'a été utilisé.
kind delete cluster --name cn-meshLa sortie annonce Deleting cluster "cn-mesh" ... puis Deleted nodes: ["cn-mesh-control-plane"].
À retenir
Section intitulée « À retenir »- Délai et reprises se posent dans le
VirtualService, appliqués par le sidecar du client ; l'autorisation se pose dans uneAuthorizationPolicy, appliquée par le sidecar du serveur. - Un
timeout: 2sfait renvoyer un 504 (upstream request timeout) par le proxy : mesuré 2,003 s contre 5,005 s sans règle. - Istio rejoue 2 fois par défaut, mais pas sur un 5xx applicatif : ajoutez
retryOn: 5xxpour le couvrir. attempts: Ncompte des reprises :attempts: 3a donné 4 requêtes au serveur, et environ +112 % de charge sur/unstabledans l'exécution mesurée. Ne rejouez que des appels idempotents.fault.abortne sert pas à tester les reprises : la panne n'est jamais rejouée.- Un ALLOW sur un principal (identité SPIFFE) refuse tout autre appelant avec un 403
RBAC: access denied; les ALLOW s'additionnent, et un DENY laisse passer l'anonyme. - Après un
kubectl applyde politique, sondez jusqu'à stabilité ; enSTRICT, un Pod sans sidecar reçoit un reset de connexion, sans HTTP. - Comptez environ 106 Mo par sidecar et prévoyez la réservation de 2 Gi d'
istiod.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications