Le Deployment d'un Service Knative est ramené à zéro réplique environ 61 secondes après la dernière requête, et son Pod n'a complètement disparu qu'au bout de 91 secondes. Cette leçon installe Knative Serving et la passerelle Kourier sur un cluster kind, puis mesure ce que la leçon serverless ne fait qu'expliquer : le délai de passage à zéro, un démarrage à froid de 0,65 s contre 3 ms à chaud, l'effet de min-scale, la montée à 9 Pods sous charge et un découpage de trafic 70/30. Elle s'adresse à qui déploie déjà sur Kubernetes et veut des chiffres avant de décider.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Installer Knative Serving et Kourier avec des manifestes dont vous vérifiez la somme SHA-256.
- Déployer un Service Knative épinglé par digest et lire ses ressources (
ksvc, révision, route). - Chronométrer le passage à zéro Pod et relier le résultat aux réglages réels de
config-autoscaler. - Comparer un démarrage à froid, un démarrage à froid avec image à télécharger et une requête à chaud.
- Supprimer le froid avec
min-scale, et mesurer son prix. - Régler la concurrence cible et lire la montée en Pods sous charge.
- Découper le trafic entre deux révisions et diagnostiquer les erreurs de validation les plus courantes.
Prérequis
Section intitulée « Prérequis »- Les niveaux 1 « Fondamentaux » et 2 « Livrer une application » de la formation Kubernetes : Deployment, Service, sondes, HPA.
- Docker et kind installés. Si ce n'est pas le cas, Créer votre premier cluster Kubernetes local avec kind l'explique pas à pas.
- La leçon Serverless sur Kubernetes, qui définit le scale-to-zero, l'Activator et le
queue-proxy. - Environ 1,5 Gio de mémoire libre, et
curl. Ce chiffre vient des mesures de ce lab (nœud kind complet : 1,25 Gio au repos) ; la documentation d'installation de Knative demande davantage (6 CPU et 6 Go pour un nœud unique), ce lab n'ayant pas cherché à en vérifier le minimum réel.
Que montre cette leçon, et qu'est-ce qu'elle ne montre pas ?
Section intitulée « Que montre cette leçon, et qu'est-ce qu'elle ne montre pas ? »Tout ce qui suit a été rejoué sur un seul nœud kind, avec les réglages par défaut de Knative : les chiffres décrivent ce poste, pas votre production. Les versions de référence sont Knative Serving 1.23.0 et net-kourier 1.23.0 sur un nœud kindest/node:v1.37.0. Aucune plage de versions Kubernetes n'est annoncée par Knative pour cette release : elle a été testée sur Kubernetes 1.37.0 sans anomalie, ce qui ne veut pas dire « supportée officiellement ».
Les accès passent par kubectl port-forward et l'en-tête HTTP Host:, sans DNS public. La leçon ne montre pas Knative Eventing, Knative Functions, le TLS, un cluster multi-nœuds ni une vraie charge de production. Les réglages de descente à zéro n'ont jamais été modifiés : seules leurs valeurs par défaut sont mesurées.
Comment installer Knative Serving et Kourier sur kind ?
Section intitulée « Comment installer Knative Serving et Kourier sur kind ? »L'installation tient en quatre manifestes officiels et un correctif de configuration. Les CRD (définitions de ressources personnalisées) ajoutent les types Service, Configuration, Revision et Route de Knative ; le core déploie le plan de contrôle (activator, autoscaler, controller, webhook) ; Kourier est la couche réseau, une passerelle Envoy pilotée par Knative. Vérifier la somme SHA-256 de chaque fichier avant de l'appliquer est le geste de chaîne d'approvisionnement qui s'impose ici : ces manifestes créent des webhooks et des rôles à l'échelle du cluster.
-
Créer le cluster. Le nœud est épinglé par digest.
Fenêtre de terminal kind create cluster --name cn-knative \--image kindest/node:v1.37.0@sha256:a1ed56cfb0e7b93589bdf97c8cd566405a265939e3620fc4f5de89adff580ae5kubectl wait --for=condition=Ready node --all --timeout=90sRésultat attendu :
node/cn-knative-control-plane condition met. Le nœud afficheNotReadypendant les premières secondes, d'où lewait. -
Télécharger les trois manifestes. Les URL sont celles des releases
knative-v1.23.0.Fenêtre de terminal curl -fsSLO https://github.com/knative/serving/releases/download/knative-v1.23.0/serving-crds.yamlcurl -fsSLO https://github.com/knative/serving/releases/download/knative-v1.23.0/serving-core.yamlcurl -fsSLO https://github.com/knative-extensions/net-kourier/releases/download/knative-v1.23.0/kourier.yaml -
Vérifier les sommes. Ces valeurs sont celles calculées pendant le lab, identiques au fichier
checksums.txtpublié avec chaque release.Fenêtre de terminal cat > SHA256SUMS <<'EOF'b172ff4901ed50f8e4e09ff8616e54d22e264df7086ce8cb74f513a04812fe74 serving-crds.yamlbe3f16c9c0ac9276cc173ef04871aaeac78537f9edb116310caa02f016e9cbc2 serving-core.yamlcded0c3c1d7669b1aa9f7484234b454ff3940a2b54a27d5ec4825c2d4003d01d kourier.yamlEOFsha256sum -c SHA256SUMSRésultat attendu : trois lignes
OK. Une somme différente signifie un fichier modifié ou une autre release : n'appliquez rien. -
Appliquer Serving, puis attendre.
Fenêtre de terminal kubectl apply -f serving-crds.yamlkubectl apply -f serving-core.yamlkubectl -n knative-serving rollout status deployRésultat attendu :
deployment "activator" successfully rolled out, puis la même ligne pourautoscaler,controlleretwebhook. -
Appliquer Kourier et le déclarer comme couche réseau. Sans le correctif de
config-network, Knative garde sa classe d'ingress par défaut, Istio (istio.ingress.networking.knative.dev), et n'utilise pas Kourier. La clé s'écritingress-class, avec un tiret.Fenêtre de terminal kubectl apply -f kourier.yamlkubectl -n knative-serving patch configmap/config-network --type merge \-p '{"data":{"ingress-class":"kourier.ingress.networking.knative.dev"}}'kubectl -n kourier-system rollout status deploykubectl -n kourier-system get pods,svcRésultat attendu :
configmap/config-network patched, puis la passerelle3scale-kourier-gatewayen1/1 Running. Le Servicekourierreste enEXTERNAL-IP <pending>: kind n'a pas de load balancer, c'est normal, d'où les port-forward de l'étape suivante. -
Ouvrir deux accès locaux. Chaque commande occupe un terminal, ou se lance en arrière-plan.
Fenêtre de terminal kubectl -n kourier-system port-forward svc/kourier 18100:80 # chemin externekubectl -n kourier-system port-forward svc/kourier-internal 18101:80 # chemin cluster-local
L'installation compte 6 Pods : activator, autoscaler, controller, webhook et net-kourier-controller dans knative-serving, plus la passerelle dans kourier-system. Une limite de reproductibilité : le manifeste officiel kourier.yaml référence Envoy par le tag mouvant docker.io/envoyproxy/envoy:v1.37-latest. Le lab l'a résolu en envoyproxy/envoy@sha256:a384f50976a8ce7511316776383f907bb5d0edffabac393ada1fdd703a5c1318, mais un lecteur qui rejoue ce lab après coup obtiendra un autre Envoy. Pour éviter cela, remplacez la référence par ce digest dans une copie du manifeste et recalculez sa somme.
Comment déployer un Service Knative ?
Section intitulée « Comment déployer un Service Knative ? »Un seul objet Service Knative crée tout le reste : une Configuration, une Révision, une Route et un Deployment. L'image est épinglée par digest, dans la forme canonique du site. La variable WHOAMI_NAME sert à reconnaître la révision qui répond, et traefik/whoami renvoie en corps de réponse les en-têtes qu'il a reçus, ce qui permet de lire par où est passée la requête.
apiVersion: serving.knative.dev/v1kind: Servicemetadata: name: hello namespace: defaultspec: template: spec: containers: - image: docker.io/traefik/whoami:v1.11.0@sha256:200689790a0a0ea48ca45992e0450bc26ccab5307375b41c84dfc4f2475937ab ports: - containerPort: 80 env: - name: WHOAMI_NAME value: v1Enregistrez ce fichier sous hello-v1.yaml et appliquez-le. Knative affiche un avertissement securityContext à chaque création de révision : des valeurs par défaut de Kubernetes pourraient devenir plus strictes dans une version future de Knative. Il est inoffensif ici.
kubectl apply -f hello-v1.yamlkubectl wait --for=condition=Ready ksvc/hello --timeout=120skubectl get ksvc,configuration,revision,routekubectl get podsLe wait évite de lire l'état trop tôt : sans lui, READY affiche Unknown pendant la résolution du digest. ksvc est l'abréviation de services.serving.knative.dev, pour ne pas la confondre avec un Service Kubernetes. Résultat attendu, tronqué :
service.serving.knative.dev/hello createdNAME URL LATESTCREATED LATESTREADY READYservice.serving.knative.dev/hello http://hello.default.svc.cluster.local hello-00001 hello-00001 True...revision.serving.knative.dev/hello-00001 hello 1 True 1 1...hello-00001-deployment-6bdcfb866b-xnkcx 2/2 Running 0 25sTrois points se lisent ici. L'URL est en svc.cluster.local : sans domaine configuré, le service reste cluster-local. Le Pod affiche 2/2 conteneurs, l'application (user-container) et le queue-proxy que Knative injecte. Et un Pod existe sans aucune requête : initial-scale vaut 1, puis le service redescend seul à zéro.
Testez maintenant l'accès. Un nom en svc.cluster.local est servi par la passerelle interne, donc par le port 18101 :
curl -s -i -H 'Host: hello.default.svc.cluster.local' http://127.0.0.1:18101/Résultat attendu : HTTP/1.1 200 OK, Name: v1, et l'en-tête K-Proxy-Request: activator, preuve du passage par l'Activator. La même requête sur le port 18100 (la passerelle externe) renvoie 404 Not Found avec server: envoy : ce n'est pas une panne, c'est le mauvais service. Un domaine configuré change la donne, voir le dépannage.
Après combien de temps un service passe-t-il à zéro ?
Section intitulée « Après combien de temps un service passe-t-il à zéro ? »Avec les réglages par défaut, le Deployment passe à zéro réplique environ 61 secondes après la dernière requête, et le Pod disparaît environ 30 secondes après, vers 91 secondes. Ces délais ne sont pas affichés par Knative : il faut les chronométrer, en envoyant une requête puis en sondant chaque seconde le Deployment et les Pods.
curl -s -o /dev/null -H 'Host: hello.default.svc.cluster.local' http://127.0.0.1:18101/t0=$(date +%s%3N)while true; do el=$(( $(date +%s%3N) - t0 )) rep=$(kubectl get deploy -l serving.knative.dev/service=hello \ -o jsonpath='{.items[0].spec.replicas}') pods=$(kubectl get pods -l serving.knative.dev/service=hello --no-headers | awk '{print $2" "$3}') echo "t+${el} ms replicas=${rep} pods=[${pods}]" [ -z "$pods" ] && break sleep 1doneTrois essais ont été chronométrés (deux après une requête à froid, un après une requête à chaud) :
| Essai | Deployment à 0 réplique, Pod Terminating | Pod disparu |
|---|---|---|
| 1 | 61,4 s | 91,6 s |
| 2 | 60,4 s | 90,6 s |
| 3 | 61,3 s | 91,5 s |
Pour interpréter ces nombres, il faut lire les réglages en vigueur. Le ConfigMap config-autoscaler livré ne contient qu'une clé _example : aucune valeur n'est activée, et Knative applique les valeurs par défaut que ce bloc documente. Celles de la descente sont :
stable-window: "60s"scale-to-zero-grace-period: "30s"scale-to-zero-pod-retention-period: "0s"enable-scale-to-zero: "true"La fenêtre stable (stable-window, 60 s) est la période d'observation sur laquelle l'autoscaler moyenne le trafic : après 60 s sans requête, la concurrence moyenne tombe à zéro et il décide zéro. Cela correspond à la première mesure, 60 à 61 s. Le délai de grâce (scale-to-zero-grace-period, 30 s) est, selon le commentaire du ConfigMap, une limite haute laissée au réseau pour mettre l'Activator dans le chemin avant de supprimer le dernier Pod ; il peut valoir 0 si l'Activator y est déjà depuis assez longtemps, ce qui est le cas ici (voir la section sur l'Activator) et concorde avec l'absence de 30 s supplémentaires avant le passage à zéro du Deployment, sans que le réglage ait été modifié pour le prouver. La rétention (scale-to-zero-pod-retention-period, 0 s) fixe le temps minimal pendant lequel le dernier Pod reste après la décision de passer à zéro : à zéro seconde, elle n'a aucun effet.
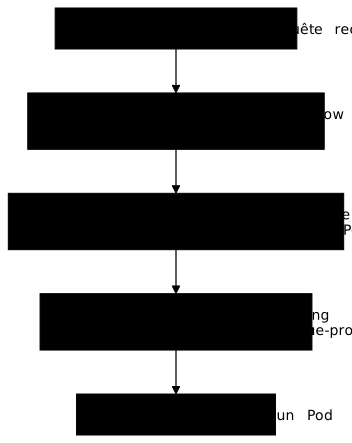
Regardez la dernière flèche du schéma : le Deployment est déjà à zéro à 61 s, et pourtant le Pod reste visible, en Terminating, jusqu'à 91 s. Ces 30 s finales coïncident avec la valeur de scale-to-zero-grace-period, mais ce n'est pas ce réglage qui les fixe, puisque le Deployment est à zéro avant elles. Le Pod porte terminationGracePeriodSeconds: 300, recopié du timeoutSeconds de la révision (300 s par défaut), et le user-container un preStop qui interroge /wait-for-drain sur le port 8022 du queue-proxy. Dans le code de la release 1.23.0, ce point d'accès attend 30 s sans requête (constante drainSleepDuration, indépendante de config-autoscaler) : le drain du sidecar est donc l'explication la plus solide, établie par la lecture du code et par la concordance des durées, mais non vérifiée par une expérience. Faire varier stable-window ou scale-to-zero-grace-period pour voir bouger les mesures n'a pas non plus été fait.
Retenez la formule : une minute de silence pour décider, une trentaine de secondes de plus pour que le Pod parte vraiment. Sur un cluster auto-hébergé, seules les ressources du nœud se libèrent, pas la facture du cluster, comme le précise la leçon serverless.
Que coûte un démarrage à froid ?
Section intitulée « Que coûte un démarrage à froid ? »Un démarrage à froid avec l'image déjà présente sur le nœud coûte environ 0,65 s, contre environ 3 ms pour une requête à chaud. La mesure a été répétée six fois à froid et dix fois à chaud : avant chaque requête à froid, un script attend que plus aucun Pod ne tourne, patiente 2 s, puis envoie la requête avec curl -w '%{time_total}'. Les dix requêtes à chaud suivent en rafale.
| # | Froid : time_total (s) | Chaud : time_total (s) |
|---|---|---|
| 1 | 0,641576 | 0,002779 |
| 2 | 0,647312 | 0,003333 |
| 3 | 0,625212 | 0,002538 |
| 4 | 0,658656 | 0,002756 |
| 5 | 0,653122 | 0,002650 |
| 6 | 0,642512 | 0,002419 |
| 7 à 10 | 0,002380 ; 0,017684 ; 0,002998 ; 0,002691 | |
| Moyenne | 0,645 s (min 0,625 ; max 0,659) | 0,004 s (médiane 0,0027) |
La connexion TCP à froid ne dépasse pas 0,4 ms et le premier octet arrive presque en même temps que la fin de la réponse : tout le délai est une attente côté serveur, le temps que l'Activator retienne la requête pendant que le Pod démarre. Une dernière mesure ajoute le téléchargement de l'image : retirée du cache de containerd, elle a fait monter le premier appel à 3,07 s (2,455 s de pull pour 3 Mo). Mesure unique, donc indicative.
Le froid dépend donc de la présence de l'image sur le nœud et de la taille de l'application : whoami démarre en quelques millisecondes, une application lente à s'initialiser ajoutera son propre délai, que ces chiffres ne contiennent pas. Pendant ce démarrage, un événement Unhealthy ... connection refused apparaît : la sonde de disponibilité échoue avant que le queue-proxy n'écoute, c'est attendu.
Par où passe la requête à froid ?
Section intitulée « Par où passe la requête à froid ? »À zéro Pod, la requête n'arrive pas à une application : elle est retenue par l'Activator. Quand une révision n'a aucun Pod, son ServerlessService passe en mode Proxy, son Service n'a plus de backend, et le trafic est dirigé vers l'Activator. Celui-ci met la requête en attente, prévient l'autoscaler, puis la transmet au Pod prêt. La commande kubectl get sks montre l'état de quatre révisions, dont trois à zéro Pod :
NAME MODE ACTIVATORS SERVICENAME PRIVATESERVICENAME READY REASONhello-00001 Proxy 3 hello-00001 hello-00001-private Unknown NoHealthyBackendshello-00004 Serve 2 hello-00004 hello-00004-private TrueLe schéma suivant trace les chemins. Le trait épais est le chemin par défaut, qui passe par l'Activator ; les traits pointillés montrent le signal de charge envoyé à l'autoscaler et le raccourci direct vers le Pod.
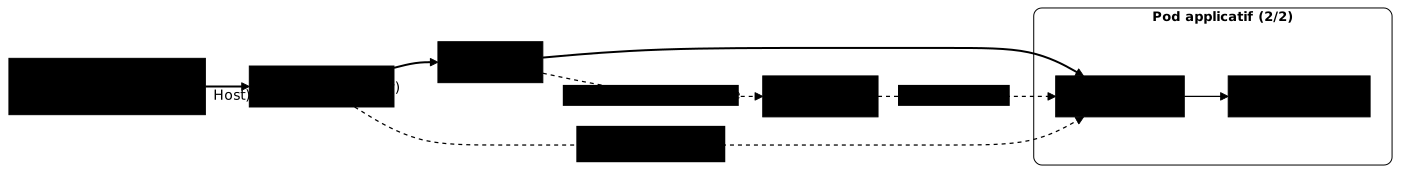
Un point surprend : avec les réglages par défaut, toutes les requêtes portent K-Proxy-Request: activator, froides ou chaudes. Le réglage en cause est target-burst-capacity, qui vaut 211 par défaut : l'Activator reste dans le chemin tant que la capacité libre du service est inférieure à ce nombre de requêtes simultanées, ce qui est le cas avec un seul Pod. La révision 4 (hello-v4-tbc0.yaml, min-scale: "1" plus target-burst-capacity: "0") sort l'Activator du chemin dès qu'un Pod existe : le sks passe en mode Serve et la réponse ne porte plus l'en-tête. Sans min-scale, avec target-burst-capacity: "0" seul, le Deployment est tombé à zéro 90,7 s après la dernière requête (une mesure) au lieu de 61 s : le délai de grâce de 30 s intervient alors avant la décision. Le gain de latence n'est pas mesurable ici, 3 à 4,4 ms dans les deux cas. La colonne ACTIVATORS varie de 2 à 4 alors qu'un seul Pod activator tourne : d'après le code de la release, c'est le nombre d'Activators placés dans le chemin, calculé comme le plus grand de 2 et de (capacité des Pods prêts + target-burst-capacity) / 100. Cela redonne les valeurs relevées (3 à zéro Pod, 4 avec un Pod, 2 avec target-burst-capacity à 0), mais ce n'est pas un nombre de Pods.
Comment supprimer le démarrage à froid avec min-scale ?
Section intitulée « Comment supprimer le démarrage à froid avec min-scale ? »L'annotation autoscaling.knative.dev/min-scale: "1" garde un Pod en permanence : le froid disparaît, au prix d'un Pod toujours présent. Le fichier hello-v2-minscale.yaml reprend hello-v1.yaml en ajoutant, dans spec.template.metadata, un bloc annotations. Placée sur le template, l'annotation fait partie de la révision : la modifier crée une nouvelle révision, ici hello-00002.
spec: template: metadata: annotations: autoscaling.knative.dev/min-scale: "1"Appliquez le manifeste complet (même image, même WHOAMI_NAME) puis lisez la route :
kubectl apply -f hello-v2-minscale.yamlkubectl wait --for=condition=Ready ksvc/hello --timeout=120skubectl get route hello -o jsonpath='{.status.traffic}'Résultat attendu : [{"latestRevision":true,"percent":100,"revisionName":"hello-00002"}]. Environ 80 à 85 s après (deux mesures : 84 s et 81 s), hello-00001, qui ne reçoit plus de trafic, est redescendue à zéro Pod, tandis que hello-00002 garde le sien. Six requêtes envoyées après plus de deux minutes d'inactivité ont répondu entre 3 et 7 ms (3,3 à 4,3 ms lors de la première mesure, 5,3 à 6,5 ms au rejeu sur un poste plus chargé), contre 0,65 s sans min-scale : le froid a disparu.
Le prix est un Pod permanent : un user-container et un queue-proxy (25 m de CPU demandés) qui tournent sans servir personne. min-scale convient à un service sensible à la latence ; pour un service rare et tolérant, le scale-to-zero reste plus économe, au détriment du premier appelant.
Comment régler la concurrence et suivre la charge ?
Section intitulée « Comment régler la concurrence et suivre la charge ? »La concurrence cible dit combien de requêtes simultanées un Pod doit absorber ; l'autoscaler ajoute des Pods pour la respecter. Par défaut, container-concurrency-target-default vaut 100 et container-concurrency-target-percentage 70 : l'autoscaler vise en moyenne 70 % de la cible de chaque Pod. Une annotation autoscaling.knative.dev/target la remplace pour une révision.
Le fichier hello-v3-target.yaml (révision 3) fixe min-scale: "1", max-scale: "10" et target: "5". Avec le pourcentage de 70, la cible effective est de 5 × 0,7 = 3,5 requêtes simultanées par Pod. Pour que chaque requête dure, whoami attend 1 s grâce au paramètre ?wait=1s, ce qui fabrique de la concurrence mesurable.
annotations: autoscaling.knative.dev/min-scale: "1" autoscaling.knative.dev/max-scale: "10" autoscaling.knative.dev/target: "5"La charge est une boucle curl parallèle, sans outil téléchargé : 30 clients, chacun enchaînant des requêtes pendant 60 s.
worker() { while [ "$(date +%s)" -lt "$END" ]; do curl -s -o /dev/null -H 'Host: hello.default.svc.cluster.local' \ -w '%{http_code} %{time_total}\n' 'http://127.0.0.1:18101/?wait=1s'; done; }END=$(( $(date +%s) + 60 ))for i in $(seq 1 30); do worker & done > load-results.txt; waitLancez ces lignes dans bash (la syntaxe des fonctions et des tâches de fond est celle de bash). Un second terminal (Ctrl-C pour l'arrêter) relève toutes les 5 s les Pods Running et les réplicas actuels et désirés de chaque révision :
while true; do n=$(kubectl get pods -l serving.knative.dev/service=hello --no-headers | grep -c Running) d=$(kubectl get revision -l serving.knative.dev/service=hello \ -o jsonpath='{range .items[*]}{.metadata.name}={.status.actualReplicas}/{.status.desiredReplicas} {end}') echo "pods_running=$n $d"; sleep 5doneLa montée observée (la révision hello-00001, à 0/0, est omise de l'extrait) :
t+0s pods_running=2 hello-00002=1/1 hello-00003=1/1t+5s pods_running=6 hello-00003=5/9t+10s pods_running=10 hello-00003=8/9t+20s pods_running=10 hello-00003=9/9t+31s pods_running=9 hello-00002=0/0 hello-00003=9/9requetes: 1770 HTTP 200: 1770temps moyen 1.008 s, max 1.048 sLe calcul se vérifie : 30 requêtes simultanées divisées par 3,5 donnent 8,57, soit 9 Pods, chiffre observé. Le total de 10 à t+10 s compte la révision 2, non routée, redescendue à zéro ensuite. Les 1770 requêtes ont toutes répondu 200, en 1,008 s en moyenne pour 1 s de travail : aucune file d'attente visible, et les Pods supplémentaires étaient prêts en une dizaine de secondes. Le mode panique de l'autoscaler n'a pas été isolé.
Après l'arrêt de la charge, un relevé toutes les 10 s donne 8, 7, 5, 4, 2 puis 1 Pod en 50 s, et ce dernier Pod tient jusqu'à la fin du relevé (131 s) : c'est le plancher de min-scale. Cette descente est plus rapide que la minute de la fenêtre stable ; le lab ne l'a pas décortiquée.
Comment découper le trafic entre deux révisions ?
Section intitulée « Comment découper le trafic entre deux révisions ? »Une Route Knative peut répartir le trafic entre plusieurs révisions et donner une URL à la révision candidate. Le fichier hello-v5-split.yaml crée une cinquième révision (WHOAMI_NAME=v2) et ajoute une section traffic : 70 % vers la révision 4, nommée explicitement, et 30 % vers la dernière révision avec le tag canary.
spec: template: spec: containers: - image: docker.io/traefik/whoami:v1.11.0@sha256:200689790a0a0ea48ca45992e0450bc26ccab5307375b41c84dfc4f2475937ab ports: - containerPort: 80 env: - name: WHOAMI_NAME value: v2 traffic: - revisionName: hello-00004 percent: 70 - latestRevision: true percent: 30 tag: canaryAprès kubectl apply suivi d'un kubectl wait --for=condition=Ready ksvc/hello, la commande kubectl get route hello -o jsonpath='{range .status.traffic[*]}{.revisionName} {.percent}% tag={.tag} url={.url}{"\n"}{end}' confirme la répartition du trafic et publie l'URL du tag de la révision candidate :
hello-00004 70% tag= url=hello-00005 30% tag=canary url=http://canary-hello.default.svc.cluster.localCent requêtes comptées avec sort | uniq -c ont donné 77 réponses Name: v1 et 23 Name: v2, un écart d'échantillonnage normal autour de 70/30. L'URL du tag, appelée avec Host: canary-hello.default.svc.cluster.local, a répondu v2 trois fois sur trois. C'est la base d'un déploiement canari : envoyer 30 % du trafic, ou ne donner que l'URL du tag à une équipe de test.
Un piège : réappliquer un manifeste sans section traffic (par exemple hello-v4-tbc0.yaml) fait disparaître le découpage, car le patch affiché par kubectl contient "traffic":null. Ce comportement est lu dans le patch ("traffic":null) et son effet a été rejoué : la route repasse à 100 % sur la dernière révision, sans tag.
Que coûte la plateforme au repos ?
Section intitulée « Que coûte la plateforme au repos ? »Knative Serving et Kourier occupent environ 121 Mio de mémoire à vide sur ce nœud. La mesure, faite avec crictl stats (working set) faute de metrics-server, Service hello supprimé, donne 94,2 Mio pour knative-serving (cinq Pods) et 26,7 Mio pour la passerelle Envoy. Seul le total est fiable (deux conteneurs portent le même nom controller), et l'écart avec un nœud sans Knative n'a pas été mesuré.
Chaque Pod applicatif ajoute son queue-proxy, avec une requête de 25 m de CPU. Ce coût fixe suggère que Knative se justifie pour un parc de services intermittents plutôt que pour un seul service constamment sollicité.
Nettoyer le cluster
Section intitulée « Nettoyer le cluster »Supprimez le cluster et vérifiez qu'il n'en reste aucun : les accès port-forward disparaissent avec lui, mais les manifestes téléchargés restent dans votre répertoire de travail.
kind delete cluster --name cn-knativekind get clustersRésultat attendu : Deleted nodes: ["cn-knative-control-plane"], et cn-knative absent de la liste.
Dépannage
Section intitulée « Dépannage »Les erreurs de ce tableau ont toutes été rencontrées pendant le lab, avec les messages exacts. Les trois erreurs de validation viennent du webhook de Knative, qui refuse un manifeste invalide avant qu'il ne crée quoi que ce soit : lisez le message jusqu'au bout, il nomme le champ fautif.
| Symptôme | Cause | Solution |
|---|---|---|
curl renvoie 404 Not Found (server: envoy) sur le port 18100 | Le domaine svc.cluster.local est servi par la passerelle interne, pas par kourier | Utiliser svc/kourier-internal (18101), ou configurer un domaine (voir ci-dessous) |
Le nœud affiche NotReady juste après kind create cluster | Le CNI démarre encore | kubectl wait --for=condition=Ready node --all --timeout=90s |
| Le Pod reste visible 90 s après la dernière requête, pas 60 s | 60 s de stable-window, puis environ 30 s de Terminating | Normal avec les valeurs par défaut ; mesurer avant de régler |
Avertissement securityContext à chaque révision | Valeurs par défaut de Kubernetes que Knative pourrait durcir | Inoffensif ; sécurisez le securityContext du conteneur si besoin |
Traffic targets sum to 90, want 100: spec.traffic | Les pourcentages de traffic ne totalisent pas 100 | Corriger les valeurs |
max-scale=2 is less than min-scale=5 | min-scale supérieur à max-scale | Aligner les deux annotations |
target 0 should be at least 0.01 | target: "0" refusé par le webhook | Utiliser une valeur d'au moins 0.01 |
READY False, raison RevisionMissing, message Unable to fetch image ... v9.9.9 ... 404 Not Found | Un tag d'image inexistant : Knative résout les tags en digests auprès du registre | Corriger le tag, ou épingler un digest valide |
zsh: command not found: kubectl --context kind-cn-knative | Une variable contenant la commande n'est pas découpée en mots par zsh | Utiliser un script d'enrobage ou kubectl config use-context |
EXTERNAL-IP <pending> sur svc/kourier | kind n'a pas de load balancer | Passer par kubectl port-forward |
Pour exposer le service par la passerelle externe, ajoutez un domaine dans config-domain : kubectl -n knative-serving patch cm config-domain --type merge -p '{"data":{"kind.local":""}}'. Le Service recréé reçoit l'URL http://hello.default.kind.local, joignable sur le port 18100 avec ce Host:. Aucun DNS public n'est nécessaire, et svc.cluster.local reste un 404 sur cette passerelle.
À retenir
Section intitulée « À retenir »- Knative Serving ramène un service à zéro Pod : avec les valeurs par défaut, le Deployment passe à zéro vers 61 s et le Pod disparaît vers 91 s.
- Les 30 s finales de
Terminatingviennent, d'après le code de la release, du drain de 30 s duqueue-proxy(une constante), pas descale-to-zero-grace-period; aucune expérience ne l'a démontré. - Un démarrage à froid coûte environ 0,65 s avec l'image en cache et 3,07 s avec téléchargement (une mesure) ; une requête à chaud, environ 3 ms.
- À zéro Pod, c'est l'Activator qui retient la requête. Avec
target-burst-capacityà 211 et un seul Pod, il reste dans le chemin même à chaud. min-scale: "1"supprime le froid (3 à 7 ms après deux minutes d'inactivité) mais garde un Pod en permanence.- La cible de concurrence, corrigée par le pourcentage de 70, fixe le nombre de Pods : 30 requêtes simultanées pour une cible effective de 3,5 donnent 9 Pods.
- Chaque modification du
templatecrée une révision ; le champtrafficrépartit entre elles, et un manifeste réappliqué sanstrafficsupprime le découpage du patch ("traffic":null), effet rejoué : la route repasse à 100 % sur la dernière révision. - Cette leçon n'a testé ni Eventing, ni Functions, ni le TLS, ni un cluster multi-nœuds, ni les réglages
stable-windowmodifiés.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Le service mesh
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications