Un namespace est un mécanisme du noyau Linux qui donne à un processus sa
propre vue d'une ressource système : la liste des processus, les interfaces
réseau, les points de montage, le nom d'hôte. Le processus continue de tourner
sur le même noyau, mais il ne voit plus la même chose que vous. Cette page vous
fait construire un environnement isolé à la main avec unshare, vérifier
l'isolation obtenue, puis démonter un conteneur Docker pour constater qu'il
n'est rien d'autre qu'un assemblage de namespaces.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Lister les namespaces d'un processus avec
lsnset/proc/<pid>/ns/. - Créer un shell isolé avec
unshareet prouver que l'isolation est réelle. - Comprendre pourquoi il faut remonter
/procdans un namespace PID. - Obtenir les droits root dans un namespace utilisateur, sans
sudo. - Entrer dans les namespaces d'un conteneur avec
nsenterpour le dépanner. - Distinguer le cgroup namespace (une vue) des contrôleurs cgroup (une limite).
Prérequis
Section intitulée « Prérequis »Toutes les manipulations de cette page ont été exécutées sur Ubuntu 24.04 LTS
(noyau 6.8) avec util-linux 2.39.3, qui fournit unshare, lsns et
nsenter, puis rejouées le 1er octobre 2026 avec Docker 29.1 et Podman
4.9. Un accès sudo est nécessaire pour la majorité des commandes, et un
moteur de conteneurs (Docker ou Podman) pour la dernière partie. Les
commandes fonctionnent à l'identique sur Debian 13 et RHEL 10, seuls les
identifiants de namespaces changent d'une machine à l'autre.
Un lab de niveau A suffit : un shell sur une machine jetable. Les manipulations ne modifient rien de persistant, et chaque namespace créé disparaît quand son dernier processus se termine.
Les huit types de namespaces
Section intitulée « Les huit types de namespaces »Le noyau ne propose pas un mécanisme d'isolation unique mais huit namespaces indépendants, chacun cloisonnant une ressource précise. Vous les combinez à la carte : isoler le réseau sans isoler les processus est parfaitement légitime. C'est cette granularité qui distingue un namespace d'une machine virtuelle.
| Namespace | Ce qu'il isole | Option unshare |
|---|---|---|
| PID | La table des processus. Le premier processus devient PID 1. | --pid |
Mount (mnt) | Les points de montage : chaque namespace a son arborescence. | --mount |
Network (net) | Interfaces, adresses IP, tables de routage, règles de pare-feu. | --net |
| UTS | Le nom d'hôte et le nom de domaine NIS. | --uts |
| IPC | Les communications inter-processus : mémoire partagée, files de messages, sémaphores. | --ipc |
| User | La correspondance des UID et GID, donc les privilèges. | --user |
| Cgroup | La vue de la hiérarchie cgroup, pas les limites de ressources. | --cgroup |
| Time | Les horloges CLOCK_MONOTONIC et CLOCK_BOOTTIME, donc l'uptime perçu. | --time |
UTS signifie Unix Time-Sharing System, un héritage historique : ce
namespace ne touche pas au temps mais au nom d'hôte. Le namespace Time,
lui, ne change pas l'heure murale : date renvoie la même valeur dans et hors
du namespace, seul l'uptime est décalé.
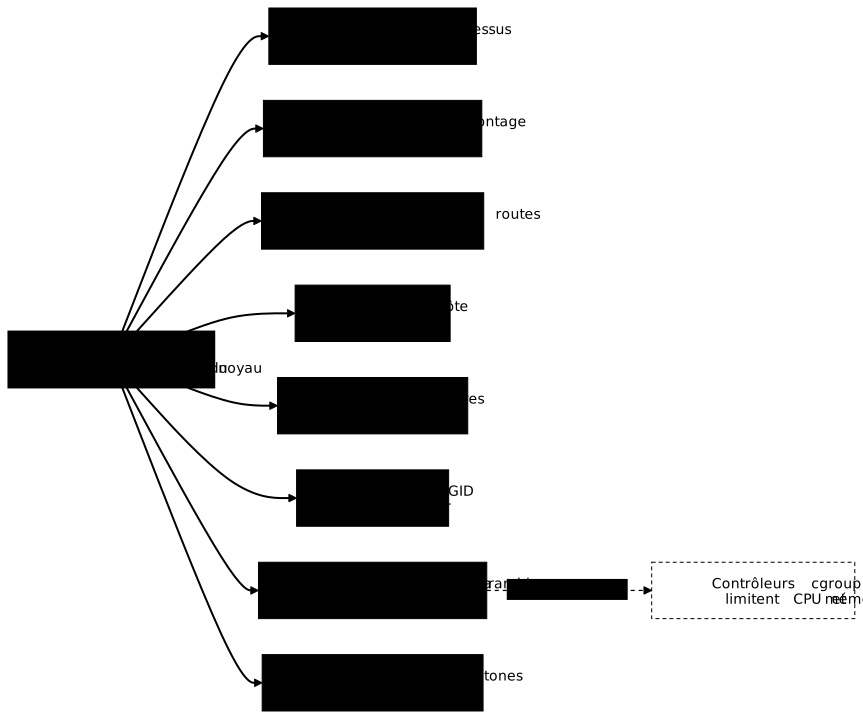
Le schéma résume ce tableau autour d'un processus : chaque flèche est un
cloisonnement que vous activez par une option d'unshare. La flèche en
pointillés rappelle le contresens traité en fin de page : le cgroup
namespace ne limite rien, ce sont les contrôleurs cgroup qui plafonnent
le CPU et la mémoire.
Voir les namespaces de votre système
Section intitulée « Voir les namespaces de votre système »Chaque processus expose ses namespaces dans /proc/<pid>/ns/, un répertoire de
liens symboliques. La cible du lien contient l'identifiant de namespace,
un numéro d'inode unique. Deux processus qui pointent vers le même numéro
partagent le même namespace : c'est le seul critère fiable pour savoir si une
isolation est réelle ou imaginaire.
ls -l /proc/self/ns/lrwxrwxrwx 1 bob bob 0 juil. 12 18:22 cgroup -> cgroup:[4026531835]lrwxrwxrwx 1 bob bob 0 juil. 12 18:22 ipc -> ipc:[4026531839]lrwxrwxrwx 1 bob bob 0 juil. 12 18:22 mnt -> mnt:[4026531841]lrwxrwxrwx 1 bob bob 0 juil. 12 18:22 net -> net:[4026531840]lrwxrwxrwx 1 bob bob 0 juil. 12 18:22 pid -> pid:[4026531836]lrwxrwxrwx 1 bob bob 0 juil. 12 18:22 pid_for_children -> pid:[4026531836]lrwxrwxrwx 1 bob bob 0 juil. 12 18:22 time -> time:[4026531834]lrwxrwxrwx 1 bob bob 0 juil. 12 18:22 time_for_children -> time:[4026531834]lrwxrwxrwx 1 bob bob 0 juil. 12 18:22 user -> user:[4026531837]lrwxrwxrwx 1 bob bob 0 juil. 12 18:22 uts -> uts:[4026531838]Les numéros proches de 4026531835 correspondent aux namespaces initiaux,
ceux créés au démarrage du système. Tout ce qui est isolé ensuite reçoit un
numéro nettement plus élevé. Retenez ce réflexe : readlink /proc/self/ns/net
avant et après une commande vous dit en une seconde si vous avez réellement
changé de namespace.
La commande lsns offre la vue d'ensemble, un namespace par ligne, avec
le nombre de processus qu'il contient et le processus le plus ancien. Sur une
machine qui fait tourner des conteneurs, le décompte par type révèle
immédiatement l'activité de cloisonnement.
lsns -n -o TYPE | sort | uniq -c | sort -rn 9 mnt 7 pid 7 cgroup 6 uts 6 net 6 ipc 2 user 1 timeUn seul namespace time et deux user sur cette machine, contre neuf mnt :
c'est la signature classique d'un hôte Docker. Les moteurs de conteneurs
isolent systématiquement les montages, les processus et le réseau, mais très
rarement le temps et les utilisateurs. Ce déséquilibre a des conséquences de
sécurité vérifiées plus bas.
Créer un environnement isolé avec unshare
Section intitulée « Créer un environnement isolé avec unshare »unshare crée un ou plusieurs namespaces puis y lance une commande. C'est
l'outil qui permet de reconstituer un conteneur à la main, étape par étape,
et de comprendre ce que chaque option apporte réellement.
-
Créer les namespaces PID, Mount et Network en même temps
Chaque option demandée ajoute un cloisonnement. L'option
--forkest obligatoire avec--pid: le processus qui appelleunsharene peut pas changer lui-même de namespace PID, seuls ses enfants y naissent. Sans--fork, votre shell resterait dans l'ancien namespace.Fenêtre de terminal sudo unshare --pid --mount --net --fork bashVérifiez immédiatement que le réseau est bien isolé. Un namespace réseau neuf ne contient qu'une interface de bouclage
lo, éteinte, et rien d'autre :Fenêtre de terminal ip -brief addrlo DOWNFenêtre de terminal ping -c1 -W1 1.1.1.1ping: connect: Network is unreachableAucune route, aucune carte réseau, aucune connectivité. C'est le point de départ de tout conteneur : le moteur lui greffe ensuite une interface virtuelle
veth. -
Constater que
psment encoreVous êtes dans un nouveau namespace PID, et pourtant :
Fenêtre de terminal ps -p 1 -o pid,user,commPID USER COMMAND1 root systemdFenêtre de terminal ps aux | wc -l696psaffiche lesystemdde l'hôte en PID 1 et 696 lignes, soit 695 processus plus l'en-tête, exactement comme si vous n'aviez rien isolé. L'isolation est pourtant bien active, et votre shell le sait :Fenêtre de terminal echo $$1Le shell est le PID 1 de son namespace. C'est
psqui se trompe, parce qu'il lit le/prochérité de l'hôte :--mounta créé un namespace de montage, mais il a copié la table de montages existante,/proccompris. -
Remonter
/procpour quepsdise la véritéLa commande
mountavec le typeprocremplace le/prochérité par un pseudo-système de fichiers alimenté par le namespace PID courant :Fenêtre de terminal mount -t proc proc /procps auxUSER PID %CPU %MEM VSZ RSS TTY STAT START TIME COMMANDroot 1 0.0 0.0 7340 3620 ? S 18:22 0:00 bashroot 7 0.0 0.0 10884 4560 ? R 18:22 0:00 ps auxDeux processus, votre shell et la commande que vous venez de lancer. Le cloisonnement est maintenant visible autant qu'il est réel. Ce remontage n'affecte pas l'hôte : le namespace de montage le confine.
-
Utiliser le raccourci
--mount-procUne fois le mécanisme compris,
unsharesait faire les deux opérations d'un coup. L'option--mount-procimplique--mountet remonte/procautomatiquement :Fenêtre de terminal sudo unshare --pid --net --fork --mount-proc bashps auxUSER PID %CPU %MEM VSZ RSS TTY STAT START TIME COMMANDroot 1 0.0 0.0 4328 3384 ? S 13:58 0:00 bashroot 2 0.0 0.0 7896 4036 ? R 13:58 0:00 ps auxLe shell est le PID 1,
psle PID 2, et rien d'autre n'existe dans ce namespace. C'est la forme à retenir pour un usage courant. Tapezexitpour quitter : le dernier processus du namespace disparaît, et le noyau détruit automatiquement les namespaces devenus vides.
Le user namespace, la clé des conteneurs sans root
Section intitulée « Le user namespace, la clé des conteneurs sans root »Le user namespace est le plus utile à comprendre, car c'est lui qui permet à un utilisateur ordinaire de lancer des conteneurs. Son principe : établir une table de correspondance entre les UID à l'intérieur du namespace et les UID réels sur l'hôte. Vous devenez root dans le namespace, tout en restant un utilisateur sans privilège pour le reste du système.
L'option --map-root-user demande la correspondance la plus simple :
« l'UID 0 ici, c'est mon UID là-bas ». Aucun sudo n'est nécessaire.
# Hors du namespaceiduid=1000(bob) gid=1000(bob) groups=1000(bob),27(sudo),990(docker)unshare --user --map-root-user bashiduid=0(root) gid=0(root) groups=0(root),65534(nogroup)Vous êtes root. Les groupes secondaires sudo et docker, qui n'ont pas
de correspondance dans le namespace, apparaissent sous le nom nogroup. La
table de correspondance, exposée dans /proc/self/uid_map, explique exactement
ce qui s'est passé : trois colonnes, l'UID de départ dans le namespace,
l'UID correspondant sur l'hôte, et la taille de la plage.
cat /proc/self/uid_map 0 1000 1L'UID 0 du namespace correspond à l'UID 1000 de l'hôte, sur une plage d'un seul identifiant. Ce root est donc un root de façade, et le noyau le sait. Toute opération qui touche une ressource appartenant à l'hôte est refusée :
touch /etc/preuve-usernstouch: cannot touch '/etc/preuve-userns': Permission deniedRoot dans le namespace, impuissant en dehors. En revanche, ce root possède
les capabilities dans son propre namespace, ce qui lui permet de créer
d'autres namespaces sans sudo :
unshare --net --fork ip -brief addrlo DOWNUn utilisateur non privilégié vient de créer un namespace réseau. C'est précisément le mécanisme sur lequel reposent Podman rootless, Buildah et les conteneurs non privilégiés en général.
Les autres namespaces en pratique
Section intitulée « Les autres namespaces en pratique »Les namespaces UTS, IPC et Time sont plus simples, mais leur démonstration est instructive : chacun se vérifie par une commande unique, et l'effet reste strictement confiné.
Le namespace UTS donne à un environnement son propre nom d'hôte. C'est
ce qui permet à un conteneur de s'appeler conteneur-web alors que la machine
s'appelle autrement. Le changement est totalement confiné : l'hôte ne le
voit jamais.
hostname # master1sudo unshare --uts --fork bashhostname conteneur-webhostname # conteneur-webexithostname # master1, inchangéLe namespace IPC cloisonne les objets de communication inter-processus : files de messages, sémaphores, segments de mémoire partagée. Deux conteneurs ne peuvent pas se marcher dessus, et un objet créé dans le namespace disparaît avec lui.
sudo unshare --ipc --fork bashipcmk -Q # Message queue id: 0ipcs -q------ Message Queues --------key msqid owner perms used-bytes messages0x38b103b1 0 root 644 0 0Depuis l'hôte, la même commande ipcs -q ne montre aucune file : l'objet
est invisible en dehors de son namespace, ce qui protège les applications
voisines.
Le namespace Time décale les horloges monotones. Il sert surtout à la
migration de conteneurs et à la restauration d'instantanés, où un logiciel
doit retrouver l'uptime qu'il avait avant d'être déplacé. L'option --boottime
prend un décalage en secondes, ici sept jours.
uptime -p # up 9 hours, 48 minutessudo unshare --time --fork --boottime 604800 bashuptime -pup 1 week, 9 hours, 48 minutesL'heure courante, elle, n'est pas modifiée : date renvoie la même valeur
des deux côtés, car seules CLOCK_MONOTONIC et CLOCK_BOOTTIME sont
décalées.
Des namespaces réseau persistants avec ip netns
Section intitulée « Des namespaces réseau persistants avec ip netns »Un namespace créé par unshare meurt avec son dernier processus. Pour un
lab réseau, vous voulez souvent l'inverse : un namespace qui survit entre
deux commandes. La sous-commande ip netns répond à ce besoin en ancrant le
namespace à un fichier dans /run/netns/, ce qui l'empêche d'être détruit.
sudo ip netns add labnsip netns listsudo ip netns exec labns ip -brief addrlabnslo DOWNLe namespace existe alors qu'aucun processus n'y tourne, et chaque
ip netns exec y lance une commande à la demande. Une fois lo activée, le
bouclage fonctionne à l'intérieur, isolé de celui de l'hôte :
sudo ip netns exec labns ip link set lo upsudo ip netns exec labns ping -c1 127.0.0.11 packets transmitted, 1 received, 0% packet loss, time 0msUn namespace persistant se supprime explicitement, sans quoi il reste en place jusqu'au redémarrage. Prenez l'habitude de nettoyer :
sudo ip netns delete labnsip netns listLa liste doit revenir vide. C'est l'outil de prédilection pour simuler des routeurs, des pare-feu ou des topologies multi-sites sur une seule machine.
Ce qu'un conteneur isole vraiment
Section intitulée « Ce qu'un conteneur isole vraiment »Un conteneur n'est pas une technologie du noyau : c'est un assemblage de namespaces, de cgroups et de capabilities orchestré par un moteur. La meilleure façon de s'en convaincre est de lancer un conteneur, puis de l'inspecter avec les outils que vous venez d'apprendre. L'image est nginx 1.29.8 sur Alpine, épinglée par son digest :
docker run -d --name mon-conteneur \ nginx:1.29.8-alpine@sha256:5616878291a2eed594aee8db4dade5878cf7edcb475e59193904b198d9b830dePID=$(docker inspect -f '{{.State.Pid}}' mon-conteneur)sudo lsns -p "$PID" NS TYPE NPROCS PID USER COMMAND4026531834 time 745 1 root /sbin/init4026531837 user 738 1 root /sbin/init4026533214 mnt 17 723602 root nginx: master process nginx -g daemon off;4026533215 uts 17 723602 root nginx: master process nginx -g daemon off;4026533216 ipc 17 723602 root nginx: master process nginx -g daemon off;4026533218 pid 17 723602 root nginx: master process nginx -g daemon off;4026533219 cgroup 17 723602 root nginx: master process nginx -g daemon off;4026533220 net 17 723602 root nginx: master process nginx -g daemon off;Lisez attentivement les deux premières lignes. Les namespaces time et
user affichent le PID 1 de l'hôte (/sbin/init) et des centaines de
processus : le conteneur les partage avec l'hôte. Seuls six namespaces sur
huit sont réellement isolés, ce que le relevé du 1er octobre 2026 avec
Docker 29.1 reproduit à l'identique. La comparaison des identifiants ne
laisse aucune place au doute.
| Type | Hôte (PID 1) | Conteneur nginx | Isolé ? |
|---|---|---|---|
| mnt | mnt:[4026531841] | mnt:[4026533214] | oui |
| uts | uts:[4026531838] | uts:[4026533215] | oui |
| ipc | ipc:[4026531839] | ipc:[4026533216] | oui |
| pid | pid:[4026531836] | pid:[4026533218] | oui |
| net | net:[4026531840] | net:[4026533220] | oui |
| cgroup | cgroup:[4026531835] | cgroup:[4026533219] | oui |
| user | user:[4026531837] | user:[4026531837] | non, partagé |
| time | time:[4026531834] | time:[4026531834] | non, partagé |
L'absence de user namespace est le point de sécurité majeur de Docker en
configuration par défaut : root dans le conteneur est root sur l'hôte. La
commande ps sur l'hôte le confirme, le processus nginx y tourne sous
l'identité root. Si ce processus s'échappe de son cloisonnement, il s'échappe
avec les pleins pouvoirs. Docker sait activer un user namespace via l'option
userns-remap, mais ce n'est pas le comportement par défaut.
Podman en mode rootless fait le choix inverse et illustre parfaitement
la section précédente. Le même nginx, lancé sans sudo, se croit root :
podman run --rm docker.io/library/nginx:1.29.8-alpine@sha256:5616878291a2eed594aee8db4dade5878cf7edcb475e59193904b198d9b830de iduid=0(root) gid=0(root) groups=0(root),1(bin),2(daemon),3(sys),4(adm),6(disk),10(wheel),11(floppy),20(dialout),26(tape),27(video)Mais vu de l'hôte, ce processus appartient à l'utilisateur ordinaire qui l'a lancé, et non à root, ce qui borne les dégâts d'une évasion :
PID USER COMMAND 727603 bob nginxLa table de correspondance vient des plages déléguées dans /etc/subuid,
que podman unshare affiche directement. La première ligne mappe votre compte
sur root, la seconde délègue 65 536 UID supplémentaires pour les autres
utilisateurs de l'image :
podman unshare cat /proc/self/uid_map 0 1000 1 1 100000 65536Entrer dans un conteneur avec nsenter
Section intitulée « Entrer dans un conteneur avec nsenter »nsenter fait l'opération inverse d'unshare : au lieu de créer des
namespaces, il rejoint ceux d'un processus existant. C'est l'outil de
dépannage par excellence, parce qu'il ne dépend pas du moteur de
conteneurs et fonctionne même si le démon Docker ne répond plus.
sudo nsenter --target "$PID" --mount --uts --ipc --pid --net --cgroup -- shVous obtenez l'équivalent d'un docker exec, avec le nom d'hôte, le
système de fichiers et la table de processus du conteneur :
# hostname2e17ffa2b5a9# ps -efPID USER TIME COMMAND 1 root 0:00 nginx: master process nginx -g daemon off; 30 nginx 0:00 nginx: worker processL'astuce vraiment précieuse consiste à ne rejoindre que le namespace réseau.
Vous gardez alors le système de fichiers de l'hôte, donc vos outils, tout en
observant le réseau du conteneur. C'est la réponse au cas classique de l'image
minimale qui ne contient ni ip, ni ss, ni curl, ou seulement leur
version BusyBox :
sudo nsenter --target "$PID" --net -- ip -brief addrsudo nsenter --target "$PID" --net -- ss -tlnlo UNKNOWN 127.0.0.1/8 ::1/128eth0@if356 UP 172.17.0.3/16
State Recv-Q Send-Q Local Address:Port Peer Address:PortLISTEN 0 511 0.0.0.0:80 0.0.0.0:*LISTEN 0 511 [::]:80 [::]:*Vous voyez l'adresse IP du conteneur et le port 80 en écoute, sans avoir
installé quoi que ce soit dans l'image. Retenez ce réflexe : pour diagnostiquer
le réseau d'un conteneur, nsenter --net bat docker exec dans presque tous
les cas.
Le cgroup namespace ne limite rien
Section intitulée « Le cgroup namespace ne limite rien »C'est le contresens le plus répandu à la lecture de lsns. Voir un
namespace cgroup sur un conteneur ne signifie pas que sa mémoire ou son
CPU sont limités. Le cgroup namespace virtualise la vue de la
hiérarchie cgroup : il fait croire au processus que son cgroup est la racine.
Rien de plus.
Sur l'hôte, nginx appartient à un cgroup au chemin bien identifié, une scope nommée d'après l'ID du conteneur :
sudo cat /proc/$PID/cgroup0::/system.slice/docker-2e17ffa2b5a9a90bc24fac62ecce9da06ebc481b11ecf57b3d563643d4bbdf0d.scopeVu de l'intérieur du conteneur, le même cgroup s'affiche ainsi :
docker exec mon-conteneur cat /proc/self/cgroup0::/Même cgroup, deux vues différentes. Le namespace a masqué le chemin réel, ce qui évite de divulguer l'arborescence de l'hôte et permet aux outils du conteneur de raisonner sur une racine propre. La preuve que rien n'est limité tient en une commande : ce conteneur possède bien un cgroup namespace, et pourtant sa mémoire est illimitée.
docker exec mon-conteneur cat /sys/fs/cgroup/memory.maxmaxLa limitation vient des contrôleurs cgroup, que le moteur configure seulement si vous les demandez. Le même conteneur lancé avec des quotas donne un tout autre résultat :
docker run -d --name conteneur-limite --memory=64m --cpus=0.5 \ nginx:1.29.8-alpine@sha256:5616878291a2eed594aee8db4dade5878cf7edcb475e59193904b198d9b830dedocker exec conteneur-limite cat /sys/fs/cgroup/memory.maxdocker exec conteneur-limite cat /sys/fs/cgroup/cpu.max6710886450000 100000Les deux conteneurs ont chacun leur cgroup namespace, mais seul le second est contraint : 64 Mio de mémoire, et 50 000 microsecondes de CPU par période de 100 000, soit un demi-cœur. Le partage des ressources est le sujet des cgroups ; les namespaces, eux, ne font que cloisonner la visibilité.
Retenez la formule : les namespaces décident de ce qu'un processus voit, les cgroups décident de ce qu'il consomme, et les capabilities décident de ce qu'il a le droit de faire. Un conteneur, c'est les trois à la fois.
Nettoyer votre lab
Section intitulée « Nettoyer votre lab »Les namespaces créés par unshare disparaissent seuls quand vous quittez le
shell, mais les conteneurs et les namespaces persistants restent.
Terminez toujours par ce nettoyage, et vérifiez que la liste des namespaces
réseau persistants est bien vide :
docker rm -f mon-conteneur conteneur-limitesudo ip netns delete labns 2>/dev/nullip netns listDépannage
Section intitulée « Dépannage »Les erreurs rencontrées lors de ces manipulations sont toujours les mêmes, et elles ont toutes une cause simple. Ce tableau reprend celles réellement produites pendant l'écriture de cette page, avec la correction qui fonctionne, vérifiée commande par commande.
| Symptôme | Cause | Solution |
|---|---|---|
ps aux affiche tous les processus de l'hôte dans un namespace PID | /proc est celui de l'hôte, hérité par le namespace de montage | Exécuter mount -t proc proc /proc dans le namespace, ou lancer unshare avec --mount-proc |
| Le shell « isolé » voit toutes les interfaces réseau de l'hôte | L'option --net a été oubliée : aucun namespace réseau n'a été créé | Ajouter --net et vérifier avec readlink /proc/self/ns/net |
unshare: write failed /proc/self/uid_map: Operation not permitted | Ubuntu 23.10+ restreint les user namespaces non privilégiés via AppArmor | Vérifier sysctl kernel.apparmor_restrict_unprivileged_userns et le passer à 0 pour un lab |
bash: fork: Cannot allocate memory après unshare --pid sans --fork | Le processus appelant n'est pas entré dans le nouveau namespace PID | Toujours associer --fork à --pid |
ip -brief addr échoue dans un nsenter --mount | Vous utilisez le ip de l'image, souvent un BusyBox sans l'option -brief | Rejoindre uniquement --net pour conserver les outils de l'hôte |
nsenter: cannot open /proc/<pid>/ns/pid: No such file or directory | Le processus cible est mort, ou vous n'êtes pas root | Relire le PID avec docker inspect -f '{{.State.Pid}}' et préfixer par sudo |
À retenir
Section intitulée « À retenir »- Un namespace cloisonne la vue d'une ressource, pas sa consommation. Huit types existent : PID, Mount, Network, UTS, IPC, User, Cgroup, Time.
- L'isolation ne s'obtient que pour les namespaces explicitement demandés. Sans
--net, le réseau de l'hôte reste entièrement accessible. --forkest obligatoire avec--pid: seuls les enfants du processus naissent dans le nouveau namespace PID.- Tant que
/procn'est pas remonté,psaffiche les processus de l'hôte. L'isolation est réelle, c'est l'affichage qui ment. - Le user namespace mappe l'UID 0 interne sur votre UID réel : root dedans, sans aucun privilège dehors. C'est le fondement des conteneurs rootless.
- Un conteneur Docker par défaut partage les namespaces
userettimede l'hôte : root dans le conteneur reste root sur la machine. - Le cgroup namespace virtualise la vue de la hiérarchie, il ne limite aucune ressource. Les limites viennent des contrôleurs cgroup.
nsenter --target <pid> --netest l'outil de diagnostic réseau à privilégier : il donne le réseau du conteneur avec les outils de l'hôte.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de ce guide est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Capabilities
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications
Aux origines des namespaces
Section intitulée « Aux origines des namespaces »Le mécanisme n'est pas né avec les conteneurs. Le premier namespace, celui des points de montage, apparaît dès 2002 dans le noyau 2.4.19, inspiré des travaux du système Plan 9 de Bell Labs. Les namespaces UTS et IPC suivent en 2006, le PID et le Network en 2008, puis le User en 2013, qui débloque enfin les conteneurs non privilégiés. Le Cgroup arrive en 2016 et le Time en 2020 avec le noyau 5.6.
L'arrivée de Docker en 2013 n'a
donc rien inventé sur le plan du noyau. Sa contribution a été d'assembler
briques existantes et format d'image dans un outil utilisable, là où les
technologies antérieures demandaient une expertise système considérable.
Aujourd'hui, Kubernetes orchestre
des milliers de conteneurs qui reposent tous, in fine, sur les appels système
clone, unshare et setns que vous venez de manipuler à la main.