Grafana Loki centralise les logs de toute votre infrastructure et les rend consultables depuis Grafana, sans indexer leur contenu. Là où Elasticsearch indexe chaque mot, Loki n'indexe que les labels (comme Prometheus). Résultat : un déploiement rapide, un stockage réduit et un coût maîtrisé, au prix d'une recherche full-text moins poussée.
La leçon précédente a centralisé les logs d'un cluster avec Promtail, l'agent historique. Celle-ci reprend Loki hors Kubernetes, avec l'agent qui le remplace : vous allez démarrer Loki en local, collecter des logs avec Grafana Alloy, les interroger en LogQL et voir comment passer en production sur stockage objet.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Comprendre pourquoi Loki n'indexe que les labels et ce que ça change.
- Démarrer Loki en local avec Docker, puis sur Kubernetes.
- Collecter les logs avec Grafana Alloy, le successeur de Promtail.
- Interroger vos logs avec le langage LogQL.
- Éviter le piège de la cardinalité et configurer le stockage objet.
Pourquoi Loki plutôt qu'Elasticsearch
Section intitulée « Pourquoi Loki plutôt qu'Elasticsearch »Chercher un log lors d'un incident ne devrait pas coûter le prix d'un moteur d'indexation full-text. C'est le pari de Loki : au lieu d'indexer chaque mot de chaque ligne, il n'indexe que les labels attachés aux flux de logs (le service, l'environnement, le pod). Le contenu part compressé dans un stockage objet bon marché.
Ce choix explique son positionnement et ses limites.
| Problème courant | Réponse de Loki |
|---|---|
| Logs éparpillés sur N serveurs | Centralisation via un agent (Alloy) |
| Coût de stockage d'Elasticsearch | Pas d'index full-text, stockage réduit |
| Corréler logs et métriques | Mêmes labels que Prometheus |
| Apprendre un nouveau langage | LogQL, proche de PromQL |
Démarrer Loki en local
Section intitulée « Démarrer Loki en local »Le plus simple est un conteneur unique avec un stockage sur disque. On écrit d'abord une configuration minimale de développement : authentification désactivée, anneau en mémoire, index TSDB et stockage filesystem.
auth_enabled: false
server:  http_listen_port: 3100
common:  ring:    instance_addr: 127.0.0.1    kvstore:      store: inmemory  replication_factor: 1  path_prefix: /loki
schema_config:  configs:    - from: 2024-01-01      store: tsdb      object_store: filesystem      schema: v13      index:        prefix: index_        period: 24h
storage_config:  filesystem:    directory: /loki/chunks
limits_config:  retention_period: 168h  # 7 jours
On lance ensuite Loki en épinglant la version, pour un résultat reproductible :
docker run -d --name loki -p 3100:3100 \ -v "$(pwd)/loki-config.yaml:/etc/loki/config.yaml" \ grafana/loki:3.7.3@sha256:70b9f699fc9bb868b62f1cfd4f787dfa50242f1fd92e6089787d5d7daea75fe8 \ -config.file=/etc/loki/config.yamlVérification : curl http://localhost:3100/ready doit répondre ready. Sur Kubernetes, le chart Helm officiel déploie Loki en une commande :
helm repo add grafana https://grafana.github.io/helm-chartshelm repo updatehelm install loki grafana/loki --namespace monitoring --create-namespace \ --set loki.auth_enabled=false --set singleBinary.replicas=1Ce mode monolithique convient au test et aux petits volumes ; en production, on passe au mode distribué avec un stockage objet.
L'architecture de Loki
Section intitulée « L'architecture de Loki »Loki repose sur trois briques complémentaires. Comprendre leur rôle aide à diagnostiquer un flux de logs qui n'arrive pas.
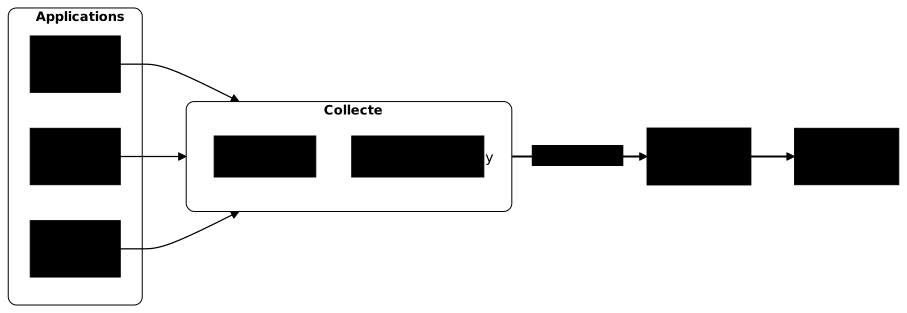
| Composant | Rôle |
|---|---|
| Grafana Alloy | Agent qui collecte les logs et les pousse vers Loki |
| Loki | Stocke les logs, les organise par labels, répond aux requêtes |
| Grafana | Interface de requête et de visualisation |
Les labels, clé de voûte de Loki
Section intitulée « Les labels, clé de voûte de Loki »Loki n'indexe pas le contenu des logs, il les range par labels, exactement comme Prometheus range ses métriques. Un flux de logs est identifié par un ensemble de labels :
{namespace="production", app="frontend", pod="frontend-abc123"}Ces labels permettent de filtrer rapidement, de corréler avec les métriques Prometheus (mêmes labels) et de réduire les coûts (pas d'index massif). Leur choix est donc décisif, et c'est aussi là que se cache le principal piège, la cardinalité, détaillé plus bas.
Collecter les logs avec Grafana Alloy
Section intitulée « Collecter les logs avec Grafana Alloy »Grafana Alloy est l'agent de collecte recommandé, successeur de Promtail (déprécié depuis 2025). C'est un collecteur unifié, bâti sur l'OpenTelemetry Collector, qui rassemble logs, métriques et traces. On le configure en déclarant une source de logs et une destination loki.write.
L'exemple ci-dessous lit tous les fichiers .log d'un dossier, leur attache le label app, et les pousse vers Loki :
local.file_match "app" {  path_targets = [{"__path__" = "/logs/*.log", "app" = "demo"}]}
loki.source.file "app" {  targets    = local.file_match.app.targets  forward_to = [loki.write.default.receiver]}
loki.write "default" {  endpoint {    url = "http://loki:3100/loki/api/v1/push"  }}
On lance Alloy en montant la configuration et les logs à collecter :
docker run -d --name alloy \ -v "$(pwd)/config.alloy:/etc/alloy/config.alloy" \ -v "$(pwd)/logs:/logs" \ grafana/alloy:v1.17.1@sha256:4f6ddc56ffdcf8a6316748fc5162972e20cb301523cac1bb4a31957df733ae9b \ run /etc/alloy/config.alloyPour d'autres sources, Alloy fournit des composants dédiés : loki.source.docker pour les conteneurs, et l'intégration Kubernetes pour collecter automatiquement les logs des pods. Le guide Alloy détaille ces cas.
Interroger les logs avec LogQL
Section intitulée « Interroger les logs avec LogQL »LogQL est le langage de requête de Loki, dans l'esprit de PromQL. On commence par sélectionner les streams via leurs labels, puis on filtre le contenu, et on peut enfin agréger.
{label="valeur"} # sélection par labels{app="nginx"} |= "error" # contient "error"{app="nginx"} |~ "5[0-9]{2}" # regex (codes 5xx){app="nginx"} != "healthcheck" # ne contient pasLes opérateurs de filtrage se combinent avec les parseurs pour extraire des champs structurés.
| Opérateur | Description | Exemple |
|---|---|---|
|= | Contient (exact) | |= "error" |
!= | Ne contient pas | != "healthcheck" |
|~ | Correspond à la regex | |~ "5[0-9]{2}" |
!~ | Ne correspond pas à la regex | !~ "debug" |
| json | Parse le JSON | | json | level="error" |
| logfmt | Parse le logfmt | | logfmt | duration > 100 |
Quelques requêtes concrètes :
# Toutes les erreurs du frontend en production{namespace="production", app="frontend"} |= "error"
# Parser un log JSON et filtrer sur un champ{app="nginx"} | json | status_code = 500
# Compter les erreurs par minutecount_over_time({app="api"} |= "error" [1m])Connecter Loki à Grafana
Section intitulée « Connecter Loki à Grafana »Loki n'a pas d'interface propre : il se consulte depuis Grafana, où il devient une source de données. La configuration prend moins d'une minute.
-
Ouvrir Grafana sur
http://localhost:3000(identifiants par défautadmin/admin). -
Ajouter la source : menu Connexions, Data sources, Add data source, choisir Loki.
-
Renseigner l'URL :
http://loki:3100sur Kubernetes, ou l'adresse de votre conteneur. -
Valider avec « Save & test », qui confirme la connexion.
-
Premiers logs : dans Explore, tapez
{app="demo"}, le label posé par la configuration Alloy ci-dessus, pour voir remonter vos premiers logs.
Passer en production avec un stockage objet
Section intitulée « Passer en production avec un stockage objet »En production, le filesystem local ne convient pas : un seul nœud, pas de réplication, disque qui se remplit. On bascule le storage_config vers un stockage objet (S3, GCS ou MinIO) et on adapte la rétention.
schema_config:  configs:    - from: 2024-01-01      store: tsdb      object_store: s3      schema: v13      index:        prefix: loki_index_        period: 24h
storage_config:  aws:    s3: s3://eu-west-3/mon-bucket-loki    s3forcepathstyle: true  tsdb_shipper:    active_index_directory: /loki/tsdb-index    cache_location: /loki/tsdb-cache
limits_config:  retention_period: 336h  # 14 jours
Trois réglages comptent : le backend objet pour le volume, la rétention pour maîtriser le coût, et les limites d'ingestion pour qu'un service bavard ne sature pas la plateforme.
Le piège de la cardinalité
Section intitulée « Le piège de la cardinalité »La cardinalité est l'ennemi numéro un de Loki. Chaque combinaison unique de labels crée un stream distinct. Utiliser un identifiant à forte variété (un request_id, un user_id) comme label génère des millions de streams et effondre les performances.
La règle est simple : les labels décrivent la provenance (namespace, app, pod), pas le contenu. Les données à forte cardinalité restent dans le corps du log, où LogQL les extrait à la demande avec | json ou | logfmt. On garde ainsi un nombre de streams raisonnable tout en pouvant filtrer finement.
Dépannage
Section intitulée « Dépannage »La plupart des incidents Loki tiennent à la collecte ou à la cardinalité. Voici les symptômes les plus fréquents.
| Symptôme | Cause probable | Solution |
|---|---|---|
connection refused sur :3100 | Loki non démarré | Vérifier docker logs loki |
| Aucun log dans Grafana | L'agent ne pousse pas | Vérifier l'url de loki.write dans Alloy |
rate limited à l'ingestion | Trop de logs ou de labels | Augmenter limits_config.ingestion_rate_mb |
| Requêtes lentes | Trop de streams | Réduire la cardinalité des labels |
# L'agent voit-il Loki ?curl http://localhost:3100/ready
# Quels labels Loki connaît-il déjà ?curl http://localhost:3100/loki/api/v1/labels
Ressources
Section intitulée « Ressources »Les références officielles à garder ouvertes, en particulier celle de LogQL pour les parseurs et les fonctions d'agrégation que cette leçon ne détaille pas, et celle d'Alloy pour ses composants de collecte :
À retenir
Section intitulée « À retenir »- Loki n'indexe que les labels, pas le contenu : stockage réduit, coût maîtrisé.
- Les labels sont partagés avec Prometheus : logs et métriques se corrèlent naturellement.
- Grafana Alloy remplace Promtail comme agent de collecte, déprécié depuis 2025.
- LogQL sélectionne des streams par labels, puis filtre et agrège le contenu.
- La cardinalité est le piège : jamais d'identifiant unique en label, données à variété dans le corps du log.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Instrumenter un service avec OpenTelemetry
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications
FAQ : questions fréquentes
Section intitulée « FAQ : questions fréquentes »Les questions qui reviennent le plus souvent portent sur la définition de Loki, le choix face à Elasticsearch, le remplaçant de Promtail et le langage LogQL : les réponses ci-dessous les reprennent une par une.
loki.source.file, loki.source.docker) et une destination loki.write vers Loki. Promtail reste utilisable mais n'évolue plus.{app="nginx"}), puis on filtre le contenu avec des opérateurs comme |= (contient) ou |~ (regex), et on peut agréger avec des fonctions comme count_over_time.