Les métriques vous disent quoi (combien de requêtes, quelle latence). Les logs vous disent pourquoi (le message d'erreur exact, la stack trace). Après avoir configuré Prometheus pour les métriques et Alertmanager pour les notifications, vous allez maintenant ajouter la gestion des logs centralisés.
Loki est souvent appelé le « Prometheus des logs ». Comme Prometheus, il indexe par labels plutôt que par contenu complet. Cela le rend léger, économique et rapide, parfait pour Kubernetes.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »À la fin de ce module, vous saurez :
- Expliquer l'architecture Loki/Promtail
- Installer Loki et Promtail sur Kubernetes
- Requêter les logs avec LogQL
- Parser les logs JSON pour extraire des champs
- Générer des métriques à partir des logs
- Créer des dashboards et alertes sur les logs
Prérequis
Section intitulée « Prérequis »-
Prometheus et Grafana fonctionnent
Fenêtre de terminal kubectl get pods -n observability -l "app.kubernetes.io/name in (prometheus,grafana)"Ce que vous devez voir : Les pods en
Running. -
L'application OpenTelemetry Demo génère du trafic
Fenêtre de terminal kubectl get pods -n otel-demo | head -5Ce que vous devez voir : Plusieurs pods en
Running. -
Le repo Helm Grafana est disponible
Fenêtre de terminal helm repo list | grep grafanaCe que vous devez voir : La ligne
grafana.Si absent :
Fenêtre de terminal helm repo add grafana https://grafana.github.io/helm-chartshelm repo update -
Vous êtes dans le répertoire du lab
Fenêtre de terminal cd ~/lab-observability
Comprendre l'architecture Loki
Section intitulée « Comprendre l'architecture Loki »Loki se distingue des moteurs de recherche classiques par ce qu'il indexe : seulement les labels, jamais le contenu des lignes. Cette décision explique à la fois sa légèreté et la façon dont il faut écrire les requêtes.
Les composants
Section intitulée « Les composants »La chaîne comporte quatre maillons, du producteur de logs jusqu'à la consultation. Retenez surtout la place de Promtail : c'est lui qui lit les fichiers de logs sur chaque node et attache les labels Kubernetes (namespace, pod, container). Si un label vous manque dans une requête, c'est la configuration de Promtail qu'il faut regarder, pas Loki.
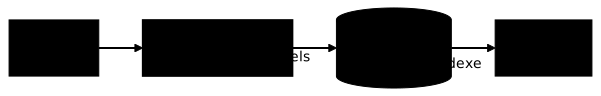
| Composant | Rôle |
|---|---|
| Pods | Écrivent leurs logs sur stdout/stderr |
| Promtail | Collecte les logs et les enrichit avec les labels Kubernetes |
| Loki | Stocke les logs, indexe par labels |
| Grafana | Interface pour chercher et visualiser |
Pourquoi Loki est différent
Section intitulée « Pourquoi Loki est différent »L'approche traditionnelle (ELK/Splunk) :
- Indexe tout le contenu de chaque log
- Recherche full-text puissante
- Stockage coûteux (chaque mot est indexé)
- Ingestion lourde
L'approche Loki :
- Indexe seulement les labels (namespace, pod, container...)
- Stockage économique (les logs bruts sont compressés)
- Recherche par labels d'abord, puis filtrage de contenu
- Ingestion légère
Tableau comparatif
Section intitulée « Tableau comparatif »| Critère | Loki | ELK/Splunk |
|---|---|---|
| Indexation | Labels seulement | Contenu complet |
| Coût stockage | ✅ Faible | ❌ Élevé |
| Recherche full-text | ⚠️ Séquentielle | ✅ Indexée |
| Intégration Grafana | ✅ Native | ⚠️ Plugin |
| Syntaxe requête | LogQL (≈ PromQL) | Propre à chaque outil |
| Complexité déploiement | ✅ Simple | ⚠️ Complexe |
Conclusion : Loki est le choix recommandé pour la majorité des cas DevOps. Réservez ELK/Splunk aux besoins de recherche full-text intensive (logs d'application avec messages très variés, analyse forensique).
Installer Loki et Promtail
Section intitulée « Installer Loki et Promtail »L'installation se fait par Helm, avec un chart qui déploie les deux composants d'un coup. Les valeurs par défaut conviennent à un lab ; les ajustements de rétention et de stockage viennent plus loin.
Comprendre loki-stack
Section intitulée « Comprendre loki-stack »Le chart loki-stack de Grafana installe Loki et Promtail ensemble. C'est la méthode la plus simple pour commencer.
Configuration des values
Section intitulée « Configuration des values »Examinez la configuration que nous allons utiliser :
cat 05-loki/helm-values/loki-stack.yamlPoints clés, extraits du fichier du dépôt :
loki:  enabled: true  persistence:    enabled: true    size: 10Gi  config:    auth_enabled: false              # un seul locataire    schema_config:      configs:        - from: 2020-10-24          store: boltdb-shipper      # index local, format historique de Loki 2          object_store: filesystem          schema: v11          index:            prefix: index_            period: 24h    limits_config:      reject_old_samples: true      reject_old_samples_max_age: 168h
promtail:  enabled: true  config:    clients:      - url: http://loki:3100/loki/api/v1/push    scrapeConfigs:      - job_name: kubernetes-pods        kubernetes_sd_configs:          - role: pod        relabel_configs:              # métadonnées Kubernetes -> labels          - source_labels: [__meta_kubernetes_namespace]            target_label: namespace          - source_labels: [__meta_kubernetes_pod_name]            target_label: pod          - source_labels: [__meta_kubernetes_container_name]            target_label: container          # (le fichier relabellise aussi les labels de pod app et component)        pipeline_stages:          - json:              expressions:                level: level                message: msg          - labels:              level:                  # seul champ promu en label
grafana:  enabled: false                      # on garde le Grafana du module 03
Chaque bloc a un rôle précis, et deux d'entre eux se lisent souvent de
travers : reject_old_samples n'est pas une rétention, et seul
level devient un label.
| Section | Effet |
|---|---|
loki.persistence | Les logs vivent sur un volume de 10 Gi, conservé au redémarrage du pod |
auth_enabled: false | Un seul locataire : aucune authentification ni identifiant de tenant à fournir |
limits_config.reject_old_samples* | Loki refuse à l'ingestion les lignes horodatées de plus de 7 jours ; rien n'est supprimé ensuite |
relabel_configs | Promtail transforme les métadonnées Kubernetes en labels namespace, pod et container |
pipeline_stages | Le champ JSON level devient un label ; msg est extrait sans en devenir un |
grafana.enabled: false | Le chart n'installe pas son propre Grafana |
Ce fichier ne configure aucune rétention : Loki conserve tout jusqu'à
remplir le volume, point traité dans la section sur la rétention. Le choix
de ne promouvoir que level en label est délibéré : un identifiant comme
trace_id créerait un stream par trace, exactement l'explosion de
cardinalité vue avec Prometheus.
Déployer
Section intitulée « Déployer »-
Installez loki-stack
Fenêtre de terminal helm upgrade --install loki grafana/loki-stack \-n observability \-f 05-loki/helm-values/loki-stack.yaml \--waitCe que vous devez voir :
Release "loki" does not exist. Installing it now.level=WARN msg="this chart is deprecated"NAME: lokiLAST DEPLOYED: [date]NAMESPACE: observabilitySTATUS: deployedPatientez 1-2 minutes que les pods démarrent.
-
Vérifiez que Loki tourne
Fenêtre de terminal kubectl get pods -n observability -l app=lokiCe que vous devez voir :
NAME READY STATUS RESTARTS AGEloki-0 1/1 Running 0 2mLe pod
loki-0est enRunning. -
Vérifiez que Promtail tourne
Fenêtre de terminal kubectl get pods -n observability -l app.kubernetes.io/name=promtailCe que vous devez voir :
NAME READY STATUS RESTARTS AGEloki-promtail-xxxxx 1/1 Running 0 2mPromtail est un DaemonSet : il y a un pod par node de votre cluster. Si vous avez 3 nodes, vous verrez 3 pods.
-
Vérifiez que Promtail collecte des logs
Fenêtre de terminal kubectl logs -n observability -l app.kubernetes.io/name=promtail --tail=10Ce que vous devez voir : Des lignes mentionnant les fichiers de logs découverts et les streams créés. Par exemple :
level=info msg="Adding target" ...level=info msg="start" ...Si vous voyez des erreurs de connexion à Loki, attendez quelques secondes et réessayez.
Ajouter Loki comme datasource Grafana
Section intitulée « Ajouter Loki comme datasource Grafana »Grafana doit savoir où trouver Loki pour pouvoir l'interroger.
-
Ouvrez Grafana
Grâce au NodePort configuré dans le module 03, Grafana est accessible directement :
Fenêtre de terminal minikube service grafana -n observability --urlOu accédez directement à http://<MINIKUBE_IP>:30030
Connectez-vous avec
admin/admin. -
Allez dans Connections → Data sources
-
Cliquez sur "Add data source"
-
Cherchez et sélectionnez "Loki"
-
Configurez la connexion
Champ Valeur Name LokiURL http://loki:3100Laissez les autres champs par défaut.
-
Cliquez sur "Save & test"
Ce que vous devez voir : Un message vert "Data source successfully connected".
Si vous utilisez le provisioning Grafana (recommandé en production), ajoutez Loki dans le fichier 03-grafana/helm-values/grafana.yaml :
# Dans le bloc datasources existant, ajoutez Lokidatasources:  datasources.yaml:    apiVersion: 1    datasources:      - name: Prometheus        type: prometheus        url: http://prometheus-server.observability.svc.cluster.local:80        access: proxy        isDefault: true        editable: false
      - name: Loki        type: loki        url: http://loki.observability.svc.cluster.local:3100        access: proxy        isDefault: false        editable: false
Puis appliquez la mise à jour :
helm upgrade grafana grafana/grafana \ -n observability \ -f 03-grafana/helm-values/grafana.yaml \ --waitExplorer les logs avec LogQL
Section intitulée « Explorer les logs avec LogQL »LogQL ressemble à PromQL mais s'applique à des lignes de log. Une requête se construit toujours en deux temps : d'abord un sélecteur de labels qui réduit le volume, ensuite un filtre sur le contenu. Inverser cet ordre est le premier réflexe à perdre.
Accéder à Explore
Section intitulée « Accéder à Explore »Explore est le mode de Grafana conçu pour l'itération : vous tapez une requête, vous voyez le résultat, vous ajustez, sans passer par la sauvegarde d'un dashboard. C'est là que vous mettez au point vos requêtes LogQL avant de les figer dans un panneau. Sélectionnez bien la datasource Loki en haut, sinon l'éditeur attend du PromQL.
-
Dans Grafana, cliquez sur l'icône boussole (Explore) dans le menu latéral
-
En haut, sélectionnez "Loki" dans le dropdown des datasources
-
Vous voyez : Un éditeur de requête et un sélecteur de plage temporelle
Votre première requête
Section intitulée « Votre première requête »Tapez cette requête dans l'éditeur :
{namespace="otel-demo"}Cliquez sur Run query (ou Shift+Enter).
Ce que vous devez voir :
- Une liste de logs avec des timestamps
- Chaque log affiche ses labels (namespace, pod, container)
- Les logs les plus récents en haut
Filtrer par labels
Section intitulée « Filtrer par labels »Les labels disponibles sont ceux que la configuration de Promtail fabrique : pas un de plus. Avec les values du lab, ce sont les métadonnées Kubernetes relabellisées et le niveau extrait du JSON :
| Label | Description | Exemple |
|---|---|---|
namespace | Le namespace Kubernetes | otel-demo |
pod | Le nom du pod | frontend-75d6c5bb89-8jdrb |
container | Le nom du conteneur | frontend |
level | Le niveau extrait des logs JSON | error |
app, component | Les labels app et component du pod, s'il les porte | frontend |
Exemples de sélecteurs :
# Logs d'un namespace spécifique{namespace="otel-demo"}
# Logs d'un pod spécifique{namespace="otel-demo", pod="otel-demo-frontend-abc123"}
# Logs de tous les pods dont le nom commence par "frontend"{namespace="otel-demo", pod=~".*frontend.*"}
# Logs de tous les namespaces sauf kube-system{namespace!="kube-system"}
Les opérateurs de sélection :
| Opérateur | Signification | Exemple |
|---|---|---|
= | Égal exactement | {namespace="otel-demo"} |
!= | Différent de | {namespace!="kube-system"} |
=~ | Correspond au regex | {pod=~".*frontend.*"} |
!~ | Ne correspond pas au regex | {pod!~".*test.*"} |
Filtrer par contenu
Section intitulée « Filtrer par contenu »Après avoir sélectionné les streams, vous pouvez filtrer les lignes par leur contenu :
{namespace="otel-demo"} |= "error"Cette requête retourne les logs du namespace otel-demo qui contiennent le mot "error".
Les opérateurs de filtre de ligne :
| Opérateur | Signification | Exemple |
|---|---|---|
|= | Contient | {container="frontend"} |= "error" |
!= | Ne contient pas | {container="frontend"} != "health" |
|~ | Correspond au regex | {container="frontend"} |~ "status=(4|5)[0-9]{2}" |
!~ | Ne correspond pas au regex | {container="frontend"} !~ "DEBUG" |
Exemples pratiques :
# Logs contenant "error" (case-insensitive avec regex){namespace="otel-demo"} |~ "(?i)error"
# Logs contenant "error" mais pas "healthcheck"{namespace="otel-demo"} |= "error" != "healthcheck"
# Logs avec un code HTTP 4xx ou 5xx{namespace="otel-demo"} |~ "HTTP/(4|5)[0-9]{2}"
# Logs contenant une trace_id (pour la corrélation){namespace="otel-demo"} |~ "trace_id"
Parser les logs JSON
Section intitulée « Parser les logs JSON »La plupart des applications modernes génèrent des logs en JSON. LogQL peut les parser.
Exemple de log JSON :
{"level":"error","msg":"Failed to process order","order_id":"12345","trace_id":"abc123"}Parser avec | json :
{namespace="otel-demo"} | jsonAprès | json, les champs JSON deviennent des labels que vous pouvez utiliser :
# Filtrer par niveau d'erreur{namespace="otel-demo"} | json | level="error"
# Filtrer par code HTTP{namespace="otel-demo"} | json | status_code >= 400
# Combiner plusieurs filtres{namespace="otel-demo"} | json | level="error" | service_name="checkout"Formater la sortie
Section intitulée « Formater la sortie »Vous pouvez modifier l'affichage des logs :
# Afficher seulement certains champs{namespace="otel-demo"} | json | line_format "{{.level}} - {{.msg}}"
# Format plus lisible{namespace="otel-demo"} | json | line_format "[{{.level}}] {{.service_name}}: {{.msg}}"
Exercice 1 : Explorer les logs de l'application démo
Section intitulée « Exercice 1 : Explorer les logs de l'application démo »-
Listez tous les logs du namespace otel-demo
{namespace="otel-demo"}Observation : Beaucoup de logs ! Réduisez la plage temporelle à 15 minutes.
-
Filtrez sur les erreurs
{namespace="otel-demo"} |= "error"Combien de logs d'erreur voyez-vous ?
-
Parsez le JSON et filtrez par niveau
{namespace="otel-demo"} | json | level="error"Question : Y a-t-il une différence avec la requête précédente ?
(Oui, la précédente cherche le texte "error" n'importe où ; celle-ci cherche le champ JSON
levelégal à "error") -
Identifiez les pods les plus bavards
{namespace="otel-demo"} | jsonRegardez le panneau latéral (si disponible) pour voir la distribution par pod.
-
Cherchez les logs avec un trace_id
{namespace="otel-demo"} | json | trace_id != ""Le
trace_idest la clé qui relie une ligne de log à la trace de la même requête. Cette corrélation logs-traces sort du périmètre de la formation, mais ce filtre suffit à repérer les services qui la rendent possible.
LogQL : générer des métriques
Section intitulée « LogQL : générer des métriques »LogQL peut compter et mesurer les logs, transformant des logs en métriques.
Compter les logs
Section intitulée « Compter les logs »Logs par seconde :
rate({namespace="otel-demo"}[5m])Cette requête retourne le taux de logs par seconde sur les 5 dernières minutes, groupé par stream.
Logs par seconde, agrégés par pod :
sum by (pod) (rate({namespace="otel-demo"}[5m]))Logs par seconde, agrégés par niveau :
sum by (level) (rate({namespace="otel-demo"} | json [5m]))Total sur une période
Section intitulée « Total sur une période »Là où rate donne une vitesse, count_over_time renvoie un volume absolu
sur la fenêtre indiquée. C'est la fonction à utiliser pour répondre à « combien
d'erreurs cette nuit », pas pour alerter.
# Nombre total de logs d'erreur sur la dernière heurecount_over_time({namespace="otel-demo"} |= "error" [1h])
# Par podsum by (pod) (count_over_time({namespace="otel-demo"} |= "error" [1h]))
Pourcentage d'erreurs
Section intitulée « Pourcentage d'erreurs »Un nombre d'erreurs seul ne dit rien sans son volume de référence : cent erreurs
sur un million de requêtes n'ont pas le même sens que cent sur mille. Le ratio
se calcule en divisant deux rate calculés sur la même fenêtre.
# Ratio erreurs / total logs par service( sum by (service_name) ( rate({namespace="otel-demo"} | json | level="error" [5m]) ))/( sum by (service_name) ( rate({namespace="otel-demo"} | json [5m]) ))Exercice 2 : Métriques sur les logs
Section intitulée « Exercice 2 : Métriques sur les logs »-
Comptez les logs par seconde de chaque pod
sum by (pod) (rate({namespace="otel-demo"}[5m]))Ce que vous devez voir : Un graphique avec une ligne par pod.
-
Identifiez le top 5 des pods les plus bavards
topk(5, sum by (pod) (rate({namespace="otel-demo"}[5m]))) -
Comptez les erreurs par niveau de log
sum by (level) (rate({namespace="otel-demo"} | json [5m])) -
Alertez si plus de 10 erreurs par minute
D'abord, vérifiez le taux d'erreurs :
sum(rate({namespace="otel-demo"} | json | level="error" [1m])) * 60Cette valeur (erreurs par minute) peut être utilisée pour une alerte Grafana.
Configuration avancée de Promtail
Section intitulée « Configuration avancée de Promtail »Promtail fait plus que collecter les logs. Il peut les transformer.
Pipeline stages
Section intitulée « Pipeline stages »Les "stages" sont des étapes de traitement appliquées à chaque log :
pipeline_stages:  # 1. Parser le format CRI (Container Runtime Interface)  - cri: {}
  # 2. Parser le JSON  - json:      expressions:        level: level        message: msg        trace_id: trace_id   # extrait, utilisable en filtre, jamais en label
  # 3. Ajouter des labels (faible cardinalité uniquement)  - labels:      level:
  # 4. Filtrer (drop) les logs inutiles  - match:      selector: '{container="frontend"}'      stages:        - drop:            expression: "healthcheck"
  # 5. Modifier le contenu  - replace:      expression: "password=.*"      replace: "password=***"
Explication de chaque stage :
| Stage | Rôle | Exemple |
|---|---|---|
cri | Parse le format des logs Kubernetes (CRI) | Extrait le timestamp |
json | Parse le contenu JSON | Extrait level, msg, etc. |
labels | Ajoute des labels à partir des champs extraits | level devient un label filtrable |
drop | Supprime les logs correspondants | Ignore les healthchecks |
replace | Modifie le contenu | Masque les mots de passe |
Multiline (logs sur plusieurs lignes)
Section intitulée « Multiline (logs sur plusieurs lignes) »Les stack traces Java ou Python s'étendent sur plusieurs lignes :
2024-01-15 10:30:45 ERROR Something went wrongjava.lang.NullPointerException at com.example.MyClass.method(MyClass.java:42) at com.example.Main.main(Main.java:10)Configuration pour les regrouper :
pipeline_stages: - multiline: firstline: '^\d{4}-\d{2}-\d{2}' # Nouvelle entrée = commence par une date max_wait_time: 3sCréer un dashboard de logs
Section intitulée « Créer un dashboard de logs »Les requêtes mises au point dans Explore se figent ensuite dans un dashboard, ce qui évite de les réécrire à chaque incident. Deux types de panneaux suffisent : le flux de logs brut et la courbe de volume.
Panel avec visualisation logs
Section intitulée « Panel avec visualisation logs »Ce premier panneau affiche le flux de logs brut, celui que vous lisez pendant un incident pour voir les messages exacts. La visualisation Logs de Grafana conserve l'horodatage et les labels ; activez Wrap lines pour ne pas tronquer les longues lignes JSON.
-
Créez un nouveau dashboard ou ouvrez un existant
-
Add panel → Visualization: Logs
-
Configurez la requête
- Data source : Loki
- Query :
{namespace="otel-demo"} | json
-
Dans Panel options
Option Valeur recommandée Time Show Unique labels Show Common labels Hide Wrap lines On -
Sauvegardez le panel
Panel avec métrique sur logs
Section intitulée « Panel avec métrique sur logs »Ici on ne lit plus les lignes, on les compte. La visualisation Time series trace une courbe de volume par niveau de log, ce qui rend visible une montée d'erreurs bien avant de plonger dans les messages. La requête réutilise rate() et | json vus plus haut.
-
Add panel → Visualization: Time series
-
Configurez la requête
sum by (level) (rate({namespace="otel-demo"} | json [5m])) -
Dans Panel options
- Title : "Log rate par niveau"
- Legend : Table, valeurs
-
Sauvegardez
Panel "erreurs par service"
Section intitulée « Panel "erreurs par service" »Ce dernier panneau répond à une question de priorisation : quel service génère le plus d'erreurs sur la dernière heure. La visualisation Bar gauge avec des seuils colorés (vert, jaune, rouge) transforme le classement en signal visuel immédiat pour l'astreinte.
-
Add panel → Visualization: Bar gauge
-
Configurez la requête
sum by (service_name) (count_over_time({namespace="otel-demo"} | json | level="error" [1h])) -
Dans Panel options
- Title : "Erreurs par service (dernière heure)"
- Thresholds : 0=vert, 10=jaune, 50=rouge
-
Sauvegardez
Alerter sur les logs
Section intitulée « Alerter sur les logs »Grafana peut créer des alertes basées sur des requêtes Loki.
-
Allez dans Alerting → Alert rules
-
Cliquez sur "New alert rule"
-
Configurez la requête
-
Data source : Loki
-
Query :
sum(count_over_time({namespace="otel-demo"} | json | level="error" [5m]))
-
-
Configurez la condition
- Expression :
count > 10 - For : 5 minutes
- Expression :
-
Configurez les labels et annotations
Summary: Plus de 10 erreurs en 5 minutes dans otel-demo -
Sauvegardez
Rétention et estimation du stockage
Section intitulée « Rétention et estimation du stockage »C'est le réglage qui décide de la facture. Loki ne purge rien par défaut dans une installation de lab : sans politique explicite, le volume croît jusqu'à saturer le disque.
Calculer l'espace nécessaire
Section intitulée « Calculer l'espace nécessaire »Loki compresse bien les logs (ratio ~10:1 typique).
Formule d'estimation :
Espace = (logs_bruts_par_jour_GB / 10) × jours_rétentionExemple :
- 50 GB de logs bruts par jour
- Rétention 7 jours
- Espace nécessaire ≈ (50 / 10) × 7 = 35 GB
Configuration de la rétention
Section intitulée « Configuration de la rétention »Les values du lab ne posent aucune rétention, et c'est voulu pour un
environnement jetable. Ne confondez pas reject_old_samples_max_age, qui
refuse à l'ingestion des lignes trop anciennes, avec une durée de
conservation : il ne supprime rien.
En production, la documentation de Loki
confie la rétention au Compactor : on active retention_enabled dans son
bloc compactor et l'on fixe la durée par retention_period dans
limits_config. Dimensionnez le volume avec la formule ci-dessus avant
d'activer la purge, pas après la première saturation.
Dépannage
Section intitulée « Dépannage »Les pannes de Loki se ressemblent : Grafana répond, mais aucune ligne n'apparaît. La cause se situe presque toujours en amont, du côté de la collecte ou des labels, plutôt que dans la requête elle-même.
Les logs n'apparaissent pas dans Grafana
Section intitulée « Les logs n'apparaissent pas dans Grafana »Le tableau ci-dessous se lit de haut en bas comme un arbre de décision : chaque étape isole un maillon de la chaîne de collecte. Ne sautez pas d'étape, car un pod Running ne garantit pas que Promtail pousse effectivement vers Loki. La première ligne qui échoue désigne le composant à corriger.
| Étape | Commande/Action | Ce que vous cherchez |
|---|---|---|
| 1. Promtail tourne ? | kubectl get pods -n observability -l app.kubernetes.io/name=promtail | Pods Running |
| 2. Loki tourne ? | kubectl get pods -n observability -l app=loki | Pod Running |
| 3. Logs Promtail | kubectl logs -n observability -l app.kubernetes.io/name=promtail --tail=50 | Pas d'erreurs de connexion |
| 4. Les pods cibles ont des logs ? | kubectl logs -n otel-demo <pod> --tail=5 | Des logs s'affichent |
| 5. Datasource Loki OK ? | Grafana → Connections → Data sources → Loki → Save & test | "Successfully connected" |
Erreur "too many outstanding requests"
Section intitulée « Erreur "too many outstanding requests" »Loki est surchargé.
| Cause | Solution |
|---|---|
| Trop de requêtes simultanées | Réduisez les dashboards actifs |
| Requêtes trop larges | Ajoutez des filtres de labels |
| Ressources insuffisantes | Augmentez memory/CPU de Loki |
Requête lente
Section intitulée « Requête lente »Une requête LogQL lente vient presque toujours d'un scan trop large : Loki lit les logs bruts de tous les streams sélectionnés avant de filtrer. La parade tient en un principe, filtrer par labels d'abord pour réduire le volume, puis seulement par contenu et par | json.
| Cause | Solution |
|---|---|
| Plage temporelle trop large | Réduisez à 1h ou moins |
| Pas de filtre de labels | Ajoutez {namespace="..."} au minimum |
| Trop de parsing JSON | Filtrez par texte d'abord (|= "error"), puis | json |
Logs tronqués
Section intitulée « Logs tronqués »Un log coupé net ou une stack trace éclatée en dizaines d'entrées séparées signalent deux réglages distincts de Promtail : une ligne trop longue rejetée par une limite de taille, ou des lignes multiples qu'aucune stage multiline ne regroupe. Le symptôme visuel diffère, la correction se fait dans les deux cas côté collecteur.
| Cause | Solution |
|---|---|
| Limite de taille de ligne | Augmentez max_line_size dans Promtail |
| Logs multilignes non groupés | Ajoutez une stage multiline |
Validation finale
Section intitulée « Validation finale »-
Loki et Promtail sont déployés
Fenêtre de terminal kubectl get pods -n observability -l "app in (loki)" && \kubectl get pods -n observability -l app.kubernetes.io/name=promtailLes pods sont en
Running. -
La datasource Loki fonctionne
Dans Grafana → Connections → Data sources → Loki : "Successfully connected"
-
Les logs sont collectés
Dans Grafana → Explore → Loki :
{namespace="otel-demo"}Des logs s'affichent.
-
Le parsing JSON fonctionne
{namespace="otel-demo"} | json | level="error"Des logs filtrés s'affichent.
-
Vous savez générer des métriques
sum by (pod) (rate({namespace="otel-demo"}[5m]))Un graphique s'affiche.
À retenir
Section intitulée « À retenir »Ce module a ajouté le deuxième pilier de l'observabilité, les logs centralisés, à côté des métriques. Voici les points à retenir.
- Loki indexe les labels, pas le contenu, ce qui le rend léger et économique
- Promtail collecte les logs des pods et les enrichit avec les labels Kubernetes
- LogQL ressemble à PromQL : sélecteurs de stream
{}+ filtres|= |~+ transformations| json - Parser JSON permet de filtrer sur les champs :
| json | level="error" - Les fonctions
rate()etcount_over_time()transforment les logs en métriques - Grafana Alerting peut créer des alertes basées sur des requêtes Loki
- Un label se choisit à faible cardinalité :
leveloui,trace_idjamais ; etreject_old_samplesn'est pas une rétention
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Loki hors Kubernetes, avec Alloy
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications