L'instrumentation est la première étape du pipeline d'observabilité : c'est le code qui génère les signaux, métriques, logs, traces, au sein même de vos applications. Un backend ne peut afficher que ce que l'instrumentation a émis : une trace sans service.name reste anonyme quel que soit le tableau de bord placé derrière.
Mais "instrumenter" n'est pas un seul outil. C'est un empilement de couches qui vont de votre code jusqu'au backend (l'outil qui stocke et affiche les signaux). Cette page vous explique comment ces briques s'assemblent.
Deux termes reviennent partout. Un span est une opération chronométrée (un appel HTTP, une requête SQL) ; une trace est l'ensemble des spans d'une même requête, de service en service.
Les couches de l'instrumentation
Section intitulée « Les couches de l'instrumentation »Vue d'ensemble
Section intitulée « Vue d'ensemble »Lisez le schéma de haut en bas, dans le sens de circulation des signaux. Chaque couche a un point de configuration distinct, et c'est ce qui compte pour vous : un problème de nommage de service se règle dans le SDK, un problème de volume dans le sampling, un problème de données sensibles dans le Collector. Savoir à quelle couche appartient un symptôme évite de modifier le code applicatif pour un réglage qui vit ailleurs.
Plus vous descendez dans le pipeline, plus la configuration est centralisée et donc facile à gouverner, mais plus vous perdez le contexte métier : le Collector voit passer des spans, il ne sait pas qu'il s'agit d'un abandon de panier.
1. API / Facade : l'interface que le code appelle
Section intitulée « 1. API / Facade : l'interface que le code appelle »L'API fournit une interface stable dans le code : tracer, meter, logger. Votre code appelle ces primitives sans savoir quel backend stockera les données.
| Outil | Ce qu'il fait |
|---|---|
| OpenTelemetry API | Interface standard pour traces, métriques, logs (multi-langage) |
| Micrometer (Java) | Facade "metrics-first" très utilisée dans l'écosystème Spring |
Dans le code, ça ressemble à :
# Créer un span (trace)with tracer.start_as_current_span("checkout.process") as span: span.set_attribute("cart.items", 3) # ... logique métier// Incrémenter un compteur (métrique)counter.add(1, Attributes.of(stringKey("status"), "success"));2. SDK : l'implémentation qui collecte et exporte
Section intitulée « 2. SDK : l'implémentation qui collecte et exporte »Le SDK transforme ce que produit l'API en télémétrie exploitable :
| Responsabilité | Ce que ça fait |
|---|---|
| Buffering / Batch | Regroupe les signaux avant export (économise le réseau) |
| Retry | Ré-essaie en cas d'échec réseau |
| Sampling en tête | Décide, dès la création de la trace, laquelle garder (ratio, parent-based...) ; le tail sampling relève du Collector |
| Propagation | Injecte/extrait le contexte (trace-id) entre services |
| Export | Envoie les signaux vers OTLP (ou autre format) |
C'est dans le SDK que vous configurez :
# Identité du serviceOTEL_SERVICE_NAME=checkout-apiOTEL_RESOURCE_ATTRIBUTES=service.version=1.2.3,deployment.environment=production
# Export OTLP vers le CollectorOTEL_EXPORTER_OTLP_ENDPOINT=http://otel-collector:4317OTEL_EXPORTER_OTLP_PROTOCOL=grpc
# Sampling (10% des traces)OTEL_TRACES_SAMPLER=parentbased_traceidratioOTEL_TRACES_SAMPLER_ARG=0.1
Le sampling (échantillonnage) ne conserve qu'une partie des traces pour limiter le coût. parentbased_traceidratio garde ici 10 % des traces, et respecte la décision déjà prise par le service appelant. Comme cette décision est prise à la création de la trace, avant d'en connaître l'issue, le SDK ne peut pas viser les traces en erreur : le tail sampling du Collector s'en charge, et les fondamentaux des traces comparent les deux approches.
3. Auto-instrumentation : le "zéro code"
Section intitulée « 3. Auto-instrumentation : le "zéro code" »L'auto-instrumentation intercepte automatiquement les appels aux frameworks et librairies (HTTP, DB, messaging) sans modifier votre code.
| Langage | Comment ça marche |
|---|---|
| Java | Agent JVM : -javaagent:opentelemetry-javaagent.jar |
| Python | Wrapper : opentelemetry-instrument python app.py |
| Node.js | Require : --require @opentelemetry/auto-instrumentations-node/register |
| .NET | Runtime hooks (variable CORECLR_ENABLE_PROFILING) |
| Go | Pas d'agent comme en Java : instrumentation eBPF (OBI, OpenTelemetry eBPF Instrumentation) ou bibliothèques d'instrumentation (otelhttp...) ajoutées au code |
| PHP | Extension PHP : opentelemetry.so |
Quand l'utiliser ?
- Pour couvrir rapidement l'essentiel des spans techniques (HTTP entrant/sortant, SQL, Redis, Kafka...)
- Sur du legacy où vous ne voulez pas toucher le code
- En complément de spans manuels pour la logique métier
4. Exporters : comment les signaux sortent de l'application
Section intitulée « 4. Exporters : comment les signaux sortent de l'application »L'exporter envoie les signaux vers une destination. En 2026, le standard est :
App (SDK) → OTLP → CollectorPourquoi OTLP vers un Collector (et pas directement vers le backend) ?
| Avantage | Explication |
|---|---|
| Découplage | Votre app ne "connaît" qu'un endpoint OTLP |
| Flexibilité | Changez de backend (Jaeger → Tempo) sans recoder |
| Gouvernance | Filtrage, redaction, routing centralisés |
| Résilience | Le Collector bufferise si le backend est down |
5. Collector : la gouvernance hors du code
Section intitulée « 5. Collector : la gouvernance hors du code »Le Collector est le routeur central de votre télémétrie. Il reçoit les signaux OTLP et les transforme/route vers vos backends.
Ce qu'il fait :
| Fonction | Exemple |
|---|---|
| Normaliser | Convertir différents formats en un seul |
| Enrichir | Ajouter metadata Kubernetes (namespace, pod, node) |
| Filtrer | Exclure les healthchecks, les routes internes |
| Redacter | Masquer les tokens, emails, données sensibles |
| Router | Traces → Tempo, Métriques → Mimir, Logs → Loki |
| Bufferiser | Queue + retry si backend indisponible |
Synthèse : qui fait quoi ?
Section intitulée « Synthèse : qui fait quoi ? »La colonne « Où ça vit » est celle à retenir, parce qu'elle dit qui doit intervenir quand un réglage change. Modifier l'API ou les spans manuels implique un développeur et un redéploiement. Modifier le SDK se fait par variables d'environnement, donc au niveau du déploiement. Modifier le Collector ne touche aucune application. Cette progression est exactement ce qui rend l'architecture avec Collector plus soutenable dans la durée.
| Couche | Exemple | Où ça vit | À quoi ça sert |
|---|---|---|---|
| API / Facade | OTel API, Micrometer | Dans le code | Interface stable, appels de l'app |
| SDK | OTel SDK Java/Python/Node | Dans le runtime | Collecte, batching, sampling, export |
| Auto-instrumentation | Java Agent, Python distro | Autour de l'app | Spans/metrics automatiques sans toucher le code |
| Exporter | OTLP exporter | Dans l'app | Sortie des signaux |
| Collector | OTel Collector | Infra | Gouvernance, routing, résilience |
3 architectures types
Section intitulée « 3 architectures types »Chaque environnement a ses contraintes. Voici les trois patterns les plus courants, vus depuis l'application. Le détail du déploiement côté Collector (gateway, agent, sidecar, haute disponibilité) est dans la page Collecte & pipeline.
1. Démarrage rapide (POC, service isolé)
Section intitulée « 1. Démarrage rapide (POC, service isolé) »L'application exporte directement vers le backend, sans intermédiaire. C'est la configuration la plus courte à écrire, et la seule dette qu'elle crée est l'adresse du backend inscrite dans la configuration de chaque service. Sur un seul service, ce n'est rien. Sur quinze, chaque changement de backend devient une campagne de redéploiement.
- Avantage : simple, rapide à mettre en place
- Limite : couplé au backend, difficile à faire évoluer
- Limite : pas de gouvernance centralisée
Quand l'utiliser : POC, application standalone, environnement de développement.
2. Standard moderne (recommandé)
Section intitulée « 2. Standard moderne (recommandé) »Toutes les applications exportent vers un Collector central qui route vers les backends. La configuration applicative se réduit alors à une seule adresse OTLP, identique pour tous les services, et tout ce qui relève du filtrage, du masquage ou du routage sort du code.
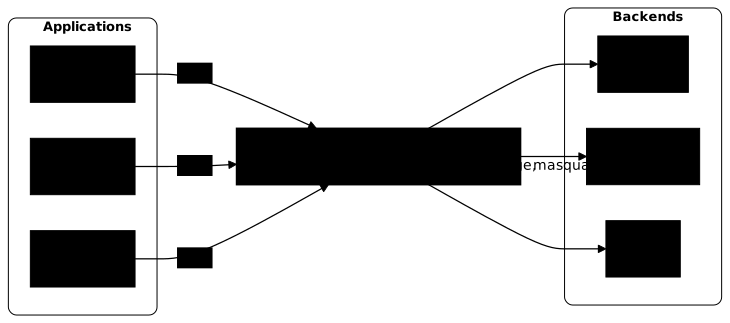
- Avantage : découplage entre les applications et les backends
- Avantage : gouvernance centralisée (filtrage, masquage, sampling)
- Avantage : plusieurs backends sans modifier le code applicatif
Quand l'utiliser : dès que vous avez plusieurs services en production.
3. Kubernetes à l'échelle (agent + gateway)
Section intitulée « 3. Kubernetes à l'échelle (agent + gateway) »Chaque nœud Kubernetes a un agent (un DaemonSet, c'est-à-dire un pod par nœud) qui collecte localement, puis envoie à une gateway centrale. Ce dédoublement répond à deux besoins que le Collector unique ne couvre pas : l'agent est le mieux placé pour lire les métadonnées du nœud et les journaux des conteneurs qui y tournent, et il absorbe les pics locaux sans saturer le réseau entre nœuds.
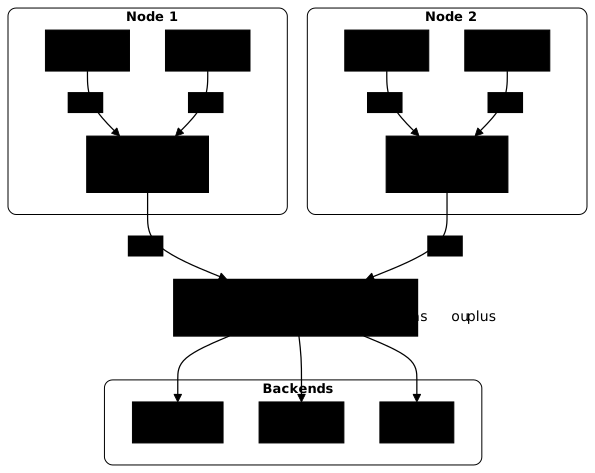
- Avantage : collecte locale, donc faible latence réseau
- Avantage : enrichissement Kubernetes (namespace, pod, node)
- Avantage : routage centralisé et haute disponibilité par réplication de la gateway
Quand l'utiliser : clusters Kubernetes de production, multi-tenants, équipes plateforme.
Aide à la décision
Section intitulée « Aide à la décision »Ce tableau se lit par le besoin, pas par l'outil. Deux lignes se combinent presque toujours en production : l'auto-instrumentation couvre les appels techniques, les spans manuels ajoutent le contexte métier que rien d'automatique ne peut deviner. Choisir l'une contre l'autre est une erreur fréquente ; elles ne répondent pas à la même question.
| Vous voulez... | Solution |
|---|---|
| Zéro code | Auto-instrumentation + OTLP → Collector |
| Du contexte métier | Spans manuels via API + SDK |
| Découpler du backend | OTLP exporter vers Collector |
| Standardiser cross-langage | OpenTelemetry partout |
| Juste des métriques JVM | Micrometer (mais OTel reste compatible) |
| Migrer du legacy | OTel Shim pour OpenTracing/OpenCensus |
Minimum Viable Instrumentation
Section intitulée « Minimum Viable Instrumentation »Avant de tout tracer, instrumentez l'essentiel :
Checklist
Section intitulée « Checklist »Les six étapes sont ordonnées par dépendance, pas par importance. Les deux premières conditionnent tout le reste : sans identité de service, vos traces arrivent anonymes dans le backend, et sans propagation W3C, chaque service crée sa propre trace au lieu de continuer celle de l'appelant, ce qui donne des traces coupées en morceaux que rien ne relie.
| Étape | Ce qu'il faut faire |
|---|---|
| 1. Identité | OTEL_SERVICE_NAME, service.version, deployment.environment |
| 2. Propagation | W3C Trace Context (traceparent) activé |
| 3. Spans métier | 3-5 opérations clés (checkout, paiement, génération PDF) |
| 4. Métriques RED | Rate (requêtes par seconde), Errors, Duration (percentiles p50/p95/p99) |
| 5. Redaction | Masquer tokens, emails, données personnelles (PII) avant export |
| 6. Sampling | Ratio de départ indicatif (10 à 20 %), à affiner ensuite |
Configuration minimale
Section intitulée « Configuration minimale »Ces variables sont standardisées par la spécification OpenTelemetry : elles
portent le même nom quel que soit le langage, ce qui permet de les injecter
uniformément depuis un manifeste Kubernetes ou un fichier docker compose. Le
port 4317 correspond au transport gRPC ; passez à 4318 si vous exportez
en HTTP.
La configuration minimale est celle du bloc de variables de la section SDK plus
haut : l'identité du service (OTEL_SERVICE_NAME,
OTEL_RESOURCE_ATTRIBUTES), l'export OTLP vers le Collector
(OTEL_EXPORTER_OTLP_ENDPOINT) et le sampling (OTEL_TRACES_SAMPLER et
OTEL_TRACES_SAMPLER_ARG), à ajuster selon le volume de traces. Les spans
métier, les métriques RED et la redaction, eux, demandent du code ou une
configuration du Collector.
Les erreurs à éviter
Section intitulée « Les erreurs à éviter »La première ligne du tableau est celle qui coûte le plus cher en facture. Mettre un identifiant unique (identifiant de commande, adresse e-mail, identifiant de session) dans un label de métrique crée une série temporelle distincte par valeur : quelques milliers de commandes suffisent à faire exploser la cardinalité et à saturer le backend. Les identifiants ont leur place dans les attributs de span, pas dans les métriques.
| Anti-pattern | Conséquence | Solution |
|---|---|---|
| IDs uniques en tags/labels | Explosion cardinalité, coûts | Utiliser des catégories (status, region) |
| Tout tracer sans sampling | Overhead perf, coûts stockage | Un ratio de départ (10 à 20 %, repère indicatif) puis tail sampling dans le Collector |
| Spans trop verbeux | Bruit, difficile à exploiter | 5-10 attributs max par span |
| Pas de validation locale | Bugs découverts en prod | Exporter vers console/debug en dev |
Ignorer service.name | Traces anonymes, inutilisables | Toujours définir l'identité |
| Exporter direct vers backend | Couplage, pas de gouvernance | Passer par le Collector |
Quel guide pour quel outil d'instrumentation ?
Section intitulée « Quel guide pour quel outil d'instrumentation ? »Cette page décrit l'assemblage des couches et ne se pratique pas : le geste se joue dans les guides d'outil. Chaque famille d'outil renvoie vers le sien.
Standards et SDK
Section intitulée « Standards et SDK »OpenTelemetry est le seul projet à couvrir les trois signaux (traces, métriques, logs) avec une API commune et des conventions de nommage partagées. C'est par le guide OpenTelemetry qu'il faut commencer : les autres pages de cette section supposent son vocabulaire acquis. Si le modèle de données (signal, contexte, propagation) n'est pas encore clair, les fondamentaux OpenTelemetry l'expliquent sans outil, et la corrélation des signaux montre comment relier logs, métriques et traces.
Auto-instrumentation
Section intitulée « Auto-instrumentation »Chaque langage a son mécanisme d'injection, résumé dans le tableau plus haut : agent JVM pour Java, exécutable d'enrobage pour Python, chargement de module au démarrage pour Node.js. Le guide OpenTelemetry cité ci-dessus couvre les concepts communs à tous les langages, dont l'agent Java et le wrapper Python.
Facades et alternatives
Section intitulée « Facades et alternatives »Micrometer précède OpenTelemetry dans l'écosystème Spring et reste très présent sur les applications Java existantes. Il est avant tout une facade de métriques (le traçage relève de Micrometer Tracing, un module à part), et il sait exporter les métriques en OTLP, ce qui permet de le conserver côté code tout en unifiant la sortie avec le reste de votre télémétrie. Le guide Micrometer l'installe sur une application Spring Boot.
Et après l'application ?
Section intitulée « Et après l'application ? »Quand l'instrumentation fonctionne et que vous voulez filtrer, enrichir et router ce qu'elle produit, le relais est pris par le Collector OpenTelemetry. Les références externes à garder sous la main sont la liste des langages et SDK OpenTelemetry, la configuration du SDK par variables d'environnement, la documentation du Collector et la documentation de Micrometer.
À retenir
Section intitulée « À retenir »- L'export direct convient à un POC, le Collector central dès plusieurs services en production, agent + gateway sur Kubernetes à l'échelle
- Les applications ne connaissent qu'un endpoint OTLP : filtrage, masquage et routage vivent dans le Collector
- Auto-instrumentation et spans manuels se combinent : l'une couvre les tuyaux, l'autre le contexte métier
- Commencez par l'identité du service et la propagation W3C, puis les spans métier, les métriques RED et le sampling
- Pas d'identifiant unique dans un label de métrique : il va dans les attributs de span
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Instrumenter une application JVM avec Micrometer
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications