Le 1er août 2012, la société de courtage américaine Knight Capital a perdu plus de 460 millions de dollars en 45 minutes. Selon la SEC, le gendarme boursier américain, un déploiement incorrect de code dans son routeur d'ordres avait réveillé une fonction devenue défectueuse : plus de 4 millions d'ordres envoyés pour servir 212 commandes clients.
Ce qui distingue une équipe résiliente d'une autre, c'est sa capacité à apprendre de chaque incident. Cette page s'adresse aux exploitants et aux devops qui doivent rédiger ou animer un postmortem blameless : elle montre comment le structurer, comment remonter à la cause profonde et comment transformer l'analyse en actions réellement suivies.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Distinguer un postmortem d'un simple compte-rendu d'incident, et savoir quand chacun s'impose
- Conduire une analyse blameless qui cherche les causes systémiques au lieu d'un coupable
- Appliquer la méthode des 5 pourquoi pour remonter du symptôme à la cause racine
- Structurer un document de postmortem actionnable et animer la réunion associée
- Éviter les anti-patterns qui vident l'exercice de sa valeur, de la chasse aux sorcières aux actions sans suite
Qu'est-ce qu'un postmortem blameless ?
Section intitulée « Qu'est-ce qu'un postmortem blameless ? »Un postmortem (littéralement « après la mort ») est une analyse structurée réalisée après un incident. Son objectif : comprendre ce qui s'est passé, pourquoi c'est arrivé, et quelles actions correctives empêcheront que ça se reproduise.
L'adjectif blameless (« sans blâme ») est fondamental : l'analyse se concentre sur les causes systémiques, pas sur la recherche d'un coupable. Cette approche, popularisée par le livre Site Reliability Engineering de Google (le « SRE Book »), part d'un principe simple : les personnes impliquées ont agi rationnellement avec les informations qu'elles avaient à ce moment-là.
Cette page détaille le document et la réunion de postmortem. La gestion de l'incident lui-même, rôles, communication et clôture, est traitée dans la leçon Incidents et postmortems, que celle-ci prolonge sans la répéter.
Postmortem ou compte-rendu d'incident : quelle différence ?
Section intitulée « Postmortem ou compte-rendu d'incident : quelle différence ? »Le compte-rendu d'incident trace les faits pendant ou juste après la crise, tandis que le postmortem analyse les causes à froid pour prévenir la récidive. Les deux documents se complètent, et le tableau ci-dessous les compare critère par critère :
| Aspect | Compte-rendu d'incident | Postmortem |
|---|---|---|
| Moment | Pendant ou juste après l'incident | Quelques jours après, avec du recul |
| Objectif | Tracer les faits et la résolution | Analyser les causes et prévenir |
| Contenu | Chronologie, actions, résolution | Causes profondes, actions correctives |
| Durée de vie | Archive de référence | Document vivant avec suivi |
| Audience | Équipe technique, support | Toute l'organisation concernée |
| Ton | Factuel, technique | Analytique, pédagogique |
Le compte-rendu répond à « que s'est-il passé ? ». Le postmortem répond à « pourquoi c'est arrivé et comment éviter que ça se reproduise ? ». Le premier est une archive, le second un document de travail.
Quels sont les trois types de postmortem ?
Section intitulée « Quels sont les trois types de postmortem ? »Selon la nature des causes, un postmortem est technique, organisationnel ou hybride. Choisir l'angle dès le départ évite de passer la réunion sur les serveurs quand le vrai problème était une escalade qui n'a pas eu lieu.
Focus : les systèmes et leur comportement.
Ce postmortem analyse les défaillances matérielles, logicielles ou d'infrastructure. Il répond aux questions :
- Quel composant a défailli en premier ?
- Comment la panne s'est-elle propagée ?
- Pourquoi les mécanismes de protection n'ont pas fonctionné ?
Exemple : un serveur de base de données qui sature sa mémoire provoque un effet cascade sur les applications clientes. Le postmortem technique analyse la configuration mémoire, les requêtes problématiques, et l'absence d'alerting sur ce seuil.
Quand l'utiliser : pannes d'infrastructure, bugs applicatifs, problèmes de performance.
Focus : les processus et la communication.
Ce postmortem analyse les facteurs humains et organisationnels. Il répond aux questions :
- L'information a-t-elle circulé correctement ?
- Les bonnes personnes étaient-elles disponibles ?
- Les procédures existantes ont-elles été suivies ?
Exemple : un incident de sécurité détecté par l'équipe réseau n'est pas remonté à l'équipe sécurité pendant 48 heures faute de canal de communication défini. Le postmortem organisationnel analyse les circuits d'escalade et les responsabilités.
Quand l'utiliser : incidents impliquant plusieurs équipes, problèmes de coordination, échecs de communication.
Focus : la combinaison technique et organisationnelle.
La plupart des incidents majeurs ont des causes multiples. Un postmortem hybride analyse les deux dimensions en parallèle pour obtenir une vision complète.
Exemple : une mise en production échoue (cause technique : script de migration défectueux) et personne n'est disponible pour un rollback pendant 2 heures (cause organisationnelle : astreinte mal définie). Les deux aspects doivent être traités.
Quand l'utiliser : incidents majeurs, pannes ayant un impact métier significatif, incidents récurrents.
Pourquoi « blameless » change tout
Section intitulée « Pourquoi « blameless » change tout »Une analyse qui cherche un coupable produit du silence, alors qu'une analyse blameless produit de l'information. C'est la raison pour laquelle la recherche de responsable est le premier anti-pattern à neutraliser.
Le réflexe naturel : trouver un coupable
Section intitulée « Le réflexe naturel : trouver un coupable »Face à un incident, la réaction instinctive est de chercher « qui a fait ça ». Cette approche semble logique : identifier le responsable et le sanctionner devrait éviter que ça se reproduise. En réalité, cette logique est contre-productive, et le tableau ci-dessous relie chaque comportement qu'elle induit à sa conséquence :
| Comportement induit | Conséquence |
|---|---|
| Les équipes cachent leurs erreurs | Les incidents sont sous-déclarés |
| Les gens évitent les tâches risquées | L'innovation est freinée |
| L'information ne circule pas | Les causes réelles restent inconnues |
| La confiance disparaît | La collaboration se dégrade |
L'approche blameless
Section intitulée « L'approche blameless »Le postmortem blameless part d'un principe fondamental : les personnes impliquées ont agi rationnellement avec les informations qu'elles avaient à ce moment-là. Si un administrateur a exécuté une commande qui a causé une panne, les questions pertinentes portent sur le système :
- Pourquoi cette commande était-elle possible dans cet environnement ?
- Quelles informations manquaient pour anticiper le risque ?
- Quel filet de sécurité aurait pu prévenir l'impact ?
Le problème n'est jamais « Jean a fait une erreur ». Le problème est « notre système a permis qu'une erreur humaine normale cause un incident majeur ».
Les bénéfices concrets
Section intitulée « Les bénéfices concrets »Une culture blameless produit des effets observables sur la fiabilité, dans le même sens à chaque fois, même si leur ampleur dépend fortement du contexte de l'organisation :
- Déclaration d'incidents en hausse : les équipes signalent les problèmes plus tôt, y compris les presque-incidents
- Temps de résolution en baisse : l'information circule sans filtre défensif
- Récurrence des incidents en baisse : les vraies causes systémiques sont traitées, pas seulement les symptômes
- Engagement des équipes renforcé : la confiance remplace la peur de la sanction
Que contient un postmortem ?
Section intitulée « Que contient un postmortem ? »Un postmortem efficace suit une structure standardisée : résumé exécutif, chronologie, analyse des causes (immédiate, contributives, profonde), ce qui a fonctionné ou non, actions correctives avec responsable et échéance, leçons apprises. L'exemple complet ci-dessous, fictif, illustre chaque rubrique sur une saturation du pool de connexions PostgreSQL :
# Postmortem : Timeout API de paiementDate de l'incident : 15 décembre 2024Auteur : Marie DupontParticipants : Jean Martin (Ops), Pierre Durand (Dev), Sophie Bernard (Support)Statut : En cours de suivi
## Résumé exécutifL'API de paiement a été indisponible pendant 47 minutes (14h23-15h10)suite à une saturation du pool de connexions PostgreSQL.Impact : 1 247 transactions échouées, perte estimée à 45 000 €.
## Chronologie des événements| Heure | Événement ||-------|-----------|| 14h23 | Première alerte : temps de réponse API > 5s || 14h25 | L'équipe support signale des plaintes clients || 14h28 | Jean identifie la saturation du pool PostgreSQL || 14h35 | Tentative de restart du service API (échec) || 14h42 | Pierre identifie une requête bloquante non commitée || 14h48 | Kill de la session PostgreSQL problématique || 14h52 | Restart progressif des instances API || 15h10 | Retour à la normale confirmé |
## Analyse des causes
### Cause immédiateUne requête de reporting lancée manuellement a verrouillé une tablependant 45 minutes, bloquant progressivement toutes les connexions.
### Causes contributives1. Pas de séparation entre base transactionnelle et reporting2. Pas de timeout configuré sur les requêtes longues3. Pas d'alerte sur le nombre de connexions actives4. Documentation du pool de connexions inexistante
### Cause profondeL'architecture ne prévoit pas d'isolation entre les charges de travailcritiques (transactions) et non critiques (reporting).
## Ce qui a bien fonctionné- Détection rapide par le monitoring (< 5 min)- Communication fluide entre les équipes- Logs suffisamment détaillés pour le diagnostic- Rollback possible sans perte de données
## Ce qui a mal fonctionné- Pas de runbook pour ce type d'incident- Temps de diagnostic trop long (14 min)- Première tentative de correction inefficace- Pas d'alerte sur les verrous de longue durée
## Actions correctives
| Action | Responsable | Échéance | Priorité ||--------|-------------|----------|----------|| Créer une réplique dédiée au reporting | Pierre | 15 jan | Haute || Configurer statement_timeout à 5 min | Jean | 20 déc | Critique || Ajouter alerte sur connexions > 80% | Jean | 20 déc | Haute || Rédiger runbook « saturation pool PG » | Marie | 10 jan | Moyenne || Former l'équipe support au diagnostic | Sophie | 31 jan | Moyenne |
## Leçons apprises1. Les requêtes ad-hoc sur la base de production sont un risque majeur2. Le monitoring du pool de connexions était un angle mort3. L'équipe a besoin d'un runbook pour les incidents base de données
## Métriques de suivi- Nombre d'incidents pool de connexions : objectif 0 sur 6 mois- Temps moyen de détection : objectif < 2 min- Temps moyen de résolution incidents DB : objectif < 15 min
Remarquez la rubrique « Ce qui a bien fonctionné » : elle n'est pas de la politesse. Elle identifie les pratiques à conserver, ici la détection en moins de 5 minutes, pour qu'une action corrective ne les supprime pas par mégarde. Le SRE Book publie aussi un exemple complet de postmortem, utile comme second modèle.
Quelles sont les cinq qualités d'un bon postmortem ?
Section intitulée « Quelles sont les cinq qualités d'un bon postmortem ? »Un bon postmortem est factuel, complet, actionnable, partagé et suivi. Chacune de ces qualités répond à un mode d'échec précis, détaillé ci-dessous.
-
Factuel
Un bon postmortem décrit les faits sans interprétation ni jugement. « Le service a été redémarré à 14h52 » plutôt que « Jean a enfin pensé à redémarrer le service ».
La chronologie doit être vérifiable. Les heures proviennent des logs, pas des souvenirs. Les actions sont décrites objectivement.
-
Complet
Toutes les informations nécessaires sont présentes : contexte, chronologie, causes, impacts, actions. Un lecteur qui n'a pas vécu l'incident doit pouvoir comprendre ce qui s'est passé et pourquoi.
Les zones d'ombre sont explicitement mentionnées : « Nous n'avons pas pu déterminer pourquoi le monitoring n'a pas alerté plus tôt ».
-
Actionnable
Chaque cause identifiée génère une action corrective. Chaque action a un responsable, une échéance et une priorité. « Améliorer le monitoring » n'est pas une action. « Ajouter une alerte Prometheus sur pg_stat_activity > 80 connexions » en est une.
-
Partagé
Un postmortem qui reste dans un tiroir ne sert à rien. Il doit être accessible à toutes les personnes concernées, présenté en réunion d'équipe, et référencé dans la documentation.
Les équipes qui n'ont pas participé à l'incident doivent pouvoir apprendre de l'expérience des autres.
-
Suivi
Les actions correctives sont suivies jusqu'à leur complétion. Un postmortem sans suivi est un exercice de style. Le statut des actions est mis à jour régulièrement, et un bilan est fait après l'échéance de la dernière action.
Comment appliquer la méthode des 5 pourquoi ?
Section intitulée « Comment appliquer la méthode des 5 pourquoi ? »La technique des 5 pourquoi (5 Whys) consiste à poser la question « Pourquoi ? » de manière itérative jusqu'à atteindre la cause racine. Développée chez Toyota, elle part du symptôme observé et remonte chaque maillon de la chaîne causale ; le chiffre cinq est un ordre de grandeur, pas une règle.
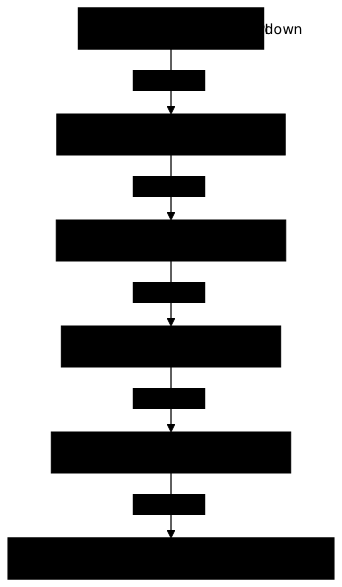
Appliquée à l'incident de l'API de paiement décrit plus haut, la méthode descend en cinq marches de la panne visible à la cause architecturale :
| Question | Réponse |
|---|---|
| Incident | L'API de paiement a été indisponible pendant 47 minutes |
| Pourquoi ? | Le pool de connexions PostgreSQL était saturé |
| Pourquoi ? | Une requête maintenait un verrou sur une table depuis 45 minutes |
| Pourquoi ? | La requête de reporting n'avait pas de timeout configuré |
| Pourquoi ? | Aucune politique de timeout n'existe pour les requêtes |
| Pourquoi ? | L'architecture n'a pas été conçue pour isoler les charges de travail |
La cause profonde n'est pas « quelqu'un a lancé une requête », mais « l'architecture permet qu'une requête de reporting impacte les transactions critiques ».
Comment organiser la réunion de postmortem ?
Section intitulée « Comment organiser la réunion de postmortem ? »La réunion de postmortem réunit les témoins directs de l'incident autour d'un facilitateur neutre, pendant une heure et demie au plus, pour valider la chronologie, trouver les causes et attribuer des actions.
Qui participe ?
Section intitulée « Qui participe ? »Le dosage de l'assistance conditionne la franchise des échanges. Trop peu de monde et l'analyse rate des angles ; trop de monde, surtout du management en position de juge, et les participants s'autocensurent. La règle pratique tient en une ligne : invitez ceux qui détiennent une information de première main sur l'incident, laissez les autres en lecture du compte rendu.
- Obligatoire : les personnes directement impliquées dans l'incident
- Recommandé : les équipes impactées (support, métier)
- Optionnel : le management (en observateur, pas en juge)
Le rôle du facilitateur
Section intitulée « Le rôle du facilitateur »Un facilitateur neutre guide la discussion. Ce n'est ni le manager des participants ni la personne la plus impliquée dans l'incident : sa neutralité est ce qui lui permet de recadrer une accusation sans froisser. Son rôle tient en cinq gestes :
- Maintenir le focus sur les faits et les causes
- Couper court aux accusations ou justifications
- S'assurer que toutes les voix sont entendues
- Garder le timing (1h30 maximum)
- Prendre des notes structurées
Déroulement type (1h30)
Section intitulée « Déroulement type (1h30) »Ce minutage n'est pas décoratif : il protège la partie la plus utile de la réunion. Le piège récurrent est de laisser la reconstitution de la chronologie déborder et grignoter le temps de l'analyse des causes, alors que c'est cette dernière qui produit les actions correctives. Surveillez donc le passage à la trentième minute ; si les faits ne sont pas encore stabilisés, tranchez et avancez, la chronologie se complétera par écrit après la séance.
| Phase | Durée | Objectif |
|---|---|---|
| Introduction | 5 min | Rappeler les règles blameless |
| Chronologie | 20 min | Reconstituer les faits ensemble |
| Analyse des causes | 30 min | Identifier les causes profondes |
| Ce qui a fonctionné | 10 min | Valoriser les bonnes pratiques |
| Actions correctives | 20 min | Définir les améliorations |
| Conclusion | 5 min | Résumer et attribuer le suivi |
Les règles à afficher en début de réunion
Section intitulée « Les règles à afficher en début de réunion »Ces cinq règles ne sont pas un rituel formel : elles servent d'outil de recadrage au facilitateur. Affichées à l'écran ou au mur, elles permettent de couper une accusation naissante en pointant simplement la règle concernée, sans que cela paraisse personnel. La plus souvent invoquée en séance est la troisième, celle qui requalifie une erreur humaine en symptôme d'un système défaillant.
- Nous cherchons les causes, pas les coupables
- Chacun a agi rationnellement avec les informations disponibles
- Les erreurs humaines sont des symptômes, pas des causes
- Nous sommes là pour apprendre, pas pour juger
- Les désaccords sont bienvenus, les attaques personnelles non
Quand faire un postmortem ?
Section intitulée « Quand faire un postmortem ? »Un postmortem se déclenche sur des critères définis à l'avance, jamais au cas par cas après l'incident. Le SRE Book cite comme déclencheurs courants : une indisponibilité ou une dégradation visible des utilisateurs au-delà d'un seuil, une perte de données de quelque nature que ce soit, une intervention de l'ingénieur d'astreinte, un temps de résolution au-delà d'un seuil, et une défaillance du monitoring.
Tous les incidents ne méritent pas un postmortem complet. Le tableau ci-dessous donne un exemple de seuils à adapter à la taille et à l'activité de votre organisation : ce sont des repères de départ, pas une norme.
| Critère | Postmortem obligatoire | Postmortem recommandé |
|---|---|---|
| Durée | > 30 minutes | 15-30 minutes |
| Impact utilisateurs | > 1000 utilisateurs | 100-1000 utilisateurs |
| Impact financier | > 10 000 € | 1 000-10 000 € |
| Données perdues | Oui | Risque avéré |
| Incident récurrent | 3ème occurrence | 2ème occurrence |
| Near miss | Évité de justesse | - |
Où stocker les postmortems ?
Section intitulée « Où stocker les postmortems ? »Le meilleur emplacement est celui où vos équipes cherchent déjà leur documentation opérationnelle : un postmortem qu'on ne retrouve pas ne sert à personne. Le tableau compare les quatre options courantes :
| Solution | Avantages | Inconvénients |
|---|---|---|
| Wiki d'équipe | Accessible, recherche facile | Peut devenir désorganisé |
| Dépôt Git | Versionné, revue possible | Moins accessible aux non-tech |
| Confluence/Notion | Collaboration facile | Dépendance à un outil |
| Dossier partagé | Simple | Recherche limitée |
Recommandation : utilisez le même outil que vos runbooks
et que votre documentation opérationnelle.
La cohérence facilite l'adoption. Créez une convention de nommage
claire : postmortem-YYYY-MM-DD-resume-court.md, qui trie les fichiers par
date sans effort.
Quels anti-patterns éviter ?
Section intitulée « Quels anti-patterns éviter ? »Quatre dérives vident un postmortem de sa valeur : la chasse aux sorcières, l'analyse superficielle, le postmortem jamais diffusé et les actions sans suite. Chacune se reconnaît à un symptôme précis.
La chasse aux sorcières
Section intitulée « La chasse aux sorcières »Symptôme : le postmortem se transforme en procès. Les questions commencent par « pourquoi tu as... » ou « qui a décidé de... ».
Conséquence : les équipes se braquent, l'information ne circule plus, les prochains incidents seront cachés.
Solution : le facilitateur recadre immédiatement. Reformuler « pourquoi Jean a fait ça » en « quelles informations manquaient pour éviter cette action ».
L'analyse superficielle
Section intitulée « L'analyse superficielle »Symptôme : le postmortem s'arrête à la cause immédiate. « Le serveur a planté parce que le disque était plein. Action : ajouter du disque ».
Conséquence : le même incident se reproduira sous une autre forme. Les causes systémiques ne sont jamais traitées.
Solution : appliquer la méthode des 5 pourquoi systématiquement. Pourquoi le disque s'est rempli ? Pourquoi l'alerte n'a pas fonctionné ? Pourquoi personne n'a vérifié ?
Le postmortem fantôme
Section intitulée « Le postmortem fantôme »Symptôme : le postmortem est rédigé mais jamais partagé. Il reste dans le dossier de son auteur ou dans une page wiki que personne ne consulte.
Conséquence : l'apprentissage reste individuel. Les autres équipes feront les mêmes erreurs.
Solution : inclure une étape de diffusion dans le processus. Présentation en réunion d'équipe, notification dans le canal de discussion de l'équipe, lien dans la documentation.
Les actions sans suite
Section intitulée « Les actions sans suite »Symptôme : le postmortem contient une belle liste d'actions correctives. Au bout de trois mois, aucune n'a été réalisée.
Conséquence : l'exercice perd sa crédibilité. Les équipes cessent de proposer des améliorations puisqu'elles ne sont jamais implémentées.
Solution : suivre les actions dans l'outil de gestion de projet (Jira, GitLab Issues). Faire un bilan mensuel des actions ouvertes. Escalader les blocages.
Comment intégrer les postmortems dans le workflow ?
Section intitulée « Comment intégrer les postmortems dans le workflow ? »Un postmortem isolé a peu d'impact. L'intégrer aux processus existants,
pipeline, runbooks et monitoring, maximise sa valeur. L'extrait GitLab CI
ci-dessous crée automatiquement un squelette de postmortem dans le dépôt
quand un incident de sévérité major est déclaré, ce qui garantit que le
document existe avant même la réunion :
# Création automatique d'un template de postmortem après incident majeurcreate_postmortem:  stage: post-incident  script:    - |      cat > postmortems/postmortem-$(date +%Y-%m-%d)-${INCIDENT_ID}.md << EOF      # Postmortem : ${INCIDENT_TITLE}      Date de l'incident : $(date +%Y-%m-%d)      Auteur : À compléter      Participants : À compléter      Statut : En cours de rédaction
      ## Résumé exécutif      À compléter
      ## Chronologie des événements      | Heure | Événement |      |-------|-----------|      | | |
      ## Analyse des causes      ### Cause immédiate      ### Causes contributives      ### Cause profonde
      ## Actions correctives      | Action | Responsable | Échéance | Priorité |      |--------|-------------|----------|----------|      | | | | |      EOF    - git add postmortems/    - git commit -m "chore: créer template postmortem incident ${INCIDENT_ID}"    - git push  rules:    - if: $INCIDENT_SEVERITY == "major"
Les variables INCIDENT_ID, INCIDENT_TITLE et INCIDENT_SEVERITY sont à
fournir au déclenchement du pipeline, et le git push suppose un jeton
d'accès en écriture configuré pour le job : l'extrait illustre le principe,
il ne se copie pas tel quel.
Lien avec les runbooks
Section intitulée « Lien avec les runbooks »Chaque postmortem peut générer ou améliorer un runbook. Ajoutez systématiquement une action du type « créer ou mettre à jour le runbook pour ce type d'incident » : le postmortem alimente ainsi la base de connaissances opérationnelles, et l'incident suivant se traite par une procédure écrite au lieu d'une improvisation.
Lien avec le monitoring
Section intitulée « Lien avec le monitoring »Les angles morts révélés par l'analyse doivent se traduire en alertes, sous la forme « ajouter une alerte sur [métrique] avec seuil [valeur] ». Le postmortem améliore ainsi la détection des futurs incidents, et le temps de détection devient une métrique de suivi à part entière.
Quelles checklists suivre avant, pendant et après ?
Section intitulée « Quelles checklists suivre avant, pendant et après ? »Les quatre listes ci-dessous découpent le postmortem en phases : à chaud pendant l'incident, en préparation, en réunion, puis après la réunion. Elles servent de pense-bête au facilitateur comme à l'ingénieur d'astreinte.
Checklist « Pendant l'incident »
Section intitulée « Checklist « Pendant l'incident » »Cette liste se joue à chaud, quand personne n'a le temps de documenter. Son unique objectif est de préserver les preuves périssables : les logs qui tournent, les métriques qui s'écrasent, l'heure exacte de chaque action. Un postmortem de qualité se prépare ici, pas trois jours après, car une chronologie reconstituée de mémoire est toujours fausse sur les minutes qui comptent.
- Noter l'heure de début précise
- Identifier les personnes impliquées
- Capturer les logs et métriques pertinents
- Documenter chaque action tentée et son résultat
- Noter l'heure de résolution
Checklist « Préparation du postmortem »
Section intitulée « Checklist « Préparation du postmortem » »Cette phase se déroule à froid, une fois l'incident stabilisé. Le point qui distingue une bonne préparation d'une mauvaise est le premier : produire le postmortem rapidement après la stabilisation, typiquement sous quelques jours ouvrés, pendant que les faits et le contexte restent frais. Il n'existe pas de délai universel. Les chiffres publiés sont des pratiques d'organisations : Atlassian tient la réunion sous 24 à 48 heures et au plus cinq jours ouvrés, PagerDuty sous trois jours calendaires pour un SEV-1 (incident de sévérité maximale) et cinq jours ouvrés pour un SEV-2, alors que le Google SRE Book ne fixe aucun délai chiffré. Trop tôt, les esprits sont encore sous tension et l'analyse dérive vers la justification ; trop tard, les souvenirs et les données se perdent. Le reste du travail consiste à rassembler les preuves collectées à chaud pour arriver en réunion avec une chronologie déjà ébauchée.
- Programmer la réunion rapidement après la stabilisation, sous quelques jours ouvrés
- Collecter les logs, métriques, captures d'écran
- Reconstituer la chronologie à partir des données
- Identifier tous les participants à inviter
- Réserver une salle et envoyer l'invitation
Checklist « Réunion de postmortem »
Section intitulée « Checklist « Réunion de postmortem » »Cette liste guide le facilitateur pendant la séance. L'étape la plus souvent bâclée est l'avant-dernière : formuler des actions SMART. Une action vague comme « améliorer le monitoring » ne survivra pas à la réunion, alors qu'une action spécifique, mesurable et datée génère un ticket concret. Chaque point coché ici doit produire une trace exploitable après la réunion, pas une bonne intention.
- Rappeler les règles blameless en début de réunion
- Valider la chronologie collectivement
- Appliquer la méthode des 5 pourquoi
- Identifier ce qui a bien fonctionné
- Définir des actions SMART (Spécifique, Mesurable, Atteignable, Réaliste, Temporel)
- Attribuer un responsable et une échéance à chaque action
Checklist « Post-réunion »
Section intitulée « Checklist « Post-réunion » »C'est ici que se joue la valeur réelle du postmortem, et c'est ici qu'on abandonne le plus souvent. Rédiger le document sans créer les tickets correspondants transforme l'exercice en littérature : les actions correctives qui ne deviennent pas des tâches suivies ne seront jamais réalisées. Le même réflexe, dès la fin de la réunion, vaut pour la rédaction et pour l'ouverture des tickets, avant que l'urgence ne retombe et que l'incident ne soit oublié.
- Rédiger le document final dès la fin de la réunion
- Faire relire par les participants
- Publier dans l'espace documentaire
- Créer les tickets pour chaque action corrective
- Notifier les équipes concernées
- Planifier le suivi des actions
Quels outils pour gérer les postmortems ?
Section intitulée « Quels outils pour gérer les postmortems ? »Pour les équipes qui gèrent des incidents fréquents, des plateformes de gestion d'incidents génèrent le squelette du postmortem à partir de la chronologie de l'alerte et suivent les actions. Le tableau en liste quelques-unes ; vérifiez toujours leur statut commercial avant de choisir :
| Outil | Type | Points forts |
|---|---|---|
| PagerDuty | SaaS | Intégration alerting, templates, suivi automatique |
| incident.io | SaaS | Intégré à Slack, automatisation |
| Rootly | SaaS | ChatOps, intégrations multiples |
| Jira Service Management | SaaS | Intégration ITSM complète |
| GitLab | Auto-hébergé ou SaaS | Issues + Wiki intégrés |
Opsgenie, longtemps cité dans ce type de comparatif, n'est plus vendu depuis le 4 juin 2025 et son support s'arrête le 5 avril 2027, selon la page de migration d'Atlassian : ne démarrez pas dessus aujourd'hui.
À retenir
Section intitulée « À retenir »- Un postmortem analyse un incident résolu pour en tirer des enseignements ; il complète le compte-rendu, il ne le remplace pas.
- L'approche blameless part du principe que chacun a agi rationnellement avec les informations disponibles : on corrige le système, pas les personnes.
- Le déclenchement repose sur des critères définis à l'avance : indisponibilité au-delà d'un seuil, perte de données, intervention d'astreinte, défaillance du monitoring.
- La chronologie s'appuie sur les logs et métriques, jamais sur les souvenirs, préservés dès la phase à chaud de l'incident.
- La méthode des 5 pourquoi fait passer de la cause immédiate à la cause profonde, souvent architecturale.
- Chaque cause identifiée génère une action SMART avec responsable, échéance et priorité, suivie jusqu'à sa clôture.
- Un postmortem non partagé ou dont les actions ne deviennent pas des tickets suivis est un exercice sans valeur.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Slidev : créer des présentations techniques en Markdown
Continuer le cours : Résilience : HA, DR, chaos engineering et continuité d'activité
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications