Le chirurgien Atul Gawande raconte dans son livre The Checklist Manifesto comment une simple checklist de 19 points a transformé les blocs opératoires. L'étude du programme Safe Surgery Saves Lives de l'OMS, publiée en 2009 dans le New England Journal of Medicine, porte sur 7 688 patients de huit hôpitaux répartis dans huit villes. Elle mesure deux effets : les complications en hospitalisation passent de 11 % à 7 %, soit 36 % de moins, et les décès de 1,5 % à 0,8 %, soit 47 % de moins. Pas une nouvelle technologie, pas une formation supplémentaire, juste une feuille de papier avec des cases à cocher.
En exploitation serveur, c'est pareil. Combien de fois avez-vous oublié de vérifier un point « évident » ? Redémarré un service sans avoir fait la sauvegarde ? Mis en production sans avoir testé le rollback ?
Une checklist bien conçue élimine ces oublis.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Distinguer une checklist d'exploitation d'une simple documentation
- Rédiger des points binaires, vérifiables et indépendants
- Construire une checklist à partir d'un incident réel plutôt que d'une page blanche
- Reconnaître les anti-patterns qui font cocher sans lire
- Intégrer la checklist au workflow, du ticket à la revue périodique
Qu'est-ce qu'une checklist d'exploitation ?
Section intitulée « Qu'est-ce qu'une checklist d'exploitation ? »Définition simple
Section intitulée « Définition simple »Une checklist d'exploitation est une liste structurée de points de contrôle à valider avant, pendant ou après une opération. Elle répond à une question simple : « Ai-je bien fait tout ce qu'il fallait ? »
Contrairement à un runbook qui décrit comment faire une opération, une checklist vérifie que rien n'a été oublié.
| Runbook | Checklist |
|---|---|
« Exécutez df -h pour vérifier l'espace disque » | « ☐ Espace disque vérifié » |
| Décrit les étapes | Vérifie que les étapes sont faites |
| Suivi pas à pas pendant l'opération | Coché avant, pendant et après, pour vérifier |
| Peut faire plusieurs pages | Tient sur une page |
Les deux sont complémentaires : le runbook explique comment faire, la checklist garantit que c'est fait.
Les trois types de checklists
Section intitulée « Les trois types de checklists »Checklists « avant » : s'assurer que tout est prêt.
Exemples :
- Pré-mise en production (serveur configuré, monitoring actif, sauvegardes OK)
- Pré-maintenance (fenêtre validée, communication faite, rollback préparé)
- Pré-déploiement (tests passés, environnement de staging validé)
Ces checklists bloquent l'opération si un point n'est pas validé. Mieux vaut retarder que de foncer tête baissée.
Checklists « après » : vérifier que tout s'est bien passé.
Exemples :
- Post-mise en production (service accessible, logs sans erreur, métriques OK)
- Post-maintenance (services redémarrés, alertes réactivées)
- Post-incident (cause identifiée, ticket créé, runbook mis à jour)
Ces checklists valident que l'opération est vraiment terminée, pas juste « techniquement finie ».
Checklists d'audit : évaluer la conformité d'un système.
Exemples :
- Audit de sécurité (ports ouverts, utilisateurs, permissions)
- Audit de configuration (conformité au baseline, drift détecté)
- Audit de documentation (runbooks à jour, schémas actuels)
Ces checklists sont utilisées périodiquement pour détecter les dérives avant qu'elles ne causent des incidents.
Pourquoi les checklists sont essentielles
Section intitulée « Pourquoi les checklists sont essentielles »Le problème de l'oubli sous pression
Section intitulée « Le problème de l'oubli sous pression »Vous connaissez la procédure par cœur. Vous l'avez faite des dizaines de fois. Mais cette fois, c'est vendredi soir, le téléphone n'arrête pas de sonner, et le manager vous demande « c'est quand que c'est fini ? ».
Dans ce contexte, même les experts oublient des étapes. Pas par incompétence, mais parce que le cerveau humain a des limites cognitives :
- Mémoire de travail limitée : on ne garde que 4 à 7 éléments en tête
- Biais de confirmation : on « sait » que c'est bon, donc on ne vérifie pas
- Interruptions : chacune augmente le risque d'oubli
Une checklist externalise ces vérifications. Le cerveau n'a plus à se souvenir de tout, il lui suffit de lire et cocher. C'est d'ailleurs l'aviation qui a ouvert la voie, et Gawande le rappelle dans son livre : après l'accident du Boeing Model 299 en 1935, piloté par un équipage chevronné, les pilotes d'essai ont adopté une liste de vérification plutôt qu'une formation supplémentaire.
Quels bénéfices attendre d'une checklist ?
Section intitulée « Quels bénéfices attendre d'une checklist ? »| Aspect | Sans checklist | Avec checklist |
|---|---|---|
| Oublis | Fréquents sous pression | Éliminés (si checklist suivie) |
| Cohérence | Dépend de l'opérateur | Identique pour tous |
| Traçabilité | Aucune | Checklist archivée = preuve |
| Audit | Difficile à démontrer | Facile à prouver |
| Formation | « Regarde comment je fais » | Liste claire des points |
Aucune étude comparable ne chiffre l'effet des checklists en exploitation informatique : les gains qu'on lit ici ou là ne précisent ni la population, ni la période, ni ce qu'ils comptent comme incident. Le raisonnement tient donc sans pourcentage, et il tient par le mécanisme : une tâche oubliée ne peut pas causer de panne si sa case reste vide devant les yeux de celui qui exécute.
Anatomie d'une bonne checklist
Section intitulée « Anatomie d'une bonne checklist »La structure minimale
Section intitulée « La structure minimale »Une checklist efficace contient :
# Checklist : [Nom de l'opération]
## Contexte* Quand utiliser cette checklist* Prérequis
## Points de contrôle
### Avant l'opération* [ ] Point 1* [ ] Point 2
### Pendant l'opération* [ ] Point 3
### Après l'opération* [ ] Point 4* [ ] Point 5
## Validation* Opérateur : ___________* Date : ___________* Résultat : OK / NOK
Chaque point doit être :
- Binaire : oui ou non, fait ou pas fait, jamais « partiellement »
- Vérifiable : on peut prouver que c'est fait
- Indépendant : chaque point se vérifie seul
Exemple concret : mise en production d'un serveur
Section intitulée « Exemple concret : mise en production d'un serveur »Voici une checklist réelle, prête à copier et à adapter. Observez comment elle applique les trois règles précédentes : chaque ligne est binaire (« NTP synchronisé et fonctionnel », pas « réseau OK »), les points sont regroupés par domaine pour ne pas mélanger sécurité et sauvegarde, et le bloc final Validation matérialise la responsabilité de l'opérateur. Ne la reprenez pas telle quelle : retirez ce qui ne s'applique pas à votre parc, sinon les points inutiles seront cochés machinalement et perdront leur valeur.
# Checklist : Mise en production serveur Linux
## ContexteUtiliser avant de déclarer un serveur "prêt pour la production".Prérequis : installation de base terminée.
## Configuration système* [ ] Hostname configuré selon la convention de nommage* [ ] Timezone correcte (Europe/Paris)* [ ] NTP synchronisé et fonctionnel* [ ] Locales configurées (fr_FR.UTF-8)
## Sécurité* [ ] Firewall activé, seuls les ports nécessaires ouverts* [ ] SSH : authentification par clé uniquement, root désactivé* [ ] Utilisateurs : comptes nominatifs, pas de comptes partagés* [ ] sudo : configuré avec journalisation* [ ] Mises à jour de sécurité appliquées
## Monitoring* [ ] Agent de monitoring installé et actif* [ ] Métriques de base remontées (CPU, RAM, disque, réseau)* [ ] Alertes configurées et testées* [ ] Contact d'astreinte vérifié
## Sauvegarde* [ ] Agent de sauvegarde installé* [ ] Politique de sauvegarde définie* [ ] Première sauvegarde effectuée* [ ] Restauration testée au moins une fois
## Documentation* [ ] Serveur documenté dans le CMDB/inventaire* [ ] Schéma réseau à jour* [ ] Runbooks applicables identifiés
## Validation finale* [ ] Tests de charge/smoke tests passés* [ ] Validation par un pair* Opérateur : ___________* Date : ___________
Les 5 qualités d'une checklist efficace
Section intitulée « Les 5 qualités d'une checklist efficace »-
Courte : moins de 20 points. C'est une heuristique, pas une loi : la checklist de l'OMS en compte 19, ce qui ne condamne pas celle qui en compte 21. Au-delà, interrogez-vous : la liste couvre-t-elle encore un seul moment de l'opération ? Une checklist trop longue ne sera pas utilisée.
-
Précise : « Firewall activé » plutôt que « Sécurité vérifiée ». Chaque point doit être sans ambiguïté.
-
Séquentielle : les points suivent l'ordre logique d'exécution, et on les lit de haut en bas sans sauter.
-
Testée : chaque point a été vérifié comme pertinent en conditions réelles. Pas de points « au cas où ».
-
Maintenue : mise à jour après chaque incident révélant un oubli. Une checklist obsolète est dangereuse.
Comment créer vos checklists
Section intitulée « Comment créer vos checklists »Méthode pas à pas
Section intitulée « Méthode pas à pas »Les six étapes forment une boucle, pas une ligne : la dernière renvoie à la deuxième dès qu'un incident révèle un point manquant ou qu'un point devient obsolète. Le schéma met en avant l'étape qui donne sa forme à la checklist, la structure avant, pendant, après.
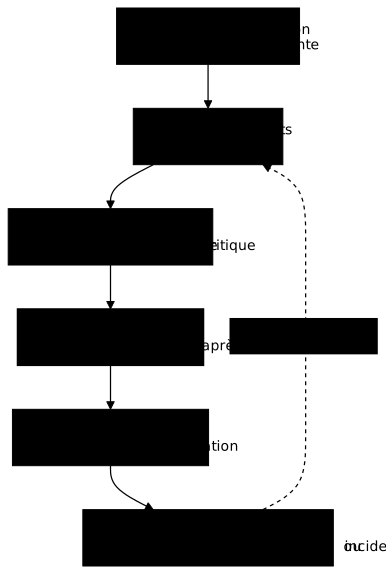
-
Identifier l'opération à couvrir
Commencez par les opérations critiques ou fréquentes : mise en production, maintenance planifiée, déploiement. Une opération = une checklist.
-
Lister tous les points de contrôle
Réfléchissez avec l'équipe : qu'est-ce qu'on oublie parfois ? Qu'est-ce qui a causé des incidents ? Incluez les points « évidents », ce sont souvent ceux qu'on oublie.
-
Filtrer et prioriser
Gardez uniquement les points critiques. Si un oubli n'a pas de conséquence grave, le point n'a pas sa place dans la checklist.
-
Structurer en phases
Organisez en « avant / pendant / après ». Ça aide à savoir où on en est et à ne pas mélanger les vérifications.
-
Tester en conditions réelles
Utilisez la checklist sur une vraie opération. Notez ce qui manque, ce qui est redondant, ce qui n'est pas clair.
-
Itérer après chaque utilisation
Comme les runbooks : chaque opération est une occasion d'améliorer la checklist.
Où stocker vos checklists ?
Section intitulée « Où stocker vos checklists ? »| Solution | Avantages | Inconvénients |
|---|---|---|
| Wiki | Facile à éditer, recherche | Pas de workflow de validation |
| Git | Versionné, revue par PR | Moins accessible pour certains |
| Outil dédié (Notion, Confluence) | Templates, assignation | Dépendance à un outil |
| Papier | Toujours disponible | Pas de versioning, perte facile |
Recommandation : stockez les templates dans Git, utilisez des copies dans le wiki ou un outil de tickets pour l'exécution avec traçabilité.
Les anti-patterns à éviter
Section intitulée « Les anti-patterns à éviter »La checklist fleuve
Section intitulée « La checklist fleuve »Symptôme : 50 points, personne ne la lit en entier.
Problème : Une checklist trop longue sera survolée ou ignorée.
Solution : viser 15 à 20 points, sans en faire une loi. Si la liste s'allonge, la question utile n'est pas le compte mais le périmètre : couvre-t-elle encore un seul moment de l'opération ? Sinon, découpez.
La checklist vague
Section intitulée « La checklist vague »Symptôme : « Vérifier la sécurité », « S'assurer que tout fonctionne ».
Problème : Impossible de savoir si c'est vraiment fait.
Solution : Points précis et vérifiables. « SSH : authentification par clé uniquement » plutôt que « SSH sécurisé ».
La checklist fossile
Section intitulée « La checklist fossile »Symptôme : « Ce point date de 2018, on ne fait plus ça depuis longtemps ».
Problème : Points obsolètes = perte de confiance = checklist ignorée.
Solution : Revue trimestrielle, mise à jour après chaque incident.
La checklist optionnelle
Section intitulée « La checklist optionnelle »Symptôme : « On utilise la checklist quand on a le temps ».
Problème : Les oublis arrivent justement quand on n'a pas le temps.
Solution : Checklist obligatoire, intégrée dans le workflow (pas de mise en prod sans checklist validée).
Intégrer les checklists dans votre workflow
Section intitulée « Intégrer les checklists dans votre workflow »Lier checklists et processus
Section intitulée « Lier checklists et processus »La checklist ne doit pas être un document isolé. Intégrez-la dans vos outils :
- Tickets/Issues : template de ticket incluant la checklist
- CI/CD : étape de validation manuelle avec checklist
- Change management : checklist comme condition de validation
- Postmortem : « La checklist était-elle à jour ? »
Exemple : intégration GitLab
Section intitulée « Exemple : intégration GitLab »Une checklist gagne en fiabilité quand elle vit là où se fait le travail, pas dans un wiki que personne n'ouvre au moment critique. En collant les cases à cocher dans la description d'une merge request ou d'un ticket de déploiement, la validation devient traçable : GitLab conserve qui a coché quoi et quand. L'exemple ci-dessous découpe le déploiement selon trois moments clés, avant la fusion, avant la mise en production, puis après, pour que rien ne soit validé trop tôt.
## Checklist de déploiement
### Avant merge* [ ] Tests unitaires passés* [ ] Review par un pair* [ ] Documentation mise à jour
### Avant déploiement prod* [ ] Déployé en staging* [ ] Smoke tests passés* [ ] Rollback testé* [ ] Communication équipe faite
### Après déploiement* [ ] Métriques vérifiées (pas d'anomalie)* [ ] Logs vérifiés (pas d'erreur)* [ ] Ticket clos
Checklists de référence
Section intitulée « Checklists de référence »Pour commencer (minimum viable)
Section intitulée « Pour commencer (minimum viable) »Si vous partez de zéro, ne cherchez pas à couvrir toutes vos opérations d'un coup : le projet s'enliserait. Cette première liste vise le minimum qui apporte déjà de la valeur, trois checklists courtes sur vos opérations les plus risquées, testées une fois en réel. L'important n'est pas l'exhaustivité mais d'installer le réflexe et de désigner un responsable qui la fera vivre.
- Identifier 3 opérations critiques sans checklist
- Créer une checklist simple pour chacune (< 15 points)
- Stocker dans un endroit accessible à tous
- Tester sur une opération réelle
- Identifier un responsable par checklist
- Planifier une revue trimestrielle
Pour une organisation mature
Section intitulée « Pour une organisation mature »Ce second niveau décrit une cible, pas un point de départ. On y reconnaît une organisation où les checklists sont versionnées, intégrées aux outils et mises à jour après chaque incident, plutôt que des documents figés. Servez- vous de cette liste comme d'un auto-diagnostic : chaque case non cochée désigne un chantier concret d'amélioration, pas un échec.
- Toutes les opérations critiques ont une checklist
- Checklists versionnées dans Git
- Intégration dans les outils (tickets, CI/CD)
- Mise à jour systématique après chaque incident
- Métriques d'utilisation (taux de complétion)
- Audit régulier de la pertinence
- Formation des nouveaux sur les checklists clés
Par où commencer
Section intitulée « Par où commencer »Commencez par l'opération critique que vous faites le plus souvent : une checklist de dix points, utilisée dès la prochaine occurrence, puis améliorée à chaque passage. La procédure détaillée que la checklist se contente de vérifier s'écrit dans un runbook, et les deux domaines où l'oubli coûte le plus cher sont les mises à jour et la dérive de configuration.
À retenir
Section intitulée « À retenir »-
Une checklist n'est pas pour les débutants : même les experts oublient sous pression, et les pilotes chevronnés en utilisent.
-
Court et précis : 15 à 20 points comme repère et non comme règle, chaque point vérifiable et sans ambiguïté.
-
Binaire : fait ou pas fait, jamais « partiellement » ni « à peu près ».
-
Obligatoire, pas optionnel : si la checklist est facultative, elle ne sera pas utilisée quand on en a le plus besoin.
-
Vivante : mise à jour après chaque incident ou oubli découvert.
-
Intégrée : dans les outils et les processus, pas un document isolé.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Documentation opérationnelle : structurer pour retrouver
Continuer le cours : Service overview : la carte d'identité du service
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications
Sources et références
Section intitulée « Sources et références »Les chiffres de l'introduction viennent de l'étude de l'OMS citée en premier ; le livre de Gawande en donne le récit, le livre SRE de Google situe les checklists dans les pratiques d'exploitation, et les CIS Controls fournissent une base de points de contrôle de sécurité prêts à reprendre.
- A Surgical Safety Checklist to Reduce Morbidity and Mortality in a Global Population : l'étude de Haynes et al., N Engl J Med 2009;360:491-499, d'où viennent les chiffres cités plus haut
- The Checklist Manifesto, Atul Gawande
- Site Reliability Engineering (Google) : les pratiques SRE
- CIS Controls : bonnes pratiques de sécurité