Vous êtes-vous déjà retrouvé à 2 heures du matin face à un serveur en panne, à vous demander : « Qui a configuré ce truc ? Où sont les identifiants ? C'est quoi déjà la procédure de redémarrage ? » Si oui, vous avez vécu le cauchemar d'une documentation absente ou introuvable.
La documentation opérationnelle, c'est tout ce qui permet à une équipe de comprendre, maintenir et faire évoluer son infrastructure sans dépendre d'une seule personne. Cette leçon s'adresse à l'administrateur ou au devops qui doit organiser cette documentation : elle la range en cinq familles, chacune avec son usage, son format et son rythme de mise à jour.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Expliquer pourquoi une information connue d'une seule personne est une information fragile
- Classer un document dans l'une des cinq familles : cartographie, architecture, procédures, référentiel, historique
- Appliquer la règle « un document = une famille »
- Mettre en place une documentation minimale en cinq étapes
- Répartir les responsabilités avec une matrice RACI et un fichier CODEOWNERS
Pourquoi la documentation opérationnelle est-elle indispensable ?
Section intitulée « Pourquoi la documentation opérationnelle est-elle indispensable ? »La documentation opérationnelle est indispensable parce qu'une équipe ne peut pas compter sur la mémoire de ses membres pour réparer, transmettre ou auditer son infrastructure. Ce qui n'est pas écrit disparaît au premier départ, et coûte cher au premier incident.
Connaissance tacite ou documentation : quelle différence ?
Section intitulée « Connaissance tacite ou documentation : quelle différence ? »Il y a une différence fondamentale entre ce qui est documenté et ce qui est connu. La connaissance tacite, c'est le savoir qui reste dans la tête des experts sans jamais avoir été écrit : c'est Jean-Pierre qui sait que « le serveur de prod, faut le redémarrer dans cet ordre sinon ça plante », ou Marie qui connaît le mot de passe de l'ancien compte admin parce qu'elle l'a configuré il y a trois ans.
Le problème ? Jean-Pierre part en vacances. Marie change d'entreprise. Et soudain, plus personne ne sait. La documentation, c'est ce qui reste quand les experts ne sont pas là : c'est la différence entre une équipe résiliente et une équipe qui s'effondre au premier départ.
Quels bénéfices concrets en attendre ?
Section intitulée « Quels bénéfices concrets en attendre ? »Vous pensez peut-être : « On est une petite équipe, on se parle tous les jours, pas besoin de tout écrire. » C'est une erreur classique, parce que les moments où la documentation sert sont justement ceux où personne n'est disponible : l'astreinte de nuit, l'arrivée d'un nouveau, le départ d'un expert. Le tableau compare ces situations avec et sans documentation.
| Bénéfice | Sans documentation | Avec documentation |
|---|---|---|
| Temps de diagnostic | On commence par chercher « c'est quoi ce serveur ? » | Ouvrir la page du service, voir le diagramme, suivre le runbook |
| Intégration des nouveaux | Des semaines à solliciter les collègues | Lecture autonome, puis questions ciblées |
| Astreinte | Appeler l'expert à 3 h du matin | Suivre le runbook, n'escalader que l'imprévu |
| Départ d'un expert | Panique, perte de savoir critique | Transition préparée, le savoir est écrit |
| Audit de sécurité | « Euh... je crois que c'est configuré comme ça... » | « Voici notre documentation des accès » |
Que se passe-t-il quand elle est mal structurée ?
Section intitulée « Que se passe-t-il quand elle est mal structurée ? »Une documentation mal structurée mélange des documents qui ne répondent pas au même besoin ni au même moment. Un runbook, la procédure pas à pas qu'on suit pour intervenir, se consulte en urgence, à 3 h du matin, quand une alerte tombe. Une note d'architecture se lit posément, en amont d'une décision. Les ranger au même endroit oblige le lecteur pressé à trier lui-même, exactement quand il n'en a pas le temps.
| Problème | Conséquence |
|---|---|
| Tout mélangé dans un wiki | Impossible de trouver l'info en urgence |
| Runbook et architecture dans le même document | Le lecteur se perd et saute des sections |
| Pas de structure définie | Chacun documente à sa façon |
| Doublons partout | On ne sait plus quelle version est à jour |
Quelles sont les 5 familles de documentation ?
Section intitulée « Quelles sont les 5 familles de documentation ? »La documentation opérationnelle se range en cinq familles : cartographie, architecture, procédures, référentiel et historique. Chacune répond à une question différente, a un format adapté et suit son propre cycle de mise à jour. Les deux onglets ci-dessous résument cette répartition, d'abord par question, puis par analogie avec une bibliothèque.
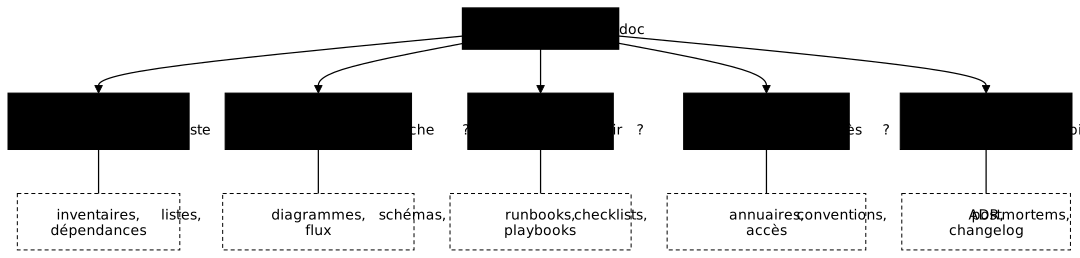
| Famille | Question | Quand consulter | Format type |
|---|---|---|---|
| Cartographie | Qu'est-ce qui existe ? | Comprendre le paysage | Inventaires, listes |
| Architecture | Comment ça fonctionne ? | Diagnostic, onboarding | Diagrammes, schémas |
| Procédures | Comment agir ? | Incident, opération | Runbooks, checklists |
| Référentiel | Qui ? Quels accès ? Quelles règles ? | Organisation, droits | Annuaires, conventions |
| Historique | Pourquoi ce choix ? | Comprendre le passé | ADR, postmortems |
| Famille | Équivalent bibliothèque | Ce qu'on y cherche |
|---|---|---|
| Cartographie | Catalogue, index | « Qu'avons-nous ? » |
| Architecture | Plans, cartes | « Comment c'est organisé ? » |
| Procédures | Manuels, guides pratiques | « Comment faire ? » |
| Référentiel | Annuaire, règlement | « Qui fait quoi ? Quelles règles ? » |
| Historique | Archives, journaux | « Pourquoi c'est comme ça ? » |
Famille 1 : la cartographie, qu'est-ce qui existe ?
Section intitulée « Famille 1 : la cartographie, qu'est-ce qui existe ? »La cartographie recense tout ce qui compose votre système : serveurs, services, bases de données, API, connexions entre composants. C'est l'inventaire complet de votre infrastructure, la première page qu'on ouvre pour savoir de quoi on parle.
Ce qu'elle contient :
- Inventaire des serveurs (nom, rôle, IP, environnement)
- Liste des services (nom, fonction, owner, criticité)
- Registre des bases de données (type, version, connexions)
- Catalogue des API (endpoints, authentification)
- Matrice des dépendances (qui appelle qui)
Le format qui convient est le tableau structuré : une ligne par service, une colonne par information qu'on cherche en urgence, notamment le propriétaire (owner), la criticité et les dépendances.
| Service | Owner | Criticité | Dépendances | SLA ||---------|-------|-----------|-------------|-----|| auth-api | @team-identity | Tier 1 | PostgreSQL, Redis | 99.9% || payment-service | @team-payment | Tier 1 | auth-api, Stripe | 99.95% || notification | @team-comm | Tier 2 | auth-api, SendGrid | 99% |Cycle de mise à jour : à chaque changement (nouveau service, migration, décommissionnement).
Famille 2 : l'architecture, comment ça fonctionne ?
Section intitulée « Famille 2 : l'architecture, comment ça fonctionne ? »L'architecture explique comment les composants interagissent : les flux de données, les protocoles utilisés, les frontières réseau. C'est la vision technique de votre système, celle qu'on lit pour diagnostiquer une panne ou accueillir un nouveau collègue.
Ce qu'elle contient :
- Diagrammes de composants (boîtes et flèches montrant les services)
- Flux de données (utilisateur → API → base de données)
- Diagrammes réseau (VLAN, pare-feu, répartiteurs de charge)
- Schémas de déploiement (Kubernetes, VM, cloud)
Le format recommandé associe des diagrammes simples à un texte explicatif. Privilégiez les formats textuels comme Mermaid ou PlantUML, qui se versionnent avec le reste, ou des outils visuels faciles à maintenir.
Pour choisir le niveau de détail, le modèle C4 de Simon Brown propose quatre niveaux de diagrammes, du plus large au plus fin. Chaque niveau vise un public différent : on documente presque toujours les deux premiers, rarement le dernier.
| Niveau | Public | Détail |
|---|---|---|
| Contexte | Tous | Le système et ses interactions externes |
| Conteneurs | Développeurs | Applications, bases, files d'attente |
| Composants | Équipe technique | Modules internes d'un service |
| Code | Contributeurs | Classes, fonctions (rarement documenté) |
Cycle de mise à jour : lors de changements structurels, avec une revue annuelle au minimum.
Famille 3 : les procédures, comment agir ?
Section intitulée « Famille 3 : les procédures, comment agir ? »Les procédures décrivent les actions à effectuer pour des opérations courantes ou des incidents. C'est ce qu'on consulte à 3 h du matin : elles doivent donc se suivre sans réfléchir, étape par étape. La leçon consacrée aux runbooks détaille leur rédaction, celle sur les checklists la façon de ne rien oublier.
| Type | Usage | Exemple |
|---|---|---|
| Runbooks | Incidents, opérations techniques | Redémarrer le service auth |
| Checklists | Ne rien oublier | Checklist de déploiement en prod |
| Playbooks | Scénarios complexes multi-acteurs | Gestion d'un incident majeur |
| Troubleshooting | Diagnostic pas à pas | « Erreur 500 sur /api/users » |
Le format recommandé est une suite d'étapes numérotées, chacune suivie du résultat attendu, puis d'une rubrique « Si ça ne marche pas » qui donne les journaux à lire et le contact d'escalade.
## Redémarrer le service auth
### Prérequis- Accès SSH au serveur auth-prod-01- Droits sudo
### Étapes
1. Vérifier l'état actuel   ```bash   systemctl status auth-service   ```   **Attendu** : "active (running)" ou "failed"
2. Redémarrer le service   ```bash   sudo systemctl restart auth-service   ```
3. Vérifier le redémarrage   ```bash   systemctl status auth-service   ```   **Attendu** : "active (running)" depuis moins d'une minute
### Si ça ne marche pas- Logs : `journalctl -u auth-service -n 100`- Escalade : @oncall-platform
Cycle de mise à jour : après chaque incident où la procédure a échoué ou était incomplète.
Famille 4 : le référentiel, qui contacter et quelles règles ?
Section intitulée « Famille 4 : le référentiel, qui contacter et quelles règles ? »Le référentiel centralise les informations organisationnelles : contacts, droits d'accès, conventions, politiques. Il répond aux questions « qui appeler ? » et « a-t-on le droit ? », qui reviennent dans presque chaque incident.
| Type | Contenu | Exemple |
|---|---|---|
| Annuaire équipes | Qui fait quoi, astreinte, escalade | « L'équipe Platform gère Kubernetes » |
| Matrice des accès | Qui a accès à quoi | « Seuls les SRE ont accès à la prod » |
| Conventions | Standards de nommage, formats | « Les services : {domaine}-{fonction} » |
| Politiques | Règles d'entreprise | « Tout changement en prod passe par une PR » |
| Glossaire | Définition des termes métier | « Un 'tenant' est un client B2B » |
Le format recommandé reste le tableau et la liste structurée : un annuaire se parcourt d'un coup d'œil, une convention de nommage se vérifie ligne par ligne.
## Annuaire des équipes
| Équipe | Responsabilités | Contact Slack | Astreinte ||--------|-----------------|---------------|-----------|| Platform | Kubernetes, CI/CD, Observabilité | #team-platform | @oncall-platform || Identity | Auth, SSO, Permissions | #team-identity | @oncall-identity || Data | Bases de données, Analytics | #team-data | @oncall-data |
## Conventions de nommage
| Ressource | Format | Exemple ||-----------|--------|---------|| Serveur | {env}-{role}-{numero} | prod-web-01 || Service | {domaine}-{fonction} | payment-api || Base de données | {service}-{type}-{env} | auth-postgres-prod |
Chaque partie du référentiel vieillit à sa propre vitesse, d'où des rythmes différents :
- Annuaire : à chaque arrivée ou départ
- Accès : revue trimestrielle (audit sécurité)
- Conventions : rarement (décision collective)
Famille 5 : l'historique, pourquoi ce choix ?
Section intitulée « Famille 5 : l'historique, pourquoi ce choix ? »L'historique conserve la mémoire des décisions et des événements, pour éviter de répéter les erreurs et comprendre le contexte d'un choix ancien. On y trouve surtout les ADR (Architecture Decision Records, une fiche courte par décision technique) et les postmortems, l'analyse écrite d'un incident.
| Type | Usage | Exemple |
|---|---|---|
| ADR | Documenter une décision technique | « Pourquoi PostgreSQL plutôt que MySQL » |
| Postmortems | Analyser un incident | « Panne du 15 mars 2024 » |
| Changelog | Historique des changements | « v2.3.0 : ajout cache Redis » |
| Journal migrations | Suivi des migrations | « Migration Oracle → PostgreSQL » |
Le modèle d'ADR popularisé par Michael Nygard tient en cinq rubriques : titre, contexte, décision, statut et conséquences. L'exemple ci-dessous y ajoute les options écartées, utiles pour ne pas rouvrir le débat ; la leçon ADR en détaille l'écriture.
# ADR-003 : Adoption de PostgreSQL pour les sessions
**Date** : 2024-01-15**Statut** : Accepté**Décideurs** : @alice, @bob, @charlie
## ContexteNous devons stocker les sessions utilisateurs avec haute disponibilitéet transactions ACID.
## Options considérées
| Option | Avantages | Inconvénients ||--------|-----------|---------------|| Redis | Rapide, simple | Durabilité et transactions limitées || PostgreSQL | ACID, SQL, réplication native | Plus lent || DynamoDB | Serverless, scalable | Dépendance à un fournisseur |
## DécisionPostgreSQL : ACID obligatoire, équipe familière.
## Conséquences- [+] Cohérence des données garantie- [-] Latence légèrement supérieure- [Action] Mettre en place PgBouncer
Chaque type de document historique a sa propre règle de vie. Un ADR n'est jamais réécrit : quand une décision est renversée, on garde l'ancien en le marquant remplacé (superseded) et on en écrit un nouveau.
- ADR : immuables (nouvelle décision = nouvel ADR)
- Postmortems : rédigés dans un délai court fixé par l'équipe, tant que les faits sont frais
- Changelog : à chaque release
Pourquoi un document ne doit-il couvrir qu'une seule famille ?
Section intitulée « Pourquoi un document ne doit-il couvrir qu'une seule famille ? »Un document ne couvre qu'une seule famille parce que chaque famille a son public, son moment de lecture et son cycle de mise à jour. Le piège le plus courant est de mélanger les familles dans un même document : le runbook noyé dans une page d'architecture n'est plus trouvé en urgence.
| À éviter | Bonne pratique |
|---|---|
| Service Overview avec runbooks intégrés | Service Overview + liens vers des runbooks séparés |
| ADR avec procédure de migration | ADR (décision) + runbook (procédure) |
| Annuaire avec architecture réseau | Page Équipes + page Architecture réseau |
| Postmortem avec checklist intégrée | Postmortem + action « créer la checklist » |
Trois raisons justifient cette séparation, et chacune suffit à elle seule :
- Cycle de mise à jour différent : un annuaire change souvent, une architecture rarement
- Public différent : la personne d'astreinte veut la procédure, pas l'historique des décisions
- Recherche facilitée : on sait où chercher selon le besoin
Comment mettre en place sa documentation, pas à pas ?
Section intitulée « Comment mettre en place sa documentation, pas à pas ? »Mettre en place une documentation opérationnelle se fait en cinq étapes : inventorier l'existant, choisir un outil central, définir une structure, écrire les pages essentielles des services critiques, puis organiser leur maintenance. Inutile de tout couvrir d'emblée : on commence par ce qui sert en incident.
-
Faire l'inventaire de l'existant
Où se trouve la documentation actuelle ? Wiki ? Notion ? README ? Post-its ? Qu'est-ce qui est à jour ? Qu'est-ce qui manque cruellement ?
Exercice : listez toutes les fois où vous avez dû « demander à quelqu'un » ces dernières semaines. Chaque question récurrente est un candidat à documenter.
-
Choisir un outil central
Critère Pourquoi c'est important Recherche efficace Si on ne trouve pas, ça n'existe pas Versioning Savoir ce qui a changé et quand Collaboration Plusieurs contributeurs Accessibilité Disponible même en cas d'incident Options : wiki (Confluence, Notion), docs-as-code (MkDocs, Docusaurus), README dans Git.
-
Définir une structure claire
RépertoireServices/
Répertoireservice-paiement/
- overview.md
- architecture.md
Répertoirerunbooks/
- …
RépertoireInfrastructure/
- reseau.md
- serveurs.md
RépertoireProcedures-transverses/
- gestion-incidents.md
- deploiement.md
RépertoireDecisions-ADR/
- 001-choix-postgresql.md
RépertoireContacts-et-acces/
- equipe.md
- acces.md
-
Créer les pages essentielles
Pour chaque service critique :
Page Pourquoi c'est prioritaire Vue d'ensemble Point d'entrée, criticité Architecture Comprendre comment ça marche Dépendances Évaluer l'impact d'une panne Runbooks Ce qu'on consulte à 3 h du matin Contacts Qui appeler en cas d'urgence Commencez par les services les plus critiques. La page d'entrée d'un service suit le modèle Service Overview.
-
Maintenir à jour
Règle 1 : à chaque changement, la documentation se met à jour dans le même geste, pas « quand on aura le temps ».
Règle 2 : revue trimestrielle des pages clés.
Règle 3 : chaque page a un propriétaire (owner).
Qui est responsable de quoi : le modèle RACI
Section intitulée « Qui est responsable de quoi : le modèle RACI »Dans une organisation à plusieurs équipes, la documentation devient un terrain vague si personne n'en est clairement responsable. Le modèle RACI répartit les rôles autour de chaque document, et le fichier CODEOWNERS permet d'en automatiser une partie dans Git.

Que signifient les quatre lettres du RACI ?
Section intitulée « Que signifient les quatre lettres du RACI ? »Le sigle RACI désigne quatre rôles. Le Responsible fait le travail, l'Accountable valide et répond du résultat, le Consulted donne son avis avant publication, l'Informed est prévenu après coup.
| Lettre | Rôle | Ce que ça veut dire |
|---|---|---|
| R | Responsible | Fait le travail (rédige, met à jour) |
| A | Accountable | Valide et répond du résultat final |
| C | Consulted | Consulté avant de finaliser (expert, relecteur) |
| I | Informed | Informé après (ne participe pas, doit savoir) |
À quoi ressemble une matrice RACI ?
Section intitulée « À quoi ressemble une matrice RACI ? »Une matrice RACI croise les activités (en lignes) et les rôles (en colonnes). Lisez-la ligne par ligne : chaque activité porte exactement un A, ici toujours le Tech Lead propriétaire de la page, et au moins un R.
| Activité | Owner (Tech Lead) | Dev (service) | Archi | Équipe |
|---|---|---|---|---|
| Créer la page service | A | R | C | I |
| Mettre à jour après changement | A | R | C | I |
| Valider la publication | A | - | C | - |
| Revue trimestrielle | A | R | C | - |
| Signaler une erreur | A | R | - | R |
Comment automatiser la relecture avec CODEOWNERS ?
Section intitulée « Comment automatiser la relecture avec CODEOWNERS ? »En docs-as-code, le fichier CODEOWNERS désigne, par chemin, les
propriétaires dont la revue est demandée automatiquement sur chaque pull
request. Sur GitHub, une équipe s'écrit @organisation/equipe et doit
avoir un accès en écriture au dépôt ; GitLab propose un fichier du même nom.
# Documentation infrastructure : l'équipe ops doit valider/docs/infrastructure/       @mon-org/ops-team
# Documentation API : l'équipe backend doit valider/docs/api/                  @mon-org/backend-team
# Documentation sécurité : l'équipe sécu doit valider/docs/security/             @mon-org/security-team
Attention au piège : sur GitHub, CODEOWNERS demande la revue mais ne bloque pas la fusion à lui seul. Il faut activer l'option Require review from Code Owners dans la règle de protection de la branche pour que la PR ne puisse pas être fusionnée sans l'approbation du propriétaire. C'est alors du RACI automatisé.
Comment gérer les conflits entre équipes ?
Section intitulée « Comment gérer les conflits entre équipes ? »Les conflits se règlent avec les rôles déjà posés : l'Accountable tranche, un désaccord technique s'escalade et sa conclusion s'écrit dans un ADR, un doublon se fusionne sous un seul propriétaire.
| Situation | Solution |
|---|---|
| Deux équipes veulent modifier le même document | L'Accountable tranche |
| Désaccord sur le contenu technique | Escalade à l'architecte, décision documentée (ADR) |
| Documentation en doublon | Fusionner, désigner un seul owner, supprimer le doublon |
| Personne ne veut maintenir un document | Assigner un owner explicitement, ou archiver |
Quelles erreurs classiques éviter ?
Section intitulée « Quelles erreurs classiques éviter ? »Les erreurs les plus fréquentes viennent d'un outil éclaté, d'une mise à jour laissée hors du workflow, ou d'un propriétaire absent ou flou. Le tableau associe chaque anti-pattern à son symptôme et à sa parade.
| Anti-pattern | Ce qui se passe | Comment l'éviter |
|---|---|---|
| Documentation fantôme | Existe mais personne ne sait où | Un seul outil, structure claire |
| Documentation obsolète | Schéma de 2019, infra changée trois fois | Mise à jour intégrée au workflow |
| Trop de détails | 50 pages que personne ne lit | Aller à l'essentiel |
| Pas assez de détails | « Voir avec Jean-Pierre » | Si c'est critique, c'est documenté |
| Silos documentaires | Chaque équipe son wiki | Un outil commun ou des liens croisés |
| Pas de recherche | Impossible de trouver | Recherche plein texte, bons titres |
| Pas de propriétaire | « Doc de personne = doc de tout le monde » | Un owner explicite par section |
| Ownership flou | « Équipes X et Y responsables » | Un seul Accountable |
| Validation sans fin | Cinq approbateurs, trois semaines pour une coquille | Simplifier le workflow |
Par quoi commencer : les checklists récapitulatives
Section intitulée « Par quoi commencer : les checklists récapitulatives »Ces trois listes servent d'auto-diagnostic. La première fixe le minimum viable quand on part de zéro, la deuxième décrit une organisation mature, la troisième se relit avant chaque nouveau document.
Checklist « minimum viable »
Section intitulée « Checklist « minimum viable » »Si vous partez de zéro, commencez par ces éléments : ils couvrent les services critiques, les incidents courants et l'annuaire, soit ce dont l'astreinte a besoin dès la première nuit.
- Outil de documentation choisi et accessible à tous
- Cartographie des services (liste avec criticité)
- Schéma réseau (comment les machines sont connectées)
- Runbooks pour les incidents les plus courants
- Annuaire (qui appeler en cas de problème)
- Recherche fonctionnelle
- Chaque service critique a au moins une page
- Owners identifiés pour chaque section
Checklist « maturité »
Section intitulée « Checklist « maturité » »Une fois les bases en place, cette liste décrit une cible : documentation versionnée, revues planifiées, gouvernance écrite. Chaque case vide désigne un chantier, pas un échec.
- ADR pour les décisions techniques importantes
- Versioning (Git ou historique du wiki)
- Revues trimestrielles planifiées
- Modèles pour créer de nouvelles pages
- Boucle de retour (signaler une doc obsolète)
- Accès en incident (doc accessible si l'infra est en panne)
- CI/CD de la documentation (build et déploiement automatiques)
- Matrice RACI documentée
- CODEOWNERS configuré et revue obligatoire activée (si docs-as-code)
- Onboarding des contributeurs documenté
Checklist avant de créer un document
Section intitulée « Checklist avant de créer un document »Avant d'écrire une nouvelle page, cinq questions de contrôle évitent le doublon et le document orphelin : chacune renvoie à une règle vue plus haut, la famille, l'emplacement, le propriétaire et le rythme de mise à jour.
- Quelle famille ? (Cartographie / Architecture / Procédures / Référentiel / Historique)
- Où le ranger ? (dossier correspondant)
- Existe-t-il déjà ? (éviter les doublons)
- Qui va le maintenir ? (owner défini)
- Quel cycle de mise à jour ?
À retenir
Section intitulée « À retenir »-
Une info non documentée n'existe pas : si elle n'est que dans la tête de Jean-Pierre, elle disparaît avec lui.
-
Cinq familles distinctes : cartographie, architecture, procédures, référentiel, historique. Ne les mélangez pas.
-
Un document = une famille : cycles de mise à jour et publics différents.
-
Un ADR ne se réécrit pas : une décision renversée donne un nouvel ADR, l'ancien est marqué remplacé.
-
Un seul Accountable par document : « tout le monde responsable » revient à personne.
-
Mise à jour intégrée au workflow : pas de merge sans doc à jour, et CODEOWNERS ne bloque la fusion que si la revue obligatoire est activée.
-
Commencez petit : services critiques, runbooks des incidents courants, annuaire. Le reste se construit ensuite.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Service Overview : la carte d'identité du service
Continuer le cours : Checklists : ne plus rien oublier en exploitation
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications
Les références ci-dessous fondent les méthodes de cette leçon : le cadre de classement Diátaxis, le format ADR de Michael Nygard, le modèle C4, le RACI et la documentation officielle de CODEOWNERS.
- Write the Docs, Documentation Guide : la référence communautaire
- Diátaxis : un cadre pour structurer la documentation selon le besoin du lecteur
- Documenting Architecture Decisions, Michael Nygard : le format ADR d'origine
- Architecture Decision Records : modèles et outils
- The C4 model, Simon Brown : les niveaux de diagrammes
- Asana, RACI chart : le modèle RACI
- GitHub, About code owners : syntaxe et revue obligatoire