Vous voulez créer un assistant qui répond aux questions sur votre documentation interne, exécute des commandes sur vos serveurs et génère des rapports. Par où commencer ? Quelles briques utiliser ? Ce guide vous donne en 15 minutes une vue d'ensemble structurée de l'écosystème IA générative.
À la fin, vous saurez :
- Nommer chaque composant (LLM, RAG, agent, MCP)
- Comprendre ce que chacun fait et quand l'utiliser
- Positionner les outils (Ollama, LiteLLM, LangGraph) dans une architecture
- Décider quelle approche choisir pour votre projet
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- LLM : qu'est-ce qu'un modèle de langage et comment il génère du texte
- RAG : comment augmenter un LLM avec vos propres données
- Tool calling : comment un LLM appelle des fonctions
- Agents : comment un LLM peut agir sur le monde réel via des outils
- MCP : le standard qui connecte agents et outils
- Où se placent les outils : LiteLLM, Ollama, LangGraph dans l'architecture
Comment choisir (en 30 secondes)
Section intitulée « Comment choisir (en 30 secondes) »Avant d'entrer dans le détail de chaque brique, ce tableau donne la correspondance directe entre un besoin et la technique adaptée. Lisez-le comme un aiguillage : identifiez d'abord ce que vous voulez faire, la colonne de droite vous renvoie vers la section qui l'explique. Les quatre lignes ne sont pas exclusives, un assistant complet combine souvent RAG, tool calling et une boucle d'agent.
| Vous voulez... | Utilisez... |
|---|---|
| Répondre sur vos docs internes | RAG (recherche + injection de contexte) |
| Déclencher une action externe (API, DB, shell) | Tool calling |
| Enchaîner plusieurs étapes / boucler jusqu'au résultat | Agent (LangGraph, CrewAI...) |
| Réutiliser vos outils dans Claude Desktop, VS Code, etc. | MCP (standard d'interopérabilité) |
LLM : la génération de texte
Section intitulée « LLM : la génération de texte »Un LLM (Large Language Model) est un programme qui prédit le token suivant dans une séquence. Un token n'est pas forcément un mot : c'est un morceau de texte (mot, partie de mot, ponctuation). À partir du texte déjà présent, le modèle calcule pour chaque token possible une probabilité d'être le suivant, choisit l'un d'eux, l'ajoute à la séquence, puis recommence. En répétant cette prédiction des milliers de fois, il produit des paragraphes entiers.
Concrètement, un LLM peut :
- Générer du texte : articles, emails, code, scripts
- Répondre à des questions : en synthétisant ce qu'il a "appris"
- Résumer des documents : en extrayant l'essentiel
- Traduire : en transposant les patterns d'une langue à l'autre
- Reformuler : en changeant le style ou le niveau de complexité
Comment ça fonctionne concrètement
Section intitulée « Comment ça fonctionne concrètement »Le LLM a été entraîné sur des milliards de textes (livres, sites web, code source, conversations). Pendant cet entraînement, il a "appris" les patterns statistiques du langage : quels mots suivent quels autres, dans quel contexte.

Le LLM choisit le token suivant selon des probabilités, puis répète le processus jusqu'à générer une réponse complète. Cette génération token par token explique pourquoi on parle de "coût par token" et de "context window" (fenêtre de contexte).
Ce qu'un LLM sait et ne sait pas
Section intitulée « Ce qu'un LLM sait et ne sait pas »| Le LLM sait | Le LLM ne sait pas |
|---|---|
| La syntaxe du langage | Les événements après sa date d'entraînement |
| Les patterns courants | Le contenu de vos documents internes |
| Générer du code valide | La vérité (il "hallucine" parfois) |
| Suivre des instructions | Agir sur le monde réel |
Les principales familles de LLM (février 2026)
Section intitulée « Les principales familles de LLM (février 2026) »| Famille | Exemples | Particularité |
|---|---|---|
| GPT (OpenAI) | GPT-4o, o1, o3 | Polyvalent, API cloud, reasoning |
| Claude (Anthropic) | Claude 3.5, 4 | Long contexte (200k), sûr |
| Llama (Meta) | Llama 3.3 | Open-weights, local possible |
| Mistral | Mistral Large, Codestral | Performant, européen |
| Gemini (Google) | Gemini 2.0 | Multimodal |
| Qwen (Alibaba) | Qwen 2.5 | Open-source, multilingue |
→ Approfondir : Anatomie d'un LLM
RAG : augmenter le LLM avec vos données
Section intitulée « RAG : augmenter le LLM avec vos données »Vous avez un LLM, mais il ne connaît pas vos documents internes. Comment lui faire répondre à "Quelle est notre politique de congés ?" ou "Comment déployer sur notre infrastructure ?" C'est là qu'intervient RAG (Retrieval-Augmented Génération).
Le principe en 4 étapes
Section intitulée « Le principe en 4 étapes »RAG tient en une idée : au lieu de demander au LLM ce qu'il « sait », on lui fournit les bons passages de vos documents au moment de la question, et on lui demande de répondre à partir de ce texte. Les quatre étapes ci-dessous se lisent dans l'ordre, mais deux se déroulent à des moments différents : l'indexation se fait une fois à l'avance, tandis que chercher, injecter et générer s'enchaînent à chaque question posée.
- Indexer : transformer vos documents en vecteurs numériques (détaillé plus bas)
- Chercher : quand une question arrive, trouver les passages pertinents
- Injecter : ajouter ces passages dans le prompt du LLM
- Générer : le LLM répond en se basant sur ce contexte

Pourquoi RAG plutôt que fine-tuning ?
Section intitulée « Pourquoi RAG plutôt que fine-tuning ? »| Approche | Avantages | Inconvénients |
|---|---|---|
| RAG | Pas de réentraînement, données à jour, traçabilité (citations) | Dépend de la qualité de la recherche |
| Fine-tuning | Comportement personnalisé, pas de latence de recherche | Coûteux, données figées, risque d'oubli |
Les étapes d'un pipeline RAG (expliquées)
Section intitulée « Les étapes d'un pipeline RAG (expliquées) »Voici le détail des six opérations qui transforment un tas de documents en réponses sourcées. Les quatre premières (extraction, chunking, embeddings, indexation) constituent la phase de préparation, exécutée une seule fois. Les deux dernières (retrieval, génération) forment la phase d'exécution, rejouée à chaque question. Repérez l'étape de chunking : la taille des morceaux qu'on y choisit conditionne à elle seule la pertinence de tout le reste.
-
Extraction : Récupérer le contenu brut de vos sources (HTML, PDF, Markdown). C'est le "web scraping" ou "parsing" de vos documents.
-
Chunking : Découper en morceaux de 500-1000 tokens. Pourquoi ? Parce que le LLM a une fenêtre de contexte limitée, et parce qu'un passage court est plus pertinent qu'un document entier.
-
Embeddings : Convertir chaque chunk en vecteur numérique (une liste de nombres). Chaque vecteur situe le chunk dans un espace à plusieurs centaines de dimensions où deux textes de sens proche obtiennent des coordonnées proches, ce qui rend leur similarité mesurable par un simple calcul de distance.
-
Indexation : Stocker ces vecteurs dans une base vectorielle (ChromaDB, FAISS). C'est une base de données optimisée pour chercher "le vecteur le plus proche".
-
Retrieval : Quand une question arrive, la convertir aussi en vecteur, puis chercher les chunks les plus proches. C'est la "recherche sémantique".
-
Génération : Injecter les chunks trouvés dans le prompt du LLM. Il répond en se basant sur ce contexte, pas sur sa mémoire.
Ce qui fait la différence en production
Section intitulée « Ce qui fait la différence en production »Un RAG "démo" fonctionne vite. Un RAG production-ready nécessite 3 éléments supplémentaires :
-
Métadonnées & filtres : chaque chunk porte des infos (source, date, produit, ACL). Sinon impossible de filtrer par équipe, restreindre par droits, ou dater les réponses.
-
Hybrid retrieval + reranking : combiner recherche dense (embeddings) et lexicale (BM25), puis re-classer les résultats avec un modèle de reranking. Gain de pertinence significatif.
-
Citations / traçabilité : renvoyer à l'utilisateur les extraits utilisés avec leurs liens ou IDs. Sans ça, impossible de vérifier ni d'auditer.
→ Approfondir : Introduction au RAG
Agent : un LLM qui agit
Section intitulée « Agent : un LLM qui agit »Jusqu'ici, le LLM ne fait que parler. Mais si vous voulez qu'il agisse, réserver un vol, déployer un service, envoyer un email, il lui faut des outils et une boucle de décision. C'est ce qu'on appelle un agent.
Concrètement, un agent peut :
- Appeler des API : météo, Slack, GitHub, votre backend
- Exécuter du code : Python, shell, SQL
- Lire/écrire des fichiers : logs, configs, rapports
- Interroger des bases de données : PostgreSQL, MongoDB, Elasticsearch
- Naviguer sur le web : scraper, remplir des formulaires
La boucle agent (expliquée)
Section intitulée « La boucle agent (expliquée) »L'agent fonctionne en boucle jusqu'à ce que la tâche soit terminée :
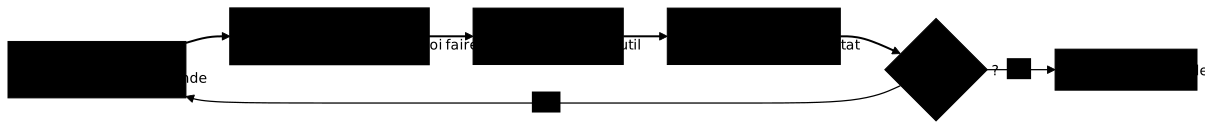
Chaque étape a un rôle précis :
- PERCEIVE : L'agent reçoit la demande ("Déploie la version 2.1 sur staging")
- THINK : Le LLM analyse la situation et décide quoi faire ("Je dois d'abord vérifier si staging est disponible")
- ACT : Il appelle un outil (
check_status("staging")) - OBSERVE : Il lit le résultat ("staging: OK, prêt")
- Recommencer ? : Si la tâche n'est pas finie, retour à THINK ("Maintenant je peux déployer")
Agent vs Chatbot
Section intitulée « Agent vs Chatbot »| Chatbot simple | Agent |
|---|---|
| Répond à une question | Accomplit une tâche |
| Une seule interaction LLM | Plusieurs itérations |
| Pas d'action externe | Appelle des outils |
| Déterministe | Autonome (et risqué) |
Patterns d'agents courants
Section intitulée « Patterns d'agents courants »| Pattern | Description | Use-case |
|---|---|---|
| ReAct | Raisonnement + Action alternés | Tâches complexes multi-étapes |
| Plan-Execute | Planifier d'abord, exécuter ensuite | Tâches avec dépendances |
| Reflection | Auto-critique et correction | Améliorer la qualité |
| Router | Orienter vers le bon sous-agent | Spécialisation par domaine |
→ Approfondir : Patterns agentiques (à venir)
Tool calling : le LLM appelle des fonctions
Section intitulée « Tool calling : le LLM appelle des fonctions »Vous vous demandez peut-être : "Comment le LLM sait-il appeler une API ?" La réponse : il ne le fait pas vraiment. Le LLM génère du texte structuré (JSON) qui décrit quelle fonction appeler et avec quels paramètres. C'est votre code qui exécute réellement l'action.
C'est le tool calling (ou function calling) : une convention où le LLM "demande" d'appeler une fonction, et votre code l'exécute.
Comment ça fonctionne concrètement
Section intitulée « Comment ça fonctionne concrètement »- Vous définissez des outils avec leurs schémas (nom, description, paramètres)
- L'utilisateur pose une question
- Le LLM décide quel outil appeler et avec quels paramètres
- Votre code exécute l'outil et retourne le résultat
- Le LLM intègre le résultat dans sa réponse
# Définition d'un outiltools = [    {        "type": "function",        "function": {            "name": "get_weather",            "description": "Obtenir la météo d'une ville",            "parameters": {                "type": "object",                "properties": {                    "city": {"type": "string", "description": "Nom de la ville"},                    "unit": {"type": "string", "enum": ["celsius", "fahrenheit"]}                },                "required": ["city"]            }        }    }]
# Le LLM génère ceci (pas le résultat, juste l'appel) :# {"name": "get_weather", "arguments": {"city": "Paris", "unit": "celsius"}}
# Votre code exécute get_weather("Paris", "celsius") → "18°C, nuageux"# Le LLM répond : "Il fait 18°C à Paris, avec un ciel nuageux."
Tool calling vs RAG
- RAG : injecter du contexte statique (documents)
- Tool calling : déclencher des actions dynamiques (API, code)
Les deux sont complémentaires : un agent peut utiliser RAG pour chercher des infos, puis tool calling pour agir.
→ Approfondir : Tool calling & contrats d'interface (à venir)
MCP : le standard pour connecter les outils
Section intitulée « MCP : le standard pour connecter les outils »Vous avez créé un outil "get_weather" pour votre agent LangGraph. Super ! Mais maintenant vous voulez l'utiliser dans Claude Desktop, VS Code Copilot et votre chatbot Chainlit. Vous allez réécrire l'intégration 3 fois ? C'est exactement le problème que MCP (Model Context Protocol) résout.
Le problème N×M (avant MCP)
Section intitulée « Le problème N×M (avant MCP) »Sans standard commun, chaque application (Claude Desktop, VS Code, votre chatbot) doit être connectée à chaque outil par une intégration sur mesure. Avec N applications et M outils, cela fait N×M intégrations à écrire et à maintenir. Le schéma ci-dessous illustre ce que MCP change : en s'intercalant comme protocole commun, il ramène ce coût à N+M, chaque application et chaque outil ne parlant plus qu'à un seul interlocuteur standard.

Architecture MCP
Section intitulée « Architecture MCP »MCP répartit les rôles en trois composants qu'il faut distinguer pour lire n'importe quelle documentation du protocole. Le point souvent mal compris est la place du client : il ne s'agit pas de l'utilisateur, mais d'une bibliothèque logée dans l'application hôte, dont le seul travail est de maintenir la connexion vers les serveurs qui exposent les outils.
| Composant | Rôle | Exemple |
|---|---|---|
| Host | L'application utilisateur | Claude Desktop, VS Code, Chainlit |
| Client | Maintient la connexion aux serveurs | Bibliothèque MCP |
| Server | Expose ressources, outils, prompts | Votre serveur MCP |
Les 3 primitives MCP
Section intitulée « Les 3 primitives MCP »| Primitive | Description | Exemple |
|---|---|---|
| Resources | Données contextuelles (read-only) | Fichiers, entrées de DB |
| Tools | Fonctions appelables par le LLM | check_status(), deploy() |
| Prompts | Templates réutilisables | "Résume cet incident" |
MCP : contexte et spécification. MCP a été annoncé le 25 novembre 2024 par Anthropic. C'est un protocole (pas un framework) qui s'appuie sur JSON Schema pour décrire les outils.
L'écosystème évolue rapidement, consultez la spécification officielle pour les dernières évolutions.
→ Approfondir : MCP : standardiser les outils (à venir)
Exemple concret : un assistant DevOps
Section intitulée « Exemple concret : un assistant DevOps »Pour bien comprendre comment tout s'assemble, prenons un assistant DevOps complet :
Le besoin
Section intitulée « Le besoin »Vous voulez un assistant qui peut :
- Répondre aux questions sur votre documentation interne (procédures, runbooks)
- Vérifier l'état de vos services
- Récupérer des logs
- Créer des tickets d'incident
La solution, brique par brique
Section intitulée « La solution, brique par brique »Ce tableau est la synthèse de tout le guide : chaque besoin de l'assistant se traduit par une brique vue précédemment. Lisez-le de haut en bas comme un plan de construction. Remarquez que le tool calling revient trois fois : dès que l'assistant doit agir sur un système réel (vérifier un service, lire des logs, créer un ticket), c'est toujours lui qui est à l'oeuvre, l'agent ne faisant qu'orchestrer ces appels.
| Besoin | Brique IA | Implémentation |
|---|---|---|
| Répondre sur la doc interne | RAG | ChromaDB avec vos runbooks indexés |
| Vérifier l'état des services | Tool calling | Outil check_status(service) |
| Récupérer des logs | Tool calling | Outil get_logs(service, lines) |
| Créer un ticket | Tool calling | Outil create_ticket(title, body) |
| Orchestrer tout ça | Agent | LangGraph avec boucle de décision |
| Standardiser les outils | MCP | Serveur MCP "devops-tools" |
| Interface utilisateur | - | Chainlit ou Slack bot |
| Inférence | LLM | GPT-4 via LiteLLM (avec fallback Claude) |
Architecture résultante
Section intitulée « Architecture résultante »
Erreurs fréquentes
Section intitulée « Erreurs fréquentes »Avant de passer à la suite, évitez ces pièges classiques :
| Erreur | Pourquoi c'est faux | Bonne approche |
|---|---|---|
| "RAG = fine-tuning" | RAG injecte du contexte à la volée ; fine-tuning modifie les poids du modèle | Utilisez RAG pour des données changeantes, fine-tuning pour un comportement personnalisé permanent |
| "Un agent = un chatbot" | Un chatbot répond ; un agent agit (boucle, outils, autonomie) | Chatbot si Q&A simple, agent si tâches multi-étapes |
| "MCP sécurise mes outils" | MCP est un protocole d'interopérabilité, pas de sécurité | Ajoutez sandbox, allowlist, audit par-dessus MCP |
| "Le LLM appelle l'API" | Le LLM génère du JSON ; votre code exécute l'appel | Validez toujours le JSON avant exécution |
À retenir
Section intitulée « À retenir »-
LLM = génération : prédit le token suivant. Base de tout. Mais ne sait que ce qu'il a appris.
-
RAG = contexte : augmente le LLM avec vos données. Recherche + injection dans le prompt.
-
Tool calling = interface : le LLM génère du JSON, votre code exécute. Validez toujours.
-
Agent = action : LLM + boucle + outils. Autonome mais risqué. Garde-fous obligatoires.
-
MCP = standard : connecte apps et outils. Évite le N×M. Resources, Tools, Prompts.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de ce guide est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Anatomie d'un LLM
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications