Le machine learning (ou apprentissage automatique) est une branche de l'intelligence artificielle qui permet à un ordinateur d'apprendre à partir de données, au lieu d'être programmé explicitement pour chaque cas. On lui montre des exemples, il en déduit des règles, puis il applique ces règles à des données qu'il n'a jamais vues.
Cette page donne la définition du machine learning, explique comment il fonctionne en quatre étapes, montre à quoi il sert, le situe par rapport à l'IA, au deep learning et à la data science, présente les trois types d'apprentissage, puis décrit la formation qui vous apprend à l'utiliser : son public, ses prérequis et son organisation. Public : débutants, sans mathématiques avancées.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- Définir le machine learning et ce qu'il n'est pas.
- Décrire le cycle d'un projet : données, entraînement, évaluation, prédiction.
- Distinguer machine learning, deep learning, IA et data science.
- Reconnaître les trois types d'apprentissage.
- Repérer ce que la formation couvre, ce qu'elle ne couvre pas, et ses prérequis.
Qu'est-ce que le machine learning ?
Section intitulée « Qu'est-ce que le machine learning ? »Le machine learning est une méthode qui apprend des règles à partir d'exemples. En programmation classique, un développeur écrit les règles à la main : « si l'e-mail contient le mot loterie, alors c'est du spam ». En machine learning, on inverse la logique : on fournit des milliers d'e-mails déjà étiquetés « spam » ou « normal », et l'algorithme trouve tout seul les motifs qui distinguent les deux.
Le résultat de cet apprentissage s'appelle un modèle : un objet mathématique capable de faire des prédictions sur de nouvelles données. Plus les données d'entraînement sont nombreuses et représentatives, plus le modèle est fiable.
Ce que le machine learning n'est pas : ce n'est ni de la magie, ni une conscience artificielle. Un modèle ne « comprend » rien ; il calcule des prédictions (souvent des probabilités) à partir de régularités statistiques. Il est aussi faillible : un modèle entraîné sur des données biaisées reproduira ces biais.
Comment fonctionne le machine learning ?
Section intitulée « Comment fonctionne le machine learning ? »Un projet de machine learning suit toujours le même cycle, quel que soit l'algorithme.
-
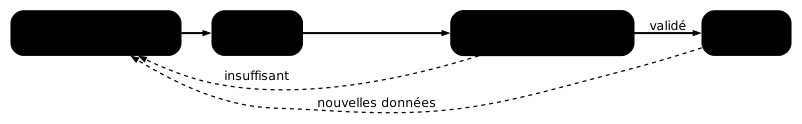
Collecter et préparer les données : on rassemble des exemples et on les nettoie (valeurs manquantes, formats, doublons). C'est souvent l'étape la plus longue, et elle conditionne la qualité finale.
-
Entraîner le modèle : on donne les données à un algorithme qui ajuste ses paramètres internes pour minimiser ses erreurs sur les exemples connus.
-
Évaluer le modèle : on teste ses prédictions sur des données mises de côté, jamais vues à l'entraînement, pour mesurer sa performance réelle.
-
Prédire et déployer : une fois validé, le modèle sert à faire des prédictions sur de vraies nouvelles données, en production.
Ce cycle se répète : on collecte de nouvelles données, on réentraîne, on réévalue. Le schéma suivant montre les quatre étapes en ligne (flèches rouges) et les deux retours en arrière (pointillés) : une évaluation insuffisante renvoie aux données, et un modèle en service reçoit de nouvelles données qui relancent la boucle.
La mise en production et la surveillance de ce cycle relèvent du MLOps, le pendant DevOps du machine learning, qui fait l'objet d'une formation distincte.
À quoi sert le machine learning ?
Section intitulée « À quoi sert le machine learning ? »Le machine learning est déjà partout, souvent sans qu'on le voie. Voici ses usages les plus courants :
- Recommandation : suggérer produits, films ou musiques selon vos habitudes, comme sur les plateformes de streaming et de e-commerce.
- Détection de spam et de fraude : filtrer les e-mails indésirables, repérer une transaction bancaire anormale en temps réel.
- Vision par ordinateur : reconnaître des objets sur une image, aider au diagnostic médical, contrôler la qualité sur une ligne de production.
- Traitement du langage : traduction, assistants, analyse de sentiment. C'est aussi le socle des grands modèles de langage (LLM).
- Prévision : anticiper la demande, ajuster des prix, planifier la maintenance prédictive d'équipements avant la panne.
Le point commun de ces usages : une décision répétitive à prendre à partir de données historiques abondantes. C'est le terrain idéal du machine learning, y compris côté exploitation informatique : prévoir la latence d'un service ou repérer une métrique anormale relève de la même démarche.
Machine learning, IA, deep learning et data science : quelle différence ?
Section intitulée « Machine learning, IA, deep learning et data science : quelle différence ? »Ces quatre termes se recoupent et prêtent à confusion. Voici comment les situer :
| Terme | Ce que c'est | Relation |
|---|---|---|
| Intelligence artificielle | Tout système qui imite une capacité humaine | L'ensemble le plus large |
| Machine learning | Apprendre des règles à partir de données | Un sous-ensemble de l'IA |
| Deep learning | ML fondé sur des réseaux de neurones profonds | Un sous-ensemble du ML |
| Data science | Extraire de la valeur des données (dont le ML) | Une discipline qui utilise le ML |
Le deep learning est donc une famille du machine learning : il utilise des réseaux de neurones à plusieurs couches (des modèles mathématiques empilés en couches successives, d'où le mot « profond »), très performants sur les images, le son et le texte, mais gourmands en données et en calcul. Pour la plupart des problèmes tabulaires (des données en lignes et en colonnes, comme un tableur ou une table de base de données), un modèle de machine learning classique suffit et reste plus simple à entraîner et à expliquer.
Quels sont les trois types d'apprentissage ?
Section intitulée « Quels sont les trois types d'apprentissage ? »Le machine learning se divise en trois grandes familles, selon la nature des données et de l'objectif.
- Apprentissage supervisé : les données sont étiquetées (on connaît la bonne réponse). Le modèle apprend à prédire cette réponse. Exemples : détecter un spam, estimer un prix, reconnaître un chiffre.
- Apprentissage non supervisé : les données ne sont pas étiquetées. Le modèle cherche des structures cachées, comme regrouper des clients par comportement (clustering).
- Apprentissage par renforcement : un agent (un programme qui agit dans un environnement) apprend par essais et erreurs, récompensé quand il agit bien. C'est la logique derrière les IA de jeu et la robotique.
La grande majorité des projets débutants relèvent de l'apprentissage supervisé, le plus concret et le plus outillé. La leçon Types d'apprentissage automatique : supervisé et non supervisé détaille chaque famille (le semi-supervisé compris), ses algorithmes et la façon de choisir.
À qui s'adresse la formation et quels sont les prérequis ?
Section intitulée « À qui s'adresse la formation et quels sont les prérequis ? »La formation s'adresse à des personnes qui savent déjà écrire un script Python et veulent comprendre puis pratiquer le machine learning, en particulier sur des données d'exploitation (métriques de services, journaux, incidents). Il faut moins de mathématiques qu'on ne le croit pour démarrer : des bases en Python, un peu de logique et de la curiosité suffisent, car la bibliothèque scikit-learn entraîne un premier modèle en quelques lignes, sans réécrire les algorithmes.
Le prérequis est la formation Python : les fondamentaux : variables, fonctions, modules, lecture de fichiers et environnements virtuels. Vous travaillerez dans un terminal Linux et vous saurez lancer une commande, lire un message d'erreur et éditer un fichier.
Comment la formation est-elle organisée ?
Section intitulée « Comment la formation est-elle organisée ? »La formation s'organise en modules. Les premiers situent la discipline et préparent le poste de travail ; les suivants reprennent le cycle vu plus haut : données, entraînement, évaluation. Chaque leçon d'enseignement se termine par un court quiz qui vérifie la compréhension, et le plan complet avec votre progression se trouve dans Mon parcours. Sept modules sont publiés aujourd'hui, dans cet ordre.
- Présentation (15 min) : cette page, qui situe le machine learning et décrit la formation.
- Parcours (5 min) : le programme complet, avec le suivi de votre progression leçon par leçon.
- Comprendre le machine learning (2 leçons, 20 min) : la leçon Data science : définition, disciplines et métiers situe le machine learning dans la data science, puis Types d'apprentissage automatique : supervisé et non supervisé distingue les grandes familles d'apprentissage, avant de poser un problème.
- Préparer son poste (3 leçons, 40 min) : la leçon Conda et Miniconda : environnements Python isolés crée un environnement isolé aux versions épinglées (conda est un gestionnaire d'environnements Python), puis Jupyter : qu'est-ce que c'est et comment ça marche explique ce qu'est un notebook, et Jupyter Notebook : créer et lancer son premier notebook en fait exécuter un de haut en bas.
- Apprentissage supervisé (1 leçon, 20 min) : la leçon Régression linéaire : définition et exemple en Python entraîne un modèle qui prédit une valeur, par exemple une latence, et l'évalue avec le R² et le RMSE.
- Apprentissage non supervisé (1 leçon, 20 min) : la leçon Clustering : partitionner des données en machine learning regroupe des données sans étiquettes avec k-means, la méthode du coude et le coefficient de silhouette.
- Approfondir : le deep learning (2 leçons facultatives, 30 min) : la leçon Deep learning : réseaux de neurones et différence avec le ML explique ce qu'est un réseau de neurones, puis PyTorch : entraîner un réseau de neurones sur CPU en entraîne un premier. Ce module peut être sauté sans bloquer la suite.
Quel jeu de données servira de fil rouge ?
Section intitulée « Quel jeu de données servira de fil rouge ? »À terme, les exemples de la formation reposeront sur un seul jeu de données d'exploitation, synthétique et seedé. Synthétique : il sera généré par un script, décrira des métriques de services (charge CPU, mémoire, requêtes, taux d'erreur, latence) et ne contiendra aucune donnée réelle d'un client. Seedé : le générateur recevra une graine fixe (seed), si bien que chaque exécution produira exactement les mêmes lignes.
Ce choix a une raison pédagogique. Vos résultats se reproduisent à l'identique avec les mêmes versions de bibliothèques (la leçon conda montre comment les figer, y compris leurs dépendances), et vous pouvez comparer vos chiffres à ceux de la leçon sans vous demander si l'écart vient d'une erreur ou du hasard. Ce jeu n'est pas encore publié : il arrivera avec le module données. En attendant, les leçons de régression et de clustering utilisent des données générées par scikit-learn avec une graine fixe, et donnent donc les mêmes chiffres à chaque exécution.
Que ne couvre pas cette formation ?
Section intitulée « Que ne couvre pas cette formation ? »Deux sujets voisins ont leurs propres guides. La mise en production des modèles (suivi d'expériences, packaging, déploiement, surveillance de la dérive, c'est-à-dire de la perte de qualité d'un modèle quand les données changent) relève du MLOps. L'usage des grands modèles de langage (LLM, agents, API) relève de la formation Python et IA, qui traite d'un autre métier : utiliser un modèle déjà entraîné plutôt que d'en entraîner un sur ses propres données. La formation vise, à terme, à préparer des données, à entraîner et à évaluer des modèles classiques avec scikit-learn. Pour l'instant, elle publie l'entraînement d'une régression et d'un clustering, sans les modules données et évaluation ; le deep learning n'y figure qu'en module facultatif.
À retenir
Section intitulée « À retenir »- Le machine learning apprend des règles à partir de données, au lieu d'être programmé cas par cas.
- Le résultat est un modèle qui fait des prédictions sur des données nouvelles.
- Le cycle est toujours le même : préparer, entraîner, évaluer, prédire.
- Deep learning et data science ne sont pas synonymes : le deep learning est une famille du ML, la data science une discipline qui l'utilise.
- La formation suppose Python et visera un jeu de données d'exploitation synthétique et seedé ; ses résultats se reproduisent avec les mêmes versions de bibliothèques.
- Elle est en construction : les modules de présentation, de compréhension, de préparation du poste, d'apprentissage supervisé, non supervisé et le module facultatif de deep learning sont publiés ; les modules données et évaluation, puis les épreuves, suivent.