Un outil IaC atteint vos machines de trois façons : il s'y connecte (push), elles viennent chercher leur configuration (pull), ou un programme résident installé sur elles l'applique (agent). Ce choix ne change pas ce que le code décrit, mais il change qui déclenche, combien de temps une dérive survit, et ce qu'un attaquant peut exploiter. Cette leçon reste neutre vis-à-vis des outils : elle s'adresse à des personnes qui lisent du YAML et connaissent Git, et vous donne les critères pour choisir un mode de déclenchement pour une équipe qui gère quelques machines.
Ce que vous allez apprendre
Section intitulée « Ce que vous allez apprendre »- distinguer push, pull, agent et réaction à des événements ;
- relier chaque mode à ses effets sur la dérive, la latence et la surface d'attaque ;
- repérer le mode réellement utilisé par un outil donné ;
- choisir un mode pour un petit parc.
Quel décor pour comparer les modes de déclenchement ?
Section intitulée « Quel décor pour comparer les modes de déclenchement ? »Reprenons l'équipe de quatre personnes et son application web, présentées dans Comprendre l'Infrastructure as Code : deux VM applicatives, une base de données, un réseau et un DNS. Elle veut que la configuration des VM (serveur web, utilisateurs, règles locales) soit appliquée et reste appliquée.
Trois questions concrètes se posent. Qui lance l'application de la configuration ? Combien de temps une modification faite à la main sur une VM peut-elle y rester ? Et qu'est-ce qu'un intrus gagnerait en prenant le contrôle de l'élément qui détient l'accès aux machines ? Ces trois questions sont exactement celles que tranche le mode de déclenchement.
Que veulent dire push, pull et agent ?
Section intitulée « Que veulent dire push, pull et agent ? »Les trois termes décrivent qui initie la connexion et où tourne le programme.
En mode push (pousser), un contrôleur (un poste, un serveur d'automatisation ou un pipeline) se connecte aux machines cibles et leur applique la configuration. Les machines n'ont rien à exécuter de spécial : le contrôleur utilise un accès existant, comme SSH. On parle alors d'outil sans agent.
En mode pull (tirer), c'est la machine qui interroge régulièrement une source (un dépôt Git, un serveur central) pour récupérer l'état voulu, puis l'applique localement. La connexion est sortante : la machine appelle, personne ne la contacte.
Un agent est un programme résident installé sur la machine. Il peut travailler en pull (il récupère sa configuration à intervalle régulier) ou attendre des ordres du contrôleur. Le point commun est la présence d'un logiciel supplémentaire à installer, à mettre à jour et à surveiller sur chaque machine.
Il existe enfin une quatrième variante, la réaction à des événements : une règle déclenche l'application d'une action quand quelque chose se produit (une alerte, un message, un changement), au lieu de le faire sur un planning.
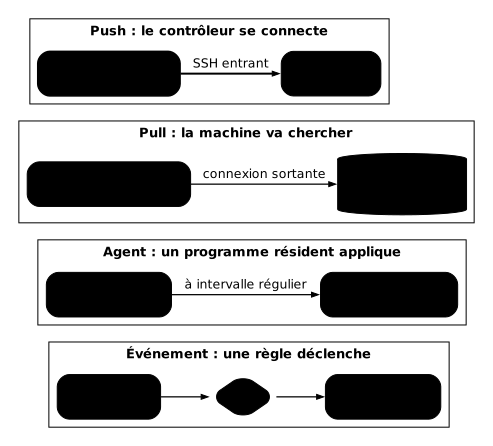
Le schéma place les quatre modes sur une VM applicative du scénario. Une seule règle de lecture : chaque flèche part de celui qui initie. En push, elle part du contrôleur et entre dans la VM ; en pull, elle sort de la VM vers la source ; avec un agent, c'est le programme résident qui rappelle le serveur ; avec un événement, c'est l'alerte qui déclenche la règle.
Quel outil utilise quel mode ?
Section intitulée « Quel outil utilise quel mode ? »Un même outil n'est pas forcément cantonné à un seul mode, mais chacun a un fonctionnement par défaut. Le tableau donne le mode habituel ; vérifiez la documentation de la version que vous utilisez.
| Outil | Mode habituel | Particularité |
|---|---|---|
| Terraform, OpenTofu | Push vers les API des fournisseurs | Pas d'agent sur les machines ; le contrôleur parle aux API |
| Ansible | Push, sans agent, via SSH ou WinRM | Existe aussi en pull avec ansible-pull, et en réaction à des événements avec Event-Driven Ansible |
| Puppet, Chef | Agent en pull | Chaque machine contacte un serveur à intervalle régulier |
| Salt | Agent (minion) relié à un serveur central | Peut aussi fonctionner sans agent avec salt-ssh |
| Flux, Argo CD | Pull depuis Git, par des contrôleurs dans le cluster | Réconciliation continue de l'état du cluster (voir GitOps) |
Ansible mérite une précision : il est historiquement push et sans agent, mais cela n'en fait pas un outil incapable de réagir. Event-Driven Ansible permet de définir des règles qui écoutent des sources d'événements et lancent des playbooks en réponse. Le statut exact de cette fonction dans la version que vous utilisez est à vérifier dans la documentation officielle. Le mode pull existe aussi côté Ansible avec ansible-pull et GitOps, et côté Chef avec le mode pull et la recherche. Les détails sur Ansible sont dans Qu'est-ce qu'Ansible ?, et le système d'événements de Salt dans Bus d'événements Salt.
Quelle différence sur la dérive et la latence ?
Section intitulée « Quelle différence sur la dérive et la latence ? »Le mode détermine quand une dérive est vue, donc combien de temps elle dure (la convergence ponctuelle et la réconciliation continue sont définies dans Idempotence, convergence et dérive). En push, rien ne se passe tant que personne ne relance : un changement manuel sur une VM reste en place jusqu'à la prochaine exécution, qui peut être dans une heure comme dans trois semaines. Pour limiter ce délai, on planifie des relances régulières depuis un pipeline.
En pull avec agent, la boucle est intégrée : l'agent revient à intervalle fixe, détecte l'écart et le corrige. La dérive est donc bornée par la période d'interrogation, que l'on configure. En contrepartie, une modification volontaire faite en urgence sera annulée si elle n'a pas été reportée dans le code.
La latence joue dans l'autre sens. Un changement poussé s'applique dès que vous le décidez, sur toutes les machines atteintes en une exécution. En pull, il s'applique au prochain passage de chaque agent, ce qui est plus lent pour un déploiement urgent mais plus régulier. La réaction aux événements, elle, vise la réactivité : une alerte déclenche une action en quelques secondes, ce qu'un planning ne peut pas faire.
Aucun mode ne garantit l'absence de dérive. Un mode continu la corrige vite, mais seulement pour ce que le code décrit : tout ce qui n'est pas décrit reste hors de contrôle. La mesure de l'écart est reprise dans État, plan et réconciliation.
Quelle surface d'attaque selon le mode ?
Section intitulée « Quelle surface d'attaque selon le mode ? »La surface d'attaque est l'ensemble des points par lesquels un attaquant peut entrer. Chaque mode en déplace des éléments plutôt qu'il ne la supprime.
En push, le contrôleur concentre un pouvoir : il détient les identifiants (clés SSH, jetons d'API) qui donnent accès à toutes les machines. Le compromettre revient à les compromettre toutes. Il faut aussi que les machines acceptent des connexions entrantes, donc un port ouvert vers le contrôleur et des clés à gérer.
En pull, les machines n'ont plus besoin d'accepter de connexion entrante pour recevoir leur configuration : elles appellent une source de confiance. C'est un avantage réel pour des machines derrière un pare-feu ou sans adresse publique. Mais la source devient un point sensible (celui qui modifie le dépôt modifie toutes les machines), et l'agent lui-même est un logiciel de plus avec ses droits élevés, ses vulnérabilités et ses mises à jour.
Les deux modèles réclament donc le même réflexe : moindre privilège pour les identifiants, protection de la branche qui déclenche les changements, et journalisation de ce qui est appliqué. Pour les secrets que ces mécanismes manipulent, voyez Gérer les secrets en IaC.
Comment choisir un mode pour le scénario ?
Section intitulée « Comment choisir un mode pour le scénario ? »Pour deux VM, une base et un réseau, le push depuis un pipeline est le plus simple : pas d'agent à installer ni à maintenir, un seul endroit où lire ce qui s'applique, et des relances planifiées pour surveiller la dérive. La contrepartie à accepter est la fenêtre pendant laquelle une dérive reste invisible.
Le pull devient intéressant quand le parc grandit, que les machines sont nombreuses, éphémères ou non joignables depuis un contrôleur, ou quand l'équipe veut une correction continue de la dérive. Le mode événementiel se justifie quand une action doit suivre un événement précis, par exemple redémarrer un service lorsqu'une alerte de supervision survient.
| Situation | Mode à privilégier | Raison |
|---|---|---|
| Quelques machines, équipe réduite | Push depuis un pipeline | Peu de pièces à maintenir, lecture simple |
| Provisionnement de ressources cloud | Push vers les API | Il n'y a pas de machine où installer un agent |
| Parc nombreux ou machines sans accès entrant | Pull ou agent | Pas de port entrant, passage à l'échelle |
| Besoin de correction continue | Pull continu | La boucle corrige les écarts sans intervention |
| Action déclenchée par un incident | Réaction aux événements | Réactivité, sans attendre un planning |
Quelles erreurs éviter ?
Section intitulée « Quelles erreurs éviter ? »- Croire que pull signifie sûr. Il retire un port entrant, mais ajoute un agent à patcher et une source à protéger.
- Croire que sans agent signifie sans risque. Le contrôleur et ses clés deviennent la cible.
- Faire agir deux outils sur la même ressource. Un agent en pull qui corrige ce qu'un push vient de modifier crée un conflit permanent ; une ressource doit avoir un seul propriétaire.
- Prétendre qu'un outil push ne peut rien observer. Ce raccourci est faux : avec un déclenchement par événements, un outil historiquement push peut réagir sans planning.
- Activer la correction automatique sans filet. Un agent qui annule toute modification manuelle peut défaire un correctif d'urgence non reporté dans le code.
À retenir
Section intitulée « À retenir »- Push : un contrôleur se connecte aux machines. Pull : la machine va chercher sa configuration. Agent : un programme résident l'applique. Événement : une règle déclenche l'action.
- Le mode détermine quand une dérive est vue : à la prochaine relance en push, à la prochaine boucle en pull.
- Chaque mode déplace la surface d'attaque : identifiants du contrôleur en push, agent et source de confiance en pull.
- Pour un petit parc, push depuis un pipeline reste le choix le plus simple ; pull ou agent se justifie par l'échelle, l'accès réseau ou le besoin de correction continue.
- Un outil n'est pas figé dans un mode : Ansible existe en push, en pull et en réaction à des événements.
- Une ressource doit avoir un seul propriétaire pour éviter qu'un push et un pull se contredisent.
Contrôle de connaissances
Section intitulée « Contrôle de connaissances »Vérifiez que l'essentiel de ce guide est acquis. Les questions portent uniquement sur ce qui vient d'être expliqué ici.
Contrôle de connaissances
Validez vos connaissances avec ce quiz interactif
Informations
- Le chronomètre démarre au clic sur Démarrer
- Questions à choix multiples, vrai/faux et réponses courtes
- Vous pouvez naviguer entre les questions
- Les résultats détaillés sont affichés à la fin
Lance le quiz et démarre le chronomètre
Vérification
(0/0)Score par domaine
Un domaine regroupe plusieurs guides et reçoit plusieurs questions : son score est plus fiable qu'un score par thème, qui porte souvent sur une seule question.
Bilan
Points forts
Aucun sujet réussi à 80 % sur au moins deux questions pour l’instant.
Points faibles
Aucun sujet sous le seuil de réussite.
À faire ensuite
Des indices pour retenter votre chance ?
Continuer le cours : Documenter une décision d'infrastructure avec un ADR
Nouveau quiz complet avec des questions aléatoires
Retravailler uniquement les questions ratées
Retour à la liste des certifications